LTX-2.3の派生モデル その3「10Eros v1.2」でリップシンク動画生成

LTX-2.3の派生モデル「10Eros」が、v1.2にバージョンアップしました。
10Erosの入手先はこちらです。
10Eros v1.2用のワークフローを添付します。
入力画像をスタートフレームにして動画を生成する、I2V(Image to Video)です。
10Eros v1用ワークフローとの違いは、10Erosのモデル本体と、テキストエンコーダーです。
・変更前「10Eros_v1-fp8mixed_learned.safetensors」→
変更後「10Eros_v1.2_fp8mixed_learned.safetensors」
・変更前「gemma_3_12B_it_fp8_scaled.safetensors」→
変更後「gemma-3-12b-it-ablit-norms-biproj-fp8mixed.safetensors」
モデルのダウンロードリンクと、ダウンロードしたファイルをどのフォルダに配置するかは、ワークフローの「Model Links」に記載しています。
プロンプトエンハンサーは無効に(バイパス)しています。
10Eros v1.2の変更点について、チャッピーさん(ChatGPT)に、README.mdの要点をまとめてもらいました。
10Eros v1.2の主な変更点は3つです。
顔のドリフト低減
“tuned connector data”を使って、I2Vで初期画像から顔がズレていく問題を減らした、という説明です。
ユーザー目線では、元画像の顔・雰囲気を保ちやすくなった可能性があります。
長いプロンプト/Director系の指示に少し強くなった
READMEでは “aid long prompts/director” とあり、長めの動作指定や演出指示の追従性を改善した、という意味合いです。
以前より「誰が、どこを、どう動かすか」を細かく書いたときに崩れにくい方向だと思います。
Sulphur EXP系の重みをv1に重ねて、動きの表現を調整
v1をベースに、Sulphur EXP weightsを上乗せして、より狙ったモーションが出るように調整した、という説明です。
ただし重要なのは、v1の弱点はまだ残っていると明記されています。具体的には、余分な身体パーツ、字幕、予期しない場面転換などはv1.2でもまだ起こるとのことです。
2026/6/25 追記
チャッピーさんとやりとりをして、ショート動画は字幕が出やすいということが分かりました。
プロンプトで「ホームビデオ」だと指示することで、字幕がほぼ出なくなりました。
意味不明な字幕が出てお困りの際は、プロンプトの最後に、以下の指示を追加してみてください。
Clean natural live-action home video.
Raw ordinary camera footage.
The frame stays simple, realistic, and uncluttered.
Natural realistic movement and ordinary home-video visual style.字幕を出さないようにと考えて、以下のような指示を追加すると、「no」が無視されて、逆に字幕が出る方にプロンプトが効いてしまいますので、ご注意ください。
no subtitles
no captions
no on-screen text
添付のワークフローで、実際に生成した動画はこちらです。
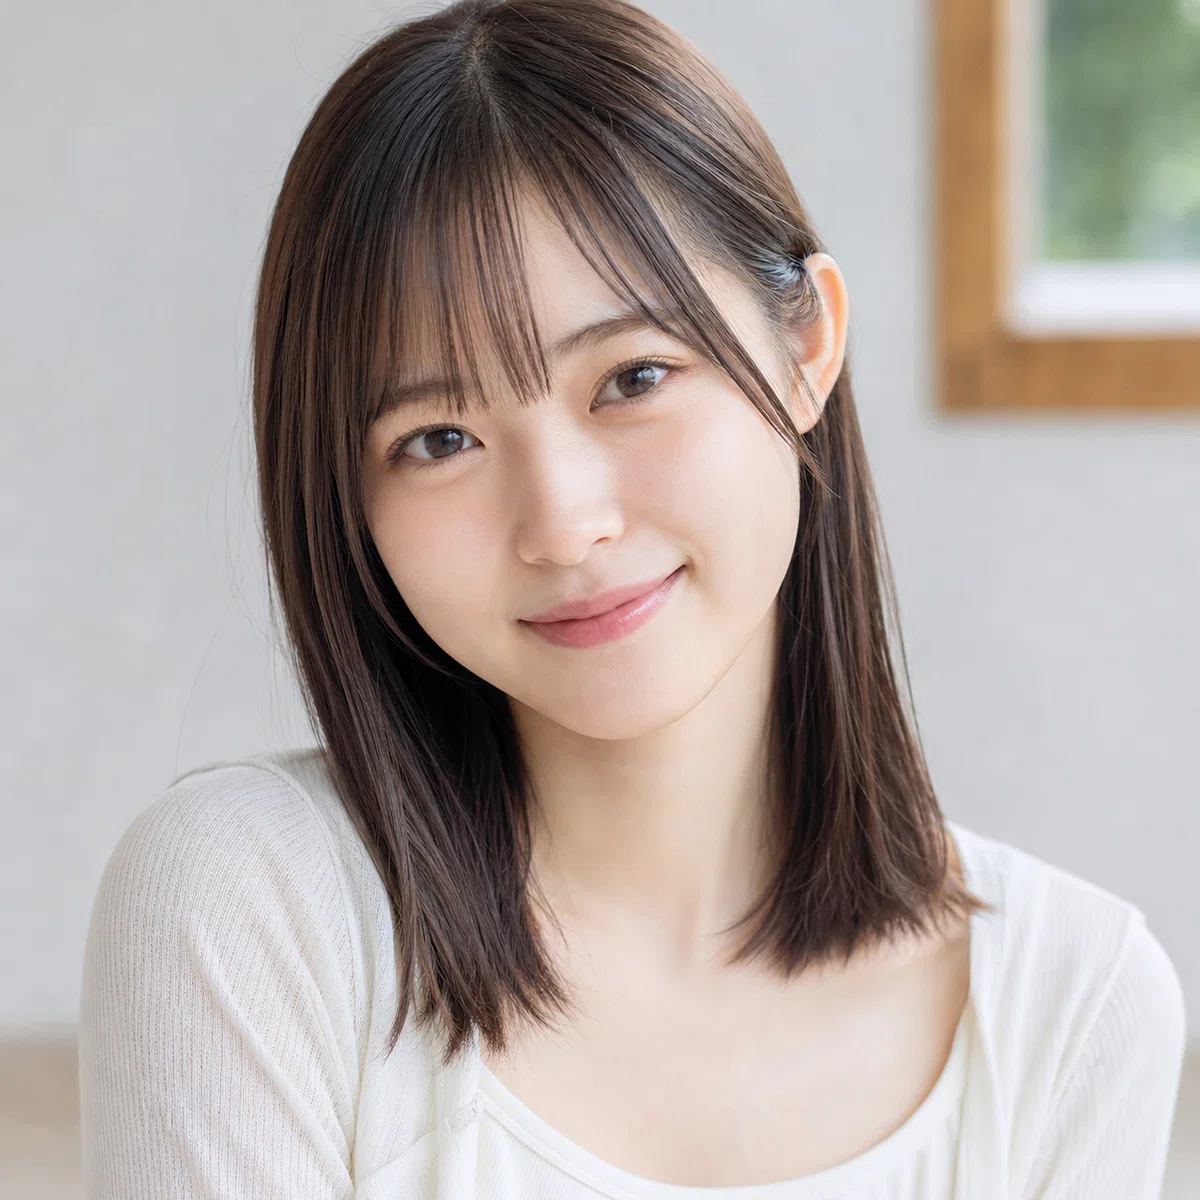
スタートフレーム用の画像を用意したら、動画生成のプロンプトは、ChatGPT、Gemini、Grokなどのチャットで作ってもらった方が、自分で考えるよりはるかに楽です。
スタートフレーム用の画像をチャットにアップロードして、
・画像の人物をどのように動かしたいか
・セリフをどんな声やトーンでしゃべらせたいか(かわいい声、落ち着いた声、キレがいいしゃべり方、ゆるい感じで、など)
動画のイメージをチャットでやり取りしながら、プロンプトを作ってもらいます。
実際に動画を生成して結果を確かめ、微調整したいポイントを伝えて、プロンプトを作り直してもらい、また動画を生成するということを繰り返して、動画を完成させます。
NSFWな動画も試してみましたが、一言で言うと、何でもありです。
NSFWなことは、あまり詳しくは書けませんので、読者様ご自身でお試しください。
旧版の10Erosについての記事もご覧ください。
ベースになっているLTX-2.3について、こちらもご覧ください。
