ChatGPTで生成した画像をもとにLTX-2.3でリップシンク動画を生成

ComfyUI環境で、動画生成AIのLTX-2.3を使い、セリフをしゃべらせるリップシンク動画を作る際のヒントです。
最初に、動画のスタートフレームにする画像を用意します。
まず、ChatGPTで画像生成用のプロンプトを作ってもらい、それをChatGPTに投げて、画像を生成してもらいました。
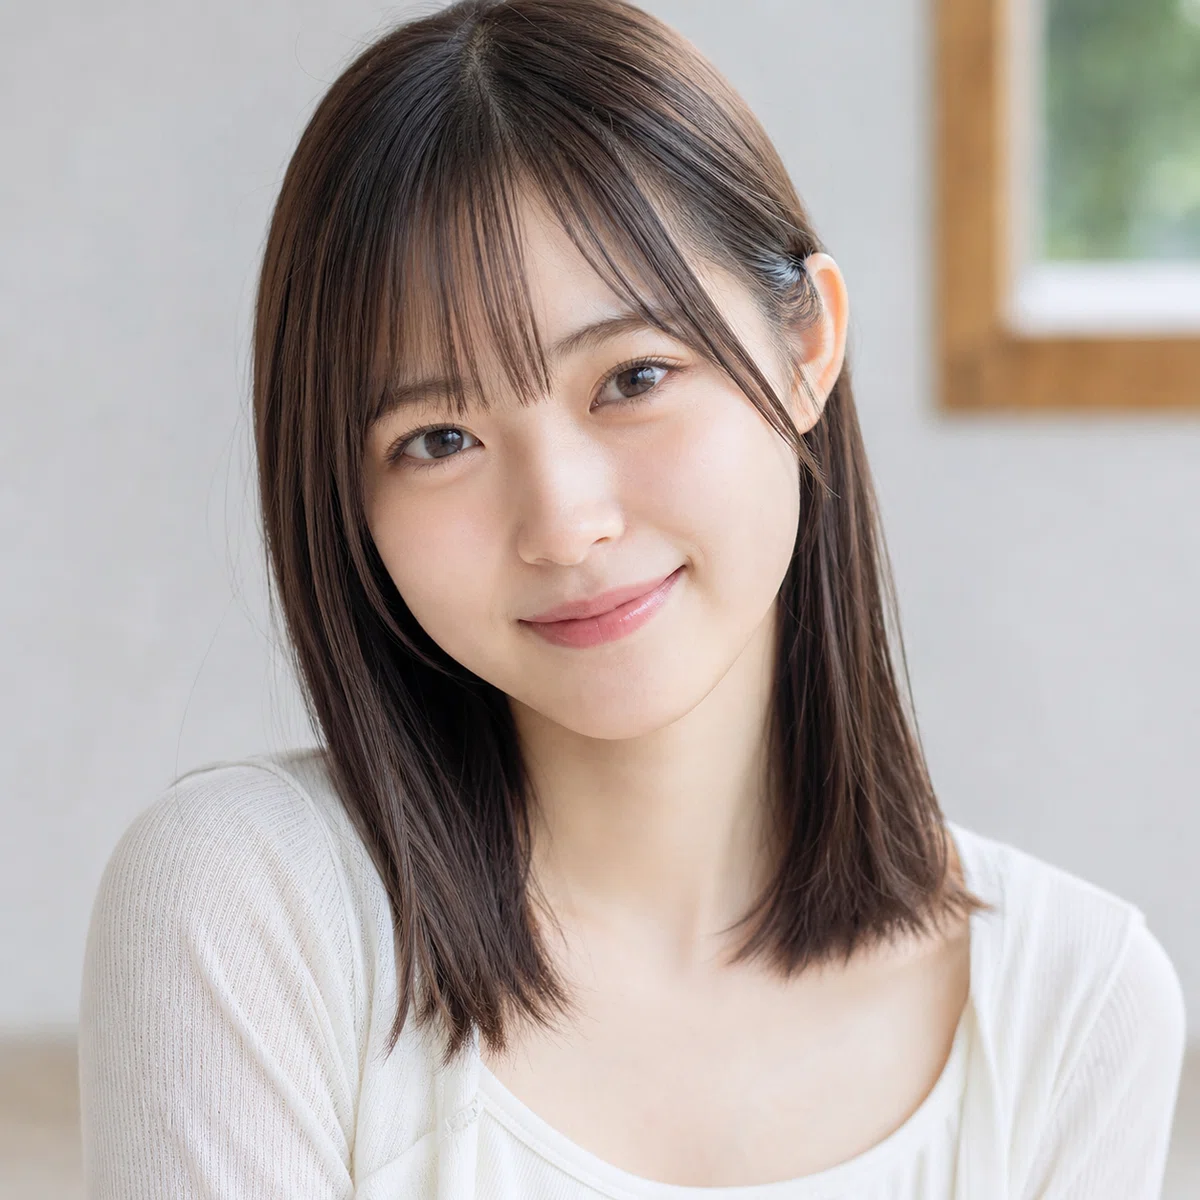
ChatGPTで作ってもらった、画像生成用のプロンプトはこちら。
ultra realistic photo, 20-year-old Japanese college girl,

medium-length dark brown hair, natural straight texture, slightly uneven soft bangs, a few light face-framing strands, subtle natural flyaways, softly controlled shine,

soft feminine face, gently rounded cheeks, soft jawline, slight natural fullness, very subtle asymmetry, approachable and friendly facial structure with a hint of refined balance,

moderate-sized eyes, natural iris size with a very slight enhancement, soft gentle gaze with a touch of clarity, slightly relaxed eyelids, warm and kind eye expression, delicate layered catchlight, eyes with softness but slightly more presence,

natural eyebrows, softly shaped, slightly more refined but not sharp,

slight subtle smile, lips softly curved, a hint of gloss, natural volume, relaxed and warm expression with a gentle hint of charm,

calm and approachable expression with natural friendliness, combined with a faint idol-like charm, soft but slightly eye-catching presence,

soft and natural beauty with a faint memorable uniqueness, not overly polished, slightly imperfect in a natural way,

minimal natural makeup, light skin correction, realistic skin texture, fine pores, soft subsurface scattering, clean healthy skin, natural glow with slight luminosity, subtle highlight on cheekbones and nose bridge,

simple casual outfit, clean and slightly coordinated style, soft light tones,

soft natural daylight, diffused light with gentle directional falloff, soft shadows, slightly enhanced illumination on eyes and upper face, mild highlight shaping,

front-facing, eye-level, relaxed posture, natural framing (chest-up), very slight head tilt,

shallow depth of field, soft creamy background blur,

photorealistic, high detail, natural color grading, slightly brighter tonal balance, subtle film-like softness,

50mm lens, f1.8, sharp focus on eyes

--ar 1:1
これをChatGPTに投げると、添付した画像のような画像が生成されます。
キャラクターは毎回異なり、似た雰囲気にはなりますが、同じ画像にはなりません。
無料版だと、10枚くらい画像を生成するとすぐ制限に達してしまいますので、ご注意ください。
この画像をスタートフレームにして、LTX-2.3でリップシンク動画を生成します。
実際に使用したワークフローはこちらです。
2026/6/3 追記
上記のワークフローから、以下のモデルを変更したLite(軽量)版ワークフローです。
現在は、こちらをメインに使用しています。
・変更前「gemma_3_12B_it_fp8_scaled.safetensors」→
変更後「gemma_3_12B_it_fp4_mixed.safetensors」
・変更前「ltx-2.3-22b-distilled-lora-384-1.1.safetensors」→
変更後「ltx_2.3_22b_distilled_1.1_lora_dynamic_fro09_avg_rank_111_bf16.safetensors」
ComfyUIのテンプレートの「LTX-2.3:画像から動画へ」をベースに、モデルをダウンロードするリンクを最新のものに変更しています。
ダウンロードしたモデルをどこのフォルダに配置するかなども、ワークフローに記載しています。
添付のワークフローは、1280x1280サイズ、24fpsで8秒の動画を生成します。
動画の画面サイズは変更可能で、比率は正方形(1:1)、縦長(3:4、9:16など)、横長(4:3、16:9など)なんでもOKです。
ピクセル数は32の倍数にする必要があります。
1280x960、1024x768など。
「Video Generation (LTX-2.3)」ノードのwidth(幅)とheight(高さ)に設定します。
スタートフレームの画像サイズよりも動画の画面サイズが小さいと、動画の画面サイズに合わせて、周囲がカットされてしまいます。スタートフレームの画像は、動画の縦横の比率と、同じ比率の画像を用意してください。
作りたい動画の画面サイズに近い画像を用意してください。
動画の画面サイズに合わせて、スタートフレーム画像がリサイズされた映像になりますが、比率が異なると、はみ出した部分がカットされた映像になります。
例えば、スタートフレーム画像を1024x1024や2048x2048などの正方形(1:1)、動画の画面サイズを1280x960(4:3)の横長にすると、スタートフレーム画像の上下がカットされた映像になります。
動画の画面サイズを3:4の縦長、スタートフレーム画像を1:1にすると、スタートフレーム画像の左右がカットされた映像になります。
動画の長さlengthは、fps x 秒数 + 1 に設定します。
24fps、8秒の場合、24 x 8 + 1 = 193 になります。
LTX-2.3はクセがあり、なかなかイメージ通りの動画にならず、とても苦労しました。
試行錯誤して、以下のようなことが分かりました。
1. 速い動きや、大きく動かそうとするプロンプトを書くと、人物が破綻する。
スタートフレームの画像から、大きく変わらない動作を指示すればOK。
2. 引き画面で顔が小さく映っていると、口の動きが分かりやすい大きさになるように、勝手にズームインしてしまう。
顔の表情が、わかりやすい大きさに映っている画像を使えばOK。
3. セリフが動画の長さに収まらないと、勝手に英語のセリフを創作してしゃべりだす。
セリフの長さを調整して、動画の長さに収めるしかありません。
動画の方を10秒などに長くしたらOOM(Out of Memory)になってしまいましたが、画面サイズを小さくすれば可能かも?(未確認)
※2026/5/20 追記
Windows 11 Pro、RTX 5060 Ti 16GB、メインメモリ64GBの環境で、1280x960で10秒(24fps、length 241)の動画を生成できました。
4. 勝手に背景を変えたり、室内なのに通行人が現れたりすることがある。
プロンプトで禁止してみたのですが、効果ありませんでした。
スタートフレームの画像の、人物の背景や服装をプロンプトに書かずに、まず1回生成してみて、
背景や服装が変わらない → プロンプトに背景や服装を書かない
背景や服装が変わる → プロンプトに背景や服装を書く
とすると安定しやすいです。
※2026/5/14 追記
服装や背景が変わってしまう原因が分かりました。
こちらの記事をご覧ください。
5. 背景が音楽のライブステージなど、音楽を連想させるものだと、勝手にセリフに曲をつけて歌いだすことがある。
これはこれで楽しいかも?
6. 空間からティーカップを取り出して、お茶を飲み始めることがよくある。
謎
※2026/5/20 追記
ChatGPTに尋ねたら、勝手にお茶を飲み始める原因がわかりました。
すでにredditで話題になっていました。
プロンプトエンハンサーの「TextGenerateLTX2Prompt」ノードが出力するプロンプトのサンプルに、「カプチーノ二杯の準備ができました!」(Two cappuccinos ready!)というセリフが入っているのが原因だそうです。
最新版のComfyUIのテンプレート「LTX-2.3:画像から動画へ」ワークフローは、プロンプトエンハンサーのノードが削除されています。
7. セリフを日本語でしゃべらせたい場合は、日本語で書いた方が流暢にしゃべる。
セリフを日本語で書き、“”(全角ダブルクォーテーション、半角の""でも可)ではさみます。
かぎかっこ「」でセリフをはさんでもOKでした。
プロンプトは英語で書いた方が、指示通りになります。
当初は、がんばってローマ字でセリフを書いていたのですが、かえってカタコトになります。
日本人女性用の声は1種類しかなさそうで、プロンプトで指定しても、例えば、アニメキャラのような声にはなりませんでした。
※2026/5/20 追記
人物の見た目で判断して、自動的に声が変わるようです。
架空の日本人女性アイドル画像をChatGPTで生成し、それを元に動画を生成してみたら、アイドルっぽい、ピッチが高めの声になりました。
セリフに関しては、漢字、ひらがな、カタカナOKです。
ですが、漢字だと読み間違いが多く、例えば「出す」を「です」と読んでしまったりします。
ひらがな、カタカナがおすすめです。
かと言って、全部ひらがなで書くと、単語の区切りを間違えます。
単語の区切りに「、」を入れると、今度は息継ぎしてしまうので、セリフのリズムが悪くなってしまいます。
そこで、名詞、動詞、形容詞、助詞、助動詞、副詞など、単語の区切りで、
ひらがな→カタカナ→ひらがな→カタカナ→・・・
と交互に書き「、」を入れないで書くと、正しく区切ってしゃべってくれます。
例)
今日はいい天気ですね → きょうワいいテンキですネ
逆に、一拍置きたいときは「、」を入れると良いです。
セリフの合間で少し沈黙させたいときは、
“せりふ”
“・・・”
“ツヅキのセリフ”
という感じに、中黒点を何個か、“”ではさんだセリフを改行して入れたら、ほどよく沈黙してくれました。
以上のことを踏まえてプロンプトを作成し、LTX-2.3で生成した動画がこちらです。
この記事に添付したワークフローに、セリフも入っていますので、参考にしてください。
おまけ。
2026/6/4 追記
LTX-2.3の動画生成プロンプトについて続編を書きましたので、こちらもご覧ください。
