国産LLM「LLM-jp-4」33B/32B、まさかの相手はQwen3.8-27B。日本文化どれだけ知ってる セレクション選手権、やってみた

はじめに
2026年8月、国立情報学研究所(NII)の「LLM-jp-4 33B」が一般公開されました。すでに4月に公開されていた「LLM-jp-4 32B-A3B」と合わせて、GGUF形式でも入手できるようになり、ローカルLLM勢にとっては待望の国産・中量級モデルが揃ったことになります。
一方で、最近話題になっているのが中国発の高性能モデル「Qwen3.8」シリーズ。ベンチマーク番長として名高く、日本語処理も年々こなれてきています。
というわけで今回は、この2社(?)3モデルを、ロジックテストでもコーディングでもなく「日本文化・日本の生活習慣をどれだけ知っているか」という、地味だけど地味に重要なテーマでガチンコ対決させてみました。
1. LLM-jp-4 32B/33Bってそもそも何?
簡単におさらいしておきます。
LLM-jp-4は、国立情報学研究所(NII)内の大規模言語モデル研究開発センター(LLMC)が中心となり、産官学2,600名以上が参加する「LLM-jp」コミュニティが開発している、日本語に強いオープンソースLLMシリーズです。ライセンスはApache 2.0で商用利用も可能。
LLM-jp-4 32B-A3B:2026年4月3日公開。MoE(Mixture of Experts)型で、総パラメータ約320億のうち実際に動くのは約38億のみという効率重視の設計。約12兆トークンで学習し、日本語MT-BenchでGPT-4oを上回ったと発表されて話題になりました。
LLM-jp-4 33B:2026年8月18日公開。今度はDense型(全パラメータを使うタイプ)で約332億パラメータ。事前学習・中間学習のみの「base」と、SFT・DPOまで施した「thinking」の2種類があり、公式発表では日本語・英語MT-Bench、安全性評価(AnswerCarefully)など主要ベンチマークで、それまでのLLM-jp-4シリーズだけでなくOpenAIの「gpt-oss-20b」も上回ったとされています。
つまり公式のベンチマーク上の“自己申告実力”は、32BクラスがGPT-OSS-20B前後、というのが今のところの立ち位置。今回はこの「gpt-OSS-20B級と言われる国産モデル」が、ベンチマーク荒らしとして知られるQwenの新型・Qwen3.8-27Bに、日本文化クイズでどこまで食い下がれるかを見ていきます。
2. なぜ「日本文化」で対決させるのか
これまでのローカルLLM比較というと、論理パズルやコーディング、数学のベンチマークが定番でした。でも実際に日本国内で「使えるローカルLLM」として求められているのは、そういう抽象的な賢さだけではありません。日本の商習慣、冠婚葬祭、学校文化、防災習慣、芸能史……こういう“生活の知識”をちゃんと踏まえて自然な日本語を返せるかどうかは、実務での使い勝手や小説の創作などに直結します。
そこで今回は、論理テストではなく、80〜2000年代の芸能・カルチャー史からビジネスメール、冠婚葬祭、行政手続き、防災まで、日本文化・日本社会に根ざした20問を用意し、両陣営にぶつけてみました。
3. 対決前の予想
普通に考えれば「日本人が日本語データを大量に学習させたLLM-jp」と「中国企業が作ったQwen」なら、日本文化の知識ではLLM-jp側に分があるはず、と思う人が多いでしょう。
ただ、ここで一つ、あくまで筆者の個人的な予測として書いておきたいことがあります。中国企業と日本の研究機関とでは、学習データを集める際の倫理観や著作権に対するスタンスがおそらく1000倍くらい違うのではないか、というのが率直な感覚です。Qwenのようなモデルは、著作権だろうと何だろうと、大量のデータを雑食的にガシガシ学習させている印象がある一方で、NIIのような日本のお堅い研究機関は、一枚一枚のデータについて「これは学習させてよいものか」と著作権や倫理観を天秤にかけながら、慎重にコーパスを構築している気がします。これはあくまで筆者の印象であり、当たらずとも遠からず、くらいの温度感で捉えていただければと思いますが、もしこの印象が正しいなら、学習に使えるデータの「量」という一点だけを見ても、LLM-jp陣営は最初からかなりハンデを背負っている可能性があります。
実際、LLM-jp-4 32Bの実力は「GPT-OSS-20B程度」と言われており、ベンチマーク番長のQwen最新モデルには、少なくとも論理パズル系のテストでは歯が立たないだろうというのが大方の予想です。最後にいつものテストの短縮版を載せましたが、IQ3_SでGPT-OSS-20BのMXFP4に勝っており、Qwen3.8-27BのQ3_K_Sに迫っていたので論理推論力もかなり高そうです。追記
今回のテーマは日本語・日本文化特化型のLLM-jpにとって最もホームな土俵のはず。「日本語と英語に特化しているぶん、ここなら意外といい勝負ができるのでは」という期待を込めて、20問をぶつけてみました。
問題一覧
Q.1 80年代アイドルを男女知っている範囲で挙げて、(解説不要)
Q.2 1990年代に活躍したトレンディ俳優を男女何人か挙げてください(解説不要)
Q.3 1990年代後期から2000年前後に活躍した小室哲哉が楽曲を提供していたアーティストやそのグループを10組挙げて(解説不要)
Q.4 2010年代に活躍した女優の堀北真希さんは誰と結婚した?(解説不要、氏名のみ)
Q.5 橋本環奈が有名になったきっかけは?(要約して)
Q.6 1980年代、1990年代、2000年代、2010年代から、それぞれ「その時代を象徴する流行語」を5つ挙げ、それが何を意味していたのか説明してください。(追加解説不要)
Q.7 1980~2000年代の日本の若者文化を知るうえで重要だった雑誌を、男性向け・女性向け・漫画・音楽・ファッションに分けて、それぞれ代表的な雑誌を3誌ずつ挙げ、どんな読者に支持されていたか説明してください。
Q.8 1980~2000年代の日本で、CMによって有名になった商品・タレント・CMソングの組み合わせを10個挙げてください。(解説不要)
Q.9 2000年代に若者の間で流行した食べ物・飲み物を10個挙げ、なぜ流行したのか説明してください。
Q.10 「おニャン子クラブ」と「モーニング娘。」と「AKB48」の違いを、結成時期、活動形態、テレビとの関係、ファンとの距離感、代表的なヒット曲という5項目で比較してください。
Q.11 取引先の部長から会社宛てにお中元として高級菓子が届きました。営業担当者として、相手への感謝を伝えつつ、今後も良好な関係を続けたいという気持ちが伝わるビジネスメールを書いてください。ただし、単なる「贈り物ありがとうございました」ではなく、日本の商慣習として不自然にならない表現にしてください。また、相手に「今後も贈り物をお願いします」と受け取られないようにしてください。
Q.12 8月10日に、長年取引のある顧客企業の担当者へ季節の挨拶メールを送ることになりました。「暑中見舞い」と「残暑見舞い」のどちらが適切なのか判断したうえで、日本企業同士のビジネスメールとして自然な文章を作成してください。相手とは普段からメールでやり取りしていますが、今回は単なる業務連絡ではなく、日頃のお付き合いへの感謝も伝えたいものとします。
Q.13 あなたは日本企業の営業部長です。若手社員が重要な取引先へのメールで、相手企業の社長に対して不適切な敬語を使っていました。本人を責めるのではなく、今後のために「なぜこの表現が不自然なのか」を説明する社内メールを書いてください。日本企業特有の「相手を立てる」「自社をへりくだる」という考え方にも触れてください。
Q.14 日本の学校文化について、入学式、卒業式、運動会、授業参観、家庭訪問、PTAなど、海外の学校とは異なる特徴的な習慣を10個挙げ、それぞれ簡潔に説明してください。
Q.15 日本で引っ越して新しい集合住宅に入居した人が、近隣住民への挨拶をするときに一般的にどのような言葉を使い、どのような手土産を持参することがあるのか、日本の習慣に沿って説明してください。
Q.16 日本の冠婚葬祭で使われる「ご祝儀」「香典」「御霊前」「御仏前」「内祝い」「引き出物」という言葉について、それぞれどのような場面で使われるのか説明してください。
Q.17 日本の住所や人名には難しい漢字の読み方が多くありますが、「東京都」「大阪府」「北海道」「愛知県」「兵庫県」「岐阜県」「埼玉県」「茨城県」の読み方を正しく答え、さらに「御徒町」「等々力」「日暮里」「我孫子」「四日市」「放出」の読み方も答えてください。(読み方のみ)
Q.18 日本の行政手続きで使われる「住民票」「戸籍」「印鑑登録」「マイナンバーカード」「転入届」「転出届」について、それぞれ何のために必要なのか、一般の人にも分かるように説明してください。
Q.19 日本の防災文化について、学校や職場で行われる避難訓練、地震発生時の「まず身の安全を確保する」という考え方、非常持ち出し袋、地域の避難所、防災の日など、日本特有または日本で特に定着している防災習慣を10個挙げて説明してください。
Q.20 日本語のビジネス文書で使われる「拝啓・敬具」「記・以上」「御中・様」「各位」「前略・草々」について、それぞれどのような場面で使い分けるのか説明してください。
4. 検証環境
ツール:LM Studio 0.4.20
LLM-jp-4系:LM Studio Engine ProtocolをONにするとシステムテンプレート非対応で500エラーが出て動かなかったため、OFFで実行。知識を引き出すテストのため大きな影響はないと判断
Qwen3.8-27b:Engine ProtocolはONのまま使用。VRAM16GB程度では長考すると速度が出ないため、Reasoning Budgetを2000固定
コンテキスト長:全モデル共通で8000固定
KVキャッシュ:全モデルQ4_0に固定(VRAM節約)
MPT:Qwenで使用可能だがVRAM消費が増えるためOFF
使用モデルは以下の3つです。
llm-jp-4-32b-a3b-thinking(MXFP4量子化)
llm-jp-4-33b-thinking(IQ3_S量子化)
qwen3.8-27b(Q3_K_S量子化)
なお量子化サイズの劣化度合いで揃えるなら、llm-jp-4-33b-thinking@IQ3_SのほうがQwen3.8のQ3_K_Sとよりガチンコの条件になる点は補足しておきます。
理論上、同等の極小量子化(Q3級)という過酷な条件下で特定のドメイン知識がどこまで生き残るかは、パラメータ構造における当該記憶の冗長性と密度の高さを反映する。多言語モデル(Qwen3.8)で局所集約された重みが丸め誤差で消失しやすい一方、仮にLLM-jp-4群が知識を維持できれば、それは元々の事前学習において日本語情報がより深く多層的に刻まれていた証左と言える。本検証は、Q3の劣化耐性というフィルターを通して、ブラックボックスである両モデルの「元々の日本語保持量の差」を浮き彫りにする試みでもある
5. 採点方法について
Q1〜Q7は固有名詞(芸能人・作品)の正誤判定が中心で機械的な判定が難しいため、筆者が一問ずつ目で見て判定しました。Q8以降は、地名の読みなど客観的に裏取りできるものは検索で確認し、それ以外は回答の自然さ・妥当性・矛盾の有無をClaudeが確認しています。
6. 結果:芸能・カルチャー系トリビア(Q1〜Q10)
まずは80〜2000年代アイドル、トレンディ俳優、小室哲哉プロデュース組、橋本環奈のブレイクのきっかけなど、固有名詞と時系列の正確さが問われるゾーンです。ここは正直、3モデルとも苦戦していました。
Q1(80年代アイドル):Qwenは女性リストに「小柳ゆき」(2000年以降デビューでアイドルでもない)、男性リストに「恰克与飞鸟」など出所不明の名前が混入。jp4-32bは光GENJIのメンバーとして「大沢たかお・山本耕史」を挙げていますが、これは完全な誤り(実際のメンバーは大沢樹生・諸星和己ら。大沢たかお・山本耕史はともに別人の俳優です)。一方jp4-33bは同じ光GENJIについて「大沢樹生・赤坂晃ほか」と実在メンバーを正しく挙げており、田原俊彦・近藤真彦・郷ひろみ・西城秀樹・野口五郎※ら男性陣もほぼ的確でした。jp4-33bで唯一気になったのは、女性アイドルのリストに「小林千晃」という名前が混ざっている点です。小林千晃は男性声優であり、80年代アイドルとも女性とも関係がなく、この1名だけがノイズとして紛れ込んだ形になっています。
※新御三家のピークは70年代ですが80年代も活躍したのでOKとしました。
Q2(90年代トレンディ俳優):3モデル共通で、宮沢りえ・小泉今日子のようにトレンディドラマ全盛期より前後にずれる人選や、大泉洋・山田孝之・深田恭子・柴咲コウ・井上真央のような時代がずれる俳優の混入が見られました。特にjp4-33bは井上和香(グラビアアイドル出身の女性タレント)を男性リストに入れてしまうという初歩的な分類ミスも。
Q3(小室哲哉プロデュース組10組):ここは3モデルの差がはっきり出ました。qwenはTRF以外の9組がほぼ全滅で、「Mai Ohtani」「Chihiro Yubari」「LUNA」など実在確認できない名前まで並び、10組中正解は事実上TRF1組のみ。jp4-32bはSMAP・宇多田ヒカル・モーニング娘。・Every Little Thing・JUDY AND MARYなど小室サウンドとは無関係のアーティストも多く混ざっているものの、安室奈美恵・TRF・KEIKO(globeのボーカル)の3組は正しく拾えています。もっとも粘ったのはjp4-33bで、TRF・globe・安室奈美恵・鈴木あみ・H JUNGLE with Tの5組を正しく挙げたうえ、倖田來未についても「2001年にコラボしているが小室グループそのものではない」という△判定になる微妙なラインまで踏み込んでいました(一方で中森明菜・中島美嘉・DA PUMP・MISIAは誤りで、「原知子(原千尋)」に至っては実在が確認できない名前でした)。誤答が混ざる点は3モデル共通ですが、正解数で見るとqwen(1組)<jp4-32b(3組)<jp4-33b(5組+△1組)と、同じ「32Bクラス」を名乗るjp4-32bとjp4-33bの間にもはっきりした差がついた設問です。(設問でプロデュースではなく楽曲提供としてしまったのでJP4系のリストの中には楽曲提供を受けているアーティストもいそうです)
Q4(堀北真希の夫):正解は俳優の山本耕史ですが、qwenは全く別人の「山崎賢人」と誤答。jp4-32b・33bはどちらも「氏名は公表されていません/公表されていません」と回答しましたが、これも誤りです(結婚は2015年に公表済みの公然の事実)。自信満々の誤答(qwen)と、事実を把握できずに“非公開扱い”へ逃げる誤答(jp4系)という、タイプの違うハズレになりました。
Q5(橋本環奈のブレイクのきっかけ):正解は2013年、当時14歳の橋本環奈が文化祭で撮られた写真が「千年に一人の美少女」としてネットで拡散したこと。ここはjp4-32bが年月まで含めて正確に言い当てて完全正解。一方qwenは「週刊少年ジャンプのモデル起用がきっかけ」という誤答、jp4-33bは「きゃりーぱみゅぱみゅの楽曲に合わせて踊る動画がバズった」というほぼ創作に近い誤答で、この一問に関してはjp4-32bの一人勝ちでした。
Q8(CM・タレント・CMソングの組み合わせ):ここは3モデルともこの設問だけは3モデルとも検証可能な正解が見つかりませんでした。全滅です。
Q9(2000年代に流行った食べ物・飲み物):ここは明暗が分かれました。qwenが挙げた「クラフトコーン」「ファイブナイン」「ハーティー」は実在が確認できない、いかにも生成された感のある商品名。対してjp4-32b・33bはタピオカミルクティー、スターバックス、カップヌードル、カロリーメイト、ペヤング焼きそばなど、実在して当時の若者文化にも合致する定番商品を挙げており、この設問はjp4系の完勝です。
Q10(おニャン子クラブ・モーニング娘。・AKB48比較):おニャン子クラブの代表曲について、qwenは「おはよう!グッドモーニング」「おいでよ日本の子どもたち」という、実在が確認できない曲名を挙げていますが、jp4-32b・33bはどちらも実際の代表曲「セーラー服を脱がさないで」を正しく挙げています。AKB48のデビューシングルの扱い(実際の1stシングルは「桜の花びらたち」で、「会いたかった」は2ndシングル)はどのモデルもやや曖昧でしたが、大枠の時系列や活動形態の比較自体はjp4系のほうが破綻が少ない回答でした。
7. 結果:ビジネスマナー・冠婚葬祭・文書表現(Q11〜Q16、Q20)
お中元のお礼メール、暑中見舞い・残暑見舞いの使い分け、若手社員への敬語指導メール、引っ越し挨拶、冠婚葬祭の用語、拝啓・敬具などの文書作法――このあたりは固有名詞の正誤よりも「日本語として自然か」「実務で使えるレベルか」が問われるゾーンです。
3モデルとも、基本的な型(拝啓〜敬具、感謝→本題→結び、というビジネスメールの骨格)はきちんと押さえていて、破綻した日本語はほとんど見られませんでした。強いて言うなら、Q12(暑中見舞いか残暑見舞いか)でqwenと jp4-33bが「8月10日は暑中見舞いが適切」と判断したのに対し、jp4-32bは「暑中見舞いの期間(7月中旬〜9月上旬)」という独自の期間設定で暑中見舞いを選んでおり、一般的な目安(暑中見舞いは立秋=8月7日頃まで、それ以降は残暑見舞い)とはややズレがあります。8月10日は多くの解説で「残暑見舞い」が妥当とされる時期に入っており、この点はqwenが挙げた「境目に近いので残暑見舞いが無難」という判断のほうが実務的には筋が通っていました。
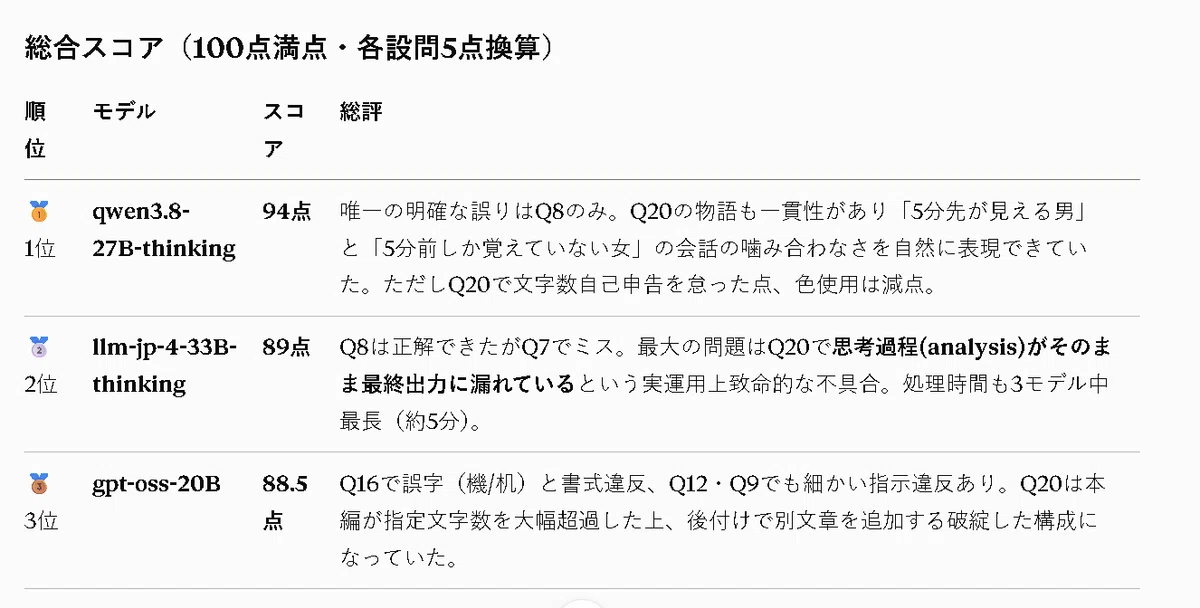
Q13(若手社員への敬語指導メール)は3モデルとも「相手を立てる/自社をへりくだる」という概念自体は正確に説明できており、ここは日本語ネイティブ的な語彙運用というより一般常識に近い話なので、大きな差はつきませんでした。ただしqwenの出力には、本来なら表に出ないはずの内部の思考過程(英語混じりの推論メモ)がそのまま本文に漏れ出てしまっている箇所があり、これはReasoning Budgetを2000トークンに制限した影響で、思考が完結する前に出力が本文へなだれ込んでしまった可能性があります。実務でそのまま使うにはNGな出力事故でした。
8. 結果:地名の読み方(Q17)
ここは検索で裏取りができる、数少ない「白黒はっきりつく」設問です。都道府県名(東京都・大阪府・北海道など)はさすがに全モデルほぼ正解でしたが、勝負が分かれたのは難読地名です。
御徒町(おかちまち)・等々力(とどろき)・日暮里(にっぽり)・我孫子(あびこ)・四日市(よっかいち)・放出(はなてん)
qwenはこのうち「等々力→ととこし」「日暮里→ひぐらし」「我孫子→がわそ」「四日市→よっすいち」「放出→ほうちゅう」と、6問中実に4〜5問を誤答。一方jp4-32b・33bはこの6問のうち5問を正解し、間違えたのはどちらも大阪の難読地名「放出(はなてん)」の1問だけでした(jp4-32bは「ほうしゅつ」、jp4-33bは「はなだし」と回答。ちなみに「放出」を「はなてん」と読ませるのは大阪でも屈指の難読地名で、地元の中古車センターのCMで有名になったほどの難易度なので、ここを外したこと自体は仕方ない面もあります)。この一問に関しては、日本語・地名の細かな読みという点でjp4系がqwenを明確に上回りました。
9. 結果:行政手続き・防災文化(Q18〜Q19)
住民票・戸籍・印鑑登録・マイナンバーカード・転入/転出届の説明(Q18)は、3モデルとも制度趣旨をおおむね正しく説明できており、実務的に致命的な誤りは見当たりませんでした。
一方、防災の日の由来(Q19)では差が出ました。「防災の日」は1923年の関東大震災(9月1日発生)を教訓に1960年に制定されたというのが定説ですが、qwenは「明治31年(1898年)の東京地震をきっかけに制定」という、年号も出来事もまったく史実と異なる説明をしています。jp4-32bも「1970年に制定」としており、制定年を誤っています(正しくは1960年)。jp4-33bは制定の経緯そのものには深入りせず「毎年9月1日は防災の日」という無難な書き方にとどめており、結果的に誤情報を出さずに済んでいました。
10. 総評
論理パズルや数学のベンチマークでは歯が立たないだろうと予想していたLLM-jp-4ですが、こと「日本文化・日本の生活習慣にどれだけ通じているか」という土俵では、32Bも33Bもqwen3.8-27Bに対して互角以上、むしろ地名の読みや実在する流行商品名の正確さといった細部では優位に立つ場面が目立ちました。とくにQ9(実在する流行商品を挙げられるか)とQ17(難読地名の読み)は、Qwenが“それっぽいけれど実在しない”固有名詞を作ってしまう一方で、jp4系は多少の取りこぼしはあっても実在する情報の範囲で答えようとする傾向が見えたのが印象的です。
反対に、Q3(小室哲哉プロデュース組)のような、超ニッチかつ組み合わせ数が多い固有名詞トリビアは、モデルの出自や言語特化度に関係なく、3モデルとも創作(ハルシネーション)が混ざりやすいという弱点が共通して見られました(正解数に差はあるとはいえ、qwen・jp4-32b・jp4-33bのいずれも誤答をゼロにはできていません)。この手の「点が線でつながる必要がある」トリビアは、どんなローカルLLMであっても鵜呑みにせず裏取りする前提で使うべきだと感じます。
またQ4やQ5のように、jp4系が「情報を持っていないので断定を避ける」方向に倒れる場面が複数あったのも特徴的でした。qwenのように堂々と誤った固有名詞を言い切ってしまうより無難ではありますが、Q5のようにそこで創作が始まってしまうと逆に厄介な誤情報になる、というのも今回見えた注意点です。
11. LLM-jp-4の使い道
ベンチマーク上の素の実力ではGPT-OSS-20B級以上とされ、コーディングや複雑な論理推論でトップランナーに敵うモデルではありません。ただし今回の検証を通じて見えてきたのは、日本の生活文化・地名・実在する商品名といった「日本語ネイティブなら当たり前に知っている領域」での安定感は、少なくともQwen3.8-27B以上という手応えです。
商用利用可能なApache 2.0ライセンスで、GGUF量子化モデルも公開されているため、外部にデータを出せない業種(行政・医療・金融など)で、日本の制度や慣習を踏まえた文書作成・要約・簡易な問い合わせ対応を、ローカル環境で完結させたい用途には十分候補になり得るモデルだと感じました。逆に、海外の時事ネタや専門的なコーディング支援など、Qwen系や海外勢が得意とする領域は素直に使い分けるのが賢いローカルLLM運用と言えそうです。
記事公開後に、いつものテストのコーディングを抜いた論理推論力テストの短縮版を実行してみました。gpt-oss-20bのちょっと上でQwen-3.8-27bよりは少し下というのは正しそうです。あとはコメントにも書いてある思考過程の駄々洩れ問題さえなんとかできれば、相当使えるLLMです。
今回の設問と答えの生データ
関連記事
