【2026年8月最新】LlamaIndexとは?RAGの作り方・LlamaParse・LangChainとの違いを解説

※最終更新:2026年8月16日。LlamaIndex Framework、LlamaCloud、LlamaParseの現行構成と、企業でRAGを導入するときの判断基準を確認しました。
社内規程、製品マニュアル、契約書、過去の問い合わせ記録。こうした自社データを生成AIから検索できるようにするには、文書の読み込み、分割、索引化、検索、回答生成、評価をつなぐ必要があります。
LlamaIndexは、このデータ処理と検索を組み立てるためのフレームワークです。ただし、数行のサンプルが動くことと、社員が安心して使えるRAGが完成することは同じではありません。
この記事では、LlamaIndexの使い方だけでなく、どの業務に向くのか、精度をどこで評価するのか、LangChainや既製サービスとどう使い分けるのかまで解説します。
この記事の要点
✅ LlamaIndexは、社内文書やデータベースなどを生成AIから利用するための読み込み・索引化・検索・回答生成を組み立てるフレームワークです
✅ 現在はRAGだけでなく、データを使うAIエージェントやイベント駆動型ワークフローの構築にも対応しています
✅ 企業導入ではコードの短さより、文書整備、アクセス権、検索評価、更新運用、障害時の切り分けが重要です
LlamaIndexとは
LlamaIndexは、LLMを自社データと組み合わせるためのオープンソースフレームワークです。公式ドキュメントでは、データを取り込み、解析し、索引化し、検索して、LLMへ必要な文脈を渡す「Context-Augmented LLM Applications」の開発基盤として説明されています。
代表的な用途はRAGです。ほかにも、文書からの構造化データ抽出、社内検索、チャットボット、複数のデータソースを使うAIエージェントなどを構築できます。
名前に「Llama」とありますが、MetaのLlamaモデル専用ではありません。OpenAI、Anthropic、Google、ローカルモデルなど、用途に合うLLMや埋め込みモデルと組み合わせられます。
RAGとは
RAGは、質問に関係する情報を外部データから検索し、その内容をLLMへ渡して回答させる仕組みです。
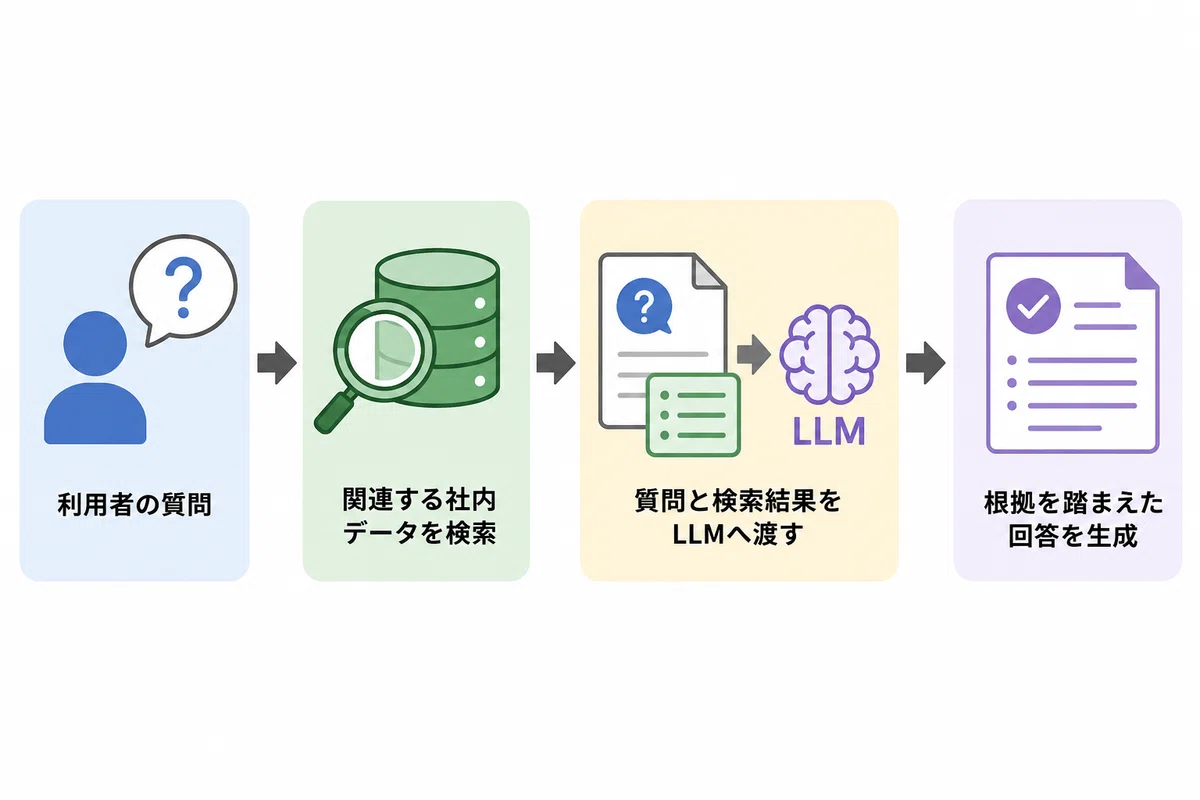
モデルを再学習させる仕組みではありません。元データや索引を更新すれば新しい情報を検索対象にできますが、データを追加しただけで必ず正しく答えられるわけでもありません。
RAGの基礎は、中学生にもわかるRAG入門で詳しく解説しています。
LlamaIndexでできること
PDFやデータベースから情報を取り込む
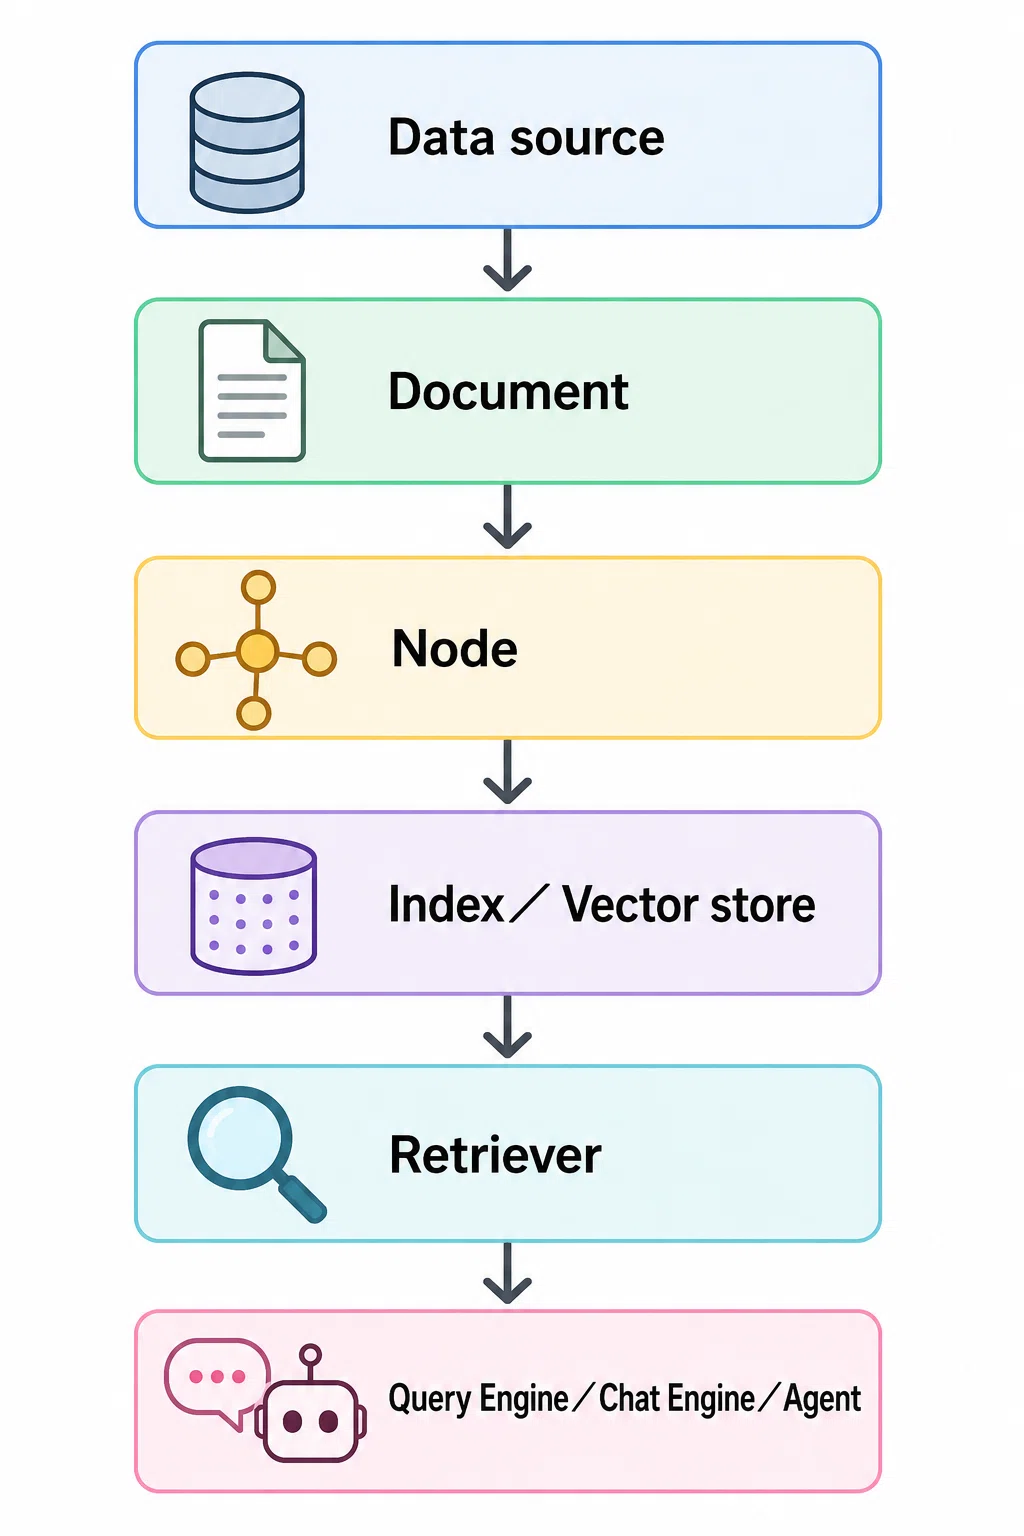
ファイル、Webページ、API、SQLデータベースなどから情報を読み込み、LlamaIndexで扱えるDocumentやNodeへ変換します。Nodeは、検索に使う文書の小さな単位です。本文だけでなく、出典、作成日、部署、閲覧区分などのメタデータも持たせられます。
文書を検索できる形に整える
文書を分割し、埋め込みを作成して、ベクトルストアなどへ保存します。表題、章、文書種別、更新日などを使った絞り込みも設計できます。
質問に合う情報を検索する
Retrieverが、質問に関係するNodeを取得します。ベクトル検索、キーワード検索、メタデータフィルタ、複数検索の組み合わせなど、データの性質に合わせた構成が可能です。
検索結果から回答を作る
Query Engineは、検索結果と質問をLLMへ渡して回答を生成します。Chat Engineを使えば、過去の会話を踏まえた対話形式にもできます。
RAGをAIエージェントのツールにする
現在のLlamaIndexはRAG専用ではありません。RAGを1つのツールとしてエージェントへ渡し、必要に応じて検索、データ抽出、API呼び出しなどを使い分ける構成を作れます。
RAGを構成する5つの工程
LlamaIndex公式は、RAGを次の5段階で説明しています。
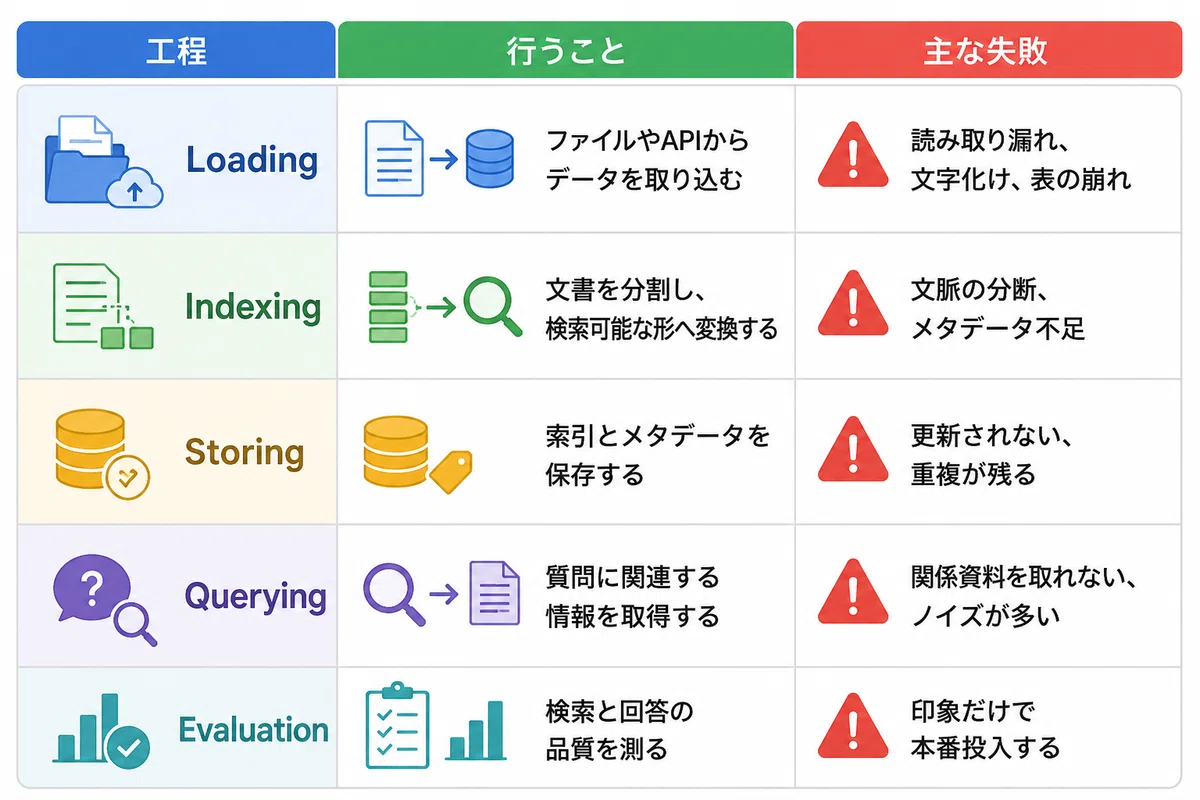
RAGの精度が悪いと、すぐにモデルやプロンプトを変えたくなります。しかし原因がPDFの読み取りや検索にあれば、モデルを替えても直りません。取り込み、検索、回答を分けて確認することが重要です。
LlamaIndexの基本構造
DocumentとNode
DocumentはPDF、APIの出力、データベースのレコードなど、読み込んだ情報を包む単位です。Nodeは検索に使う最小単位で、一般にDocumentを複数へ分割して作ります。
IndexとVector Store
Indexは検索しやすい形にデータを整理する仕組みです。ベクトル検索を使う場合は、文章の意味を数値化した埋め込みとメタデータをVector Storeへ保存します。
RetrieverとPostprocessor
Retrieverは質問に関連するNodeを取得します。その後、Node Postprocessorで絞り込み、並べ替え、再評価などを行えます。
Response Synthesizer
取得した情報を使って回答を生成します。ここでは、根拠がない場合の応答、引用の付け方、回答形式などを設計します。
最小構成でRAGを試す
Python版の公式クイックスタートは、次の形です。実行には接続するモデルのAPIキーなどが必要です。
pip install llama-index`data`フォルダへ検証用の文書を置きます。顧客情報や機密文書をそのまま使わず、最初は公開情報または架空データで試してください。
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader

documents = SimpleDirectoryReader("data").load_data()
index = VectorStoreIndex.from_documents(documents)
query_engine = index.as_query_engine()

response = query_engine.query("この文書の申請期限を教えてください")
print(response)
このコードで基本動作は確認できます。ただし、本番には認証、部署別のアクセス制御、データ更新、削除反映、監視、評価、バックアップ、障害対応が必要です。
LlamaParseとLlamaCloudの違い
LlamaIndexのオープンソースフレームワークと、マネージドサービスのLlamaCloudは分けて考えます。
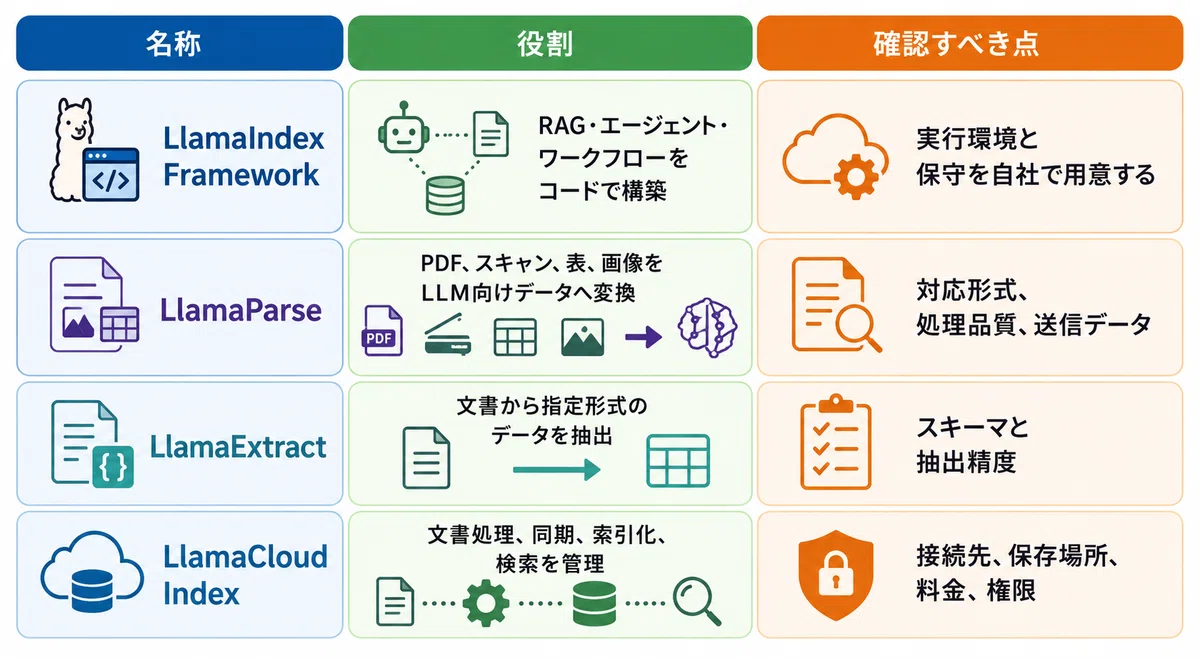
LlamaParseの現行プラットフォームでは、Parse、Extract、Classify、Split、Sheets、Indexが案内されています。複雑なPDFやスキャン文書を扱う場合、文書をきれいなテキストや構造化データへ変える工程を省力化できます。
一方、クラウドへ文書を送れるかは別の判断です。契約、データ保存、処理リージョン、学習利用、削除、監査ログなどを確認してください。外部送信できない場合は、クラウド・閉域・オンプレ生成AIの比較も参考になります。
RAGの精度を上げる順番
精度改善は、チャンクサイズだけを調整する作業ではありません。次の順番で原因を切り分けます。
1. 元文書を整える
古い版と新しい版が混在していないか、画像化された文字を読めているか、表や注記が欠落していないかを確認します。元データが崩れていれば検索後の回答も崩れます。
2. メタデータを付ける
文書名、部署、公開範囲、施行日、更新日などを保持します。これにより、利用者の権限や質問の条件に合う文書だけへ検索範囲を絞れます。
3. 分割方法を業務に合わせる
規程の条項、マニュアルの手順、FAQの質問と回答など、意味のまとまりを壊さない分割が必要です。固定のチャンク幅をすべての文書へ当てはめないでください。
4. 検索結果を評価する
正解に必要な文書が上位に入っているか、関係のない文書が混ざっていないかを見ます。回答文の評価より先に検索を確認します。
5. 回答と根拠を評価する
検索結果に沿っているか、必要な条件を落としていないか、出典を示せているかを確認します。根拠が見つからない質問では、推測せず担当部署へ案内できるかもテストします。
▶️ AIworkerのサービス資料をダウンロードする
LlamaIndexが向く会社・向かない会社
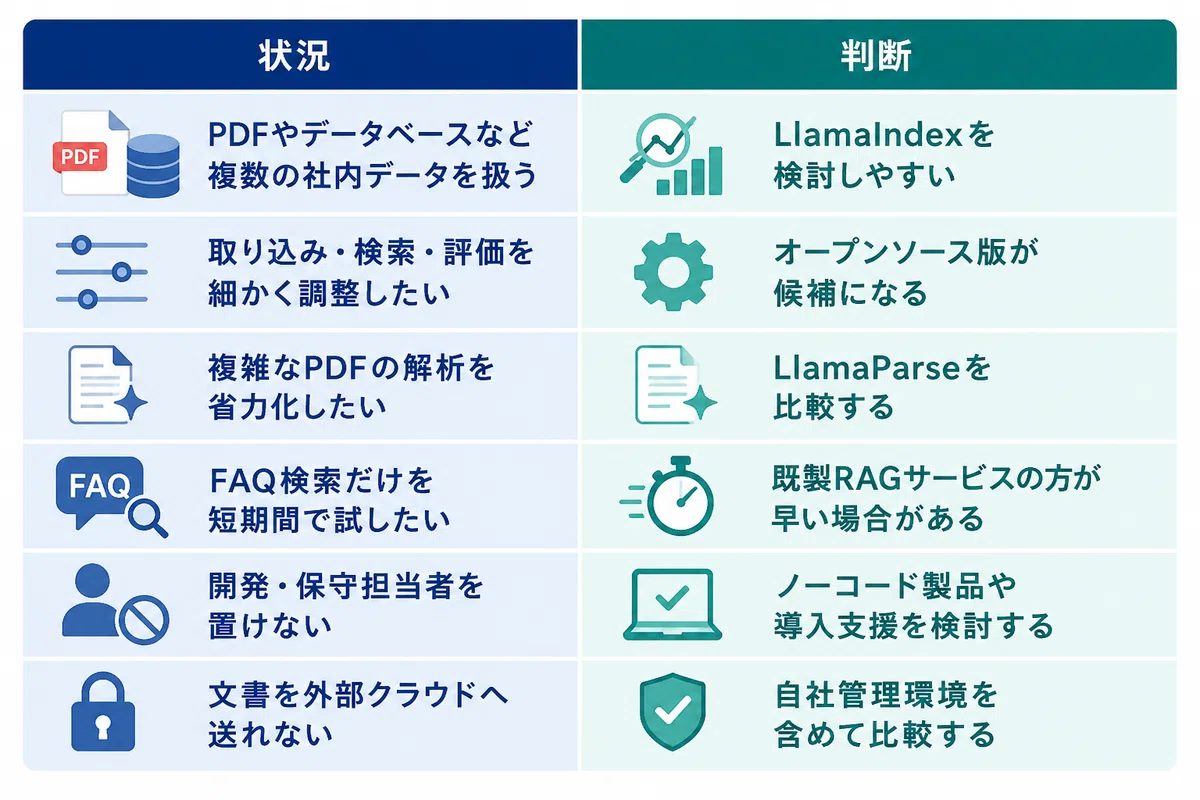
社内AI・RAGの作り方では、技術選定の前に決めるべきデータ、権限、評価、運用体制を整理しています。
LangChainとLlamaIndexの違い
両者の領域は重なっており、単純に「RAGならLlamaIndex、エージェントならLangChain」と言い切れなくなっています。
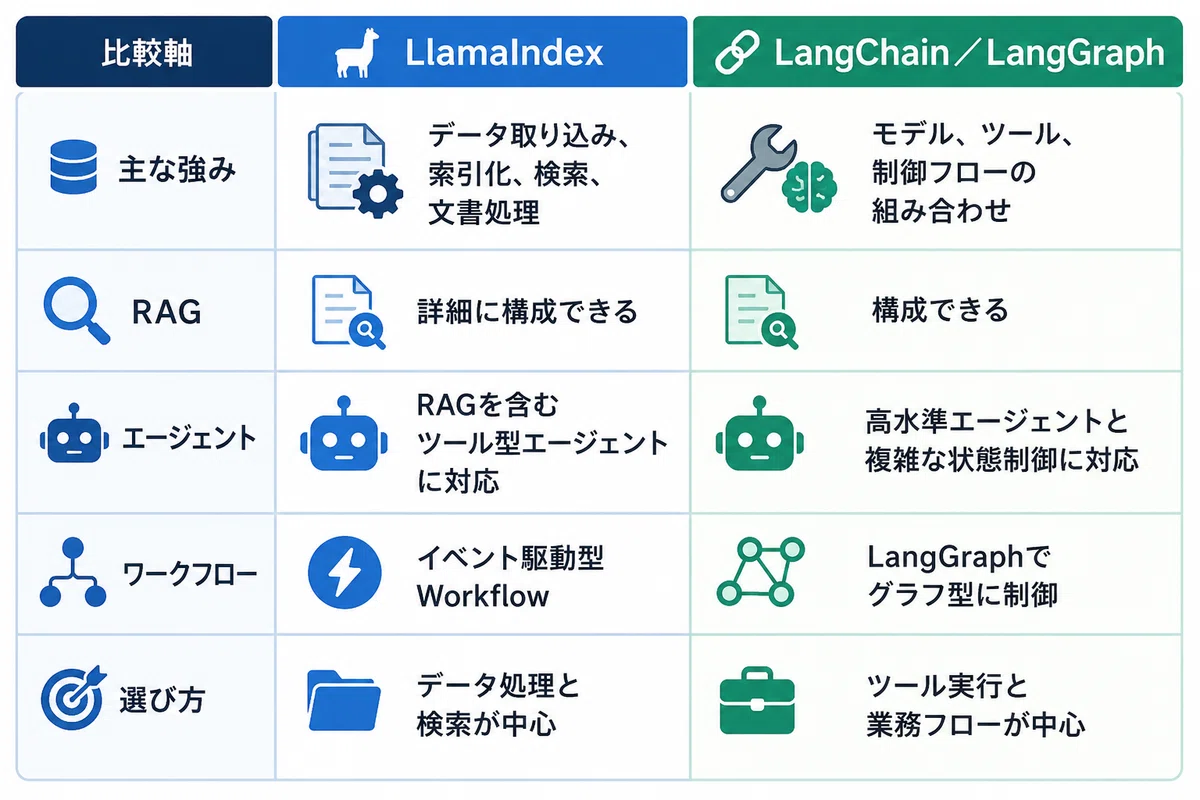
併用もできますが、最初から両方を入れる必要はありません。対象業務に必要な最小構成から始め、足りない機能が明確になってから追加します。
LangChain・LangGraph・LangSmithの違いは、別の記事で現行構成を解説しています。
企業導入で失敗しやすい6つのパターン
1. PDFを入れれば完成だと考える
古い規程、重複文書、画像化された表、権限情報のないファイルを入れると、検索結果も不安定になります。
2. すべての社員に同じ検索結果を返す
人事、法務、経営資料などは閲覧範囲が異なります。回答時だけでなく、検索前に利用者の権限で対象データを絞ります。
3. 正解例を用意せず調整する
担当者の印象だけで改善すると、設定変更の効果を比較できません。実際の質問、必要な根拠、期待回答、回答不可条件をテストデータにします。
4. 出典を表示しない
回答が合っていても、どの文書のどの部分を使ったか確認できなければ業務判断に使いにくくなります。
5. 更新と削除の運用を決めない
文書を追加する方法だけでなく、改定前文書の無効化、削除、再索引化、同期失敗の検知を設計します。
6. PoCの構成をそのまま本番へ持ち込む
ローカルフォルダとインメモリ索引で動くサンプルは、同時利用、障害復旧、権限、監査には対応していません。本番要件から構成を見直します。
PoCで確認するチェックリスト
対象業務と利用者を1つに絞っている
正式な情報源と文書の更新担当者が決まっている
閲覧権限を検索前に反映できる
実際の質問を使ったテストデータがある
検索結果と最終回答を分けて評価できる
回答には参照文書を表示できる
情報不足時は推測せず人へ引き継げる
文書の追加・更新・削除を運用できる
ログに機密情報を残しすぎない
本番後の改善担当者と予算が決まっている
よくある質問
Q. LlamaIndexは無料で使えますか?
オープンソースのLlamaIndex Frameworkは利用できます。ただし、接続するLLM、埋め込みモデル、ベクトルデータベース、クラウド、LlamaCloudなどには別途費用がかかる場合があります。最新のライセンスと料金を確認してください。
Q. LlamaIndexだけで社内RAGは完成しますか?
完成しません。認証、権限、データ整備、検索評価、ログ、更新、障害対応なども必要です。LlamaIndexは実装を助けますが、業務ルールや運用責任までは決めてくれません。
Q. LlamaParseを使えばPDFを必ず正確に読めますか?
保証はできません。複雑な表、図、スキャン品質、手書き、ページ構成によって結果は変わります。自社で扱う代表的な文書を使い、項目別に読み取り精度を確認してください。
Q. ベクトルデータベースは必須ですか?
小規模な検証では簡単な保存方法でも始められます。本番ではデータ量、更新頻度、権限、検索方式、既存インフラに合わせて選びます。既存のPostgreSQLなどを活用できる場合もあります。
Q. LlamaIndexとLangChainはどちらが優れていますか?
優劣ではなく中心業務で選びます。文書処理と検索が中心ならLlamaIndex、ツール実行や複雑な制御が中心ならLangChain/LangGraphが候補です。必要なら併用します。
Q. 機密情報を扱えますか?
接続するモデル、データベース、解析サービス、ログ、実行環境によって変わります。データの送信先、保存先、保持期間、学習利用、削除方法、閲覧権限を構成全体で確認してください。
まとめ
LlamaIndexは、社内データを取り込み、検索し、生成AIやAIエージェントから使うためのフレームワークです。短いコードで試せる一方、本番運用には文書整備、権限、評価、更新、監視が欠かせません。
重要なのは、LlamaIndexを導入することではなく、必要な根拠を必要な人へ正しく届け、間違ったときに原因を追える仕組みを作ることです。
AIネイティブX研修|RAGを作る前に業務を整理する
RAGの技術だけでなく、どの質問を対象にするか、正式な情報源は何か、AIへ任せる範囲と人が確認する箇所を整理します。既製サービスで足りる業務と、個別開発が必要な業務を分けます。
業務AIプロ|自社データに合わせて設計・実装する
文書の解析、検索、アクセス権、出典表示、外部システム連携、評価方法まで含めて構築します。PoCで精度と運用負荷を確認し、本番へ進む条件を明確にします。
AIネイティブX伴走|公開後の検索精度を改善する
利用者の質問、検索失敗、回答できなかった内容を確認し、データ、分割、検索、回答ルールを修正します。更新担当者と改善サイクルを決め、作って終わる状態を防ぎます。
LlamaIndex、LangChain、既製RAGサービスのどれを選ぶべきか迷っている場合は、対象業務とデータの状態から整理できます。
▶️ サービス資料のダウンロード(資料請求)
▶️ 無料カウンセリング・AI活用診断のご予約
この記事が参考になりましたら、今後の記事づくりの励みになるので、スキをお願いします。
参考資料
LlamaIndex Framework|LlamaIndex|2026年8月16日閲覧
Introduction to RAG|LlamaIndex|2026年8月16日閲覧
LlamaParse Platform Quickstart|LlamaIndex|2026年8月16日閲覧
#LlamaIndex #LlamaParse #LlamaCloud #RAG #生成AI #AI #AIエージェント #LLM #社内AI #社内検索 #ナレッジ検索 #ドキュメント検索 #PDF解析 #OCR #ベクトル検索 #ベクトルデータベース #埋め込み #チャットボット #Python #TypeScript #プログラミング #AI開発 #システム開発 #業務効率化 #業務改善 #DX #自動化 #企業AI #法人AI #生成AI導入 #AI導入 #AI活用 #AI研修 #生成AI研修 #AIコンサル #AIエージェント開発 #データ活用 #セキュリティ #PoC #AIworker
