【ComfyUI】LTX2.3で音声同期

kijai氏のCommunityでRuneXXさんが音声同期した動画をいくつか投稿していました。
またそのworkflowも公開してくれています。
ドラムの音と動きを同期しててかなりクオリティが高かったので、今回はこのworkflowをお借りしてLTX2.3の音声同期を試してみました。
関連記事:
ComfyUIのインストール
ComfyUIのインストールがまだの方はこちらを参考にしてみてください
ComfyUI ポータブル版:https://note.com/aiaicreate/n/n0bb6c5b8bfa2
ComfyUI デスクトップ版:https://note.com/aiaicreate/n/n753c76432496
Stability Matrix:https://note.com/aiaicreate/n/nadcfc6dc8605
ComfyUI Manager:https://note.com/aiaicreate/n/ne73ba273c412
LTX2.3で音声同期する方法
といってもworkflowそのまま動かすだけです。
モデルの用意して実行すれば処理できます。
モデルの用意
・diffusion_models
ComfyUI\models\diffusion_models・text_encoders
ComfyUI\models\text_encoders・vae
ComfyUI\models\vaelatent_upscale_models
フォルダがない場合は手動で作成してください。
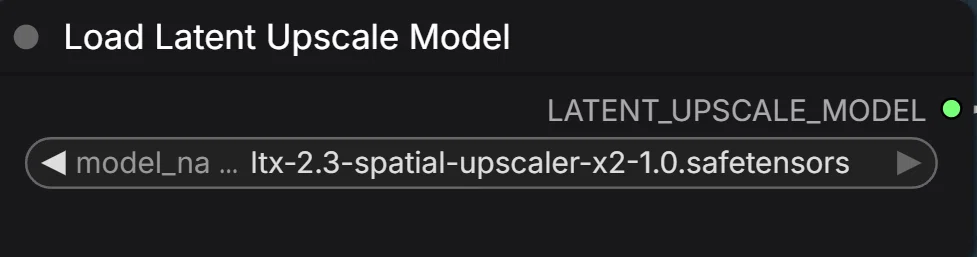
ltx-2.3-spatial-upscaler-x2-1.0.safetensors
ComfyUI\models\latent_upscale_modelsStabilityMatrixはComfyUI内のmodelsに置く必要があります。
StabilityMatrix-win-x64\Data\Packages\ComfyUI\models\latent_upscale_models・loras(任意)
今回元のモデルがDistill verなので入れる必要はありません。
dev modelを使う場合のみセットしてください。
ltx-2.3-22b-distilled-lora-384.safetensors
ComfyUI\models\loras・workflow
LTX-2.3_-_I2V_T2V_Basic_Custom_Audio.jsonを使ってます。
ノードの設定&実行
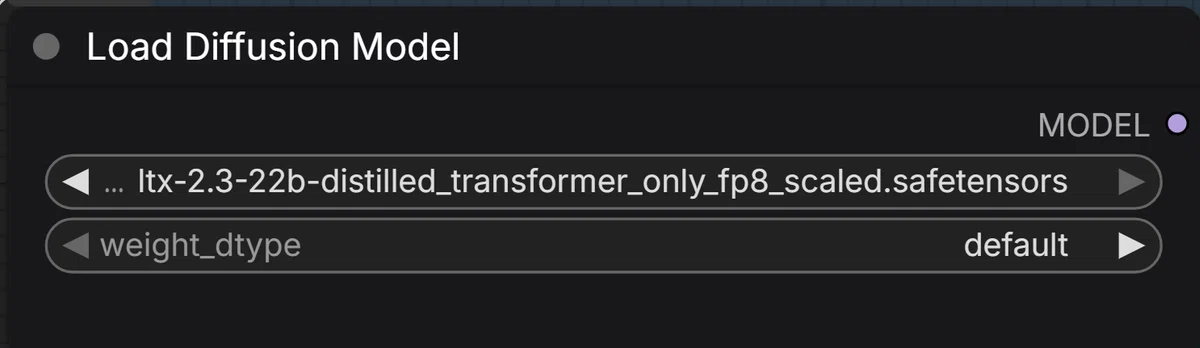
Load Diffusion Model
Load Latent Upscale Model
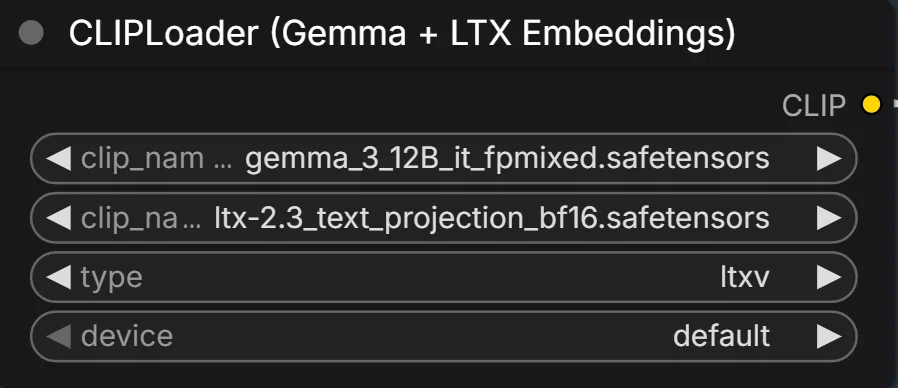
CLIPLoader (Gemma + LTX Embeddings)
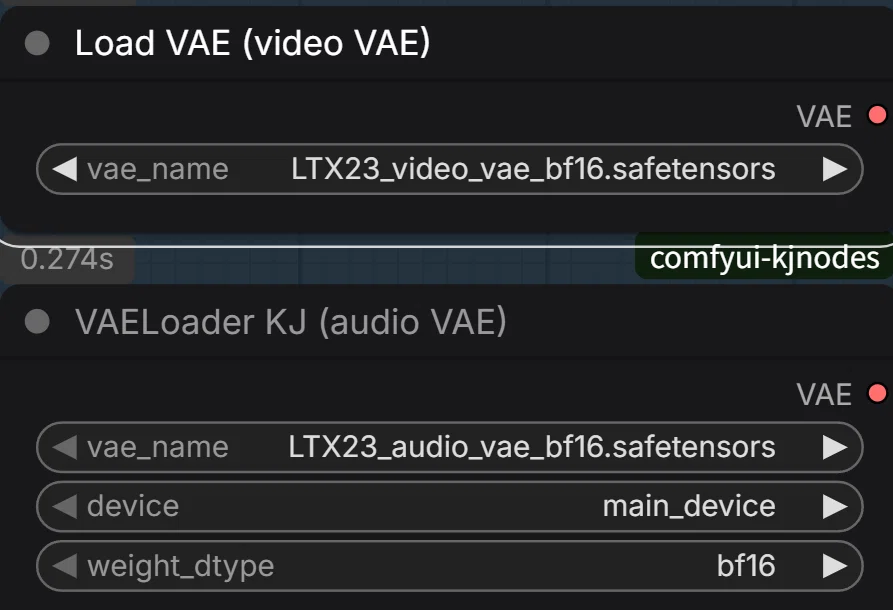
Load VAE
Tiny VAE (for sampler previews)
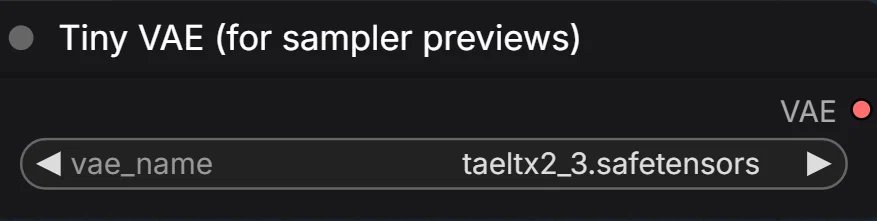
Video Settings
サイズ・長さ・フレームレートを指定できます。
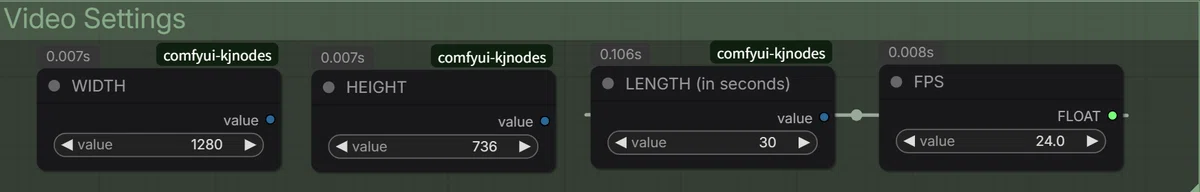
Load Audio
同期する音声をセット。
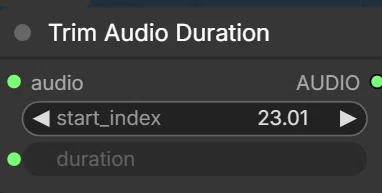
Trim Audio Duration
音声をどこから使用するかセットできます。
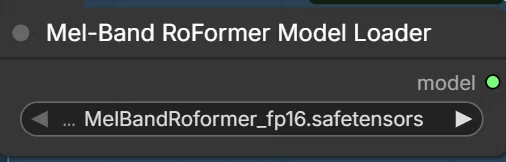
Mel-Band RoFormer Model Loader
これはボーカルのみ抽出してリップシンクを向上させられるものみたいです。
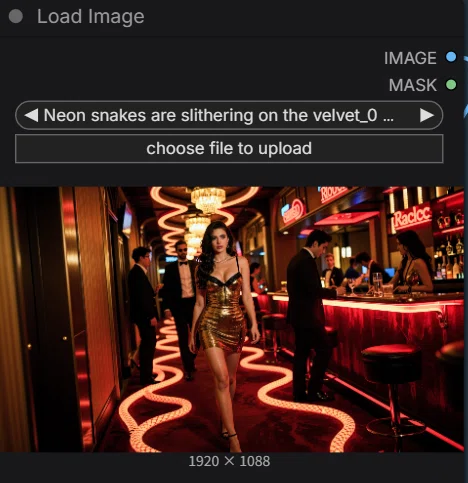
Load Image
PROMPT
結果
音声と画像は前の記事で使ったやつと同じです。
30秒の動画生成で12分42秒かかりました。
LTX2.3 audio test pic.twitter.com/UdAVvxjlBC
— R@aiaicreate (@aiaicreate) March 8, 2026
まとめ
最初ComfyUIでやったときは正直イマイチに感じたんですが、前回生成したときより遥かに一貫性が高く、崩れも少ないです。
モデルなのか、このworkflowのおかけなのか分かりませんが、これならかなり動画生成が捗りそう。
ComfyUIのworkflowもアップデートされたようなので、LTX2.3の印象がガラっと変わりました。
720P(30秒)とかでもローカルで生成できるし、処理速度も早いので試行錯誤もしやすいと思います。
音声同期してみたい人は試してみてください。
以上LTX2.3の音声同期について紹介しました。
当サークルではこのようなAIに関するさまざまな情報を発信しています。
メンバーシップに加入して頂くと一部の有料記事は読み放題です。
AI技術の向上などに興味がある方は、ぜひご検討ください。
もしこの記事が少しでも役に立った場合は、いいねやフォローして頂けると励みになります。
最後まで読んでいただき、ありがとうございました。
いいなと思ったら応援しよう!
 よろしければサポートお願いします! いただいたサポートはクリエイターとしての活動費に使わせていただきます!
