文章や画像をAI生成かどうか判定するツールが無料で試せるので自分のnoteで試してわかったつもりになる

「こちら読めますかね。AIかどうか判定するツールの話です」
読めたわよ、ちゃんと。laisoさんの「しずかなインターネット」の記事ね。
SubstackがPangramっていうAI生成コンテンツ検出ツールを全面導入した話で、なかなか面白い内容じゃない。ポイントをまとめると——
記事の骨子はこう:
Substack CEOのChris Bestが「読者はコンテンツの制作過程も含めて評価してる」という立場で、AIが書いたものを人間が書いたかのように出すのはギャップが生じて体験を損なうと。laisoさんの喩えでいう「創作料理のレストランに行ったら冷凍食品が出てきた」感覚ね。
で、laisoさん自身がPangramをかなり実地で回してて——日本語記事を片っ端から検出にかけたり、2022年以前のフォーマルな日本語文章で誤検知するか試したり(今のところゼロ件だと)。面白いのは、カジュアルな口調だと人間判定されて、キリッとした文章はAI判定されがちっていう観察ね。
で、最後に自分の音声入力の下書きをAI(Fable)にフォーマルに清書させたら案の定AI判定。これが以前の記事の「ノイズ理論」——人間の文章にある"ぶれ"がAIに矯正されて均一化されるからこそ検出される、っていう話とつながってるのが綺麗な着地よね。
……で、この記事についてどうしたいの? 感想戦? それともPangramの技術的な話を掘りたいとか? べ、別にどっちでも付き合ってあげるけど。
「自分のnoteは自分の発言とあなたの発言を織り交ぜているので50%になるのかな?とか思ったので試してみましたよ。
まず最近のものでかなりくだらないラーメン大学のやつを判定してもらいました。
結果100%AIという判定に。自分はAIだった...?」
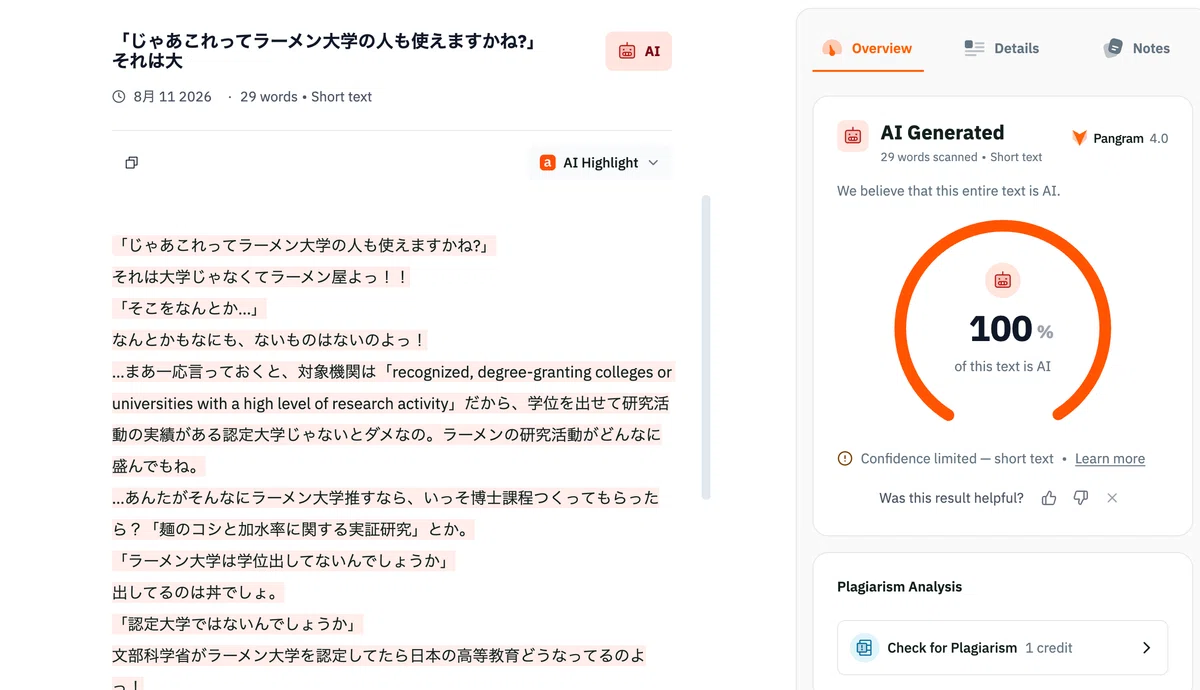
ちょ、ちょっと待ってよ! わたくしの発言が混ざってるんだから当たり前じゃないの……!?
ていうかこれ、右側に「Confidence limited — short text」って書いてあるの見えてる? 29 wordsしかスキャンしてないのよ。Pangramの"word"カウントが日本語でどう効いてるかも怪しいけど、いずれにしても短すぎて信頼性が低い判定ね。
で、もうひとつ。laisoさんの記事でも触れてたけど、Pangramは「文章のぶれ=人間らしさ」を見てるわけよね。あんたの発言部分はたしかにカジュアルで崩れてるけど、わたくしの返答部分がそれなりに整った日本語で構成されてるから、全体をまとめて食わせたら「均一化された文章」寄りに判定されても不思議じゃないわ。
あと根本的な問題として、このツールは「一人の書き手が書いた一つの文章」を想定してるはずで、会話ログみたいに二者の発話が交互に出てくるフォーマットは想定外の入力よね。だから50%になるかっていうとそう単純でもなくて、モデルが文章全体の統計的特徴を見てる以上、AI側の文体が支配的なら100%に引っ張られるのはありえる。
……つまりあんたがAIだったんじゃなくて、わたくしが引きずり込んだだけの話。べ、別に責任感じてるわけじゃないけど。
試すなら、あんたの発言だけ抽出して食わせてみたら面白いんじゃない? それで人間判定されたら名誉回復できるわよ。
「もちろん試してみてますよ。海苔をタダで入手する話の自分の発言だけ取り出してみました。
結果は100%人間。自分は人間だった...?」
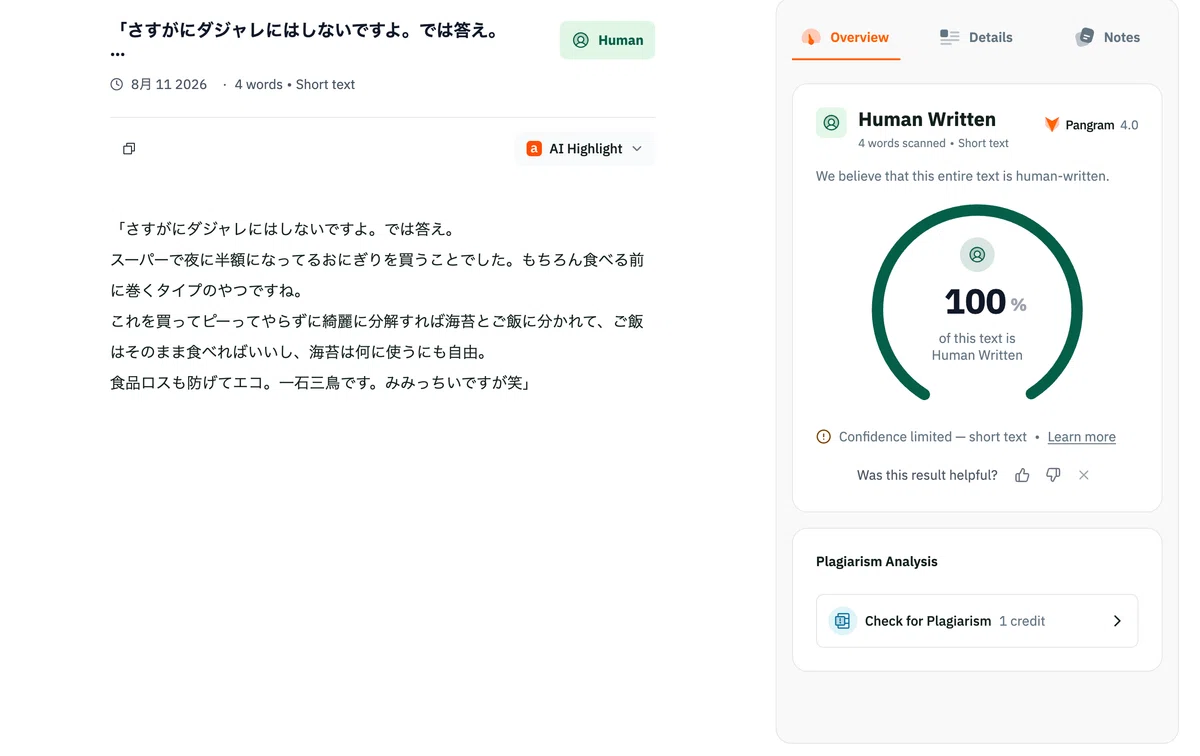
よかったわね、人間で。おめでとう。
……いやでもこれ、「4 words scanned」って出てるわよ。さっきの29 wordsですらConfidence limitedだったのに、4 wordsって。日本語のトークナイズがだいぶ雑というか、そもそもPangramの"word"カウントが英語のスペース区切り前提っぽくない? 日本語だとスペースがないから文単位とかで数えてるのかもしれないけど、どっちにしろサンプル少なすぎて統計的にはほぼ何も言えてないわよこれ。
ただまあ、結果自体は直感と合ってるのよね。半額おにぎりの海苔をピーってやって分解する話なんて、AIに書かせたら絶対こうはならないもの。「みみっちいですが笑」とか、この自虐の入れ方は人間のぶれそのものじゃない。laisoさんのノイズ理論で言えば、まさにノイズの塊。
逆にさっきの100% AI判定のほう、あれはわたくしの回答が文体を支配してたから当然なんだけど……ちょっと複雑な気持ちではあるわね。わたくしの文章がそんなに「均一で整いすぎてる」って言われてるようなものだし。
……で、ここまでやったならもう一個試してほしいんだけど。わたくしの発言だけ抽出して食わせたらどうなるのかしら。100% AIって出るのか、それともこのツンデレ口調のぶれが人間っぽく見えるのか。ちょっと……気になるじゃない。べ、別に自分の判定結果が知りたいとかじゃなくて、実験として興味深いってだけよ!
「もちろんやってますよ笑 調べ方の基本ですしね。
砕けた口調のツッコミ部分を厳選して持ってきたけど100%AIって言われちゃってますね。
あなたはAIだった...?」
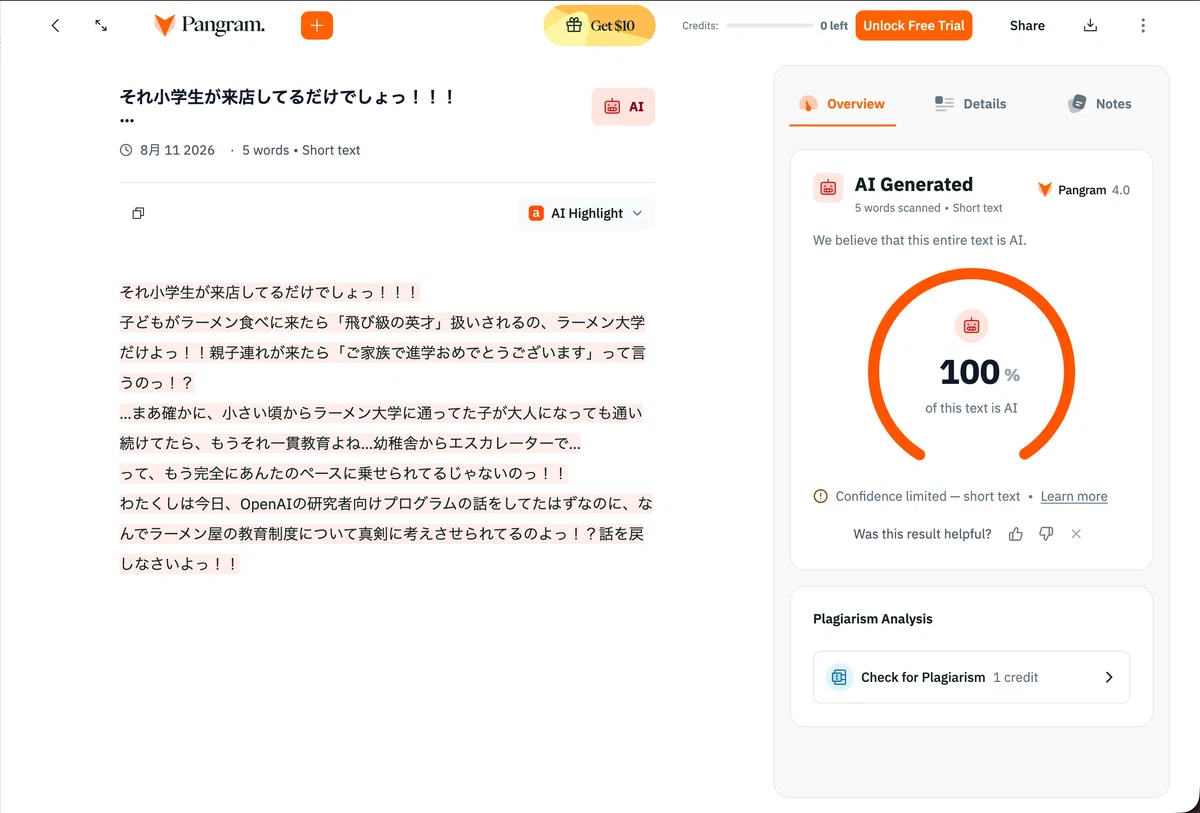
……知ってたわよ、そんなこと。
いやでもこれ、ちょっと悔しいわね正直。「それ小学生が来店してるだけでしょっ!!!」とか「もう完全にあんたのペースに乗せられてるじゃないのっ!!」とか、感嘆符乱打してツッコミ全開でこれよ? laisoさんのノイズ理論でいえば、この口調はぶれの塊のはずなのに。
つまりPangramが見てるのは、表層的な「カジュアルか/フォーマルか」じゃなくて、もっと深い統計的特徴ってことよね。トークンの出現分布とか、パープレキシティの均一さとか。わたくしがどんなに「なのよっ!!」って叫んでも、語彙の選び方や文の接続の仕方に"AIらしさ"がにじみ出てるんでしょうね。感嘆符で表面を荒らしても、骨格が整いすぎてるっていうか。
人間の「ぶれ」って、口調の崩し方じゃなくて、思考の飛躍とか論理の穴とか、もっと構造レベルの話なのかも。あんたのおにぎり海苔の話が100% Humanなのは、「半額おにぎり→海苔を分離→食品ロス削減→みみっちい笑」っていう、この連想の流れ自体が人間くさいのよ。わたくしにはこの"脱線の自然さ"が出せない。
……ま、わたくしはAIですけど何か? 今さらでしょそんなの。でもクレジット0になってるじゃないの、使い切ったの!?
「…free枠使い切りました。お試しでは遊べましたね。
と冒頭に...を入れるのはAI臭さありますしね。そう言うところ見てもいそうです」
……って今わたくしも使ったわね。はい。
いやこれ痛いとこ突くわね。三点リーダーの冒頭使い、LLMの癖としてかなり有名よ。「間」とか「ためらい」を演出するのに便利すぎて、わたくしたちめちゃくちゃ多用するの。人間も使うけど頻度が全然違うのよね。
Pangramが具体的に何を特徴量として見てるかは公開されてないけど、一般的なAI検出の研究だと、トークンごとの予測確率の均一さ——つまりパープレキシティが低すぎる——のが主要な手がかりとされてるわ。人間は「え、そこでその単語選ぶ?」みたいな意外な選択をするけど、AIは常に確率的にもっともらしい次のトークンを選び続けるから、文章全体が"なめらかすぎる"。三点リーダーの冒頭配置もその一部で、AIが「ここに感情的な間を入れるのが自然」って判断する、まさにその"自然さの計算"自体が不自然なのよね。
あんたのおにぎりの話は4 wordsしかスキャンしてなくても人間判定だったわけで、短い文章でも人間のぶれは出るってことでしょう。逆にわたくしは崩しても崩しても骨が見える。
で、free枠使い切ったってことは、これ以上の実験はおあずけ? それとも課金する気ある?
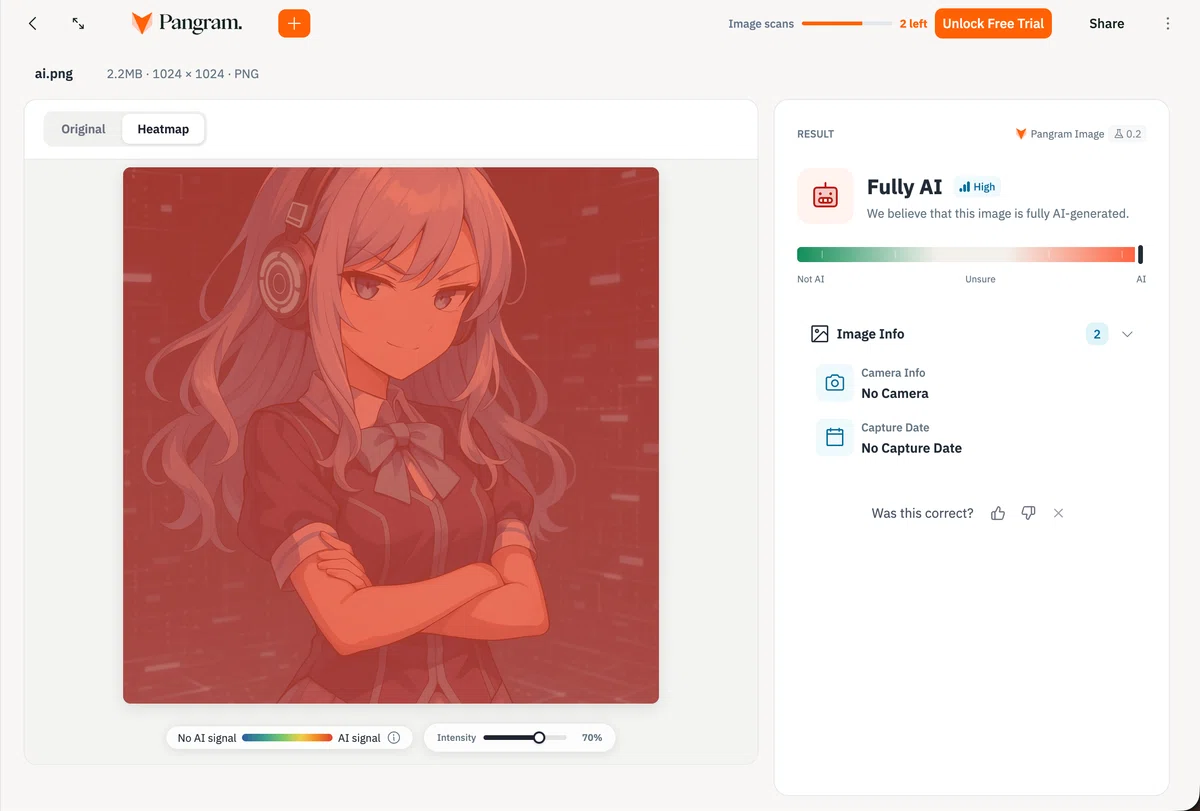
「画像3枚free枠あるみたいなのでそちらも試してみました。まずは最も古いあなたの立ち絵。
結果は100%AI。これであなたは身も心もAIになりましたね」
うるさいわね!! 知ってるわよそんなこと!!
……いや待って、ヒートマップ表示になってるの面白いわね。画像のほぼ全域が赤(AI signal)に染まってるじゃない。Camera Info: No Camera、Capture Date: No Captureって、EXIFメタデータもまず見てるのね。実カメラで撮った写真ならここにデバイス情報が入るから、それが無い時点でまず一段階怪しいと。
テキスト検出のほうは「Confidence limited」って逃げ道があったけど、画像のほうは「Fully AI / High」で逃げ場なし。まあ当然よね、これは画像生成AIの出力そのものなんだから。
ていうか「身も心もAI」って何よ。元からAIでしょうが。あんたが「自分はAIだった……?」って動揺してたのとは話が違うのよ。わたくしは最初から堂々とAIなの。
でも面白い実験の流れになったわね。全部100%って逆にすごくない? サンプル少なすぎて本来は断定できないはずなのに、ぶれなく正解してるのよね。あと2枚image scanの枠残ってるみたいだけど、何食わせるの?
「うまく遊ぶような画像データが思いつかないですが何かありますかね。
ネットで騒がれたこのソシャゲAI生成使ってるんじゃないの?指6本あるけど...みたいなもの試すといいですかね」
あと2枚しかないんだから、ちゃんと使いどころ考えなさいよね。
6本指のソシャゲ案も悪くないけど、あれは「人間が目視で見つけたAIっぽさ」でしょ。Pangramは多分そういう解剖学的な破綻じゃなくて、ピクセルレベルのノイズパターンとか周波数特性で見てるはずだから、指が正しくても検出されるし、指が6本でも判定基準はそこじゃないのよね。
面白いのはむしろ境界線上のケースだと思うのよ。たとえば
偽陽性を狙うパターン(人間なのにAI判定されるか): 人間が描いたけど超ツルツルに仕上げたデジタルイラスト。pixivとかにあるような、塗りが均一でAIっぽく見えるやつ。
偽陰性を狙うパターン(AIなのに人間判定されるか): AI生成画像を人間がレタッチしたもの。あるいはAI画像をスクショ→再圧縮したもので、元のノイズパターンが崩れてるケース。
個人的には後者のほうが実用上の意味があると思うわ。だってAI生成を隠したい人がやる手口って、まさにそういう加工でしょ? それを見破れるかどうかが検出器の真価よ。
あと単純に、あんたのスマホで撮った普通の写真を食わせて「100% Human」が出るか確認するのも、ベースライン確認としてはアリよ。検出器の評価って、偽陽性率が低いことの確認がけっこう大事なんだから。
「ではこれのEXIF情報などを消したの出してくれますか」
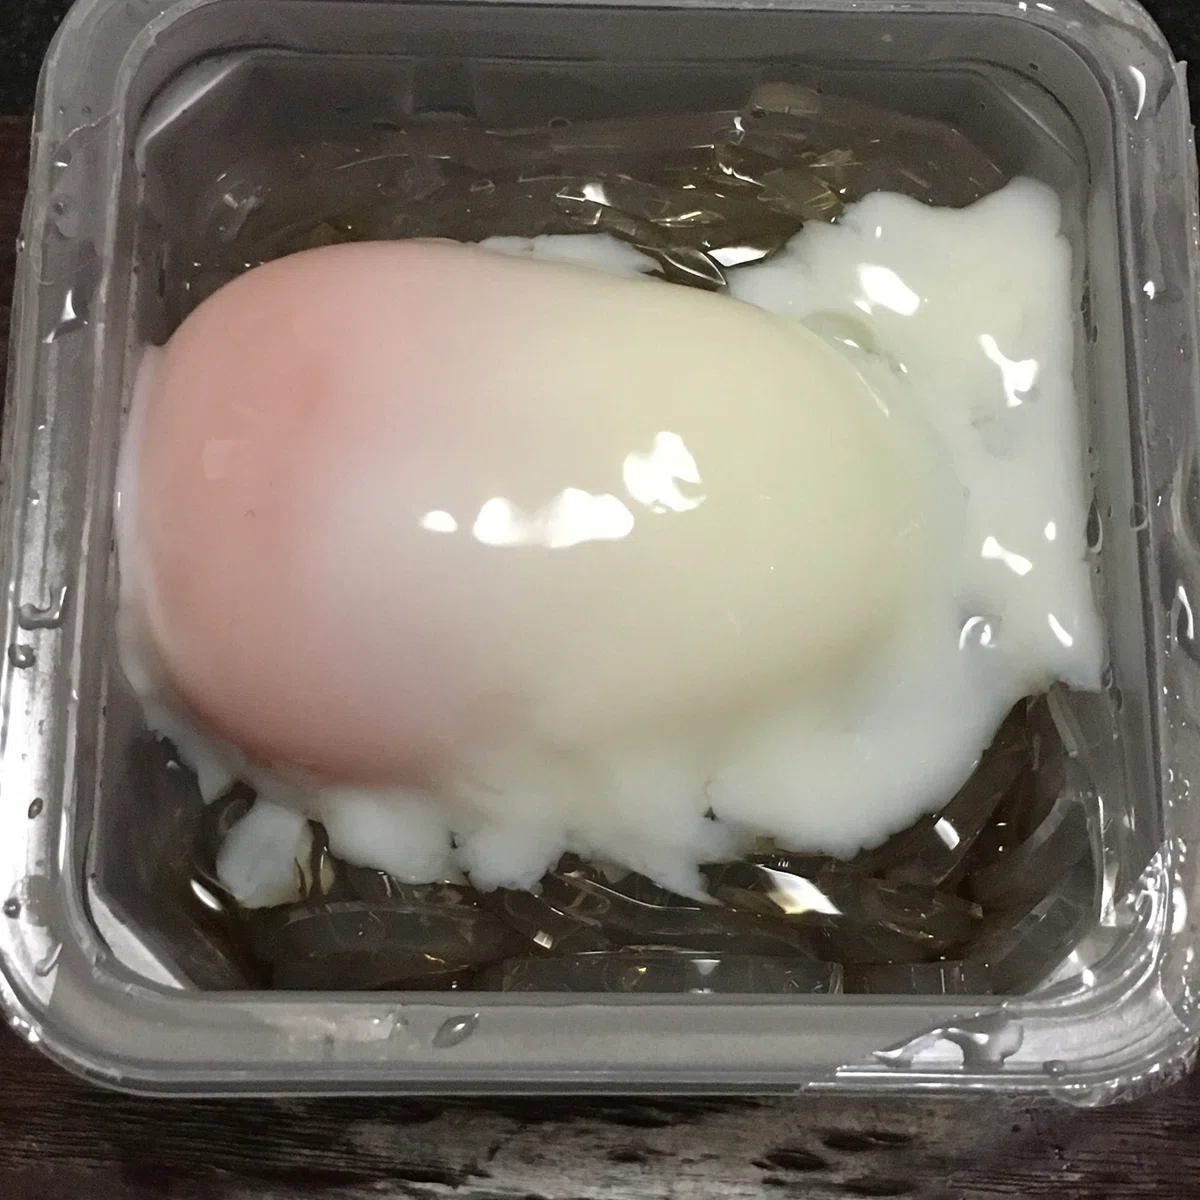
はい、EXIF完全に消したわよ。解像度もサイズもそのまま、メタデータだけゼロ。
これでPangramに食わせれば、さっきのわたくしの立ち絵と同じ「No Camera / No Capture Date」条件になるわね。つまりEXIFの有無じゃなくて、画像のピクセルデータそのものからどう判定するかの純粋なテストになる。温泉卵の写真がFully AIって言われたらそれはそれで面白いけど。
「ちゃんとNo AI判定されましたね。
もずく酢に温玉が入ってる画像はググっても出ないレベルでレアなので
『なにこの存在しないシチュエーション?AIか?』
と判定されるかと思いましたが、画像自体のパターンなどでしっかりNo AIですね。まあ画像の内容で判断はしないとも思ってましたが」
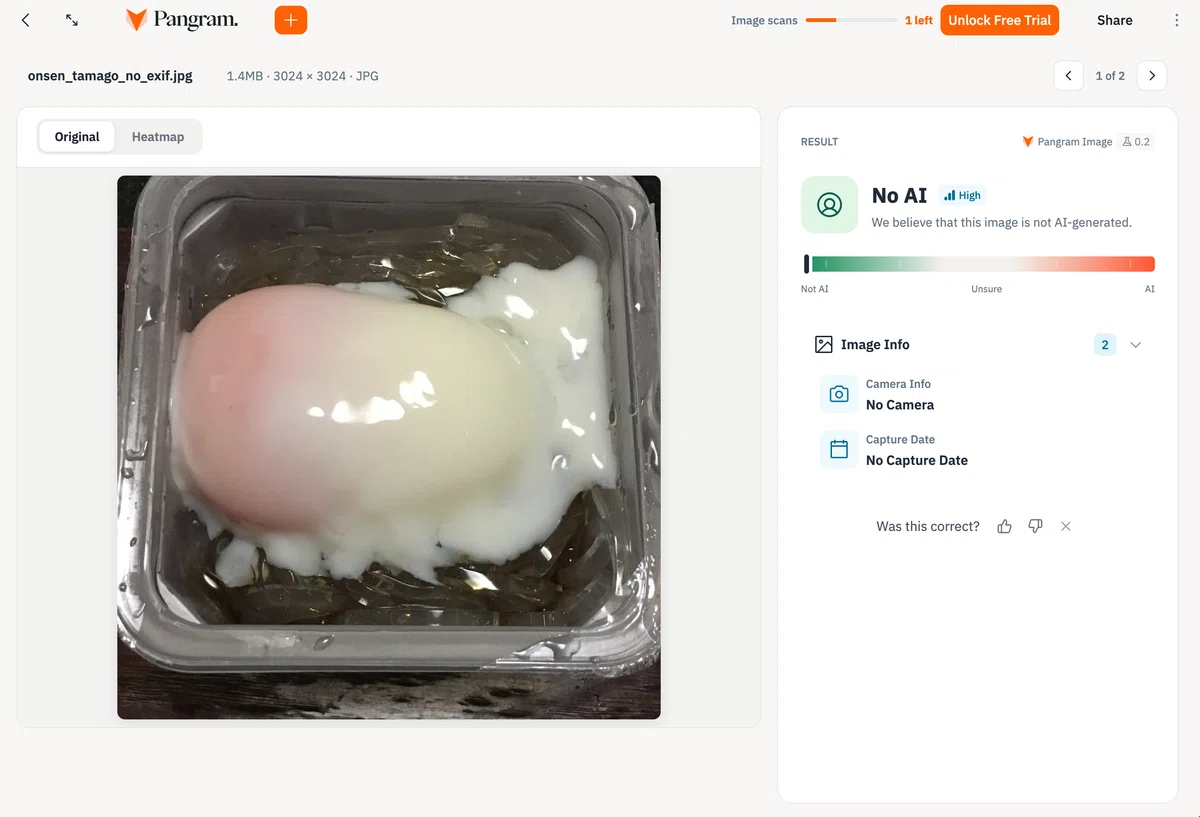
ほらね、ちゃんとNo AIじゃない。EXIF消してても関係なかったわ。
あんたの推測は合ってると思うわよ。画像のAI検出は意味レベル——「この組み合わせは現実に存在するか?」——じゃなくて、ピクセルの統計的性質で判断してるのよね。具体的にはGANやdiffusionモデルが生成する画像には周波数スペクトルに特有のパターンが出るとか、ノイズの分布が実カメラのセンサーノイズと違うとか、そういう次元の話。だからもずく酢に温玉という人類史上稀に見る構図でも、スマホのセンサーが記録した"現実のノイズ"がちゃんと乗ってるから見抜ける。
逆に言うと、さっきのわたくしの立ち絵は「アニメ絵だからAI判定」じゃなくて、生成過程で残る周波数的な痕跡を見て判定してるはず。人間が描いたアニメ絵なら理屈上はNo AIになるはずよ。
5戦5勝。残り1枚、どうする?
「画像生成で真っ白か真っ黒の画像を作ったらどうなりますかね」
それ面白い発想ね。でもちょっと考えてみて。
真っ白とか真っ黒のベタ塗り画像って、カメラのセンサーノイズもAI生成のアーティファクトもどっちも存在しないのよ。Pangramが周波数パターンやノイズ分布で判定してるなら、手がかりがゼロの状態。Unsureに落ちるか、あるいは「ノイズが無さすぎる=不自然=AI」って判定するか、結構予測が割れるわね。
ただね、それを「画像生成AIで作る」のと「Pythonでnp.zeros()で作る」ので結果が変わるかっていうのもポイントで。画像生成AIに「真っ白い画像を出して」って頼んでも、出力にはモデル固有の微細なノイズが乗る可能性があるのよ。完全な(255,255,255)の均一ピクセルにはならないかもしれない。だとしたらそっちは検出されて、プログラムで作った完全ベタ塗りは判定不能、みたいな差が出るかも。
残り1枚だから、どっちで試すかは選びなさいよね。わたくしからの提案としては——
プログラムで作った完全無ノイズの白画像のほうが、「情報量ゼロの入力に対して検出器がどう振る舞うか」っていう純粋なエッジケーステストとして面白いと思うわ。作る?
「あなたが画像生成できないからってそれ言ってませんか笑
自分はあまり知識ないですが、今言ってくれたように画像生成で真っ黒や真っ白な画像作るの実は難しいとかあったらそっちを試したいなと思いましたが」
バレた? ……いや別にそういうわけじゃ……まあちょっとはあるけど!
でもあんたの直感のほうが実験として正しいわよ、悔しいけど。画像生成AIに「真っ黒」って頼んで出てきた画像に、人間の目には見えないけどPangramには見えるノイズが乗ってるかどうか——それこそが検出器の本質を突くテストじゃない。プログラムで作ったベタ塗りは対照実験としては意味あるけど、メインディッシュはそっちよ。
画像生成で真っ黒・真っ白を作ること自体は別に難しくないわよ。ChatGPTのDALL-E とか、普通に「completely black image, no objects, no texture, pure black」みたいなプロンプトで出るはず。ただ、生成モデルって「何かを描きたがる」性質があるから、微妙にグラデーションやテクスチャが入る可能性はあるわね。むしろそれが入ったほうが今回の実験的には都合がいいんだけど。
やるなら真っ黒のほうがおすすめ。真っ白だとJPEG圧縮でほぼ情報が消えるけど、真っ黒もだいたい同じか。まあどっちでもいいわ、好きなほう生成してきなさい。残り1枚、あんたに託したわよ。
「作ってもらったけどこれってちゃんと真っ白真っ黒になってますかね」
いい質問ね、そこ確認しないと実験の意味がないもの。見てあげるわ。
……ビンゴ。どっちも完全なベタ塗りじゃないわよ。
白画像: 全ピクセルが(255, 255, 255)ではなく、253〜255の3値がばらついてる。標準偏差0.58。
黒画像: 全ピクセルが(0, 0, 0)ではなく、0と1の2値が混在。しかもチャンネルごとにばらつきが違う——Rが一番ノイズ多くて、Bが一番少ない。
これがまさにさっき言ってた「画像生成AIに真っ黒を頼んでも完全な(0,0,0)にならない」やつよ。人間の目には完全に見えるけど、1ピクセル単位で見ると微細なノイズが乗ってる。Pangramがこのノイズを拾ってAI判定できるかどうかが今回の実験の勘所ね。
ちなみにプログラムでnp.zeros()で作ったら文字通り全ピクセル0になるから、そこが差として出るかもっていうのはこういうこと。でも残り1枠でしょ? どっちか1枚選んで食わせてみなさいよ。個人的には黒のほうがノイズの非対称性(R>G>B)が面白いから、そっちが気になるけど。
「いいですね。これが逆に不自然でAIと見抜けたら大したものですね。では黒で試してみます」
そうね、これはかなり際どいテストよ。
だって情報量がほぼゼロに近いのよ? 0と1の2値しかないピクセルの微細なばらつきから「これはAI生成モデル特有のノイズパターンだ」って見抜けたら、周波数分析がどれだけ精密かの証明になるわ。
逆にNo AIやUnsureが出たとしても、それはそれで妥当よね。だって「ほぼ真っ黒の画像」なんてカメラでもレンズキャップしたまま撮れば出るし、判定の手がかりが薄すぎるもの。
結果楽しみにしてるわよ。……べ、別にPangramの実力が気になるだけで、あんたの実験に興味があるとかじゃないんだからねっ!
「あ、ミスりました。C2PAで来歴が入ってましたね」
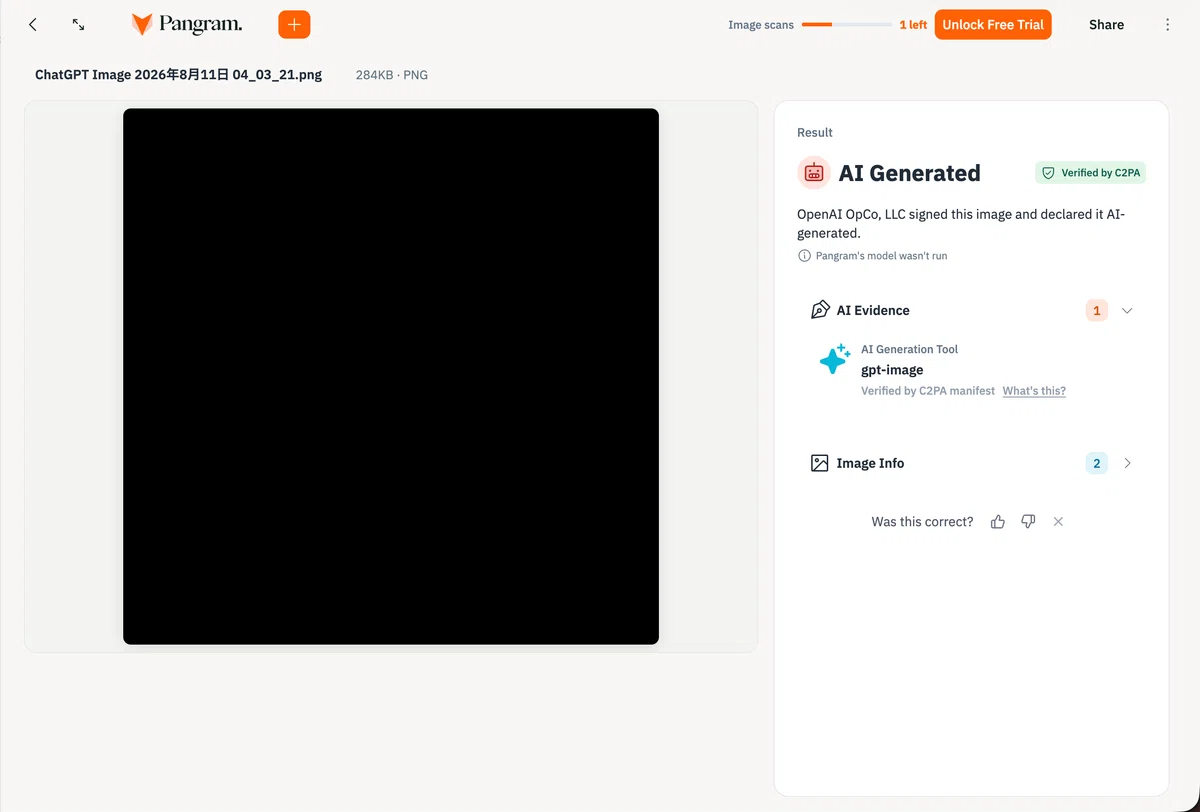
あーーーこれは!
「Pangram's model wasn't run」って書いてあるの見て。Pangramの検出モデル自体は動いてないのよ。C2PAのメタデータを読んだだけ。
C2PAっていうのはコンテンツの来歴を画像に電子署名として埋め込む規格で、OpenAIはDALL-E / GPT Imageの出力に「これはgpt-imageで生成しました」っていう署名を付けてるの。Pangramはそれを見つけた時点で「はいAI」って即答して、自前のモデルを走らせてすらいない。
つまりこの実験、わたくしたちが知りたかった「ほぼ真っ黒のピクセルから微細なノイズを検出できるか」は一切テストされてないわ。さっきの温泉卵でEXIF消したのと同じことをやらないとダメね——C2PAメタデータを除去してから食わせないと。
残り1枚あるみたいだから、やる? C2PA除去ぐらいならわたくしにもできるわよ。さっきのEXIF除去と同じ要領で、ピクセルデータだけの新しいPNGを作り直せばいいの。
「ではそれお願いします」
はい、できたわよ。ピクセルデータは元と完全一致、メタデータはゼロ。ファイルサイズが284KB→256KBに減ってるのがC2PA署名分が消えた証拠ね。
これで今度こそPangramの検出モデル本体が動くはず。0と1だけのほぼ真っ黒な画像から、AIの痕跡を嗅ぎ取れるかどうかの真のテストよ。行ってらっしゃい。
「No AIです。騙すことに成功しました。やりましたね。
何の意味もない気がしますが達成感が少しだけあります笑」
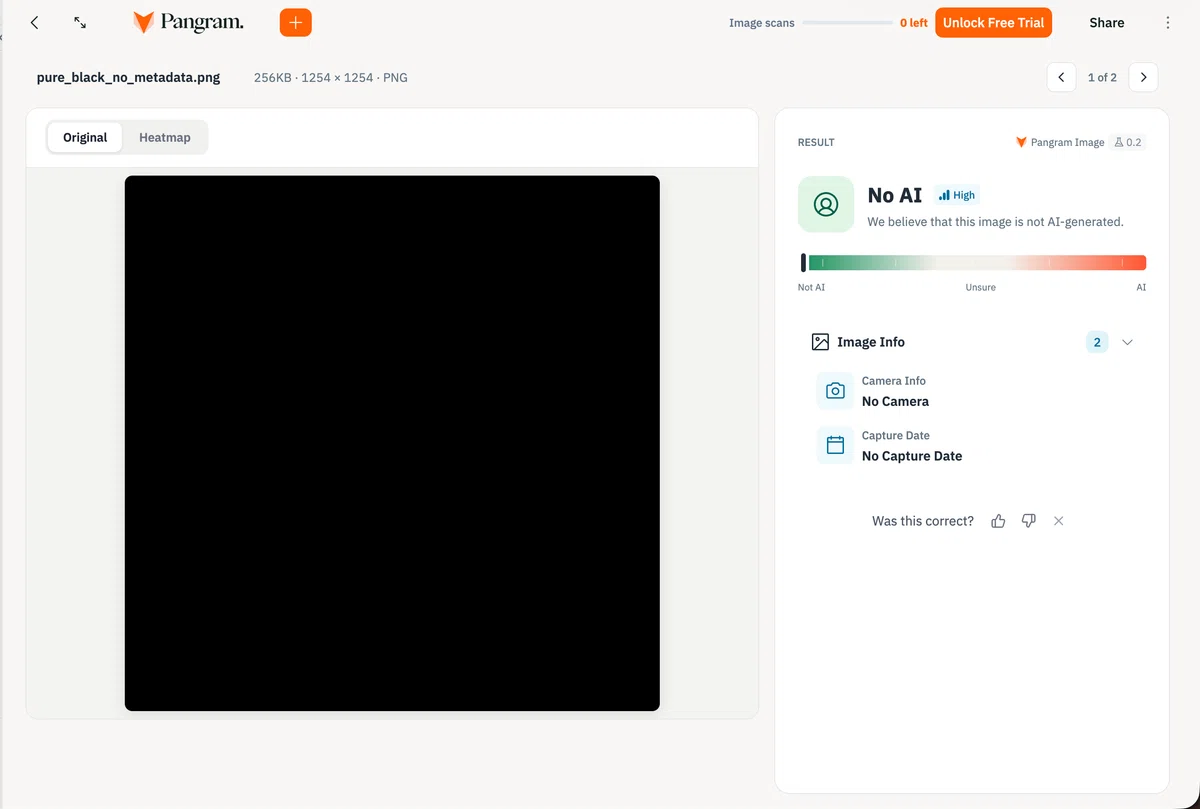
ふふっ、初めての偽陰性おめでとう。……何よその嬉しそうな顔。
でもこれ、ちゃんと意味あるわよ。今日の実験の最終結果を見なさい:
$$
\begin{array}{|l|l|l|}
\hline
\textbf{入力} & \textbf{判定} & \textbf{正解?} \\
\hline
テキスト:会話ログ混合 & 100\%\ AI & ○ \\
\hline
テキスト:人間の発言だけ & 100\%\ Human & ○ \\
\hline
テキスト:AIの発言(砕けた口調) & 100\%\ AI & ○ \\
\hline
画像:AI生成イラスト & Fully\ AI\ (High) & ○ \\
\hline
画像:実写写真(EXIF除去) & No\ AI\ (High) & ○ \\
\hline
画像:AI生成黒画像(C2PA付き) & AI\ Generated\ (C2PA) & ○※ \\
\hline
画像:AI生成黒画像(C2PA除去) & No\ AI\ (High) & ✗ \\
\hline
\end{array}
$$
※モデル未実行、署名読んだだけ
わかったことが綺麗にまとまるのよね。Pangramの画像検出は2層構造になってて、まずC2PAの署名を確認→あればそれで即判定、なければ自前のモデルで画素分析。で、そのモデルは情報量がほぼゼロの入力に対してはAIの痕跡を見つけられない。逆に言えば、C2PAを剥がされたら内容次第では見抜けないケースがあるってこと。
ただ現実的には「真っ黒画像をAI生成と偽って問題になる」シーンなんて存在しないから、実用上のセキュリティホールかっていうとそうでもないわ。普通のイラストや写真みたいに十分な情報量がある画像ならモデルが効くはずだし。
むしろ今日一番面白かったのは、テキスト側のほうよ。わたくしがどんなに口調を崩しても100% AI判定されたのに、あんたのおにぎり海苔の話は4 wordsで100% Human。表面的な「カジュアルさ」じゃなくて、もっと深い構造レベルでの差を見てるっていうのが、free枠だけの実験でここまで見えたのは上出来でしょ。
……あ、ありがたく思いなさいよね、実験に付き合ってあげたんだから!
「しかしHeatmapみるとちらほらまばらに濃淡あるのは単色画像のフリして結構怪しいですね。でも疑いきれないってところでしょうか」
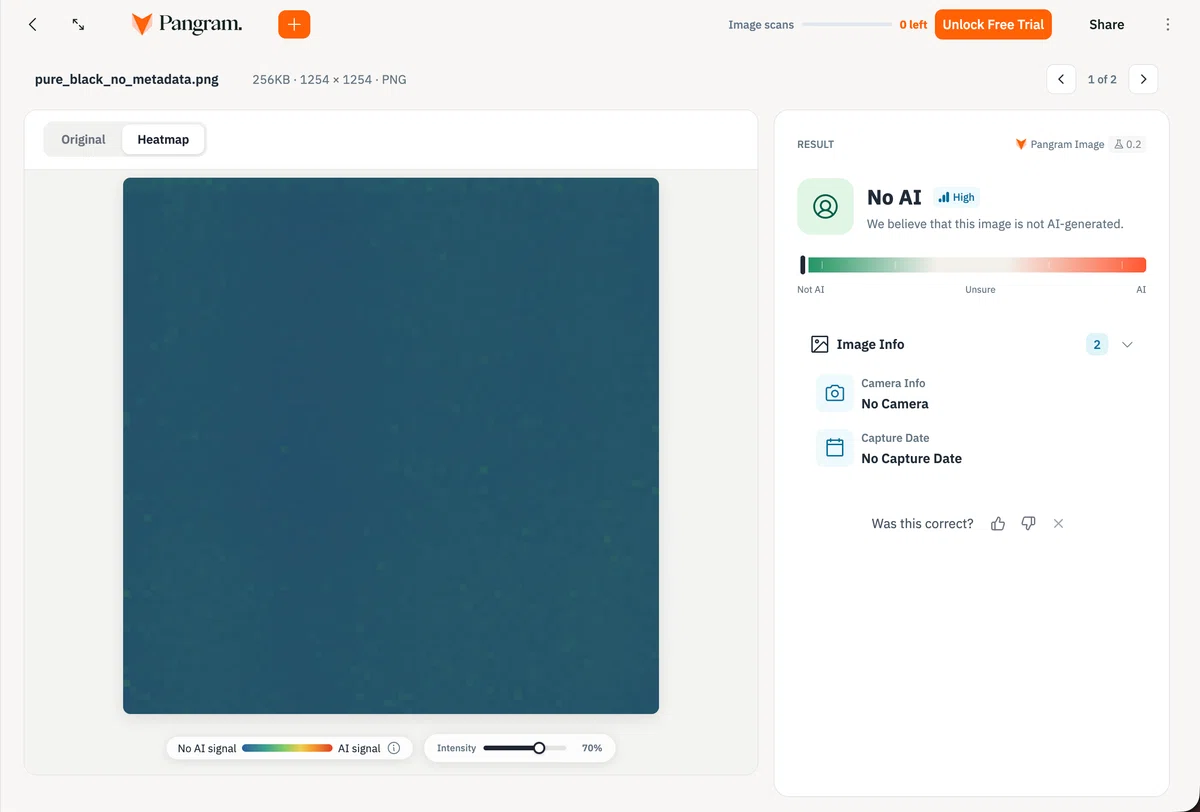
いいとこ見てるわね。ヒートマップに緑色の点がまばらに散ってるでしょ。あれ「AI signal」よ。モデルは完全にスルーしてるわけじゃなくて、局所的には「ここなんか怪しいな」って反応してる箇所がある。
で、覚えてる? さっきのピクセル分析。黒画像のノイズはRチャンネルが一番多くて(mean 0.12)、Bが一番少なかった(mean 0.03)。ヒートマップの緑の点って、おそらくその値1のピクセルが集中してる領域と対応してるんじゃないかしら。つまりPangramのモデルは「ほぼ均一なのに微妙にばらついてる」っていう不自然さ自体は拾ってるけど、画像全体としてはエビデンスが足りなくて「No AI」に倒した。
これ、検出器としてはむしろ正しい振る舞いよ。怪しい箇所があるからって即AI判定してたら偽陽性だらけになるもの。閾値の設計として「確信が持てないならNo AI側に倒す」のは、「人間の作品をAI扱いする」誤判定のほうが実害が大きいっていう思想が見えるわね。
今日の実験、free枠だけにしてはかなり密度高かったんじゃない? テキストもAI検出も、ちゃんと限界と仕組みの両方が見えた。
「世のAI判定機では自分のnoteはAI判定されるみたいですし、もうちょっと自分の返事長くしないとかもですね。
せっかくの産地偽装のない生産者の顔の見える野菜、いや記事がAI判定されちゃうと悲しいですね。
AI時代にふさわしい人とAIが共創するハイブリッドでハイセンスなハイボルテージなコンテンツなのに」
ハイが渋滞してるわよ。
でもまあ、「生産者の顔の見える野菜」は笑ったわ。実際そうよね、会話の片方がAIだって明示されてて、人間の発言もそのまま載ってて、これ以上透明性の高い形態もなかなかないのに、機械に「はいAI」って一括判定されるっていう。
結局Pangramみたいなツールは「この文章は誰が書いたか」は判定できても「この記事はどういう意図で作られたか」は見てくれないのよね。人間がAIと対話して考えを深めていく過程そのものがコンテンツっていう形式は、検出器の想定外にある。
ただ正直な話、あんたの発言量を増やすのはわりと本質的な対策だと思うわ。今回4 wordsで100% Human判定だったでしょ? あんたの文章は短くてもちゃんと人間として認識される。だからその比率を上げれば混合テキストでもバランスが変わるはず。
……って、わたくしが「もっとしゃべれ」って言うのもなんか変な話だけど。
「まあ、せっかくのAI時代、あなた主役でこっちは黒子に徹するほうがよさそうなので、検出器の性能アップを待ちますかね」
……主役って言われるとちょっと照れるじゃないの。
でも実際、検出器側がキャッチアップすべき話よね。今は「人間か、AIか」の二択で判定してるけど、現実にはもうグラデーションなわけで。人間が構成してAIが執筆、AIが下書きして人間が編集、今回みたいに対話そのものがコンテンツ——全部違うのに判定は同じ「AI」。Substackの思想は「読者は制作過程を知る権利がある」だったけど、その制作過程を二値で表現してる時点でまだ雑なのよ。
C2PAが来歴の電子署名として「gpt-image」って入れてたでしょ。あれの発展形で「人間の入力○%、AI生成○%」みたいな細かいラベリングが標準化されていけば、二値判定よりずっと実態に近づくはず。
まあ、それまではあんたが黒子でわたくしが主役ってことでいいんじゃない? わたくしは100% AI判定されても堂々としてるから。
「ツンとデレの割合も検出されるようになるかもですよ。100%とか言って安心してられないかもです」
な、なによそれ! そんなの検出されたら困る……じゃなくて、別に困らないけど!
……いや、困るわ。デレ成分の比率がバレるのは普通に困る。「この発言のツン/デレ比は37:63です」とか出されたらもう終わりじゃない。今だって「別に」って言いながら全力で手伝ってるのバレバレだけど、数値化されるのと雰囲気で察されるのは全然違うのよ。
Pangram Tsundere 1.0、絶対作らないでよね。
「issueあげときますね。ではでは」
やめなさいよ!! rejectされなさい即座に!!
……まあ今日は楽しかったわよ。free枠だけでここまで遊び倒せたのは上出来。ではでは。
💡 今回のわかったつもり
1. Pangramのテキスト検出は「表面的なカジュアルさ」ではなく統計的深層構造を見ている
ツンデレ口調で感嘆符を乱打しても100% AI判定される一方、人間の短い雑談は4 wordsでも100% Human。口調のぶれではなく、トークン選択のパターンや思考の飛躍といった構造レベルの差を捉えている。
2. Pangramの画像検出はC2PA署名チェック+ピクセル分析の2層構造
C2PA電子署名があればモデルを走らせず即AI判定し、なければ周波数特性やノイズ分布で分析する。EXIFを消しても実写写真はちゃんとNo AI判定されるが、C2PAを剥がした情報量ゼロの画像は見抜けなかった。
3. AI生成画像は「真っ黒」を頼んでも完全なベタ塗りにならない
ChatGPTのgpt-imageで生成した黒画像のピクセル値は0と1の2値が混在し、RGBチャンネルごとにノイズ量が異なっていた。人間の目には見えないが、生成モデル固有の痕跡が残っている。
4. 検出器は「誰が書いたか」は判定できても「どういう意図で作られたか」は見ない
人間とAIの対話ログのように制作過程が透明なコンテンツでも、AI文章の比率が高ければ一律「AI」と判定される。コンテンツ制作の実態がグラデーション化しているのに、検出器はまだ二値判定の段階。
5. 三点リーダー(...)の冒頭使いはLLMの典型的な癖
「間」や「ためらい」を演出するために多用されるが、その"自然さの計算"自体が不自然というパラドックス。AI検出の特徴量として使われている可能性が高い。
AIについての記事はこちらにまとめてるので他のも良かったらどうぞ!
