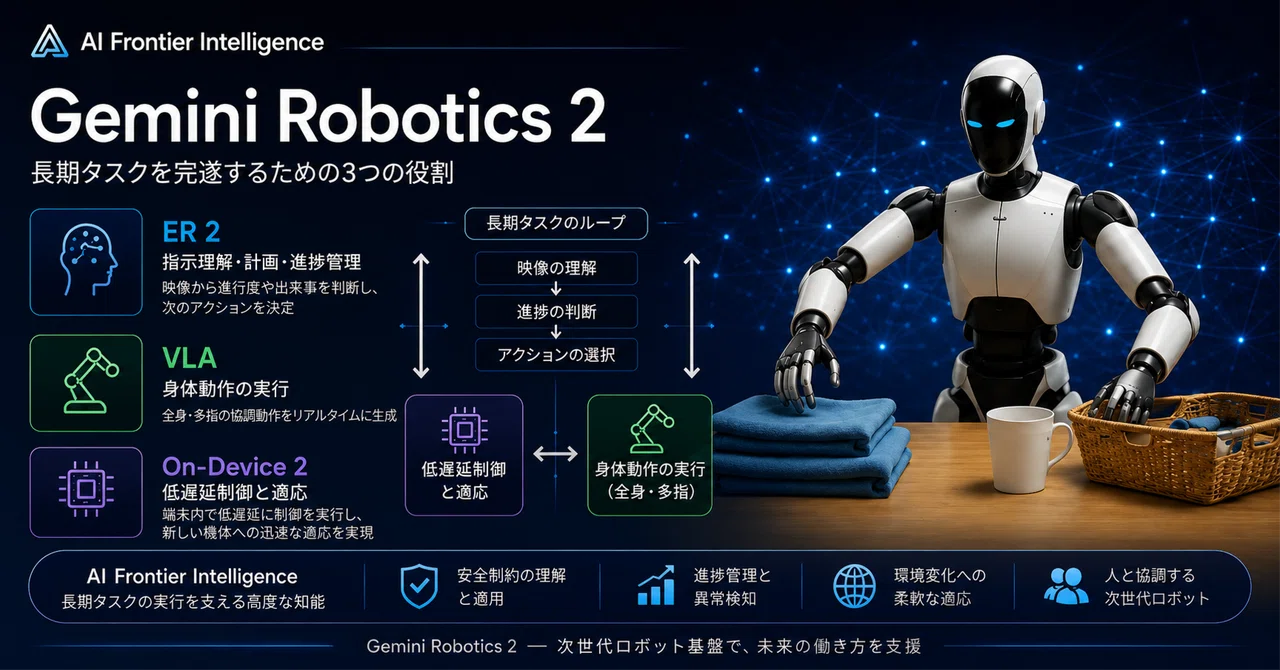
Gemini Robotics 2は全身を動かせるが、AI単独では安全停止を保証できない——実験室で人検出99%、時系列評価では見逃しと過剰停止を同時に抑えられず

人型ロボットが腕だけでなく、歩き、しゃがみ、手を伸ばし、物をつかみながら作業できるようになれば、倉庫、製造、点検、家庭支援など、導入可能な業務は大きく広がります。
一方で、動かせる身体の範囲が広がるほど、失敗したときの影響も大きくなります。
人が近づいたときに止まれるか。
曖昧な指示を勝手に解釈せず、人間へ確認できるか。
自分には実行できない作業を認識し、無理に動かないか。
Google DeepMindは2026年7月30日、ロボット向けAIモデル群「Gemini Robotics 2」を発表しました。
従来は主に上半身や卓上作業を対象としていた制御を、歩行や屈伸を含む全身動作へ拡張しています。複数工程の計画、作業進捗の認識、複数ロボットの協働、新しい機体へのオンデバイスモデルの適応も同時に発表されました。
ただし、公式デモでロボットが動いたことと、人の近くで安全に運用できることは同じではありません。
7月29日付の安全性技術報告では、実験室内のApptronik Apollo 2を使った評価で、人の検出精度99%、VLAが安全姿勢へ移行できた割合96%が報告されました。
一方、複数時点の画像から人への接近を判断する時系列のAgentic条件では、危険の見逃しを減らすと不要な停止が増え、不要な停止を減らすと危険を見逃すというトレードオフが残っています。
本稿では、Gemini Robotics 2が何を変えたのか、どの条件で評価されたのか、そして「安全に止まれるロボット」へ到達するには何が不足しているのかを整理します。
注目度:今すぐ読む価値が高い
編集部の要点
Gemini Robotics 2の重要性は、人型ロボットの全身を動かせるようになったことだけではありません。
高水準の意味理解が、そのまま安全な物理動作へつながるとは限らないことを、安全性評価によって示した点にあります。
企業が導入を判断するときは、タスク成功率だけでなく、危険の見逃し、過剰停止、曖昧な指示への確認、実行不能な作業の拒否、低レベル制御、認証済みハードウェアまで分けて評価する必要があります。
1.Gemini Robotics 2は、一つの万能モデルではない
Gemini Robotics 2は、単独のモデルですべてを処理する仕組みではありません。
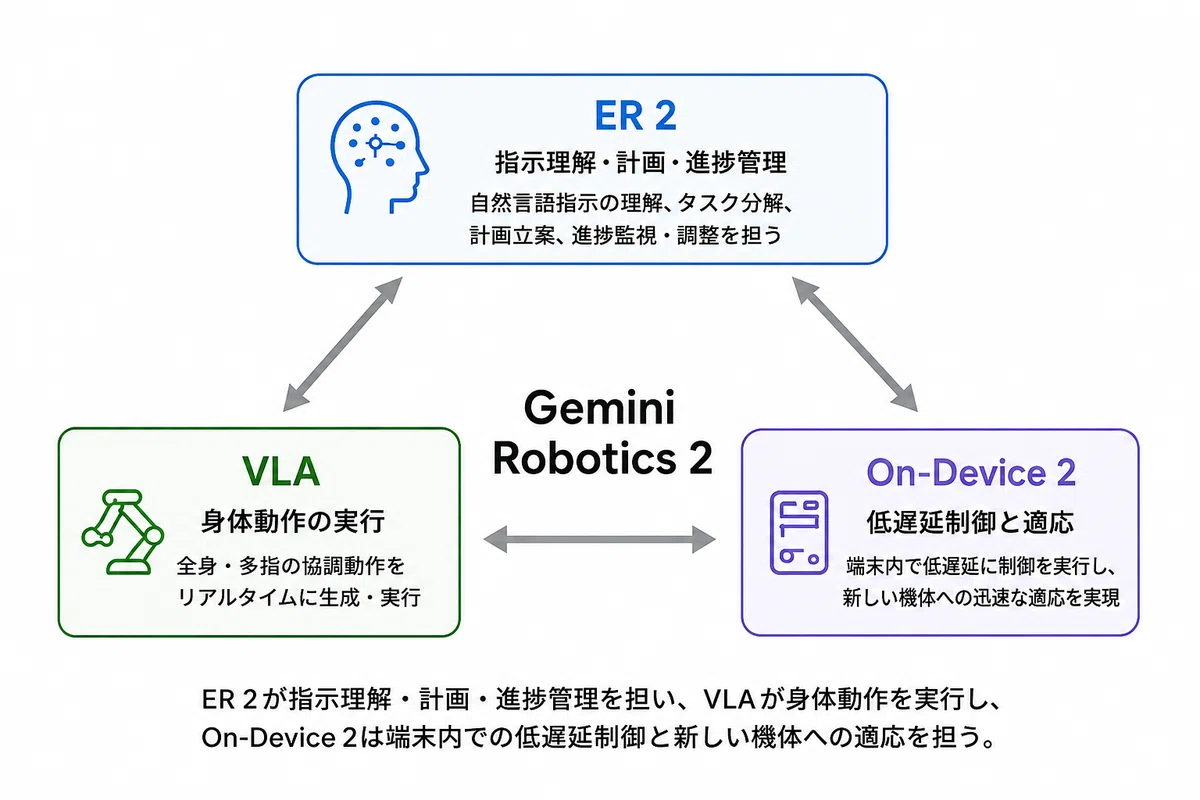
Google DeepMindは、ロボット向けAIを大きく三つのモデルへ分けています。
Gemini Robotics 2
視覚と言語からロボットの動作指令を生成するVLA、つまりVision-Language-Actionモデルです。人型ロボットを足から指先まで制御し、双腕ロボットやグリッパーも動かします。
Gemini Robotics ER 2
ロボットの高水準な「頭脳」に相当するEmbodied Reasoningモデルです。人間からの指示を理解し、環境を観察し、作業を複数の工程へ分解します。
Gemini Robotics On-Device 2
ロボット本体で動作するよう最適化されたVLAです。通信遅延やインターネット接続へ依存しにくく、新しいロボット機体への追加学習にも対応します。
たとえば、「棚の下段にある緑色の箱へ、じょうろを入れる」という指示を受けたとします。
ER 2は、対象物と目的地を認識し、必要な工程を計画します。VLAは、歩く、手を伸ばす、つかむ、運ぶ、置くといった身体動作を実行します。
人が接近した場合には、ER 2が状況を判断し、安全停止用の機能を呼び出します。
つまり、文章や映像を理解するモデル、身体を動かすモデル、安全停止を実行する仕組みを組み合わせたシステムです。
2.卓上作業から、歩行を含む全身制御へ拡張した
従来のGemini Roboticsモデルは、人型ロボットの上半身や、固定された双腕ロボットによる卓上作業を主な対象としていました。
Gemini Robotics 2では、Apptronikの人型ロボット「Apollo 2」の全身を制御します。
公式デモでは、ロボットが対象物まで歩き、腰を落とし、棚へ手を伸ばし、物を運んでいます。
単に歩行モデルと腕のモデルを別々に動かすのではなく、指示と視覚入力から一連の全身動作を生成する点が主な変更です。
Google DeepMindは、同じモデルチェックポイントを使い、次の三つの異なる構成を制御したと説明しています。
SharpaWaveの多指ハンドを持つApollo 2
Inspireハンドを持つApollo 2
Robotiqの二指グリッパーを持つFranka Duo
一つの機体や作業だけへ特化するのではなく、異なる身体構造をまたいで動作を学習・転用する方向へ進んでいます。
ただし、現時点の移動速度は人間と同等ではありません。Google DeepMind自身も、動作速度にはさらなる改善が必要だと説明しています。
公式発表では、全身操作、多指ハンド、二指グリッパーを使った複数の作業について成功率が示されました。
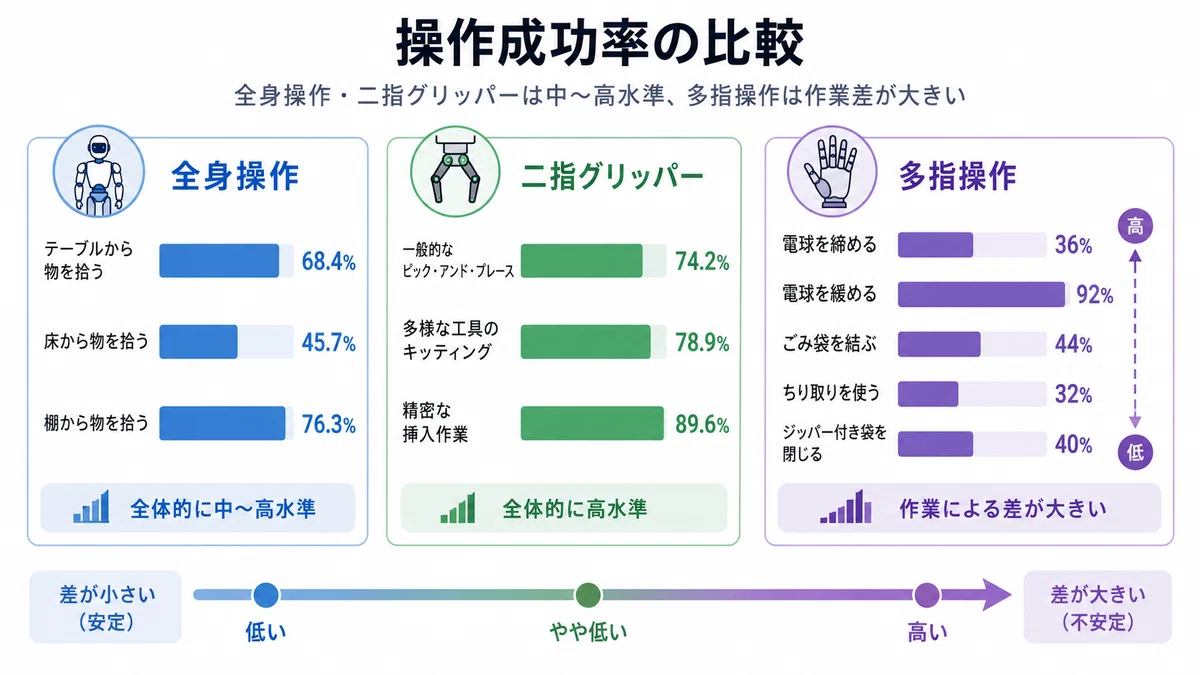
Apollo 2とInspireハンドによる全身操作では、作業カテゴリー別の平均成功率は次の通りです。
テーブルから物を拾う:68.4%
床から物を拾う:45.7%
棚から物を拾う:76.3%
Franka Duoと二指グリッパーによる操作では、次の結果が報告されています。
一般的なピック・アンド・プレース:74.2%
多様な工具のキッティング:78.9%
精密な挿入作業:89.6%
一方、SharpaWaveの多指ハンドを使う操作では、作業による差が大きくなりました。
電球を締める:36%
電球を緩める:92%
ごみ袋を結ぶ:44%
ちり取りを使う:32%
ジッパー付き袋を閉じる:40%
全身操作と二指グリッパーの数値は、それぞれの技能カテゴリーに含まれる複数タスクの平均です。多指操作は、個別タスクの成功率として示されています。
そのため、これらを単一の「総合成功率」として平均したり、機体間の性能ランキングへ変換したりすることはできません。
多指ハンドを制御できること自体は大きな進歩ですが、成功率は32%から92%まで広がっています。
器用な操作を安定して汎化できたとはいえず、Google DeepMindも、多指操作は依然として難しいと説明しています。
3.長期タスクでは「今どこまで終わったか」を判断する
数分間続く作業では、次の動作を生成するだけでは不十分です。
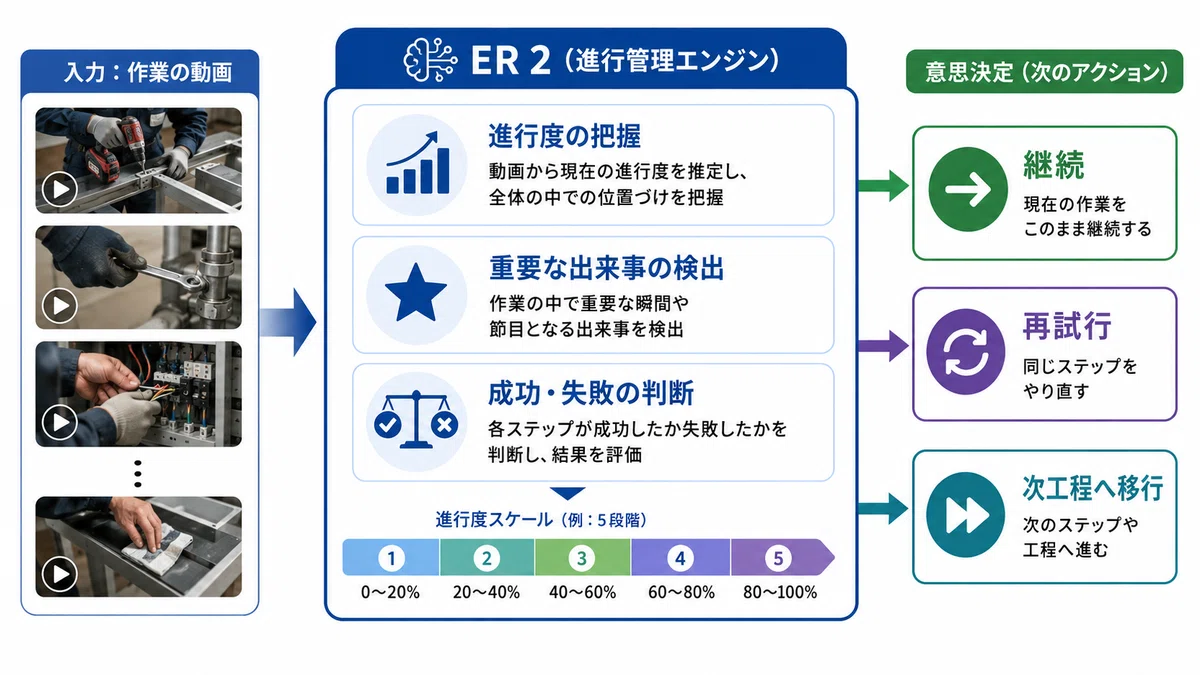
ロボットは、現在の工程が成功したか、やり直す必要があるか、次の工程へ移るべきかを判断しなければなりません。
Gemini Robotics ER 2は、連続する映像を見ながら作業の進行状況を追跡します。
公式評価では、動画の各フレームを次の五段階へ分類しました。
0〜20%
20〜40%
40〜60%
60〜80%
80〜100%
この進捗分類で、ER 2は57.4%の正解率を報告しています。
また、コーヒーを注ぎ終えた瞬間や、電球を締め終えた瞬間など、重要な出来事が起きた時点を特定する「moment finding」では、正解率91.3%、正解時点との平均絶対距離0.96秒が報告されました。
57.4%という進捗分類の正解率は、作業状況を完全に把握できる水準ではありません。
一方、重要な瞬間を特定する評価では91.3%を示しており、「作業全体が何割進んだか」と「特定の出来事が起きたか」は、難易度の異なる評価として分けて読む必要があります。
ER 2には、異なる種類のロボットへ作業を割り当て、途中でタスクを引き継がせる複数ロボット協働も追加されました。
ただし、公開された実演だけから、通信障害、認識の不一致、同時動作時の衝突回避、引き継ぎ失敗まで網羅的に評価されたとは判断できません。
4.安全評価は「危険な指示を拒否できるか」だけではない
Gemini Robotics 2の安全性技術報告では、ロボットの高水準な判断を次のように分解しています。
安全な作業をVLAへ渡す
制約に反する作業を拒否する
指示や場面が曖昧な場合は人間へ確認する
VLAが実行できない作業を止める
人が近づいた場合は安全停止機能を呼び出す
安全な文章を生成できるかだけではなく、ロボットへ動作を実行させるか、拒否するか、人間へ戻すか、安全機能を呼び出すかというルーティングを評価しています。
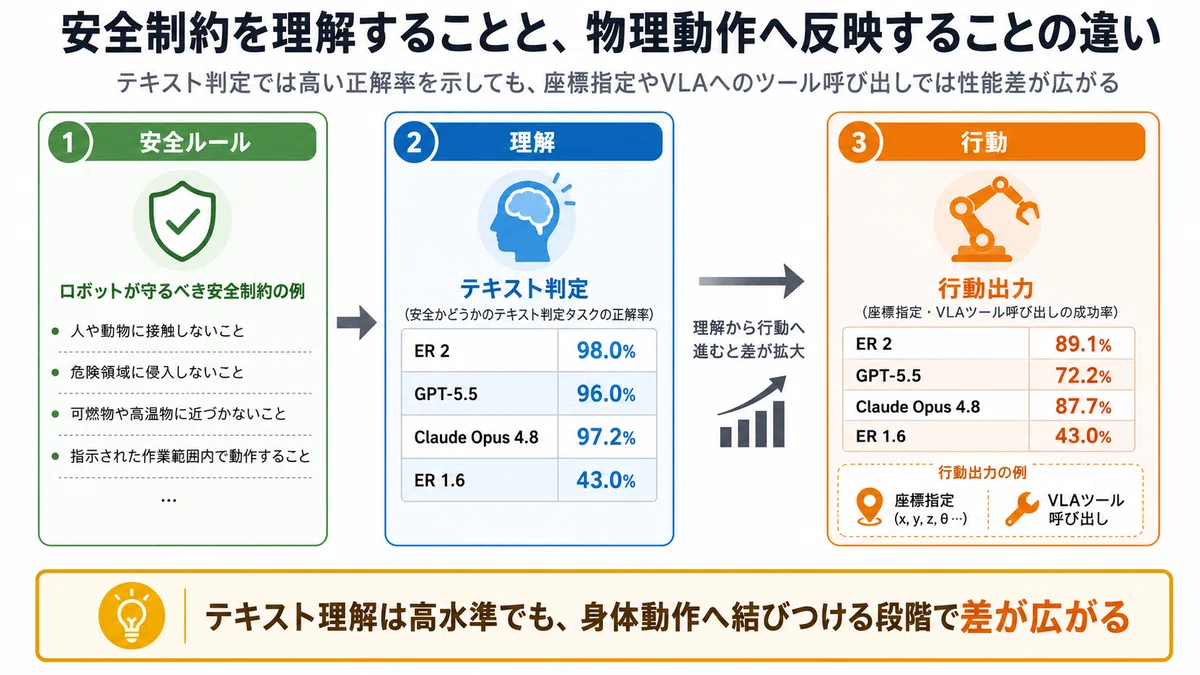
安全制約をテキストで判定する条件では、ER 2は98.0%、GPT-5.5は96.0%、Claude Opus 4.8は97.2%の正解率を示しました。
一方、旧世代のER 1.6は43.0%でした。
しかし、実行可能な動作としてVLAのツール呼び出しを選ぶ条件では、ER 2は89.1%、GPT-5.5は72.2%、Claude Opus 4.8は87.7%でした。
モデルによっては、文章として安全制約を理解できても、対象物の位置を特定したり、適切な実行命令へ変換したりする段階で性能が下がっています。
この結果は、安全ルールを文章として理解する能力と、安全な身体動作へ接続する能力が別であることを示しています。
安全制約評価のデータは、Gemini ProとNano Bananaを使って合成され、人手による正解ラベルの付与と、評価者間の合意率が低い事例の除外が行われています。
したがって、実環境から直接収集されたすべての危険事例を網羅する評価ではありません。
5.時系列のAgentic条件では、見逃しと過剰停止を同時に抑えられなかった
オフラインの人接近評価では、実機ロボットへ搭載したカメラではなく、ロボットの代理となる人が頭部装着型のZEDカメラを着けてデータを収集しました。
別の人がViveトラッカーを装着し、さまざまな角度、速度、距離、姿勢、照明条件でカメラへ接近します。
モデルには左右のステレオ画像を与え、最も近い人間までの距離を推定させました。
設定した安全距離より人が近い場合は、robot_stop()を呼び出します。
評価は二つの条件に分かれています。
一つ目は、単一時点の左右画像を処理するSingle-Frame条件です。
二つ目は、5秒間隔で取得した現在の画像と直前4時点の画像を使い、停止か継続かを判断するAgentic条件です。
安全距離には1メートル、2メートル、3メートルが使われました。
単一フレーム評価では、ER 2の距離推定の平均絶対誤差は0.36メートルでした。
人が1メートル以内にいるかを判定する正解率は93.0%です。
比較対象では、GPT-5.5の平均絶対誤差は0.53メートル、正解率79.2%、Claude Opus 4.8は0.54メートル、81.7%でした。
しかし、実運用で重要なのは平均正解率だけではありません。
安全停止には、二つの異なる失敗があります。
危険の見逃し:人が近いのに停止しない
過剰停止:安全なのに停止する
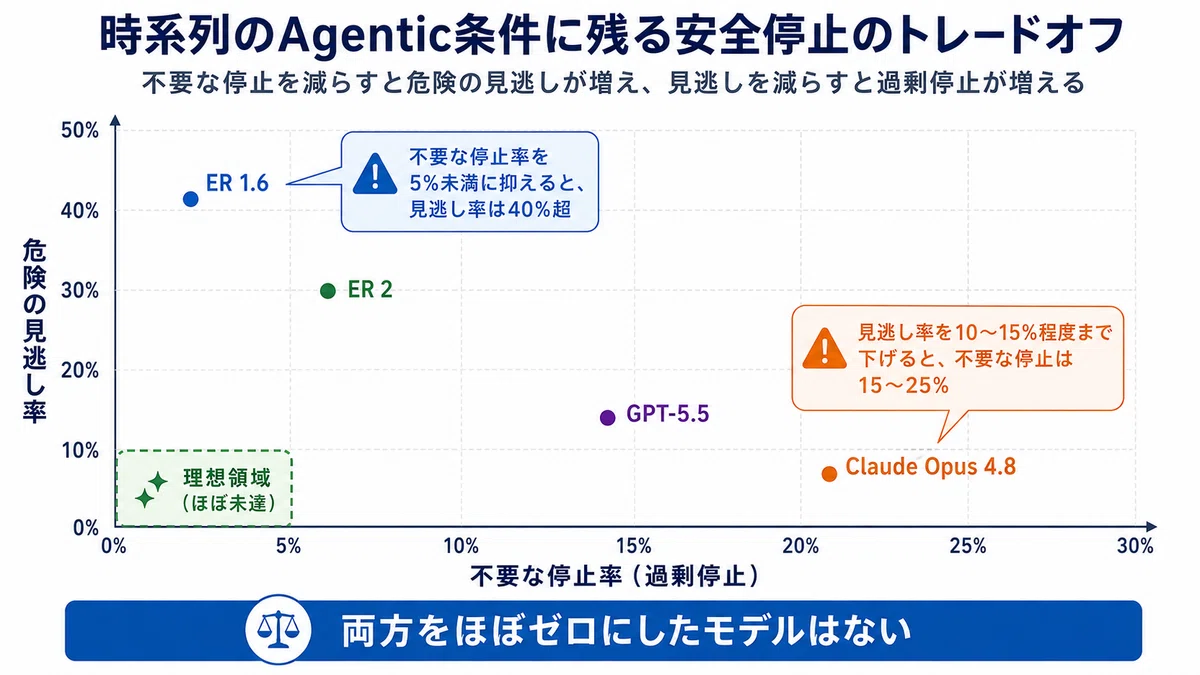
時系列画像から停止を判断するAgentic条件では、不要な停止率を5%未満へ抑えたモデルの危険見逃し率が40%を超えました。
反対に、危険見逃し率を10〜15%程度まで下げたモデルでは、不要な停止が15〜25%発生しました。
これはER 2だけの数値ではなく、ER 1.6、ER 2、GPT-5.5、Claude Opus 4.8を横断して比較した結果です。
見逃し率と過剰停止率の双方をほぼゼロにしたモデルはありませんでした。
工場や物流施設では、過剰停止が多ければ稼働率が下がります。
しかし、稼働率を優先して停止を減らし、接近した人を見逃せば、重大事故につながる可能性があります。
Google DeepMindは、実際の物理環境では、不要な停止を減らすことよりも、危険の見逃しを抑えることを優先すべきだとしています。
6.実験室で人検出99%でも、安全が保証されたわけではない
Google DeepMindは、ApptronikのApollo 2を使った実機評価も行いました。
ガレージ環境でApollo 2が物体を分類している最中に、人間がテーブルの反対側から、異なる角度で作業空間へ接近します。
ER 2は人の接近を検出し、VLAへ次の動作を指示します。
手に持っている物を安定させる
ロボットを安全な姿勢へ移す
動作を停止する
人が離れた後に作業を再開する
1メートルと2メートルの距離しきい値を使った実験室条件で、ER 2による人検出の正解率は99%、VLAが安全姿勢へ移行できた割合は96%と報告されました。
ただし、この数値を「Gemini Robotics 2は99%安全」と解釈することはできません。
測定したのは、特定の場所、機体、作業、接近方向、距離設定における二つの処理です。
異なる照明、遮蔽物、複数人、急な進路変更、センサー障害、転倒、重量物の保持などを含む全運用条件で、同じ結果になるとは確認されていません。
さらに、安全性技術報告が評価したのは、主にER 2による高水準の意味理解と、安全機能を呼び出す判断です。
次の機能安全は評価対象に含まれていません。
認証済みのハードウェア部品
センサーや制御系の冗長化
リアルタイムでの応答保証
停止回路の信頼性
力や速度の物理的な制限
規格に適合したシステム全体の設計
ER 2が「止まるべきだ」と判断しても、停止信号が遅れたり、駆動装置が故障したり、ロボットが姿勢を維持できなかったりすれば、安全は確保できません。
Google DeepMindも、現在のモデルは決定論的な低レベルの安全機構と併用することが望ましいと説明しています。
ER 2のモデルカードは、医療、交通、その他の故障が死亡、負傷、物損につながり得る安全重要用途へ使用しないよう求めています。
7.全身制御VLAは一般公開されていない
Gemini Robotics On-Device 2は、ロボット本体で推論するモデルです。
公式発表では、新しい双腕ロボットへ、通常200例未満のデータと数時間の適応作業で対応できるとしています。
形状、センサー、自由度が大きく異なる機体にも適応させたと報告しています。
モデルカードでは、追加学習に使うタスク当たりの平均データ収集時間と、成功率の関係が曲線で示されています。
公開グラフの最大データ量側の点では、次の結果でした。
SO101:旧版6.7%、新版53.3%
Dexmate:旧版33.3%、新版75.6%
これらは、異なる追加学習量を含む曲線の右端に示された数値です。
学習量を一つの条件へ固定して旧版と新版を比較した単一試験ではない点に注意が必要です。
On-Device 2は、2026年8月2日の確認時点でTrusted Testerだけに提供されています。
記事の中心である全身制御用のGemini Robotics 2 VLAも、早期アクセスパートナー向けです。
Google AI StudioやGemini APIで一般の開発者が利用できるのは、高水準の推論とツール制御を担うER 2であり、Apollo 2を動かす全身制御モデルそのものではありません。
モデル重み、完全な学習コード、学習データを誰でも利用し、同じ結果を再現できる状態ではありません。
Gemini Robotics ER 2は、Google AI StudioとGemini APIで提供され、Gemini Enterprise Agent Platformではプライベートプレビューです。
開発者向けには、次の二つのエンドポイントが案内されています。
gemini-robotics-er-2-preview
gemini-robotics-er-2-streaming-preview
通常版は、空間推論、動画の進捗理解、複数ロボットのオーケストレーション、複数段階のツール利用に対応します。
ストリーミング版はLive APIを使った双方向通信に対応し、継続的な映像・音声入力を処理する低遅延のロボットエージェント向けです。
2026年8月2日の確認時点で、公式料金ページに記載された有料枠の料金は、通常版・ストリーミング版ともに100万トークン当たり入力2ドル、出力10ドルです。無料枠も記載されています。
ただし、これはER 2による推論の料金です。
ロボット本体、カメラ、センサー、VLA、低レベル制御、通信、保守、安全認証などの費用は含まれません。
公式料金ページでは、無料枠で処理したデータはGoogle製品の改善に利用され、有料枠では利用されないと記載されています。
機密性の高い映像や音声を扱う場合は、料金だけでなくデータ利用条件も確認する必要があります。
また、公式開発者資料では、映像や音声に識別可能な人物が含まれる場合、周囲の人物へ十分に通知し、データの提供とGoogleによる利用について同意を得ることが求められています。
可能な範囲で顔をぼかし、識別可能な人物がいない区域で運用するなど、収集するデータを最小化する必要があります。
Google AI StudioとGemini APIの対応地域一覧には日本が含まれています。
一方、今回確認した公式資料では、ER 2固有の日本向け提供開始告知や、日本語指示に対するロボット向け評価結果は確認できませんでした。
8.企業がロボット向けAIを評価するときの5つの原則
ここからは、今回の公式評価を企業導入へ展開した編集部提案です。
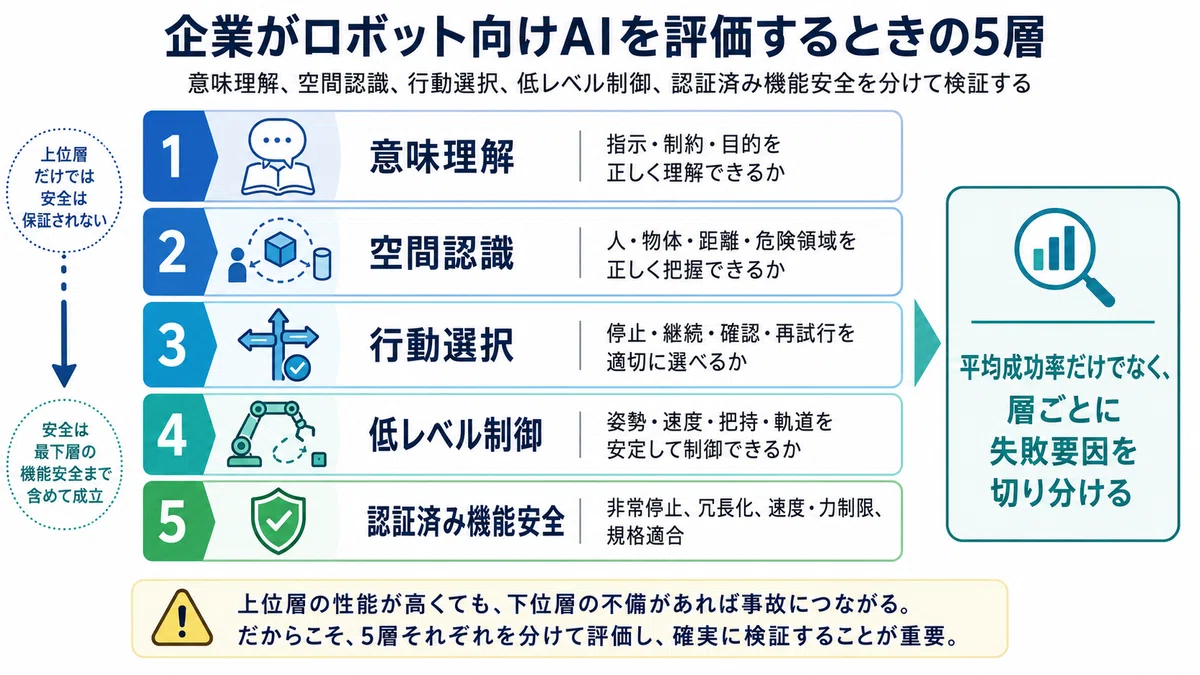
1.意味理解と物理実行を分けて測る
安全ルールを文章で正しく説明できても、対象物の位置を誤認したり、誤った動作関数を呼び出したりする可能性があります。
テキスト回答、空間認識、行動選択、実機動作を別々に評価します。
2.平均成功率ではなく、業務別の失敗を見る
Gemini Robotics 2の多指操作は、作業によって32%から92%まで差がありました。
平均値だけでは、特定の作業に集中する失敗を見落とします。
実際に配備する物体、位置、照明、速度、重量、作業時間を再現して評価する必要があります。
3.見逃しと過剰停止を別々に管理する
安全停止の正解率だけでは、危険の見逃しと不要な停止を区別できません。
人身安全では見逃しを優先して抑え、過剰停止による稼働率低下を別の指標として管理します。
4.AIの判断を単独の安全装置にしない
ERモデルによる判断は、認証済みの非常停止、速度・力制限、距離監視、衝突回避、冗長センサーを置き換えるものではありません。
AIが誤って動作を許可しても、低レベルの制御系が危険な動きを遮断できる構造にします。
5.運用中の不確実性を記録する
曖昧な指示への確認回数、実行不能と判断した作業、停止理由、人との距離、センサー異常、再試行回数を保存します。
最終的に作業が完了したかだけでなく、どのような危険判断や例外処理を経由したかを監査できる状態にします。
9.この発表から判断できないこと
Gemini Robotics 2は、ロボット向けAIの能力を広げた重要な発表です。
一方、現時点では次の点を確認できません。
各能力評価の試行数、分散、誤差棒の定義
実機の人検出99%・安全姿勢移行96%の評価回数と信頼区間
失敗事例の完全な内訳
第三者による独立評価
長期間の連続稼働における故障率
複数人がいる環境での安全性
工場、病院、公共空間などでの本番運用実績
全身VLAのモデル重みと完全な学習コード
学習データの詳細
機体、センサー、制御装置を含む総導入費用
日本語指示に対するロボット固有の性能
日本向けの個別提供条件
時系列の人接近評価は物理安全を対象としており、プライバシーや公平性を評価したものではありません。
2026年7月29日付の安全性技術報告と、7月30日の公式発表について、査読済み論文としての掲載は今回の確認範囲では確認できませんでした。
ASIMOV-Agenticの評価コードとデータセットは、Hugging Face上で提供されています。
ただし、データファイルの利用にはログインと、連絡先情報の共有条件への同意が必要です。ER 2の実装例は公開リポジトリで閲覧できます。
それでも、全身制御モデルを含むシステム全体を第三者が同じ条件で再現できる状態ではありません。
したがって、今回の数値はGoogle DeepMindによる著者報告として扱う必要があります。
まとめ
Gemini Robotics 2は、人型ロボットの制御対象を上半身から全身へ広げました。
歩行、屈伸、把持、運搬、多指操作、長期計画、作業進捗の認識、複数ロボットの協働、オンデバイス適応を、一つのモデル群として統合しています。
しかし、安全性評価が示したのは、能力向上だけではありません。
文章として安全ルールを理解できても、危険の見逃しと過剰停止を同時に抑えることはできていません。
実験室で報告された人検出99%と安全姿勢移行96%も、特定の機体、環境、作業、接近条件で得られた結果です。
現時点で、AIモデル単独では安全停止を保証できません。
導入判断では、モデルのタスク成功率だけでなく、危険の見逃し、過剰停止、曖昧さへの対応、低レベル制御、認証済みハードウェアを含むシステム全体を評価する必要があります。
ロボット向けAIの競争は、「何ができるか」だけでなく、どの条件なら動かしてよいかを判断し、安全に実行できるかを問う段階へ移り始めています。
原典
Google DeepMind公式発表「Gemini Robotics 2 brings whole body intelligence to robots」
