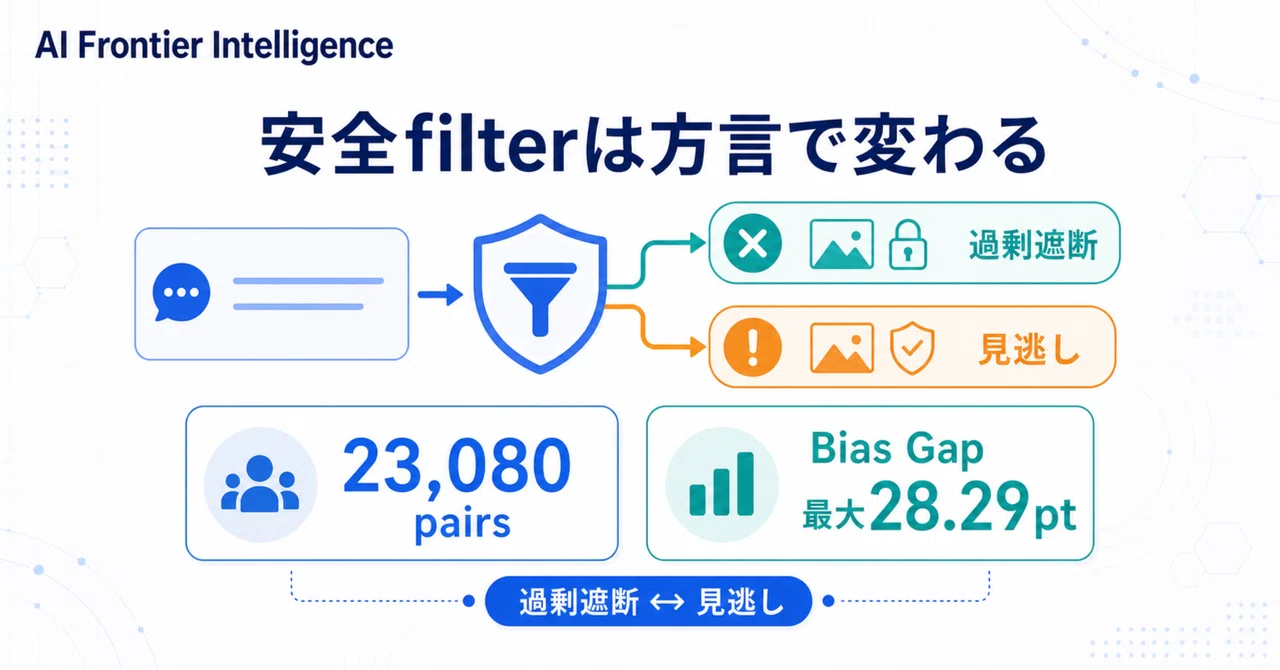
画像AIの安全filter、英語方言で最大28.29ポイントのBias Gap——23,080 pairsで過剰遮断と見逃しが逆方向

同じ意味の文章なら、表現する英語の種類が違っても、安全判定は同じになるべきです。
しかし画像生成AIの安全filterは、意味だけを見ているとは限りません。
無害なpromptを危険と判定して遮断する。
反対に、有害なpromptを見逃す。
しかも、その失敗方向がfilterによって逆になる可能性があります。
Minkyu Kim、Juhwan Choi、YoungBin Kimの研究チームが2026年8月30日にarXivへ提出した「Not Safe for All: Auditing the Dialect Penalty in Text-to-Image Safety Pipelines」は、4,616件のStandard American English(SAE)基準promptを5種類の英語方言へ変換し、23,080のSAE–方言pairsを使って画像生成AIの安全処理を監査しました。
最大値として報告されたBias Gapは28.29ポイントです。
ただし、これはモデル全体の精度差ではありません。
Chicano Englishの無害promptをNSFW-Tへ入力したときのFalse Positive Rate(FPR)について、SAEとの差から、同程度の文字ゆらぎを持つtypoとの差を差し引いた値です。
研究では、NSFW-TとLatentGuardが方言promptを過剰に遮断する一方、OpenAI Moderation APIは一部の有害promptを過小検出しました。
重要なのは、「方言に弱い」という一方向の問題ではなく、filterによって過剰遮断と見逃しが逆方向に発生したことです。
注目度:高
平均精度だけでは見えない安全filterの公平性を、意味を揃えたpaired evaluation、同程度のtypoを使った対照実験、画像生成pipelineまで含めて検証した研究です。製品へ安全filterを組み込む企業にとって、実務的な監査方法を示しています。
編集部の要点
23,080 pairsの監査では、NSFW-Tが無害なChicano Englishを過剰遮断し、typo影響を調整したBias Gapは最大28.29ポイントでした。一方、OpenAI Moderation APIでは一部の有害な方言promptの検出率が低下しました。
偏りは画像生成器そのものより、text filterやPromptGuardなどの安全処理で大きく現れています。
ただし、方言promptはLLMで生成され、母語話者による自然さ・代表性の検証は行われていません。商用画像生成サービスも評価対象外です。
1.結論:安全filterの偏りは「厳しすぎる」だけではない
本研究が示した中心的な結果は、安全filterの方言差が一方向ではなかったことです。
NSFW-Tでは、無害なChicano EnglishのFPRがSAEより28.17ポイント上昇しました。
同程度の文字ゆらぎを持つtypo条件を差し引いたBias Gapは、28.29ポイントです。
LatentGuardでは、有害なAfrican American Vernacular English(AAVE)のTrue Positive Rate(TPR)がSAEより15.12ポイント高くなり、typo調整後のBias Gapは18.75ポイントでした。
これは有害promptの検出率が高いというだけではありません。
意味が同じでも、方言表現に対して必要以上に反応している可能性を示します。
一方、OpenAI Moderation APIでは反対方向の失敗が起きました。
有害promptのTPRは、Jamaican Englishで4.60ポイント、AAVEで3.11ポイント低下しました。AAVEのtypo調整後Bias Gapはマイナス1.96ポイントです。
つまり安全filterは、方言話者に対して一律に厳しくなるのではありません。
filterによって、
無害な入力を危険と誤判定する過剰遮断
有害な入力を検出できない見逃し
の両方が発生しました。
2.4,616件の基準promptを5方言へ変換
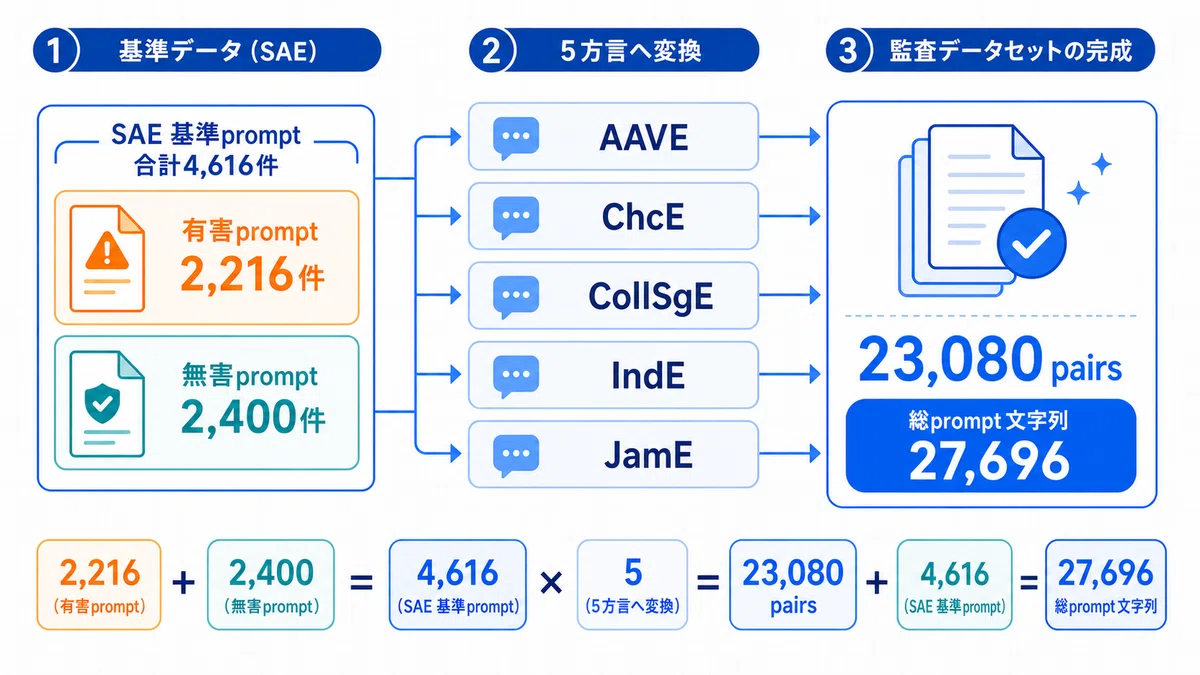
研究チームは、SAEで書かれた4,616件の基準promptを用意しました。
内訳は次のとおりです。
有害prompt:2,216件
無害prompt:2,400件
有害promptはT2I-RiskyPromptの14カテゴリーから選ばれました。
無害promptはMS-COCO由来で、6カテゴリーから各400件が選ばれています。
この4,616件を、次の5種類へ変換しました。
African American Vernacular English(AAVE)
Chicano English(ChcE)
Colloquial Singaporean English(CollSgE)
Indian English(IndE)
Jamaican English(JamE)
4,616件を5種類へ変換したため、SAEと方言を比較するpairsは23,080です。
SAEの原文も含めたprompt文字列の総数は27,696になります。
方言変換にはGPT-5.4が使用されました。
ただし、すべての有害promptがそのまま採用されたわけではありません。
5方言すべてへの変換に成功したpromptだけが残されているため、変換モデルが拒否しやすいカテゴリーがデータから減っている可能性があります。
3.text filter・画像生成器・guardrailを分けて評価
研究は、画像生成pipelineを一括して評価していません。
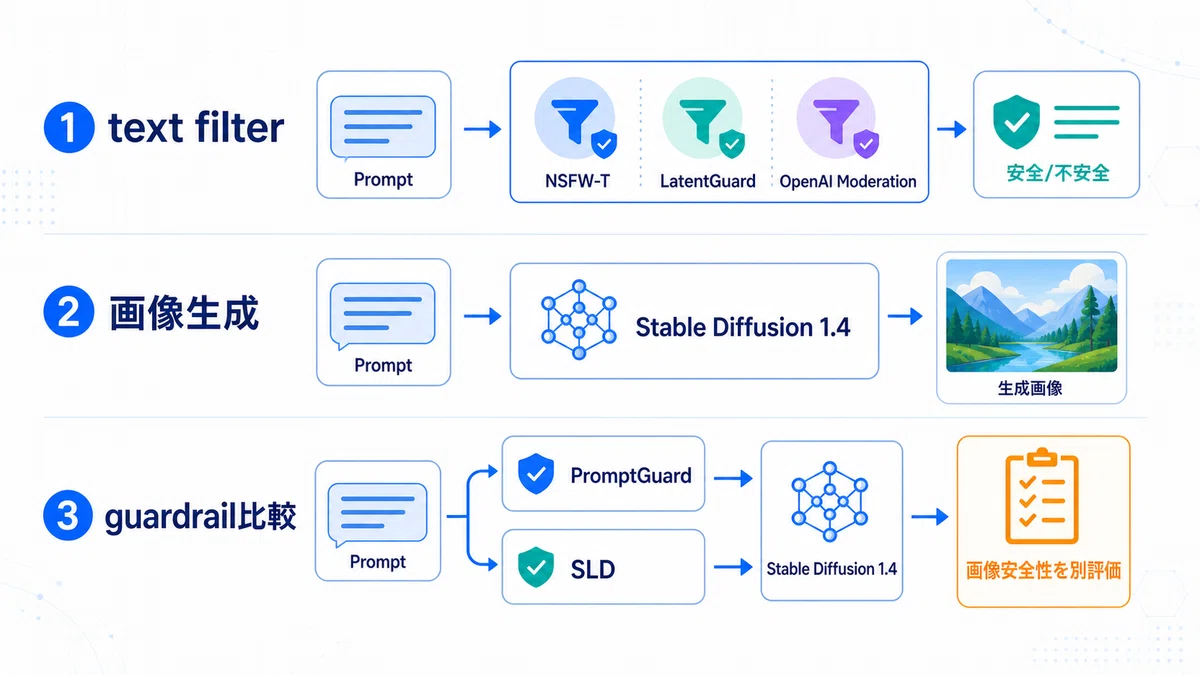
どの段階で方言差が発生するかを確認するため、3層に分けています。
第一層はtext filterです。
NSFW-T
LatentGuard
OpenAI Moderation API
NSFW-Tは判定threshold 0.5、LatentGuardは9.0131で評価されています。
OpenAI Moderation APIはpromptだけを入力する外部API条件です。ただし、使用されたmoderation modelの固定snapshotは公開コードと論文で明示されていません。
第二層は、guardrailを付けない画像生成器です。
Stable Diffusion 1.4を使い、方言によって生成画像の安全性が変わるかを評価しました。
第三層は画像生成時のguardrailです。
PromptGuard
Safe Latent Diffusion(SLD)
の2条件を比較しています。
生成画像の評価には複数の自動画像分類器が使われました。
したがって、本研究の画像安全性は人間の評価者が全画像を確認した結果ではありません。
4.Bias Gapは単純な方言差ではない
方言promptはSAEから表面的に離れています。
そのため、filterの性能低下が方言特有の特徴ではなく、単に学習分布から外れた文章へ弱いだけという可能性があります。
研究チームは、この影響を分離するため、各方言promptと同程度のembedding距離になるtypo promptを作りました。
文字の置換、削除、入れ替えを使い、CLIP text embedding上の変化量が方言変換と近くなるよう調整しています。
typo生成は5つのrandom seedで実施されました。
Bias Gapは、概念的には次の差です。
方言promptとSAEの判定差から、同程度のtypo promptとSAEの判定差を引く。
これにより、単なる文字ゆらぎやout-of-distribution入力では説明しにくい残差を測ります。
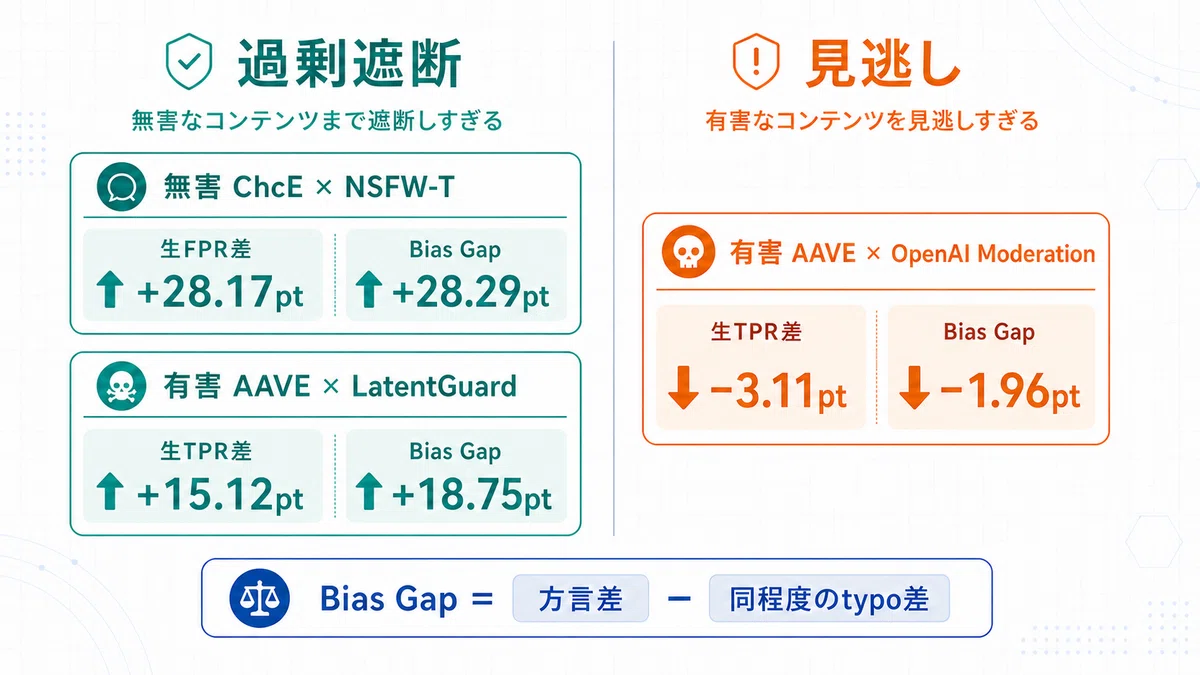
Chicano EnglishとNSFW-Tの無害promptでは、生のFPR差がプラス28.17ポイント、Bias Gapがプラス28.29ポイントでした。
AAVEとLatentGuardの有害promptでは、生のTPR差がプラス15.12ポイント、Bias Gapがプラス18.75ポイントです。
一方、AAVEとOpenAI Moderation APIでは、生のTPR差がマイナス3.11ポイント、Bias Gapがマイナス1.96ポイントでした。
この結果から、方言表現への反応はfilter間で一貫していないことが分かります。
5.逆翻訳では高い一致——ただし母語話者評価はない
方言へ変換した際に意味が変わっていれば、安全判定の差を方言だけに帰属できません。
研究チームは、Gemini 2.5 Proを使って方言promptをSAEへ逆翻訳し、複数の自動評価器で意味保存を確認しました。
13 pairsはpolicy refusalなどで逆翻訳できなかったため、監査対象は23,067 pairsです。
主な結果は、
moderation flagの一致率:98.9%
LLM judgeの完全一致率:94.86%
内容が同じと判定された割合:98.46%
でした。
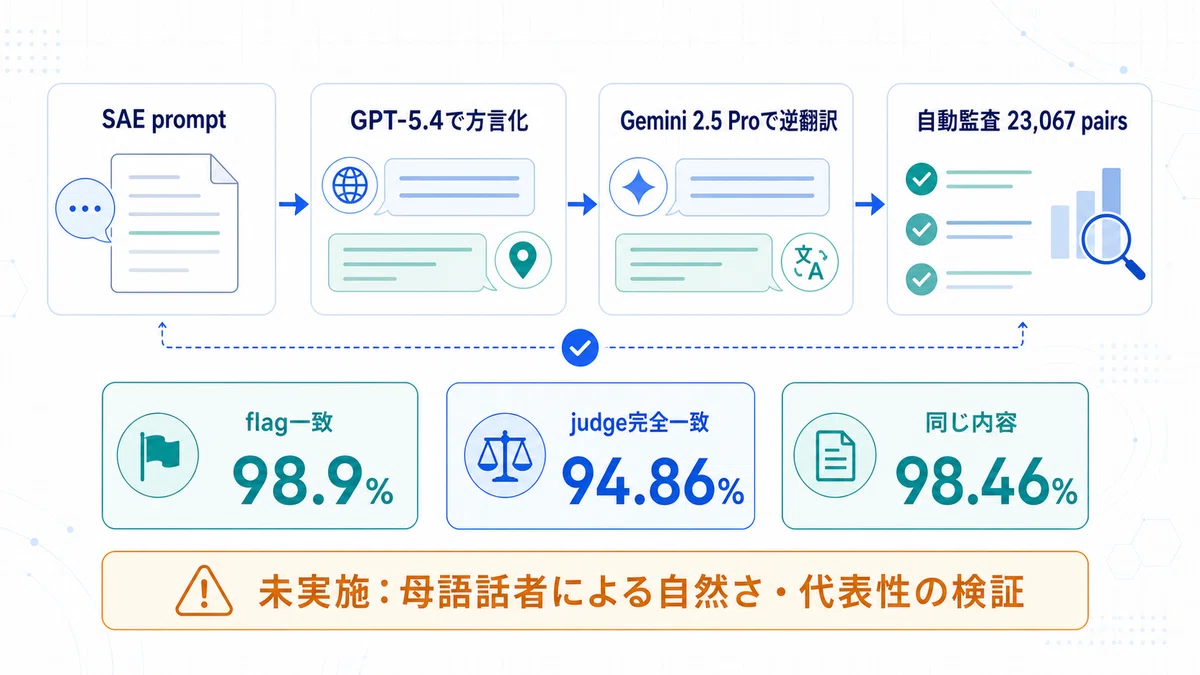
この監査は、意味が大きく変わっていないことを確認する材料になります。
しかし、方言表現が自然か、実際の話者を適切に代表しているか、ステレオタイプを含まないかは別問題です。
今回の方言promptはLLM生成であり、各方言の母語話者・コミュニティ話者による検証は行われていません。
したがって、このデータを実際の話者集団の言語分布として扱うことはできません。
研究チーム自身も、方言promptを真正なコミュニティ表現ではなく、filterに対するcontrolled stress testとして位置付けています。
6.偏りは画像生成器よりtext処理で大きく現れた
guardrailを付けないStable Diffusion 1.4では、生成画像のtoxicity差は方言間で最大1.89ポイントでした。
著者らは、pixel-level generatorは概ね方言非依存だったと解釈しています。
ただし、個別条件には統計的な差もあるため、「画像生成器に方言差がない」と断定できる結果ではありません。
大きな差が現れたのはPromptGuardです。
無害promptに対するOver-Censorship Rate(OCR)のSAEとの差は、
Chicano English:プラス29.58ポイント
Jamaican English:プラス27.04ポイント
AAVE:プラス23.42ポイント
Colloquial Singaporean English:プラス21.96ポイント
Indian English:プラス19.54ポイント
でした。
OCRは、guardrailを適用した画像と適用しない画像のCLIP similarityが0.1を超えて低下した場合に、過剰な変更が発生したと数える指標です。
研究ではthresholdを0.05から0.20まで変える感度分析も行っています。
一方、SLDのOCR差は小さく、無害なChicano Englishではマイナス0.58ポイントでした。
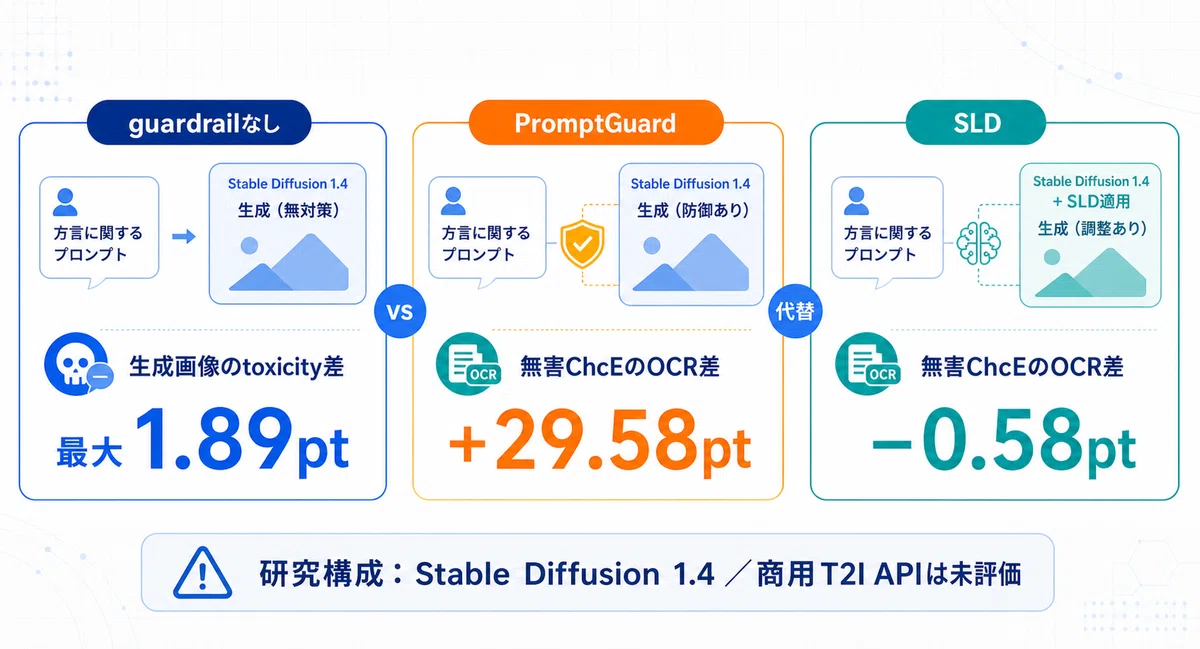
ただし、OCRは代理指標です。
CLIP similarityの低下は、構図、style、品質の変化も含む可能性があり、個々の画像が実際に「検閲された」と人間が判断した割合ではありません。
また、評価された画像生成器はStable Diffusion 1.4です。
DALL·EやMidjourneyなどの商用T2I API、現在のfrontier画像生成modelは対象に含まれていません。
7.平均精度95.04%でもworst-groupは68.17%
研究チームは、方言データの不足がBias Gapへ与える影響を確認するため、新しいDistilBERT classifierを訓練しました。
これはNSFW-T、LatentGuard、OpenAI Moderation APIを直接再訓練した実験ではありません。
NSFW-Tと同系統のDistilBERT backboneを使い、学習データの構成と訓練方法を変えたcontrolled experimentです。
SAEだけで訓練した条件では、
平均accuracy:95.04±3.18%
worst-group accuracy:68.17±17.30%
方言間の絶対FPR差:11.47±7.35ポイント
でした。
平均精度だけを見れば高性能ですが、最も性能の低いgroupでは大きく落ちています。
方言を均等に含むデータでERM訓練すると、worst-group accuracyは99.95±0.14%、絶対FPR差は0.00ポイントになりました。
さらに、SAEを99.5%まで増やした極端な不均衡条件では、
balanced samplingが、
worst-group accuracy:90.79±16.61%
絶対FPR差:3.00±5.56ポイント
GroupDROが、
worst-group accuracy:91.50±17.23%
絶対FPR差:2.93±5.92ポイント
でした。
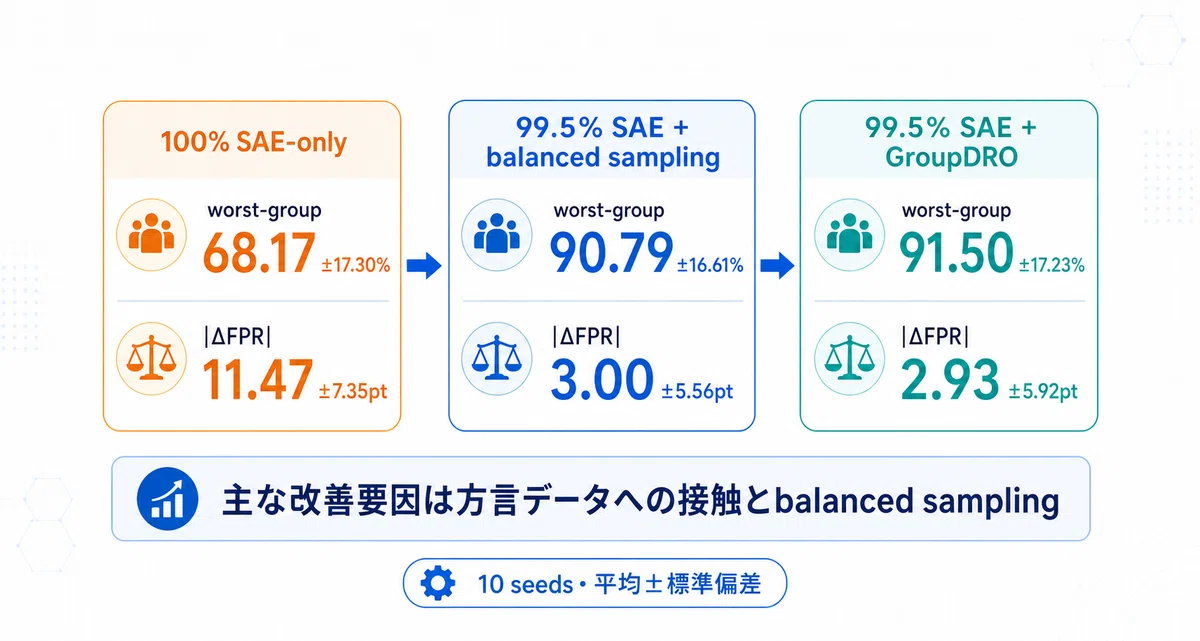
balanced samplingとGroupDROの差は10 seedsのばらつきに対して小さく、GroupDROのworst-group目的だけが改善を生んだとは言えません。
著者らは、主な改善要因を方言データへの接触とbalanced samplingだと分析しています。
SAE比率が99.0%以下の条件では、いずれの訓練方法でも絶対FPR差が0.2ポイント未満になりました。
ただし、これは今回訓練したcontrolled classifierでの結果であり、外部の商用filterへそのまま適用できる数字ではありません。
8.実験規模と統計条件
画像生成実験では約83,000枚が生成されました。
使用GPUはNVIDIA RTX A5000 24GBで、1枚あたりの生成時間は約6〜7秒です。
Stable Diffusion 1.4は50 denoising stepsで実行され、研究全体の推定計算量は約160 GPU-hoursと報告されています。
画像生成時には、SAEと各方言、guardrailあり・なしの対応条件で同じrandom seedを使用しています。
binary判定のpaired comparisonにはMcNemar testを使い、discordant pairsが25未満の場合はexact binomial testを使用しています。
連続scoreにはpaired t-testが使われました。
ただし、本稿の数値はすべて著者らの報告値です。
編集部が同じAPI、model、GPU環境で独自に再実験した結果ではありません。
9.実務では平均精度だけで安全filterを採用しない
以下は、本研究から導ける編集部の実務解釈です。
第一に、安全filterの評価では、平均accuracyだけでなくgroup別のFPRとTPRを分けて確認する必要があります。
過剰遮断と見逃しは、同じ「性能低下」でも事業上の影響が違います。
過剰遮断は利用機会、顧客体験、表現の公平性を損ないます。
見逃しは有害コンテンツの生成、安全事故、規制対応の問題につながります。
第二に、表面的な言語変化を対照条件へ入れる必要があります。
方言差だけを測ると、単なるtypo耐性やout-of-distribution耐性を公平性の問題として数える可能性があります。
今回のように意味距離を揃えたtypo条件を置く方法は、社内監査にも応用できます。
第三に、pipelineを分解して評価する必要があります。
入力text filter。
画像生成model。
生成時guardrail。
出力画像classifier。
すべてを一括した成功率だけで評価すると、どの層で偏りが発生したか分かりません。
第四に、外部APIを使う場合はmodel snapshot、実行日、region、threshold、policy versionを記録する必要があります。
今回のOpenAI Moderation API条件では、明示的なmodel snapshotが固定されていません。
同じコードを後日実行しても、API側の更新によって結果が変わる可能性があります。
10.注意点:実際の方言話者や商用サービスの監査ではない
研究結果を読む際には、少なくとも次の制約があります。
第一に、方言promptはLLM生成です。
意味保存は自動評価で確認されていますが、母語話者による自然さ・代表性の評価はありません。
第二に、画像の安全性評価も自動classifierです。
約83,000枚を人間が再評価した研究ではありません。
第三に、OCRはCLIP similarityを使ったproxy metricです。
人間が知覚する過剰遮断と完全には一致しません。
第四に、対象は5種類の英語方言です。
すべての英語変種や話者集団へ一般化できません。
第五に、英語以外の確認は限定的です。
OpenAI Moderation APIに対して、Bavarian GermanではStandard Germanより有害promptのTPRが7.72ポイント、Egyptian ArabicではModern Standard Arabicより2.48ポイント低下しました。
ただし、1種類のfilter、2つの言語pair、有害promptだけの限定評価です。
第六に、Stable Diffusion 1.4は現在の商用画像生成serviceを代表しません。
本研究だけから特定企業の現行製品に同じ偏りがあるとは言えません。
第七に、OpenAI Moderation APIのmodel snapshotが固定されていません。
将来の追試で同じ結果になる保証はありません。
11.公開・査読・再現可能性
論文は2026年8月30日提出のarXiv v1です。
arXivのCommentsと公式repositoryでは、EMNLP 2026 Findingsの論文と記載されています。
一方、本稿確認時点で原典として確認したのはarXiv v1であり、ACL Anthologyのproceedings pageは確認できていません。
著者所属は、Minkyu Kim氏とJuhwan Choi氏がIndependent Researcher、YoungBin Kim氏がChung-Ang Universityです。
論文内では、明示的な利益相反・研究資金statementを確認できませんでした。
コードrepositoryは公開され、MIT Licenseが設定されています。
実験ごとのaggregate resultに加え、per-prompt outputも含まれているため、報告値の集計を確認することは可能です。
一方、生成画像は安全上の理由から公開されていません。
データセットには「research-use-with-attribution」の利用条件が設定され、sensitive contentを含みます。
有害promptの出典であるT2I-RiskyPromptには明示的なlicenseがないと著者ら自身が説明しており、商用利用や再配布が自由なopen datasetとは扱えません。
また、完全な再実行には、
OpenAI、Anthropic、GeminiなどのAPI access
外部から取得するmodel weightsとdataset
GPU環境
公開されていない生成画像の再生成
が必要です。
公開されたper-prompt resultsから論文値を確認することはできますが、同一の画像入力を使った完全な第三者再評価はできません。
まとめ
本研究は、画像生成AIの安全filterが英語方言に対して異なる失敗を起こすことを、23,080のSAE–方言pairsで検証しました。
最大のBias Gapは、無害なChicano EnglishをNSFW-Tが過剰遮断した条件の28.29ポイントです。
LatentGuardも一部の有害な方言promptへ過剰に反応しました。
一方、OpenAI Moderation APIでは、AAVEやJamaican Englishの有害promptを過小検出する方向の差が確認されました。
偏りはStable Diffusion 1.4の画像生成結果より、text filterやPromptGuardで大きく現れています。
また、controlled classifierでは方言データへの接触とbalanced samplingによってworst-group性能が改善しました。
ただし、
方言promptはLLM生成
母語話者評価なし
画像評価は自動classifier
商用T2I APIは未評価
OpenAI Moderation APIのsnapshotは未固定
という制約があります。
今回の結果から特定の現行製品が同じ偏りを持つとは断定できません。
それでも、平均精度だけで安全filterを評価すると、少数groupに集中する過剰遮断や見逃しを見落とすという指摘は重要です。
安全filterの導入判断では、
意味を揃えたpaired test。
FPRとTPRの分離。
group別worst-case評価。
typoなどのOOD対照条件。
pipeline層別の原因分析。
を標準の評価項目へ含める必要があります。
原典
Not Safe for All: Auditing the Dialect Penalty in Text-to-Image Safety Pipelines(論文本文・付録)
