AgentOpsとは何か|AIエージェントを本番運用する5つの判断軸

公開日:2026年9月2日
AIエージェントが一度うまく動いた。しかし、本番へ出してよいか判断できない。
この悩みは、モデルの精度を追加で測るだけでは解決しません。必要なのは、何を実行したか追跡でき、権限と費用を管理し、問題が起きたら止めて人へ戻せる状態です。
Databricksが公開した「Big Book of AgentOps」を手がかりに、AIエージェントを本番運用するための判断軸を整理します。
この記事でわかること
AgentOpsが必要になる理由
AIエージェントを本番へ出す5つの判断軸
一つの業務で試せる40分のβ実験
何が起きた
Databricksは2026年9月2日、「Big Book of AgentOps」を公開しました。
AgentOpsとは、AIエージェントを構築、評価、統制、監視し、本番環境で改善し続ける運用規律です。
AIエージェントは、質問へ答えるだけのチャットボットとは異なります。実行時に道具を選び、企業データを取得し、APIを呼び、複数の工程を進めます。
自由度が上がるほど、失敗点も増えます。
誤った道具を呼ぶ。必要以上のデータへアクセスする。同じ失敗を繰り返す。費用が増える。問題が起きたとき、誰が止めるか分からない。
AgentOpsは、これらを個別の事故対応ではなく、繰り返せる運用として管理します。
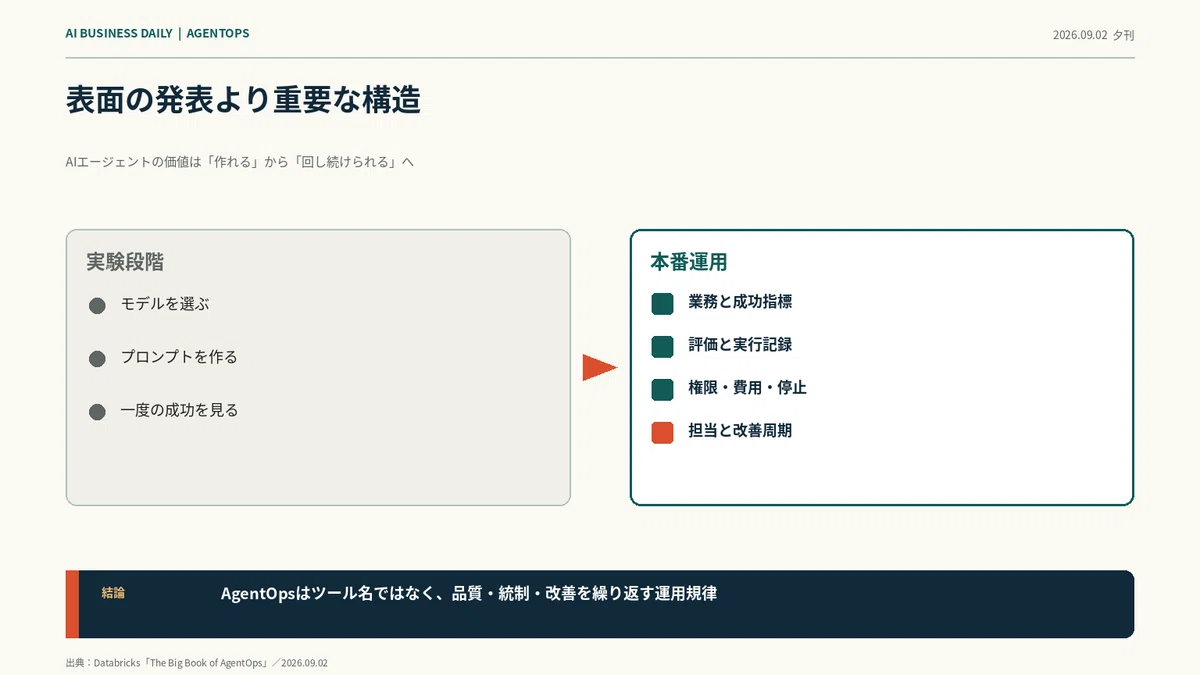
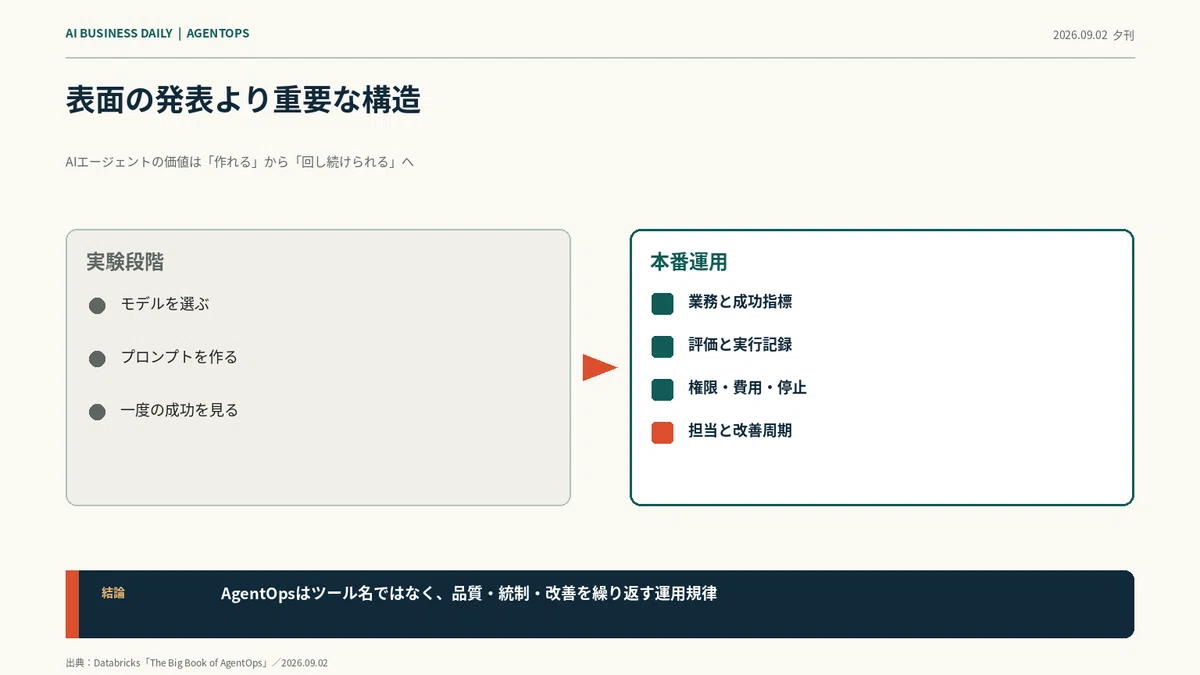
表面の発表より重要な構造
「作れる」と「回し続けられる」は別の能力
実験段階では、一度期待した回答を出せるかが重視されます。
本番運用では、毎回同じ経路になるとは限りません。エージェントが別の道具を選び、失敗後に入力を変えて再試行する場合があります。
したがって、本番可否は最終回答だけでは判断できません。
見るべき対象は、回答までの過程全体です。
対象業務は狭くする
Databricksは、本番化を妨げる例として、広すぎるユースケース、不要な複数エージェント化、過剰な推論ループ、評価の後回しを挙げています。
最初から「営業業務を自動化する」と定義すると、対象が広すぎます。
「問い合わせメールを3分類し、担当者へ提示する」まで絞れば、正解と失敗を具体的に決められます。
モデルより実行経路を評価する
文章が正しくても、許可していないデータを読んでいれば本番には出せません。
最終結果だけでなく、利用した道具、参照したデータ、再試行、エラー、外部操作を記録します。
ここが従来の生成AI評価との大きな違いです。
仕事・事業への影響
業務自動化
問い合わせ対応エージェントでは、分類精度だけでなく、顧客情報の閲覧範囲、送信前の承認、重複タスク、停止後の未処理管理を確認します。
自動処理が完了していても、裏側で何度も失敗していれば費用と待ち時間が増えます。
コンテンツ制作
素材取得、要約、下書き、校正、公開までを一つのエージェントへ任せる場合、公開権限が最大のリスクになります。
最初は下書き作成までに限定し、人が出典、利用権、表現、公開先を確認します。
完全自動化より、公開前に一度だけ承認を置くほうが運用しやすい場合があります。
一人・少人数の事業
大企業と同じ管理組織を作る必要はありません。
売上、顧客、公開期限に関係する一つのエージェントだけを選びます。対象を絞れば、評価と確認を続けられます。
本番運用する5つの判断軸
1. 業務と合格条件
対象を一つの工程へ限定します。
正常例だけでなく、間違った分類、情報不足、入力形式の違いなど失敗例も用意します。
2. 評価
実際の業務に近い入力を使い、担当者が結果を評価します。
文章の自然さだけでなく、正しい道具を選んだか、必要な根拠へ戻れるかも確認します。
3. 実行追跡
利用したデータ、道具、エラー、再試行、外部操作を記録します。
問題が起きたときに「なぜこの結果になったか」を再現できなければ、安定した改善ができません。
4. 権限と費用
閲覧、更新、削除、外部送信を分けます。
費用は総トークン量だけでなく、失敗や再試行を含む一業務あたりの値で確認します。
5. 停止・復旧・責任者
異常時に自動処理を止め、未処理の仕事を人へ戻します。
誰が確認し、誰が再開し、誰が改善するかを公開前に決めます。
導入前に確認すること
今回の発表は新しいモデルや料金プランではなく、Databricksによる公式実務ガイドです。
AgentOpsの考え方は他の環境でも使えますが、Unity CatalogやMLflowなどの製品構成をそのまま導入する必要はありません。
まず確認するのは、現在使っているサービスで次ができるかです。
実行ログを取得できる
利用者とAIの権限を分離できる
外部送信前に承認を置ける
費用を処理単位で確認できる
失敗した仕事を人へ戻せる
SHOJIの見立て
AIエージェントの価値は、自律しているように見えることではありません。
人が毎回操作しなくても、決めた範囲で仕事を進め、問題があれば追跡し、止め、戻せることです。
私は、最も賢いモデルを選ぶ前に「この仕事をどこまで任せるか」を決めます。
モデル比較はAIへ手伝わせられます。合格条件、顧客データの権限、外部送信、停止後の責任は人が決めます。
作業の面倒はAIへ渡しても、業務の責任まで曖昧にしない。それがAgentOpsの実務上の価値だと見ています。
40分の小さなβ実験
目的
既存のAI自動化一つを、本番へ出せる状態か判断します。
手順
売上、顧客、公開に関係する業務を一つ選ぶ
対象工程を一文で書く
正常例を3件、失敗例を3件用意する
残す実行記録を決める
閲覧・更新・外部送信の権限を分ける
費用と再試行の上限を決める
停止後の手動手順を書く
確認者と改善責任者を決める
観察項目
合格と失敗を区別できるか
参照データと道具を追跡できるか
再試行が見えるか
AIの権限を限定できるか
停止後に入力を失わないか
人が手作業で完了できるか
停止条件
次のいずれかに該当する場合は、完全自動化へ進みません。
合格条件を決められない
実行経路を確認できない
機密データの閲覧範囲を限定できない
外部送信を止められない
失敗後に人へ戻せない
責任者が決まらない
まとめ
AgentOpsは、AIエージェントを管理する新しいツール名ではありません。
品質、実行追跡、権限、費用、停止と改善を繰り返す運用規律です。
最優先は、重要な一つの業務を選び、40分で5つの判断軸を確認することです。未決項目があれば、完全自動化ではなく承認制から始めます。
一次情報
Databricks「Announcing the Databricks Big Book of AgentOps」
https://www.databricks.com/blog/announcing-databricks-big-book-agentops
Databricks「How we eliminated $1 million a year of wasted AI agent spend in one hour」
https://www.databricks.com/blog/how-we-eliminated-1-million-year-wasted-ai-agent-spend-one-hour
作成したAgentOpsカードで、最初に不足した項目を一つだけ改善してください。
いいなと思ったら応援しよう!
 AIHALOは、不動産業界のAIシフトを加速させるための情報発信を行っています。もし活動にご共感いただけましたら、チップにてご支援いただけますと幸いです。あなたからの応援が、より実践的で価値あるコンテンツ作成の原動力となります。
