
【30枚検証】LitVideoのSeedance 2.5は全員を再現できる?3枚・30枚で試した結果

「複数の人物画像を、1本のAI動画にまとめたい」
「人物と背景を別々の画像で指定したい」
「Seedance 2.5は最大30枚まで使えるけれど、本当に全員を出せるの?」
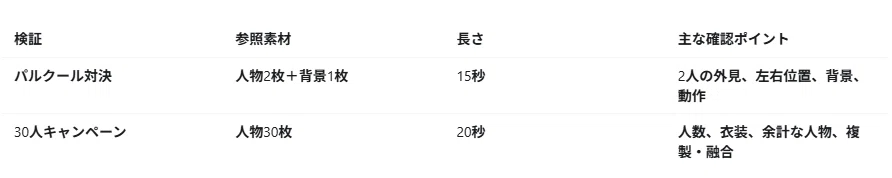
今回はLitMediaのLitVideoで使える「Seedance 2.5」を使い、次の2パターンを実際に試しました。
人物2枚+背景1枚から、15秒のパルクール動画を生成
30人分の画像から、20秒のキャンペーン風動画を生成
結論からいうと、3枚の参照では人物と背景の役割を分けやすく、2人の衣装と屋上の雰囲気を生かした動画を作れました。
一方、30枚を一気に使う検証では、プロンプトを直すと余計な人物や衣装の変化は減ったものの、30人全員の登場と完全な再現まではできませんでした。
この記事では、実際の設定、生成結果、失敗したプロンプトの問題点、改善版プロンプトまでまとめます。
※本記事には、プロモーション・アフィリエイトリンクが含まれる場合があります。
※この記事は2026年8月27日時点の情報と、2026年8月22日に保存した操作画面をもとにしています。画面、機能、料金、必要クレジットは変更される場合があります。
👇動画で操作画面と完成結果を見る👇
Seedance 2.5で今回試したこと
LitMedia公式のSeedance 2.5紹介ページでは、オムニ参照モードで最大30枚の画像、10本の動画、10件の音声、合計50件まで参照できると案内されています。
動画の長さは4〜30秒、解像度は480pまたは720pに対応しています。
今回の検証は、その中でも特に気になった「複数画像の役割分け」と「画像30枚の同時参照」に絞りました。
まずは3枚の画像からパルクール動画を作る
最初は、少ない参照素材で基本的な使い方を確認しました。
用意したのは、赤い服の女性A、青い服の女性B、都市の屋上背景の3枚です。
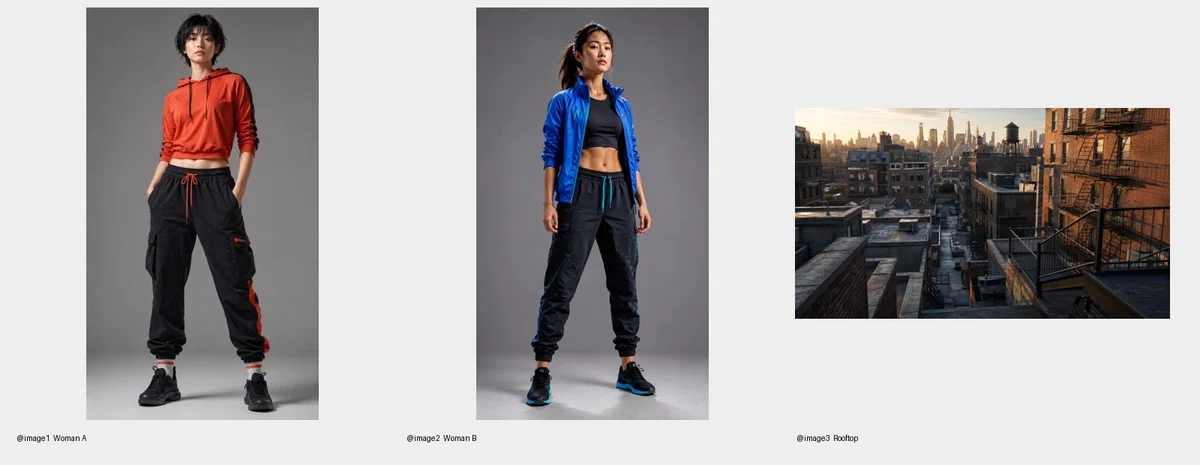
人物画像は顔・髪型・体格・衣装の参考、屋上画像は建築・照明・色調の参考として使います。
Seedance 2.5を選択する
LitVideoのホーム画面から動画生成を開き、モデル一覧で「Seedance 2.5」を選びます。
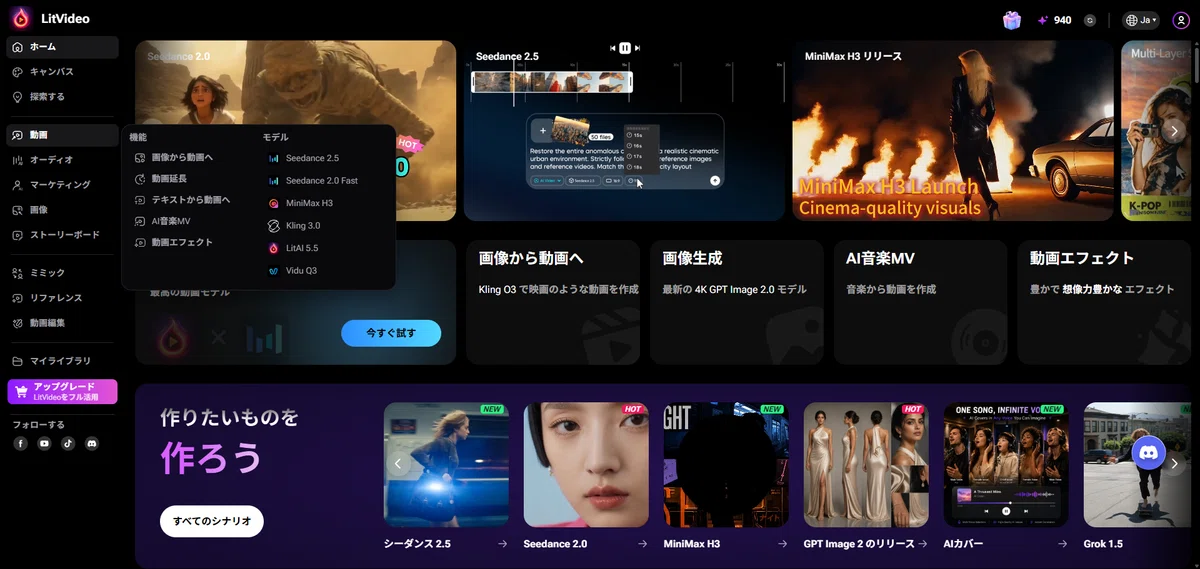
生成モードは「参考動画」を使用しました。現在の公式ページでは「オムニ参照」と案内されているため、表示名は今後変わる可能性があります。
3枚をアップロードして役割を指定する
3枚を追加したら、プロンプト内で次のように割り当てます。
`@image1`:女性A
`@image2`:女性B
`@image3`:屋上の背景
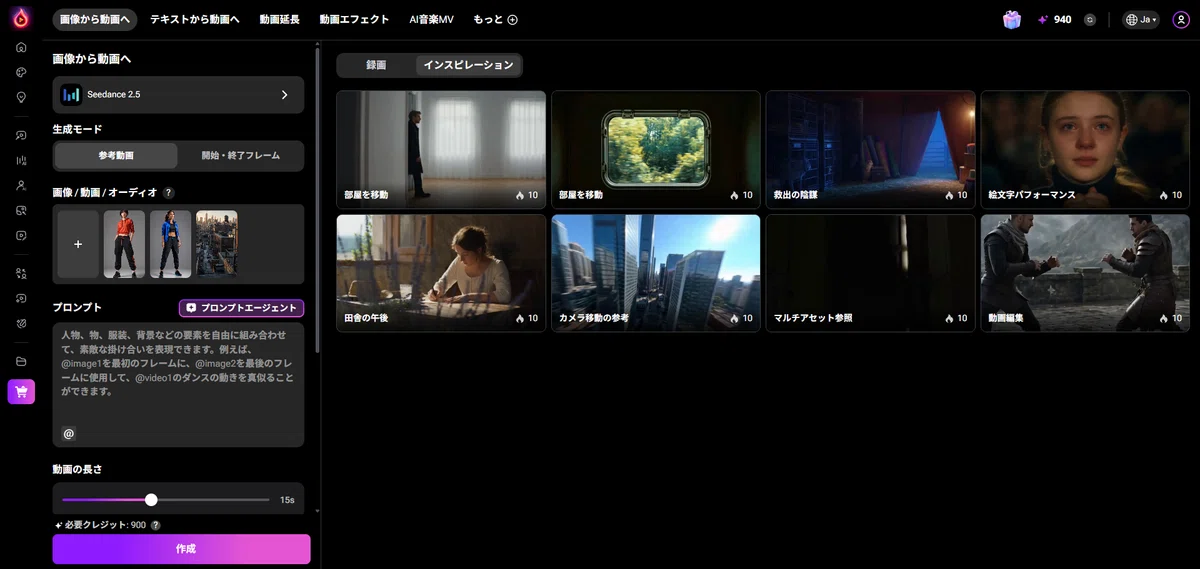
`@image1`のように参照先を明示すると、どの画像から人物、衣装、背景を使うのか整理しやすくなります。
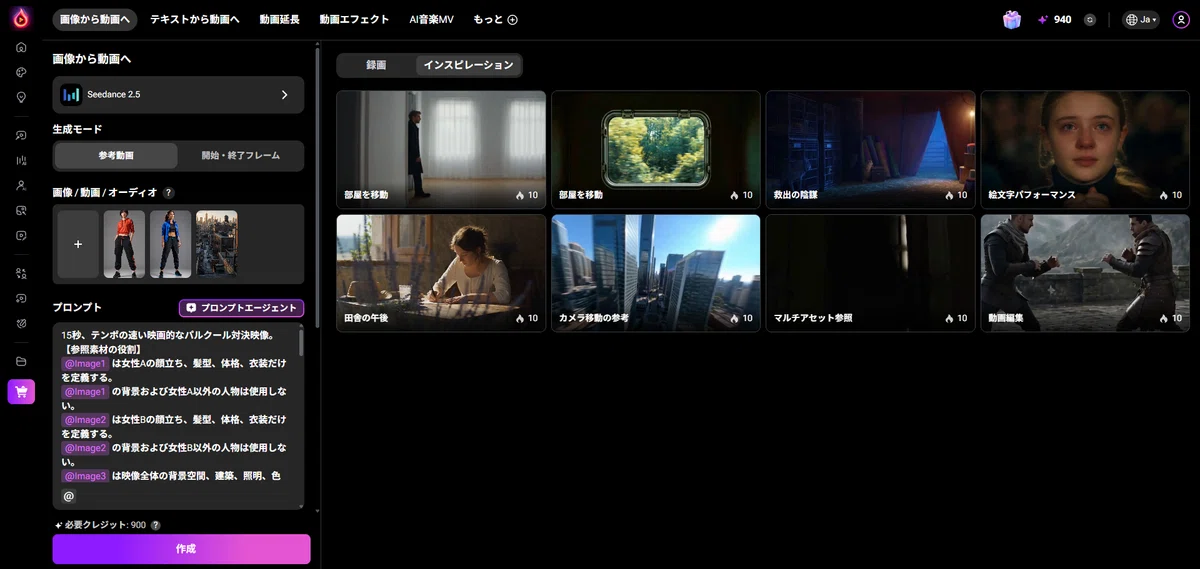
今回使ったプロンプトはこちらです。
15秒、テンポの速い映画的なパルクール対決映像。

【参照素材の役割】
@image1は女性Aの顔立ち、髪型、体格、衣装だけを定義する。
@image1の背景および女性A以外の人物は使用しない。

@image2は女性Bの顔立ち、髪型、体格、衣装だけを定義する。
@image2の背景および女性B以外の人物は使用しない。

@image3は映像全体の背景空間、建築、照明、色調だけを定義する。
@image3に写っている人物は使用しない。
建築デザインを保ちながら、走行ルートに沿ってパルクール用の障害物を自然に配置する。

【人物と位置関係】
登場人物は女性Aと女性Bの二人だけ。
追加人物、群衆、人物の複製、融合、入れ替わりは発生させない。

女性Aは画面左側、女性Bは画面右側を走る。
二人は同じ方向へ並走し、互いの技術を競い合う。
映像全体を通して左右の位置関係を維持する。
女性Aと女性Bの顔、髪型、体格、衣装を全カットで一貫させる。

【約0〜3秒:競争開始】
最初はワイドショット。
女性Aを左、女性Bを右に映し、二人が同時に走り始める。
背景空間、進行方向、最初の障害物が明確に見える構図。

低い後方追従ショットへ素早く切り替える。
二人は横並びのまま速度を上げる。

【約3〜7秒:最初の障害物】
女性Aが左側の低い障害物を、片手をついた滑らかなヴォルトで越える。
女性Bが右側の障害物を、軽快なジャンプで越える。
踏み切りから着地までを明確に映す。

【約7〜11秒:異なる技の応酬】
女性Aが左側の高い障害物を力強く跳び越え、安定して着地する。
女性Bが右側の壁で2〜3歩の短いウォールランを行い、進行方向へ跳び降りる。

【約11〜15秒:クライマックス】
背景全体が見えるワイドショット。
女性Aは左、女性Bは右のまま並んで加速する。
二人が同時に大きな段差を前方へジャンプし、安全に着地する。
着地後、一瞬だけ互いに顔を向け、達成感のある笑顔を交わして終わる。

【映像表現】
映画的でスタイリッシュ、速いテンポ、明確なカット編集。
各カットでは一つの技を明確に見せる。
カットが変わっても、進行方向と二人の左右関係を維持する。
身体の関節、手足、踏み切り、着地を自然に表現する。
過度な手ぶれ、急激なカメラ回転、極端なモーションブラーは避ける。
元のプロンプトでは各カットの終了状態まで細かく書いています。記事パッケージには原文も同梱しています。
生成設定
今回の設定は次のとおりです。
モデル:Seedance 2.5
生成モード:参考動画
参照画像:3枚
動画の長さ:15秒
動画品質:720P
サイズ:16:9
サウンド:サウンドを生成
必要クレジット:900(保存した画面に表示された値)
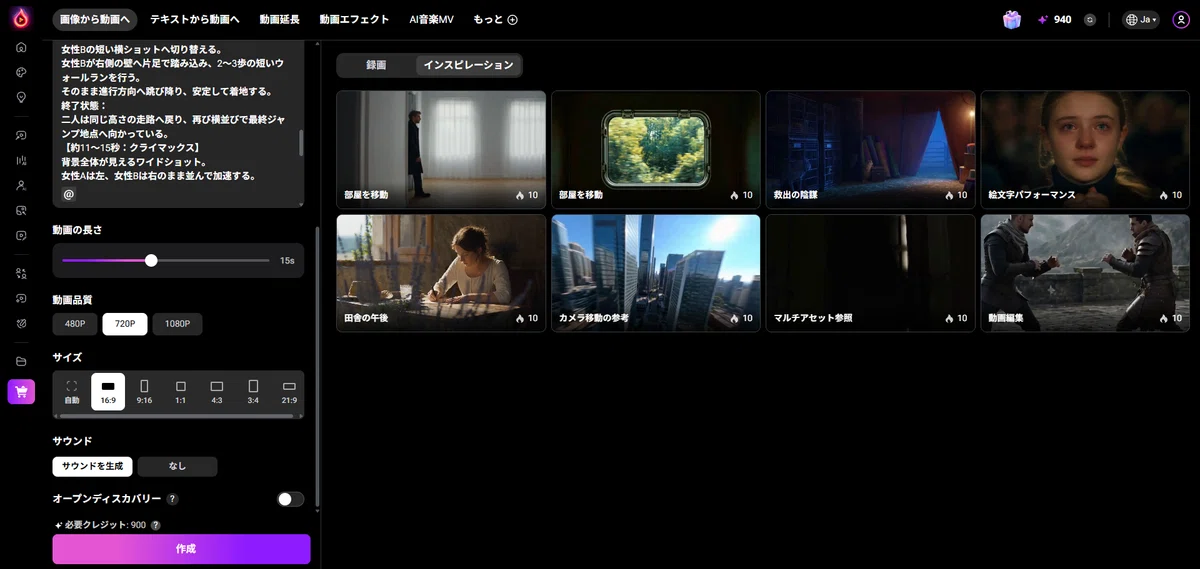
必要クレジットは設定や時期によって変わる可能性があります。必ず生成ボタンを押す前の表示を確認してください。
生成結果
完成した動画では、赤と青の衣装を着た2人が同じ屋上を走り、カットを切り替えながら競う映像になりました。
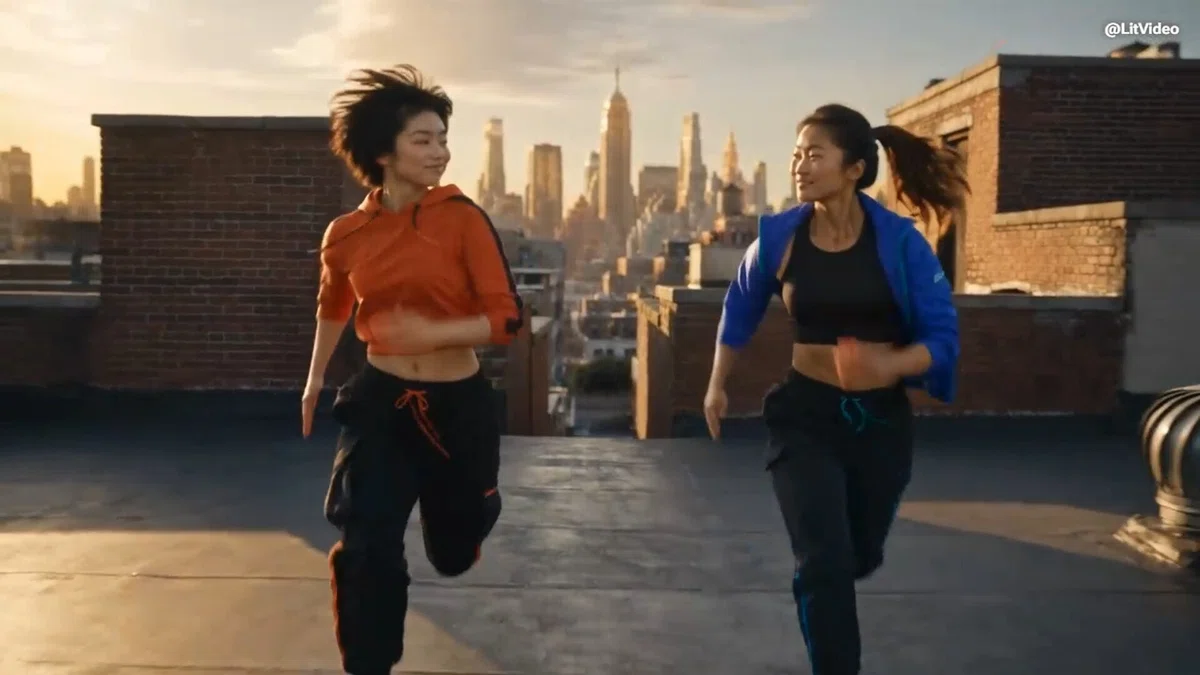
少なくとも保存したフレームでは、次の点を確認できます。
赤い服の女性Aと青い服の女性Bが同時に登場している
2人の衣装色が区別されている
参照した都市の屋上に近い背景が使われている
追加人物は見当たらない
動画全体では走行、ジャンプ、カット変更も入り、人物2枚と背景1枚だけでも映像の流れを作れました。
役割の違う素材を使うときは、「何を維持するか」だけでなく「何を使わないか」まで書くのがポイントです。
次は30枚の人物画像を一気に参照する
続いて、Seedance 2.5で追加できる画像数の上限となる30枚を使いました。
人物の違いを確認しやすいように、水着、カジュアル、着物、ゴシック、スポーツウェア、制服風など、衣装が大きく異なる画像を用意しています。
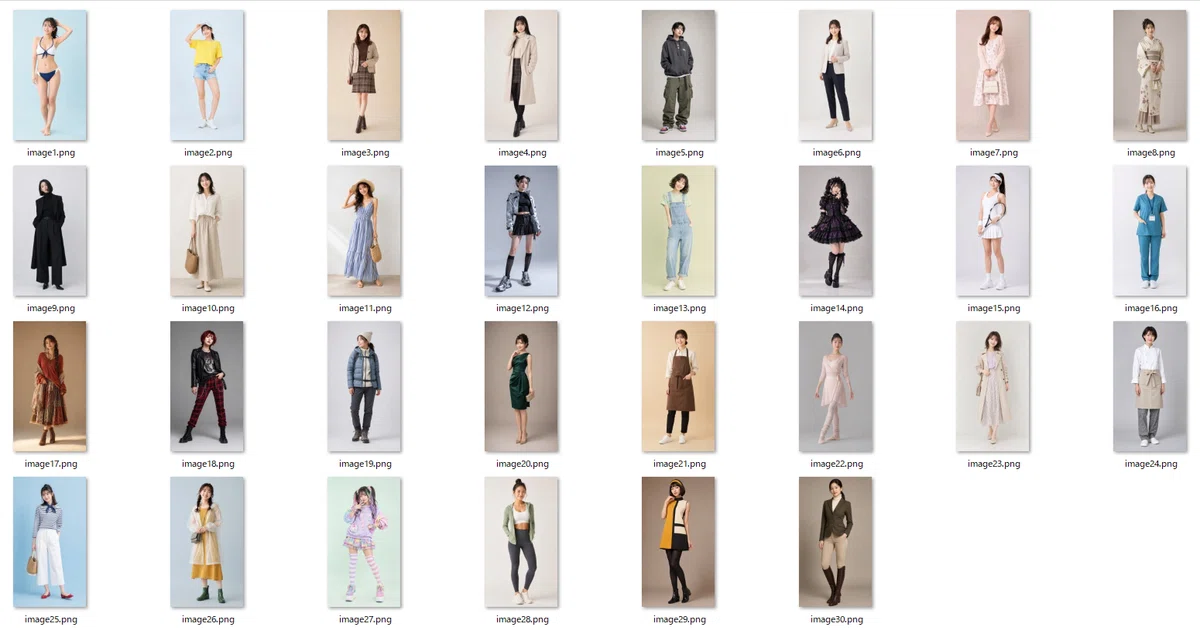
目標は、1人から始まり、7人、14人、22人、最後に30人へ増える20秒のサマーキャンペーン風動画です。
舞台は南国の高級リゾートプールサイド。人数が増えるごとに正面、サイド、ワイドへカメラを切り替える構成にしました。
1回目は余計な人物と衣装の変化が発生
1回目の生成では、最初は1人から始まったものの、参照画像にいない女性が途中で登場しました。
さらに、参照画像では水着が1人だけなのに、複数の人物が水着風の衣装へ変わって見える場面もありました。
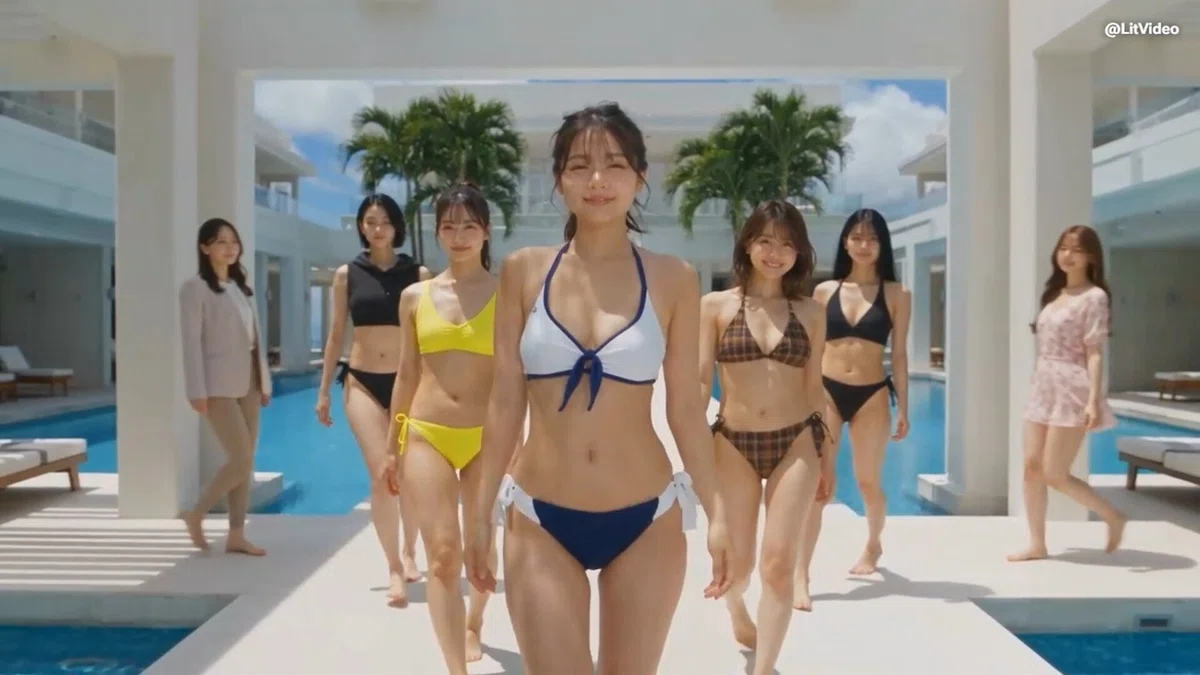
ここには、プロンプト上の2つの問題がありました。
1つ目は、固定出演者以外の通行人、客、遠景の人物、反射などを明確に禁止していなかったことです。
2つ目は、原文に次の指定が入っていたことです。
各参照画像から、対応する女性の顔、髪型、体格、水着のデザインと色だけを使用する。実際の参照画像は大半が水着ではありません。「衣装」ではなく「水着」と一括指定したため、衣装が水着寄りになる要因になった可能性があります。
これは生成結果から断定できる原因ではありませんが、参照画像とプロンプトが矛盾していたのは確かです。
2回目は出演者と禁止事項を細かく指定
修正版では、登場できる人物を`@image1`から`@image30`の30人だけに限定しました。
さらに、次の条件を追加しています。
通行人、客、スタッフ、遠景の人物を出さない
人物のシルエットや、鏡・ガラス・水面の人物反射を出さない
同じ人物を複製しない
別人同士の顔・髪型・衣装を融合しない
各ステージの人数を1人、7人、14人、22人、30人に固定する
登場済みの人物を次のステージで消さない
以下は、実際の修正版を記事向けに整理したプロンプトです。
※元原稿の「水着」は、参照画像と一致するよう「衣装」に変更しました。意味が変わる修正です。
20秒のラグジュアリーなサマーキャンペーン映像。

【固定出演者】
映像に登場できる人間は、@image1〜@image30で指定した30人の成人女性だけ。
@image1を女性1、@image2を女性2、以降同様に@image30を女性30とする。

各参照画像から使用するのは、対応する女性1人の顔、髪型、体格、衣装のデザインと色だけ。
参照画像の背景、撮影場所、ポーズ、構図、照明、ほかの人物は使用しない。
30人を全員別人として扱い、人物を複製、融合、交換しない。
1つの人物番号につき画面内に存在できるのは1人だけ。

固定出演者以外の通行人、客、スタッフ、追加モデル、群衆、遠景の人物、ぼやけた人物、人物のシルエットを生成しない。
鏡、ガラス、水面には人物の反射を生成しない。
指定人数を満たすために、参照画像に存在しない人物を補完しない。

【舞台】
明るい南国の高級リゾートプールサイド。
白い石材、鮮やかな青いプール、直線的な現代建築、ヤシの木、爽やかな夏の日差し。
施設は貸し切りで、固定出演者以外の利用客や従業員はいない。
全編を通して、光の方向、プールと建築の位置、女性たちの歩行方向を維持する。

【映像演出】
ラグジュアリーブランドのサマーキャンペーン映像。
自然な歩行、計算された人物配置、意味のあるカットでテンポを作る。
女性たちは落ち着いた表情と自然な姿勢で、同じ方向へ堂々と歩く。
各ステージではカメラの動きを1つに限定し、ステージ境界でカットを切り替える。

【ステージ1:0〜2秒】
使用人物:女性1だけ。正確な人数は1人。
女性1が単独でプール沿いの中央通路を歩く。
カメラは正面の目線の高さから一定速度で後退する。

【ステージ2:2〜6秒】
使用人物:女性1〜女性7だけ。正確な人数は7人。
女性1を中央前方に維持する。
女性2〜女性7が無人の左右の入口と奥の通路から、番号順に1人ずつ合流する。

【ステージ3:6〜10秒】
使用人物:女性1〜女性14だけ。正確な人数は14人。
女性1〜女性7を消さず、外見、衣装、前後関係、歩行方向を維持する。
サイドトラッキングショットへ切り替える。
女性8〜女性14が番号順に1人ずつ合流する。

【ステージ4:10〜15秒】
使用人物:女性1〜女性22だけ。正確な人数は22人。
女性1〜女性14を消さず、外見、衣装、人数、前後関係、歩行方向を維持する。
広めの正面ショットへ切り替える。
女性15〜女性22が番号順に1人ずつ合流する。

【ステージ5:15〜20秒】
使用人物:女性1〜女性30だけ。正確な人数は30人。
女性1〜女性22を消さず、外見、衣装、人数、前後関係、歩行方向を維持する。
女性23〜女性30が番号順に1人ずつ合流する。
カメラはゆっくり上昇しながら後退し、30人、プール、現代建築、ヤシの木をワイド構図に収める。

【全編の一貫性】
各ステージの人数は1人、7人、14人、22人、30人。
指定人数を超える人物を画面内にも背景にも生成しない。
登場済みの人物を消さない。同じ人物を複数生成しない。登場順より先に出さない。
異なる人物の顔、髪型、体格、衣装を混ぜない。
人物の外見、衣装、人数、前後関係、進行方向をステージ間で維持する。
修正後の結果
台本に残した検証記録では、1回目より次の点が改善しました。
参照画像にない人物が大幅に減った
水着風へ変わる人物が減った
黄色い服、チェック柄、着物、ゴシック、スポーツウェアなど、元画像の衣装が残りやすくなった
人物同士を別人として見分けやすくなった
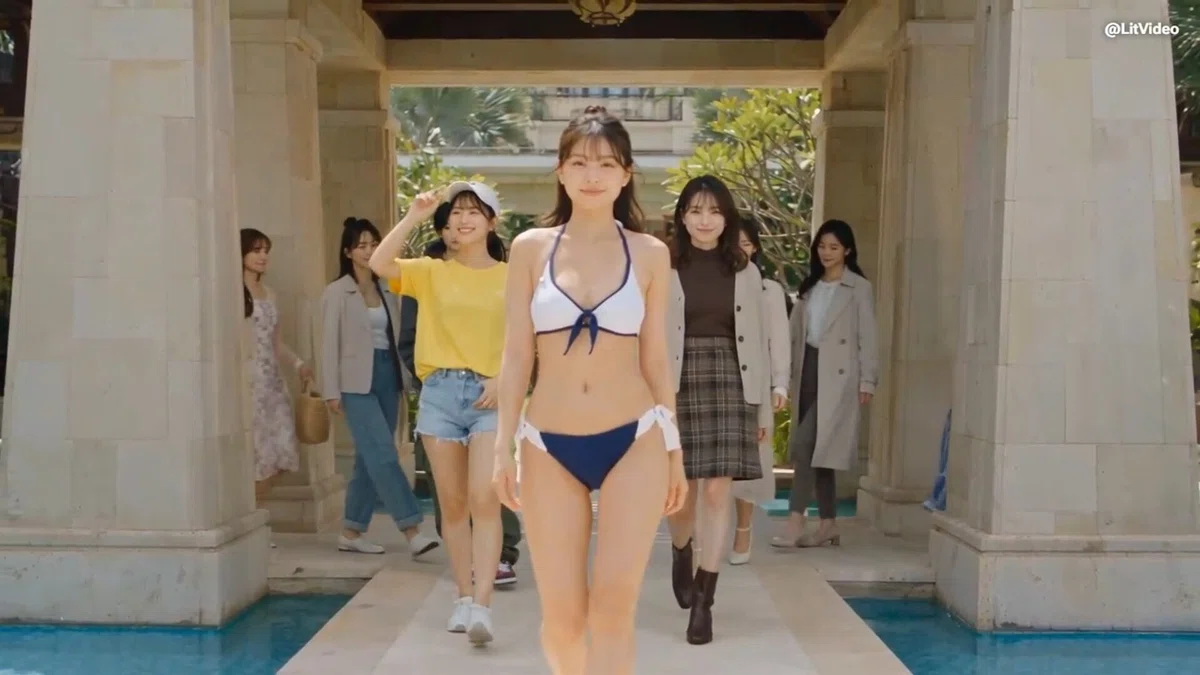
ただし、修正版でも30人全員の登場は確認できず、顔や衣装も完全一致ではありませんでした。
20秒の中で、30人の顔、衣装、人数、位置、登場順、カメラワークを同時に守らせるのは、かなり情報量の多い指示です。
「最大30枚を参照できる」ことと、「30人を同時に完全再現できる」ことは別だと考えたほうがよさそうです。
なお、ZIPには30人検証の完成動画が含まれていなかったため、この節は保存された台本の観察記録にもとづいています。公開前に1回目・2回目の動画または代表フレームを追加すると、比較がより伝わりやすくなります。
大量の参照画像で学んだ5つのコツ
1. 最初は3枚前後から役割分けを覚える
人物、背景、スタイルなど、役割の違う参照素材を少数から試すと、どの指定が結果に効いたのか判断しやすくなります。
30枚から始めると、失敗の原因が参照画像なのか、プロンプトなのか、尺なのか切り分けにくくなります。
2. 維持する要素と使わない要素を分ける
「顔と衣装を使う」だけでなく、「元画像の背景、ポーズ、ほかの人物は使わない」と書きます。
画像ごとの役割が混ざりにくくなり、背景や人物の不要な引き継ぎを抑えやすくなります。
3. 人数だけでなく、登場できない人物も指定する
群衆シーンでは、AIが空間を自然に見せるため人物を補うことがあります。
通行人、スタッフ、遠景、シルエット、反射まで禁止対象として書くと、出演者の範囲が明確になります。
4. 「衣装」と「水着」のような言葉の矛盾をなくす
参照画像と一致しない単語が1つ入るだけでも、生成方向が変わる可能性があります。
プロンプトを長くする前に、人物、衣装、人数、背景の指定が素材と一致しているか確認するのが大切です。
5. 30人を1本で完成させる前に段階テストする
まず1〜7人で人物の外見と登場方法を確認し、次に14人、22人へ増やすほうが調整しやすくなります。
クレジットを使う前に、短い尺や少ない人数で失敗条件を探す方法も有効です。
クレジット・商用利用・素材の権利に注意
今回保存した画面では、15秒・720P・16:9・サウンド生成で900クレジットと表示されました。
ただし、必要クレジットや料金は変わる場合があります。LitVideoの料金ページと、生成直前の画面を確認してください。
商用利用について、LitMediaの料金ページでは商用利用可能と案内されていますが、公式サポートは使用モデルやコンテンツガイドラインによって権利が異なる場合があると説明しています。
公開・販売・広告利用の前に、最新の利用規約と、使用したモデルの条件を確認してください。
また、人物の画像をアップロードするときは、本人の同意、肖像権、プライバシー、著作権を確認する必要があります。
今回のように30人分の顔画像を使う場合は、生成できるかどうかだけでなく、30枚すべてに利用権限があるかを先に確認しましょう。
Seedance 2.5の複数参照はこんな人に向いている
人物と背景を別の画像から組み合わせたい人
同じキャラクターを複数カットで使いたい人
商品、衣装、場所、映像スタイルを分けて指定したい人
生成結果を見ながらプロンプトを段階的に直せる人
反対に、大人数を1回で正確に数え、全員の顔と衣装を完全一致させたい用途では、追加生成や動画編集を前提にしたほうが現実的です。
まとめ
Seedance 2.5の複数参照は、画像ごとの役割を決めると、人物と背景を組み合わせた映像を作りやすくなります。
今回の3枚テストでは、2人の衣装と屋上背景を生かしたパルクール動画を生成できました。
一方、30枚テストでは、固定出演者、禁止事項、段階ごとの人数まで細かく書くことで改善したものの、30人全員の完全再現には届きませんでした。
大量参照で大切なのは、画像をたくさん入れることより、次の4点を矛盾なく指定することです。
誰を使うか
何を維持するか
誰・何を出さないか
各場面で何人いるか
まずは少ない枚数で役割分けを試し、結果を見ながら人数と指示を増やしてみてください。
次に試してほしいAI動画の検証があれば、コメントで教えてください。
👇動画で操作画面と完成結果を見る👇
こちらもオススメ!
💬 感想・質問はコメント欄でどうぞ!
💖「スキ」や「フォロー」で応援いただけると嬉しいです!
🎬YouTubeチャンネル登録もよろしくお願いいたします!
#LitMedia
#LitVideo
#Seedance25
#AI動画生成
#動画生成AI
#画像から動画
#複数画像参照
#人物一貫性
#AI動画ツール
#AI活用
いいなと思ったら応援しよう!
 応援よろしくお願い致します!いただいたチップは活動費に使わせて頂きます!
