MiniMax-H3をMacで口パクさせたかっただけなのにAudio Latentを掘ることになった話
Macでローカル動画生成をいじっていて、ふと思った。
「MiniMax-H3、外部音声に合わせて口パクできないの?」
やりたかったことは本当にこれだけだった。
自分で用意した音声を渡して、その音声に合わせて人物の口が動く。
できれば追加のLipSyncモデルを通さず、MiniMax-H3自身が持っているAudio / Video生成能力をそのまま使いたい。
たったそれだけだった。
しかし気がついたら、
・Audio VAE
・Audio Latent
・Stereo Latentのpacking
・timestep
・denoise mask
・packed token layout
・Motion Context
・Turbo
・FastH3
あたりを掘っていた。
どうしてこうなった。
この記事は、Apple Silicon Mac上でMiniMax-H3に外部音声を直接固定してLipSyncさせるところまで試した記録。
最終的には、
普通のH3
→ 実写ならかなり成功
Turbo H3
→ 実写成功、しかも高速
FastH3
→ 実装できたがLipSyncとしては失敗
2Dアニメ
→ 現状かなり厳しい
という結果になった。
──────────────
■ 環境
──────────────
検証環境はApple Silicon Mac。
MiniMax-H3をMLX系のローカル実装で動かしている。
CUDA環境のComfyUIワークフローをそのまま使った話ではなく、Mac上でH3のAudio / Video Latentを直接扱った検証になる。
今回使った音声は、自分で録音した簡単なテスト音声。
内容はだいたい、
「あーーー」
↓
無音
↓
「あー、いー、うー、えー、おー」
↓
無音
というもの。
LipSyncを見るには歌や普通の会話より、このくらい単純な方が分かりやすい。
確認したかったのは主に、
・発声中に口が動くか
・無音で止まるか
・母音ごとに口の形が変わるか
この3つ。
──────────────
■ そもそもMiniMax-H3にはAudioがいる
──────────────
MiniMax-H3は映像だけを生成するモデルではなく、AudioとVideoを一緒に扱う。
かなり雑に書くと、内部では、
Text
Audio Latent
Video Latent
をまとめて処理している。
そこで思いつく。
「生成させるAudio Latentを、自分の音声のAudio Latentに固定してしまえばいいのでは?」
外部音声をAudio VAE EncoderでLatentへ変換。
そのLatentを生成中に変更させず、その横でVideoだけをdenoiseする。
イメージとしては、
外部音声
↓
Audio VAE Encoder
↓
Clean Audio Latent
↓
Audio側は固定
Video側だけdenoise
↓
MiniMax-H3 joint Audio / Video生成
という形。
今回この方式を便宜上「NativeAudioLock」と呼んでいる。
後から調べてみると、H3コミュニティにも同じ発想でAudio Latentを固定する実装がいくつか存在していた。
なので方向性そのものは、そこまで変なものではなかったらしい。
──────────────
■ 最初の結果:ダメでした
──────────────
実装して、とりあえず生成。
……なんかおかしい。
音もLipSyncも妙。
特に左右チャンネルのタイミングがズレている。
外部音声自体は左右同一なのに、生成後のAudioを見るとL / Rで時間方向がズレていた。
最初は、
「H3の外部Audio Conditioningってこんなもん?」
とも思った。
違った。
普通に自分のpacking bugだった。
──────────────
■ Audio Latentの罠
──────────────
Audio VAEから出てきたLatentは、
[1, 32, 2, T]
という形だった。
この「2」がStereoのL / R。
H3側で扱うため、これをrowへ変換する。
今回の形式では、
L0
L1
L2
…
L(T-1)
R0
R1
R2
…
R(T-1)
というchannel-major構成。
ところが、動画側が必要とするAudio時間長と、入力音声から生成されたLatentの長さが一致しない。
なのでpaddingが必要になる。
最初の実装では、
Audio Latent
↓
row化
↓
末尾へpadding
としてしまった。
これがダメだった。
L / Rを1本のrow列にしてから末尾へpaddingすると、後でStereoとして復元したときにチャンネル境界そのものがズレる。
正しくは、
[1, 32, 2, Tsrc]
↓
time axisをpad / trim
↓
[1, 32, 2, Ttarget]
↓
その後でrow化
↓
[L0...L(T-1), R0...R(T-1)]
だった。
つまり、
「Stereoをpackする前に時間軸を合わせる」
これが重要だった。
この修正後、左右チャンネルは完全に一致。
LipSync以前の問題だった。
──────────────
■ 直したら、おっさんが喋った
──────────────
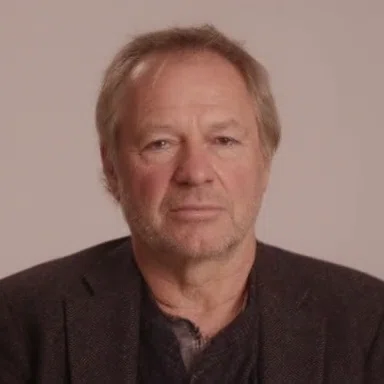
packing bugを直した後、実写人物で再検証。
条件は、
384×384
24fps
141frames
8 steps
seed 7
Reference Imageなし
Motion Contextなし
外部Audioのみ固定
人物はPromptだけで生成した普通のおっさん。
ちなみに「なぜおっさんなのか」に深い意味はない。
顔全体と口が確認しやすく、変な美少女バイアスも避けたかっただけ。
結果。
普通に喋った。
しかも思っていたよりちゃんとしていた。
「あーーー」で口が開く。
無音区間では口の動きが減る。
後半の「あいうえお」でまた動く。
「い」「う」「え」などでは、口の形にも違いが見える。
完全なphoneme-level LipSyncと断言するつもりはないが、少なくとも目視では、
「この人がこの音声を喋っている」
と感じられるレベルだった。
普通のMiniMax-H3でのsampling時間は約82秒。
これはかなり面白い。
──────────────
■ ところが最後に「プーーーー」
──────────────
成功した!
と思ったら、動画の最後から謎の音がする。
プーーーーー。
なんだこれ。
LipSyncのAudio処理を壊した?
Stereo packingまだ変?
調べた。
犯人は別だった。
──────────────
■ Zero Latentは無音ではない
──────────────
元音声は約5.525秒。
ところが141frames / 24fpsの動画側は約5.875秒。
つまり動画の方が約0.35秒長い。
この不足分をAudio Latentの0埋めで補っていた。
普通に考えると、
0 = silence
な気がする。
だがAudio VAEではそうならなかった。
Zero LatentをAudio VAE Decoderへ入れても、音響的な無音にはならない。
今回の環境では、約400Hz付近の一定音としてdecodeされた。
つまり最後の「プー」は、
「Audio Latentのpaddingを無音だと思い込んだ結果」
だった。
LipSync自体とは無関係。
最終動画では、生成したAudioを使わず、元のMaster Audioをそのままmuxすることで解決した。
映像は141frames全部残す。
Audioだけ元音声を使う。
これで末尾の音は消えた。
──────────────
■ じゃあTurboでも動くのでは?
──────────────
ここまで来ると当然やりたくなる。
MiniMax-H3 Turboにも同じNativeAudioLockを適用。
同じように、
384×384
141frames
24fps
seed 7
同じ音声
同系統の実写人物
で検証。
結果。
TurboでもLipSyncした。
そして速い。
通常H3
sampling 約82.1秒
Turbo H3
sampling 約44.3秒
約1.85倍高速。
口の動きも発声 / 無音にかなり追従しており、実用候補として十分。
「これTurboでいいじゃん」
と思った。
──────────────
■ Turbo、お前なんか白いぞ
──────────────
生成された141framesを全部確認すると、別の問題があった。
一瞬だけ、
「白いpolygonのような謎の物体」
が出るフレームがある。
最初はMP4のcodec artifactかと思った。
しかしraw PNGにも存在していた。
つまり動画圧縮ではなく、生成側。
確認できたものは単発frameが多く、一部は2~3frames程度連続する。
周期性はなし。
音声との明確な相関も、現時点では確認できていない。
NativeAudioLockが原因なのか。
Turbo 4-step由来なのか。
VAEなのか。
まだ確定していない。
ということでTurboは、
LipSync
→ 合格
速度
→ かなり良い
謎の白polygon
→ 要調査
という結果になった。
──────────────
■ FastH3にもNativeAudioLockを生やしてみる
──────────────
次にFastH3。
既存のApple MLX FastH3実装を調べると、モデル自体はjoint Audio / Video構造を持っている。
Audio input / output projectionもある。
Audio VAE Encoderのweightもある。
しかし既存runnerでは、
「外部Audioを入れる経路そのものがない」
という状態だった。
FastH3が対応していないというより、単純に実装されていない。
なら作ればいい。
まずmodelを一切ロードせず、
・[1,32,2,T] contract
・time-axis padding
・Stereo channel-major packing
・unpack
・packed layout
・Audio timestep固定
・frozen owner
・Audio update skip
・既存Fast pathとの回帰
をテスト。
NativeAudioLock contractは18 / 18 PASS。
既存FastH3 regressionも9 / 9 PASS。
その後Audio VAE Encoderへ実音声を接続。
Audio-only gateもPASS。
そして実render。
生成成功。
NativeAudioLockも技術的には正しく動作。
Audio Latentも各stepで固定されたまま。
swap増加 0MiB。
peak MLX 約16.55GiB。
Turboで出た白polygonも、
141frames中0。
おお。
FastH3大勝利か?
──────────────
■ FastH3、口は動く。でも音を聞いていない
──────────────
動画を見る。
口は動いている。
でも……
音声と関係なく動いている。
発声中だから開くわけではない。
無音だから閉じるわけでもない。
「あいうえお」と口形状の相関も見えない。
つまり、
NativeAudioLock plumbing
→ 成功
FastH3 generation
→ 成功
LipSync
→ REJECT
という結果。
これは結構面白かった。
単にNativeAudioLock実装が壊れているなら、Audio Latent driftやlayout異常が出るはず。
しかしそこは検証を通っている。
それでもVideo側が音声へ十分追従しない。
通常H3やTurboに残っているAudio → Videoの結び付きが、FastH3の高速化過程では弱くなっている可能性がある。
少なくとも今回の条件では、
「Audioを固定できる」
ことと、
「LipSyncできる」
ことは同じではなかった。
──────────────
■ そしてアニメはもっと厳しかった
──────────────
実写で成功したので、
「じゃあアニメキャラも喋らせよう」
となる。
まず劇画調の大きな口を持つキャラクター。
失敗。
141framesほぼ口固定。
「口が小さいからでは?」
と思い、今度は普通の現代的2Dアニメ顔。
これも失敗。
口がほぼ動かない。
つまり少なくとも今回の検証では、
実写
→ 成功
2Dアニメ
→ 失敗
というかなり明確なdomain差が出た。
H3内部のAudio / Video joint representationが、実写の人間の口の動きには強く結び付いている一方、2Dアニメの記号化された口には同じ関係が成立しにくいのかもしれない。
ここは今後もう少し調べたい。
例えば、
・半実写
・3DCG
・アニメ調3D
・複数の口形状Reference
などを使えば、境界が見える可能性がある。
ただし現時点では、アニメ向けNativeAudioLockは実用扱いしないことにした。
──────────────
■ 現時点の結果
──────────────
Normal H3
外部Audio
NativeAudioLock
実写LipSync
かなり良好
Sampling
約82.1秒
問題
速度は遅め
Turbo H3
外部Audio
NativeAudioLock
実写LipSync
良好
Sampling
約44.3秒
問題
一部frameに白polygon
FastH3
外部Audio
NativeAudioLock
実写LipSync
REJECT
問題
口は動くが音声と相関しない
白polygon
0 / 141frames
──────────────
■ 現時点の役割分担
──────────────
Normal H3
高品質LipSync用。
速度は遅いが、今回の実写テストでは一番素直に音声へ追従した。
Turbo H3
現在の本命候補。
Normal H3よりかなり高速で、LipSyncも維持。
ただし白polygon問題が残っている。
FastH3
通常の高速T2VA用途では有効。
ただし今回のNativeAudioLock LipSync用途では採用見送り。
──────────────
■ 今回分かったこと
──────────────
一番大きかったのは、
「MiniMax-H3は外部音声LipSyncに利用できる」
ということ。
少なくとも実写人物なら、Audio VAEで外部音声をLatent化し、そのAudio Latentを生成中に固定することで、かなり自然な口の動きを得られた。
ただし実装するときには、
「Audio LatentのStereo packing」
がかなり重要。
特に時間方向のpaddingは、rowへ変換する前に行う必要がある。
そしてもう一つ。
「Zero Audio Latent ≠ Silence」
だった。
これは完全に罠だった。
──────────────
■ 地味に重要だったNativeAudioLockの条件
──────────────
今回うまくいった構成を簡単にまとめると、
外部PCM
↓
Audio VAE Encoder
↓
[1,32,2,T]
↓
time-axisをgeneration長へfit
↓
channel-major Stereo packing
↓
clean target Audio rows
↓
Audio timestepを固定
↓
Audio側はdenoise updateしない
↓
Video側のみ生成
↓
最後は元Master Audioをmux
という流れ。
特に、
「Audio rowsへ変換してからpaddingしない」
という点は重要だった。
正しくは、
時間方向を先に合わせる
↓
その後Stereo rowsへ変換
この順序。
──────────────
■ FastH3で分かったもう一つのこと
──────────────
FastH3ではNativeAudioLockの実装自体は正常だった。
実音声のAudio VAE encodeも成功。
Audio Latentの固定も成功。
生成そのものも成功。
それでもLipSyncにはならなかった。
つまり、
「Audio Latentを固定してjoint AV modelへ入れれば必ず口が同期する」
わけではない。
モデル側に十分なAudio → Video couplingが残っている必要がある。
これは高速化モデルを評価するとき、単純な画質や生成速度だけでは分からない部分だった。
──────────────
■ Turboの白polygonは今後の宿題
──────────────
TurboではLipSync自体はかなり良かった。
Normal H3より約1.85倍高速。
これだけならそのまま実用化したい。
ただし一部frameに出る白polygonが気になる。
現時点で分かっていることは、
・MP4だけの問題ではない
・raw PNGにも存在
・単発frame中心
・一部2~3frames連続
・周期性なし
・音声との相関は未確認
・NativeAudioLock原因とはまだ断定できない
という程度。
ここはもう少し切り分けが必要。
──────────────
■ おわり
──────────────
最初は、
「自分の声でH3のおっさんを喋らせてみよう」
くらいの軽い気持ちだった。
気が付いたらAudio VAEのLatent shapeを眺め、
Stereo channelの境界を調べ、
denoise中のAudio rowが動いていないか確認し、
最後にはFastH3へ存在しなかったExternal Audio入力まで実装していた。
ローカルAIを触っているとよくある。
やりたいことは単純なのに、気づくとモデルの内臓を触っている。
でも、おかげでMac上でもMiniMax-H3自身のAudio / Video能力を利用して、外部音声に合わせたLipSyncができるところまでは確認できた。
誰の役に立つのかは知らない。
少なくとも半年後の自分が、
「あれどうやってやったっけ?」
となったときには役に立つはず。
たぶん。
