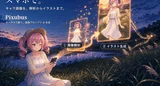
【Pixubus 3.9】グラビアCG集にキャプションを入れる機能を追加。絵はQwen-Image 2.1、ひと言はOllamaが考える。ご要望の改善も2つ

Pixubus 3.9をリリースしました。

今回のテーマは「できたCGに、文字を入れる」です。
ポーズ集(キャラ1枚からポーズ違いを何十枚も撮る画面)で撮った絵に、1行を重ねる。それだけで、ただ並んでいた絵が、グラビア集のページになります。
画面はこれです。左で絵を選んで1行を書き、右にできあがりが出ます。

目玉は、その1行をローカルLLMのOllamaが考えるところです。絵を読んで、表情と状況に合う言葉を返してきます。こちらは使ってみて、かなり面白いです。

Pixubusとは
キャラクターの絵を1枚入れると、ローカルのLLM(Ollama)が外見を読み取って、画像生成の指示文を作るソフトです。日本語で「海辺で水着、こちらに笑いかける」と書くだけで、英語のプロンプトになります。絵を出すのは、手元の画像生成ソフトComfyUIです。


動画で見るなら、こちらです。
はじめての方は、単品で買えるv3.0の記事と、公式サイトから。
3.1からは、画像生成モデルのQwen-Image 2.1で「絵を参照して描く」道が加わりました。キャラの絵をそのまま渡して、表情だけ、服だけ、ポーズだけを変える。
3.5の表情差分と衣装変更(1枚のキャラから表情違い、服違いを作る画面)、3.8のポーズ集(1枚のキャラからポーズ違いを何十枚も撮る画面)は、全部この上に乗っています。
詳しくはサイトヘルプの「3.xの歩み」に。
私の環境
・GPU: RTX 5070 Ti(VRAM 16GB)
・メモリ: 64GB
・OS: Windows 11
・画像生成: ComfyUI Desktop・Qwen-Image 2.1はint8版
・ローカルLLM: Gemma 4(Ollama)。
文字入れ
何のための機能か
先に図にします。

文字を重ねる部分だけなら、小さな機能です。すごいのは、あとに書く「1行はOllamaが考える」のほうです。ここでは、何のために足したかを書きます。
ポーズ集の続きです。3.8で、キャラ1枚からポーズ違いの絵を何十枚も撮れるようになりました。撮った絵を並べただけでは「集」になりません。1行入れると、なります。
使い道は3つ考えています。1つずつ、実物で。
グラビア集。水着にして、海辺やヴィラで撮って、ひと言。


実写でも、文字入れの手順は同じです。写実の子の作り方は、有料パートの「作例の設定」に書きました。
同人のCG集。白枠に書くと、写真集のページのようになります。この1行は、Ollamaの「余韻」の案をそのまま入れました。

ラノベのカラー口絵。白枠に縦書きで、セリフを1つ。

将来は、漫画のセリフやコマへの応用も考えています。まだ予定の段階です。
CG集にしていく流れ
3.9で一番やりたかったのは、この流れを1本につなげることでした。3つです。

1つ目、衣装を水着にする。衣装変更の画面で「Ollamaで作る」を押して、テーマに「グラビア水着」と入れます。Ollamaが8着を英文ごと考えてくれます。テーマは自分で足せます。

王道ビキニ、大人な黒水着、清楚な白ビキニ。こちらが思いつかないのも混ざります。
2つ目、気に入った水着でポーズ集。できた水着の絵をポーズ集の①に入れて、グラビアのタブからポーズを押していくだけです。

背景は、今回足したヴィラにしました。プールサイドのデッキです。

3つ目、文字を入れる。ポーズ集の結果から「文字入れへ送る」を押すと、そのまま文字入れの画面に来ます。画面は、絵を選ぶ①、1行を書く②、プレビュー③の3つの枠です。あとは絵ごとに1行書くだけ。
既定は絵の中に縦書き、右上。白い字に影をはっきり付けてあるので、空や障子のような明るい所に重なっても読めます。左上に寄せたり、横書きにしたりもできて、位置はドラッグで動かせます。

できた画像は自動で保存されます。保存ボタンはありません。作品パックに入れるところまでは、まだβなので、今回は触れません。
画面の説明は、使い方サイトにもあります。
商用で使いたいとき
ここまでの流れは、絵を参照して描くQwen-Image 2.1が前提です。このモデルは配布の条件が研究・評価向けの書き方になっていて、作った絵を売り物にするなら、提供元の条件を一度見ておいたほうがよいモデルです。公式はXで「生成物の権利は利用者に残る」とも答えていて、線がはっきりしていません。リンクと経緯は3.1の記事に書きました。
気になる方は、参照を使わないタグ型のモデル(Animaなど)だけで作る道があります。Pixubusで絵を参照せずに描く画面は3つ。生成画面(キャラの絵からタグを抽出して描く)、キャラクター生成(日本語の要望からキャラを作る)、イベントCG(2人を1枚に描く)。3.0からある画面で、Qwen-Image 2.1は使いません。作り方は2通りです。
1つ目は、生成画面で描いた絵を、そのまま文字入れへ。冒頭の川辺の子がこれです。立ち絵を1枚入れて抽出し、日本語で「夏、川の石段に体育座り」と頼んで、♥の1枚を文字入れで拾いました。

2つ目は、キャラクター生成でキャラを作って、2人以上をイベントCGで合成する。ラノベの口絵風なら、こちらが向いています。

キャプションはOllamaが考える
思いつかないときは、Ollamaに考えさせます。ここが3.9で一番見てほしいところです。Ollamaは絵を見ています。目を隠しているのか、こちらを見ているのか、1人なのか2人なのかを読んだうえで、1行を返してきます。渡すのは4つだけです。絵そのもの、文体、全部の絵に共通の前提メモ、ポーズ集から送ったときのポーズ名や背景。

冒頭に貼った画面がそれです。渡したのは絵と文体「心の声」、ポーズ集から付いてきた記録(膝を立てて座る・ヴィラ)だけ。前提メモは空です。それで5つ返ってきました。
文体は7つ。余韻、ふたりの距離、心の声、ひとりごと、そのまま説明、キャラのセリフ、相手のセリフ。選んで押すと5つ出てきます。選ぶのは自分です。

速さは、Gemma 4の12bでthinkを切って、1枚あたり4秒ほどでした。26b-a4bで9秒。モデルと文体で案がどう変わるかは、有料パートに置きます。
背景を14足しました
グラビア誌の撮影場所を意識して、ポーズ集の背景を26から40に増やしました。グラビア誌は、海辺や水着だけではありません。ホテルの部屋、ヴィラ、自宅のリビングや寝室、旅先の船のデッキ、ときどき廃墟やトンネルのようなロケ。1冊の中で場所が変わるから、めくる手が止まりません。
足したのは、リビング、寝室、書斎、シャワールーム、田舎の家の中、畳の和室、ビルの屋上、道路のトンネル、夏の川、クルーズの船のデッキ、ホテルルーム、ヴィラ、廃墟、洞窟の14です。
増えたぶん、選ぶところも変えました。場所がタブになって、学校、家、和、街、水辺、宿・リゾート、非日常を押すと、その場所の背景だけが並びます。

14の背景を1回ずつ回したのがこれです。キャラは何人か混ざっていて、ポーズはグラビアから選んでいます。絵の形ごとにまとめました。


廃工場のような背景だと、人物はアニメなのに背景だけ写真のようになることがありました。背景の書き方を変えて、タッチがそろうようにしています。
いただいた要望に応えたもの

メンバーシップの方からの要望で、2つ入れました。どちらも「あったほうがいいですよね」と言われて、確かに、と思ったものです。
think(考える)の切り替えが、どの画面にもつきました
3.1でリファレンス生成だけに付けたthinkの既定/ON/OFFを、Ollamaを使う全部の画面に広げました。生成画面は①の抽出と②の生成で別々に選べます。
OFFにすると速くなります。どのくらい速くなるかは、アプリのベンチマークで取れます。Ollamaジョブの画面に、thinkで行が分かれて出ます。

Ollamaで使っているモデルはGemma 4です。12b、26b-a4b、31bの数字は大きさで、大きいほど賢く、遅くなります。同じ画像、同じ要望で、この3つを既定とOFFで1回ずつ回しました。思考の分がまるごと消えるので、3倍から30倍くらい速くなります。モデルごとの秒数は、有料パートの表にまとめました。
私は、文字入れの案は31bのthink OFF、抽出は既定にしています。案の質は、相手のセリフのように立場が分かれる絵だと、OFFで話し手を取り違えることがありました。
生成画像を1枚ずつ消せるようになりました
生成画面で作った画像は、消す手段が「設定→データ管理→掃除」しかありませんでした。要らない1枚を消したいだけなのに、大がかりでした。

一覧で絵にマウスを乗せると🗑が出ます。消えるのはファイルだけで、プロンプト履歴や速度の記録はそのままです。♥を付けた絵、参照に使った絵は消す前に知らせます。作品パックに入れた絵は消せません。
今回は生成画面だけです。ほかの画面の画像は、次の版から順に入れていきます。
そのほかの改善
メモリの譲り合い。OllamaとComfyUIを同じグラフィックボードで使うと、両方のモデルが載り切らないことがあります。3.9からは、Ollamaを使う前にComfyUIのモデルを自動で降ろします。
ベンチマークの表示。tok/s(1秒あたりに出る文字数の目安)と平均処理時間を切り替えられます。
ComfyUI側の画像の片付け。Pixubusから生成した画像は、ComfyUIのoutputフォルダにも残っていました。3.9からは、Pixubus側にコピーしたあとで自動で消します。過去の分は消しません。設定で切れます。
サイドメニューのグループを畳めるようにしました。閉じたものだけ覚えます。
Pixubus 動かすのに必要なもの
買う前に、ここだけ見ておいてください。要るのは3つです。

Node.jsとOllamaは必須です。どちらも公式サイトのインストーラーで入り、無料です。
ComfyUIは、絵まで出したいときに要ります。ComfyUIのアプリ側でプロンプトを自分で貼って生成するなら、つないでいなくてもかまいません。Pixubusの画面から生成ボタンで出したい場合に必須になります。
・Node.js(https://nodejs.org/ja )
・Ollama(https://ollama.com/download )
・ComfyUI(https://www.comfy.org/ )
Zimoto Creative Studioとメンバーシップ
v3.9は、メンバーシップ限定で配布しています。単品で買える最新版は、これまでどおりv3.0です。
v3.0を買ってくださった方へ。v3.0の記事でお伝えしたとおり、買い切りの記事はその版で止まります。3.1から先の続きは、メンバーシップから出しています。
Pixubusは、私が作っているローカルLLMのツール群の絵の担当です。ネタを広げるMycelink、小説を書くInkubus、絵を描くPixubus、そして動画のVidubus。この4つをまとめてZimoto Creative Studioと呼んでいます。どれも手元のPCだけで動きます。

それぞれの紹介と販売はこちらです。
全部つなげると、アイデアから本や動画まで、あなたのパソコンの中だけで作品になります。今回の文字入れで、Pixubusは描いたキャラの絵を口絵やCG集の形にするところまで手元でできるようになりました。

4つとも、メンバーシップに入っていれば手に入ります。続きの改善も、メンバーシップから出していきます。ツールを2つ以上使うなら、メンバーシップのほうが早いです。
この先の有料パートで手に入るもの
Pixubus v3.9のzip(有料パートの頭に添付しました)
アップデートの手順と、はじめての方向けの入れ方
文字入れの使い方(何を選んで、どう設定したか・赤枠つき)
Ollamaの案が、モデルと文体でどう変わるか(実物の案を並べます)
作例の設定(冒頭の子・実写の子・畳の和室)
使ってみて「この文体が欲しい」「ここで文字が読めない」があれば、掲示板やコメントで教えてもらえるとうれしいです。次の改善のネタにします。