STORMがもたらす調査革命!マルチAI連携で変わる未来

STORMとは
STORMは、スタンフォード大学が開発した、任意のトピックについてWikipediaスタイルの記事を自動生成する革新的なAIシステムです。
このシステムは、複数のAIエージェントが連携するマルチエージェントアーキテクチャを採用しており、研究エージェントによる情報収集、質問生成エージェントによる多角的な視点の洗い出し、専門家エージェントによる回答、そして統合エージェントによる記事構成というプロセスを経て、高品質なコンテンツを生み出します。事前調査段階と執筆段階の2段階プロセスで、インターネット上の数百のウェブサイトから信頼性の高い情報を収集し、整理します。
たとえば、「人工知能の倫理」というトピックを英語で入力すると(例:「Ethical Frameworks in AI」)、STORMは関連するウェブサイトを検索し、多面的な質問を生成、それらへの回答を基に、参考文献付きの包括的なレポートを自動生成します。
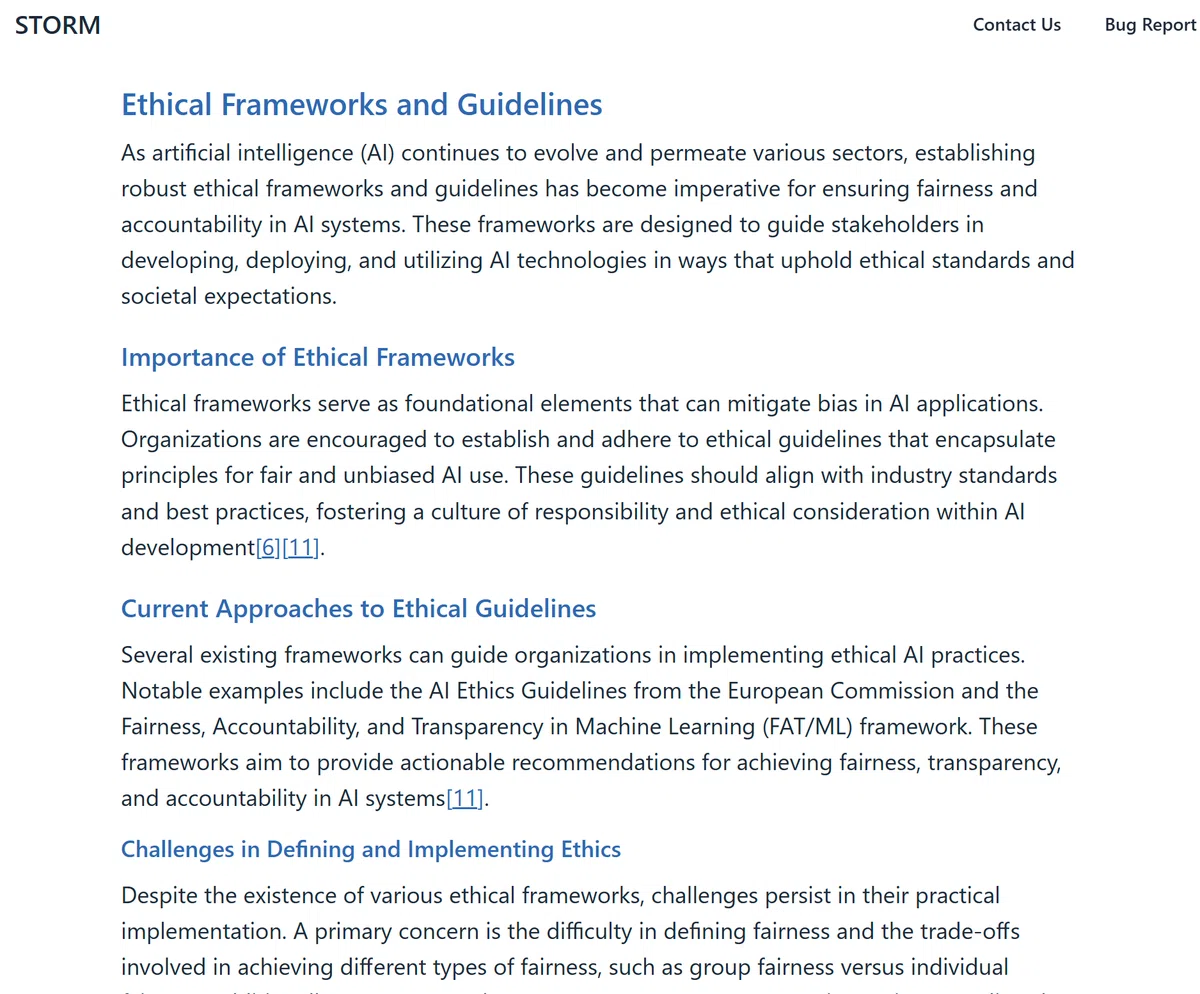
この技術により、研究者や学生は、従来多くの時間と労力を要していた情報収集や文章作成の負荷を大幅に軽減し、本来の研究活動に専念できる環境を手に入れられます。
マルチエージェントモデルが生む革新
STORMの「マルチエージェントモデル」は、複数のAIエージェントが協働することで、情報収集と文章生成の効率性と信頼性を飛躍的に向上させる仕組みです。
各エージェントは、情報収集、質問生成、回答、統合といった専門タスクに特化。この分業により、単一AIでは難しい多角的な視点の導入、情報の精密な検証、論理的で一貫性のある文章の自動生成を可能にします。
たとえば「2024年の生成AIの主要トレンドと社会への影響」というトピックで調査を依頼してみましょう。※検索キーワードは英語です。
すると、STORMは2023年以降の最新論文を複数引用し、具体的数値データに基づいた説得力の高いレポートを生成。多角的視点からの分析で、深い洞察を提供してくれます。
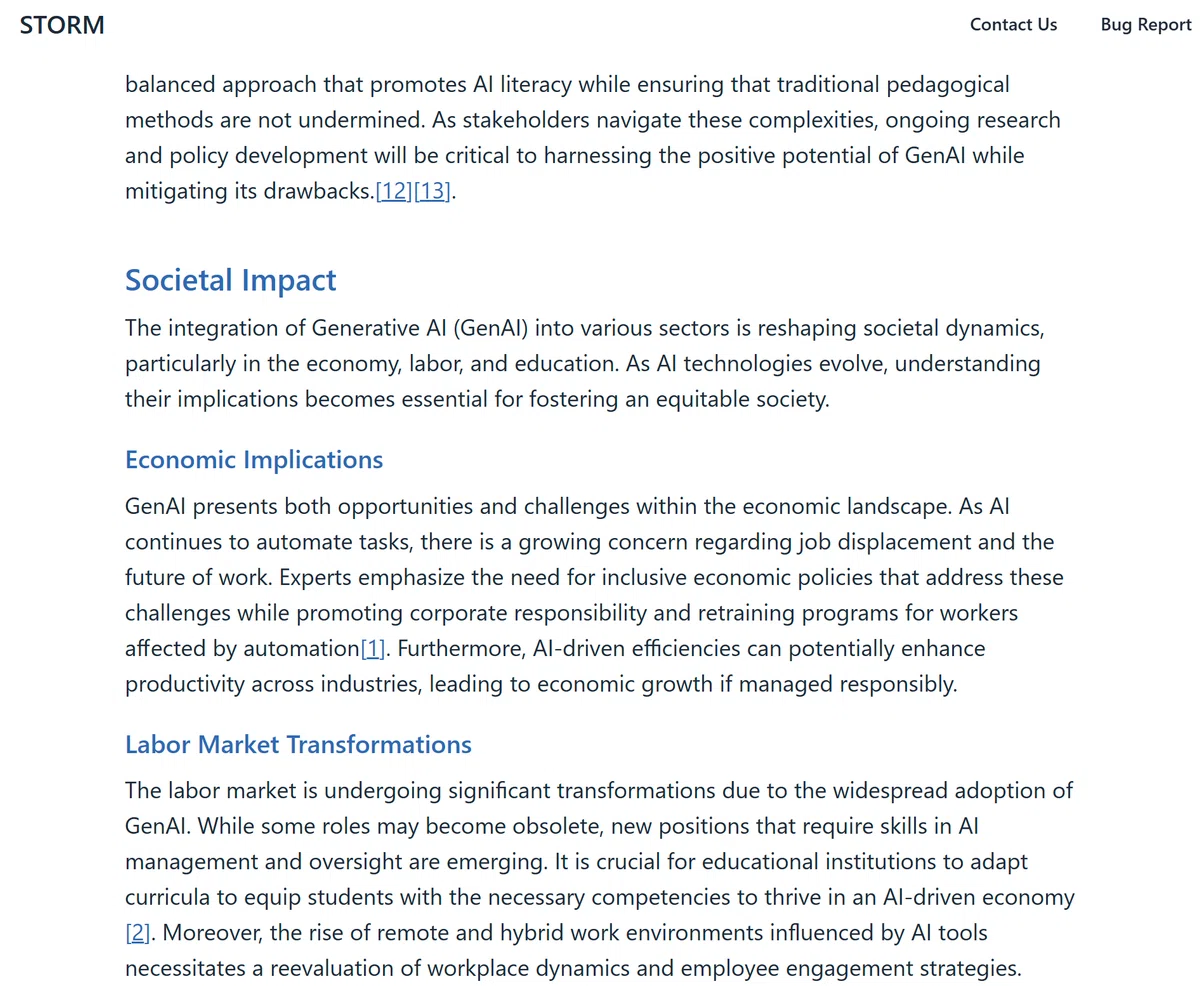
経済面では最大4.4兆ドルのGDP増加の可能性、労働市場では最大1,200万人の職業転換との予測、そして教育分野では個別化学習の可能性とAI利用による誠実性の懸念が提起されています。
これらの課題に対処するには、労働者への再教育やAIリテラシー教育が急務とのこと。
このように、専門性が必要な調査・執筆のタスクが効率化され、人間はより創造的な業務に注力できるようになります。この革新性は、STORMが従来のAIツールとは一線を画し、AI活用におけるブレークスルーと言える点です。
※実際のUIとは異なります
どんな場面で使えるのか?
STORMは、学術研究、ビジネス、コンテンツ制作、教育など、幅広い分野で活用できる汎用性の高いAIツールです。
情報収集から記事生成までを自動化することで、時間と労力を大幅に削減。特に、文献レビューや市場調査、教材作成など、情報の正確性と包括性が求められるタスクで効果を発揮します。
たとえば、研究者はSTORMを使うことで、関連論文を網羅した文献レビューを迅速に作成できます。膨大なデータ収集作業を自動化することで、分析や考察により多くの時間を割けるようになります。
このように、STORMの活用は、業務の効率化だけでなく、コンテンツの質向上にもつながります。
STORMの仕組みを支えるキーテクノロジー
STORMは、大規模言語モデル、検索エンジン連携、マルチエージェントシステム、オープンソースという4つのキーテクノロジーに支えられた、革新的なAIライティングツールです。
GPT-4oなどの高性能な言語モデルが自然な文章を生成し、検索エンジン連携で最新情報を取得。複数のエージェントが協働し、情報収集、質問生成、回答、統合を分担することで、高品質なコンテンツ作成を実現します。オープンソースだからこそ、自由にカスタマイズできます。
たとえば、市場調査レポート作成時、複数のエージェントが、最新の市場動向、競合情報などを、同時並行で調査・分析。それらの情報を統合し、自動でレポートを生成します。
こうして、専門知識を要するリサーチや、文書作成の業務を大幅に効率化できます。自由度の高いカスタマイズ性も備えているため、多様なニーズに対応可能なAIツールです。
実際に試す方法と導入ステップ
STORMの導入は、環境設定、APIキー取得、実行の3ステップで、簡単に試せます。
公式GitHubリポジトリから必要なファイルをダウンロードし、指示に従いPython環境をセットアップ。その後、利用するウェブ検索や言語モデルのAPIキーを設定すれば準備完了。提供されているサンプルコードを実行するだけで、STORMの強力な機能を体験できます。
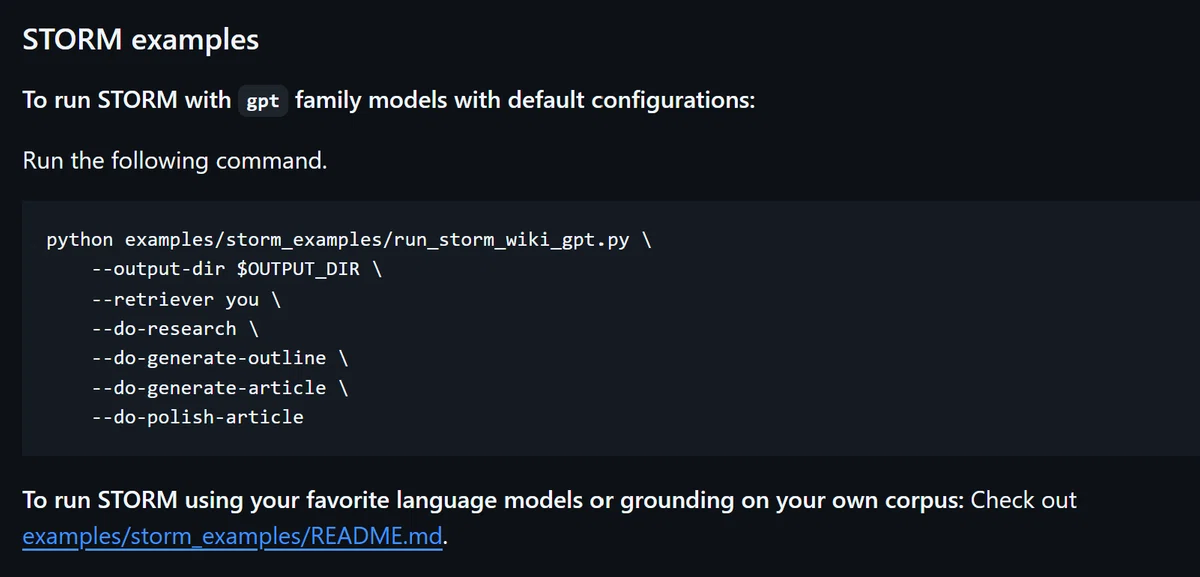
たとえば、python examples/storm_examples/run_storm_wiki_gpt.py を実行することで、OpenAIのGPTモデルを用いて、選択したトピックに関する情報収集、アウトライン生成、記事執筆を自動で実行し、結果を保存してくれます。
こうして、専門知識や複雑な手順なしに、誰でも手軽にAIによる記事生成を試すことが可能です。自身の環境で動作を確認できるので、本格導入前の評価や研究開発に、大いに役立つことでしょう。
注釈
requirements.txt : 必要なライブラリの一覧が記述されているファイル
secrets.toml : 各種APIキーを記述する設定ファイル
知っておきたい課題と注意点
STORMは強力なAIツールですが、ハルシネーション、バイアス、著作権の問題には注意が必要です。
大規模言語モデル特有の「幻覚」により、事実と異なる情報を生成するリスクがあります。また、学習データの偏りが反映され、偏った情報を提供する可能性があります。さらに、自動生成された引用が不正確な場合、著作権侵害に繋がる恐れもあります。
STORMを用いて生成された記事の精度はどの程度なのでしょうか。 ある調査結果によると、Mistral 7B-InstructというAIモデルを用いた検証では、引用された情報の再現率が84.83%、精度が85.18%という結果が得られています。つまり、8割以上の情報はおおむね信頼できると言えるでしょう。
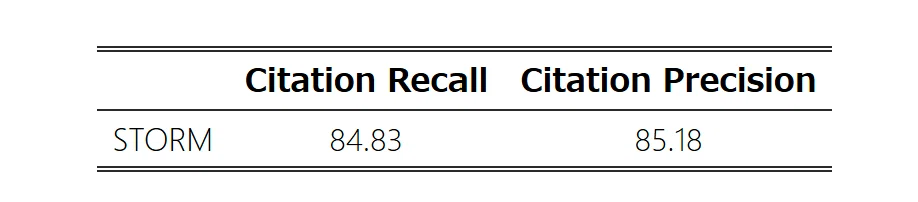
しかしながら、完璧とは言えません。引用元の情報を異なるニュアンスで言い換えたり、不適切な推論に基づいて引用したりするケースもあるようです。「ハルシネーション」と呼ばれるような、全く根拠のない情報をでっち上げる現象とは異なりますが、100%鵜呑みにせず、人間が最終確認を行うことが重要です。
これらの課題を理解し、人間による最終確認を徹底することで、リスクを回避し、安全に活用できます。結果、STORMの利便性を最大限に享受し、研究やビジネスの効率化、質の高いコンテンツ生成に繋げられるのです。
参考:Assisting in Writing Wikipedia-like Articles From Scratch with Large Language Models
Co-STORMへ拡張する未来
Co-STORMは、対話を通じて知識の発見を支援する、STORMの進化形です。人間とAIの協働を促進する、新しいタイプの情報探索ツールと言えます。
複数のAIエージェントが、情報収集、質問生成、議論を役割分担。人間も議論に参加し、情報の深掘りや、方向修正ができます。収集した情報はマインドマップで整理され、思考の見える化を実現しています。
たとえば、新規事業のアイデア出し会議で使うと、多角的な情報や、人間だけでは思いつかない視点を得られ、より革新的な企画立案に繋がるでしょう。
このように、人間とAIが相互補完し、個人では到達できない「深い知識」を獲得できます。これは、従来の検索エンジンやAIツールを大きく超える、Co-STORMの革新的で、大きな利点です。
人間とAIで実現する新たな知の地平:STORMが拓く未来
STORMは、情報検索や文章生成を効率化するだけでなく、マルチエージェントの協働によって多角的な視点を実現します。対話型に拡張されたCo-STORMでは、人間の直感や洞察とAIの論理的推論が融合。これまでにない知識創造への期待が高まっています。
しかし、ハルシネーションや著作権などの課題には注意が必要です。最終的な確認や方向性の決定には、人間の判断力が不可欠です。STORMを効果的に活用することで、研究、ビジネス、教育など、幅広い分野で質の高いアウトプットを短期間で得られるでしょう。
今後は、ユーザーコミュニティや研究機関との連携を深め、さらに高度なカスタマイズや多言語対応が進むかもしれません。人間とAIが互いの強みを活かし、新たな知の地平を切り拓く。STORMのさらなる発展から目が離せません。
