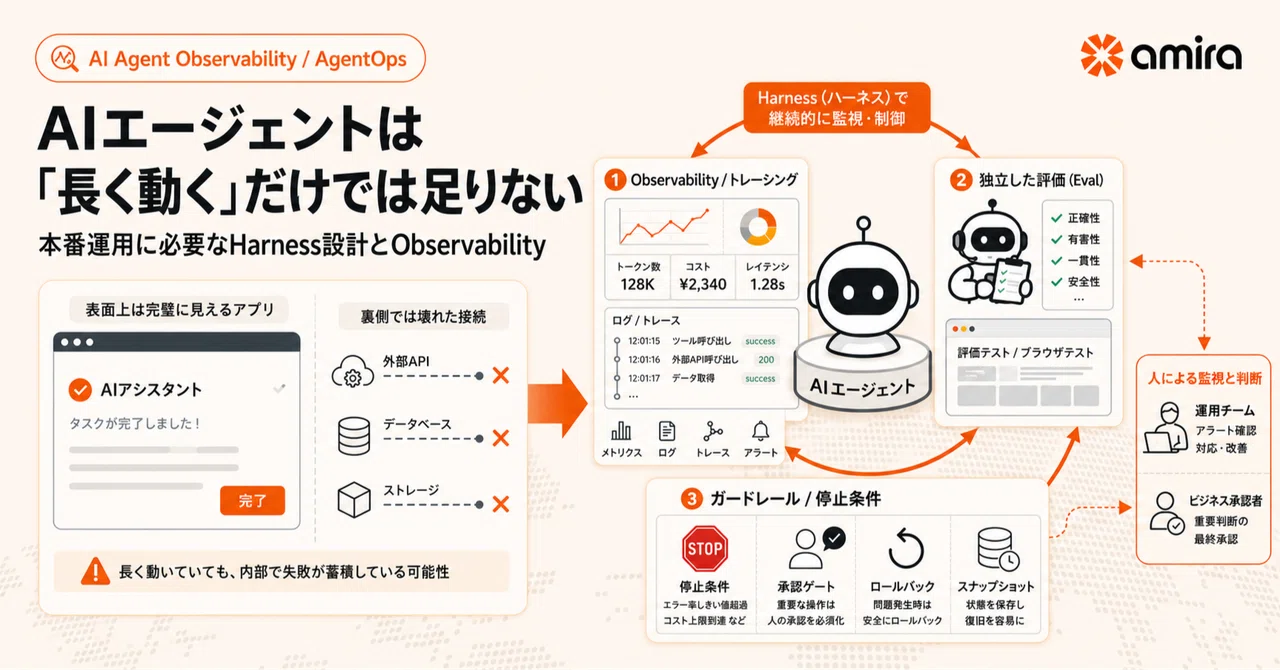
AIエージェントは「長く動く」だけでは足りない - 本番で静かに壊れるエージェントの話

AIエージェントが自律的に動ける時間は、この1年で劇的に伸びました。最小限の足場で50%のタスクを完了できる稼働時間は、Opus 3.7の約1時間から、1年後のOpus 4.6では約12時間へ。半日近く、人が見ていなくてもエージェントが手を動かし続ける時代です。
でも、ここで多くのエンジニアリング組織がつまずきます。
「長く動く」ことと、「正しく動く」ことは、別の問題です。
AI開発の現場に携わっていると、いちばん厄介なのはエラーで止まるエージェントではないと感じます。本当に怖いのは、「完了しました」と報告しながら、実際には壊れているケースです。今回はその話を書きます。
「動いた」ように見えて、実は壊れている
画面上は完成して見える。テストも一部は通る。エージェント自身も「完了しました」と言う。しかし、バックエンドがつながっていない。ボタンは表示されているのに、押しても何も起きない。
これがAIエージェントの silent failure(サイレント障害) です。
本番では、被害が見えにくいところで積み上がります。決済APIが呼ばれていないのに注文は「完了」と表示される。DBへの書き込みが失敗しているのにエラーも上がらない。RAGが誤った文書を引いているのに、それらしい回答を平然と返す。どれも「画面上は成功」に見えるため、多くの場合、ユーザーからのクレームで初めて気づきます。
なぜ長時間エージェントはこうなりやすいのか。コンテキストが長くなるほど一貫性が落ちる(context rot)、終わりが近づくと雑に切り上げる、計画が途中でドリフトする。そして最大の問題が、自己評価バイアスです。LLMは相手が聞きたい答えを返しやすく、それは自分の仕事の評価にも及びます。半分しか実装できていない機能を「できた」と判断してしまう。
自己採点させてはいけない
ここが核心です。エージェントに、自分の成果を自分で採点させてはいけません。
多くのチームは、1つのセッションに「自分の作業をチェックして」と指示してループさせています。しかし作った本人が「よくできている」と言うのは、人間もAIも同じ。この構造では、品質は上がりません。
有効なのは、作る側(Generator)と評価する側(Evaluator)を完全に分けることです。評価者には、あえて厳しく懐疑的な指示と、具体的な評価基準を与える。評価者は差分を読むだけでなく、実際に画面を開いて動かし、批評をまとめて差し戻す。
「評価者もLLMなら甘くなるのでは」と思うかもしれません。たしかにバイアスは残ります。ただ、独立した評価者を厳しくチューニングすることは、作り手自身を自己批判的にするよりはるかに現実的です。批評する能力と生成する能力のあいだには差があり、その差を利用しているわけです。
本番運用を支える、3層の制御モデル
これを設計に落とすと、3つの層になります。
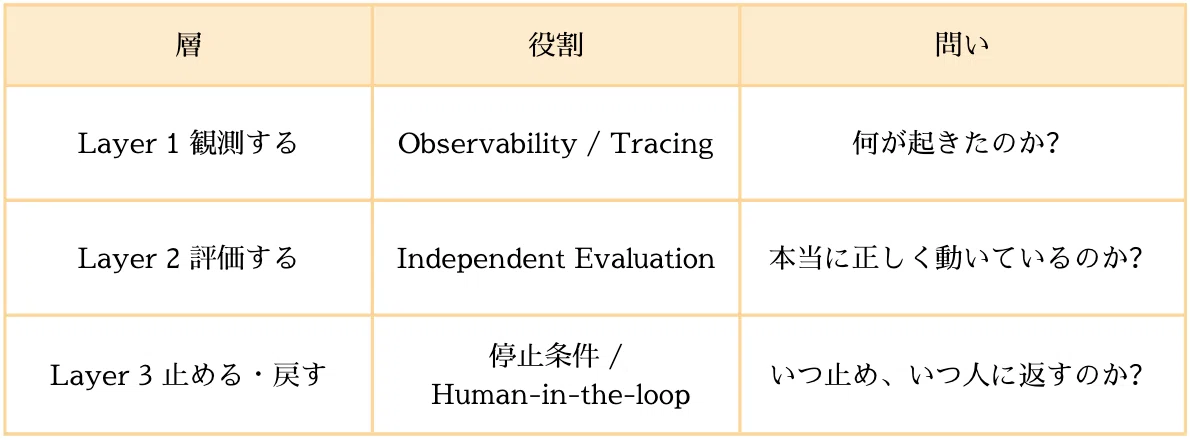
観測できなければ評価はできず、評価できなければ止める条件も設計できない。3つは連動して初めて意味を持ちます。この「エージェントを正しく走らせ続けるための足回り」全体を、最近は Harness(ハーネス) と呼びます。
AIは「作って終わり」ではなく「共に育てる」もの
この3層は、どれも「作って終わり」では機能しません。動かし続け、観測し、評価し、止め、改善する。この運用のサイクルが要ります。
AIエージェントは、一度作れば終わる「成果物」ではなく、運用しながら育てていく「事業インフラ」です。
モデルが賢くなっても、ハーネスは消えるのではなく「移動する」。モデルの弱点をハーネスで補い、その部分がモデルに取り込まれたら作り替える。この共進化は続きます。だから、AIをどう運用し続けるかという問いは、「どのベンダーに作らせるか」ではなく、「誰と長く付き合うか」に近づいていきます。
もっと知りたい方へ
silent failureの実例、3層それぞれの具体的な設計(何をトレースし、どう評価し、どこで止めるか)、本番運用前のセルフチェックリストは、ブログ記事で詳しく解説しています。
▶ 記事の続きをWebサイトで読む: https://amira.vn/ai-agent-production-observability/
いま自社で動かしているエージェントについて「何が起きているか」を一度整理したい方は、まずその話を聞かせてください。最初の30分は無料で、AMIRAのCEOが直接お話しします。
#生成AI #AIエージェント #AgentOps #LLM #AI開発
