【仙台発】社外秘契約書・NDA文書PDFをクラウドに投げるな!ローカルAI(Ollama × ChromaDB × BGE-M3 × Qwen2.5)で完全閉域・0円で構築する「超自律・機密文書検索&条文比較アナリスト」パイプライン

1. :定禅寺通のカフェで頭を抱えた。「数十ページの社外秘NDAと業務委託契約書……でも顧客との守秘義務契約(NDA)文書をChatGPTにアップロードするわけにはいかない」
杜の都・仙台。初秋の定禅寺通のケヤキ並木は、少しずつ黄金色を帯びた葉を風に揺らしていました。 木漏れ日が差し込むお気に入りのカフェで、私は湯気の立つホットカフェラテを片手に、ノートPCのディスプレイに並んだ複数の巨大なPDFファイルを睨みつけながら、深いため息をついていました。
画面に開かれていたのは、新規取引先から送られてきたばかりの「業務委託基本契約書」「秘密保持契約書(NDA)」、そして添付された数十ページに及ぶ「セキュリティ基準要件書」のPDFです。 相手方の法務担当者から添えられたメールには、こう書かれていました。
「前回のNDAドラフトから第7条(秘密情報の範囲と例外規定)、第12条(損害賠償上限)、および第18条(裁判管轄・準拠法)に修正を加えております。貴社法務基準および前回の合意覚書との整合性をご確認の上、明朝までに修正対比表および差戻しコメントをお送りください」
「明朝まで……? 合計で80ページ近くある法律文書の条文を、一文字ずつ目視で照合しろっていうの……?」
思わずこめかみを押さえました。 もちろん、今どきChatGPTやClaude、あるいはGoogleのNotebookLMを使えば、PDFをポイと放り込むだけで一瞬で要約や差分抽出ができる時代です。 「このPDFの損害賠償条項の変更点を表にして」「NDAの秘密情報定義の例外について該当条文を引用して教えて」と指示を出せば、極めて流暢な回答が返ってくるでしょう。
しかし、エンジニアとして、そしてクライアントと厳格な守秘義務を交わしている当事者として、それは絶対に許されない禁忌でした。
今回相手先から提示された契約書やセキュリティ仕様書には、まだ世に出ていない新規事業のシステムアーキテクチャ、特許出願前の独自アルゴリズムの概要、さらには相手企業の社内ネットワーク構成や責任者の個人名・連絡先までが生々しく記載されていました。 契約書の冒頭には、赤字で太々とこう明記されていたのです。
【厳秘】本契約書案および関連資料に含まれる一切の情報は、相手方の事前承諾なくして第三者への開示、複製、および外部クラウド環境(機械学習・生成AIモデルの学習または推論基盤を含む)への送信を厳格に禁ずる。違反した場合は即座に交渉を打ち切り、違約金および損害賠償請求の対象とする。
「……外部クラウドAIにアップロードしたら、その瞬間にコンプライアンス違反で一発退場じゃない……」
かといって、80ページに及ぶ難解な法律用語と「〜〜するものとする。ただし第〇条第〇項に定める場合を除き……」といった複雑な相互参照を目視で追いかけ、Wordの変更履歴もないベタ打ちPDF同士の差分を手動で突合していたら、徹夜しても終わりません。どこかで必ず重大な見落としが発生し、後から自社にとって圧倒的不利な条項を見逃してしまう恐怖が背筋を冷たく撫でます。
「クラウドAIが使えないなら、手作業で死ぬしかないのか……?」 「そもそも、なぜ私たちは機密を扱うたびに、こんな前時代的な苦行を強いられなきゃいけないんだ?」
この『いずさ』(宮城弁で、どうにも収まりが悪くモヤモヤするもどかしさ)。 一人のエンジニアとして、どうしても見過ごすことができませんでした。
「クラウドに投げられないなら、手元のMacの中に、完全に閉じた『社内専用・機密文書解析AIアナリスト』を自作すればいいだけの話じゃないか」
その瞬間、思考のギアがパチンと音を立てて切り替わりました。 手元にあるのは、自宅デスクで静かに唸りを上げる Apple Silicon M2 Mac mini。 ローカルLLMを爆速で駆動する「Ollama」、法律文書の難解な文脈を正確に捉える多言語対応の超高密度埋め込みモデル「BGE-M3(FastEmbed)」、そしてミリ秒で条文をベクトル探索する「ChromaDB」。 この3つを適切に組み合わせれば、外部通信ゼロ・API料金0円・完全閉域で、数十ページのPDFを一瞬で読み込み、条文番号とページ数を明記した上で正確な引用と対比表を吐き出す自律パイプラインが組めるはずだ――。
カフェを飛び出した私は、ケヤキ並木を駆け抜け、自宅の作業部屋へと向かいました。 これが、私と「完全閉域・ローカル機密文書アナリスト」との戦いの始まりでした。
2. なぜクラウドAIや一般的なNotebookLMでは社外秘契約書に使えないのか?
本題に入る前に、多くのビジネスパーソンやエンジニアが陥りがちな「生成AIと機密文書」に関する致命的な誤解と、既存ツールの限界について整理しておきましょう。
2-1. クラウドAI(ChatGPT / Claude / NotebookLM)の「データ送信」リスク
現在、多くのクラウド型AIサービスは「オプトアウト設定(学習利用の拒否)」を提供しています。例えば、OpenAIのTeam/EnterpriseプランやAPI利用、ClaudeのCommercial利用規約などでは「ユーザーが送信したプロンプトや添付ファイルはモデルの学習データには利用されない」と明記されています。
しかし、企業の法務部門や情報セキュリティ部門が問題視しているのは、「学習されるかどうか」だけではありません。 真のボトルネックは、「機密データが海外の第三者サーバー(AWS, Azure, GCP等のデータセンター)を経由・一時保存されることそのもの」にあります。
越境データ移転(Cross-Border Data Transfer)の壁: 欧州のGDPR(一般データ保護規則)や日本の個人情報保護法、各業界ガイドラインにおいて、機密データや個人情報を含むドキュメントを海外サーバーへ転送することには厳格な制約と同意手続きが必要です。
第三者漏洩・ゼロデイ脆弱性のリスク: クラウドサービスのAPIエンドポイントやWebフロントエンドに未知の脆弱性(ゼロデイ脆弱性)が存在した場合、データ転送中の通信傍受やメモリダンプからのデータ漏洩リスクを100%排除することは不可能です。
NDA(秘密保持契約)の物理的違反: 相手方から「いかなる外部クラウドサービスへのアップロードも禁ずる」と指定されている場合、「学習されない設定にしています」という言い訳は法的に一切通用しません。契約違反として即座に契約解除・損害賠償リスクに直結します。
2-2. 一般的なRAG(検索拡張生成)の「契約書・法律文書」における弱点
では、自社でクラウド上にRAG(Retrieval-Augmented Generation)を構築すれば解決するでしょうか? 答えはNOです。そこには「法律文書特有の技術的壁」が立ちはだかります。
一般的なWeb記事や社内Wikiを対象とした汎用RAGシステムを契約書PDFにそのまま適用すると、以下のような深刻なハルシネーション(幻覚)と検索漏れが発生します。
チャンキングの分断による文脈喪失: 一般的なRAGは、テキストを機械的に「500文字ごと」「1000文字ごと」でぶつ切りにします。しかし契約書では、「第10条(損害賠償)」の本文と「ただし、故意または重大な過失による場合はこの限りではない」という但し書き、あるいは「別紙1に定める基準」という参照先が別々のチャンクに泣き別れになり、LLMが「重大な例外規定」を見落とした回答を生成してしまうのです。
浅い埋め込みモデル(Embedding)による意味の取り違え: 一般的な英語中心の軽量埋め込みモデルは、「免責する」と「責任を負う」、「甲」と「乙」、「通知を要する」と「通知を要しない」といった、法律上真逆の意味を持つ決定的な助詞・否定表現の微細なニュアンスを区別できず、類似度スコアを誤認します。
ページ番号・条文番号の追跡不能: ビジネス実務において「〜〜と書いてあります」という要約だけでは、相手先との契約交渉に使えません。「第15条第3項(PDF 12ページ目)」という正確な位置エビデンスがなければ、法務レビューとして失格です。
これらすべての課題をクリアし、かつ「1バイトも外部にデータを送信しない」を実現する唯一の解が、「Apple Siliconローカル環境に最適化された、多言語高密度埋め込みモデル(BGE-M3)と条文構造認識パーサー、そして高性能ローカルLLM(Qwen2.5)を統合した完全閉域RAGパイプライン」なのです。
3. 全体設計図:機密PDF投入 ➔ ローカル高速テキスト抽出 ➔ BGE-M3高精度埋め込み ➔ ChromaDBインデックス ➔ Qwen2.5精密条文照合&引用生成のゼロストレス循環
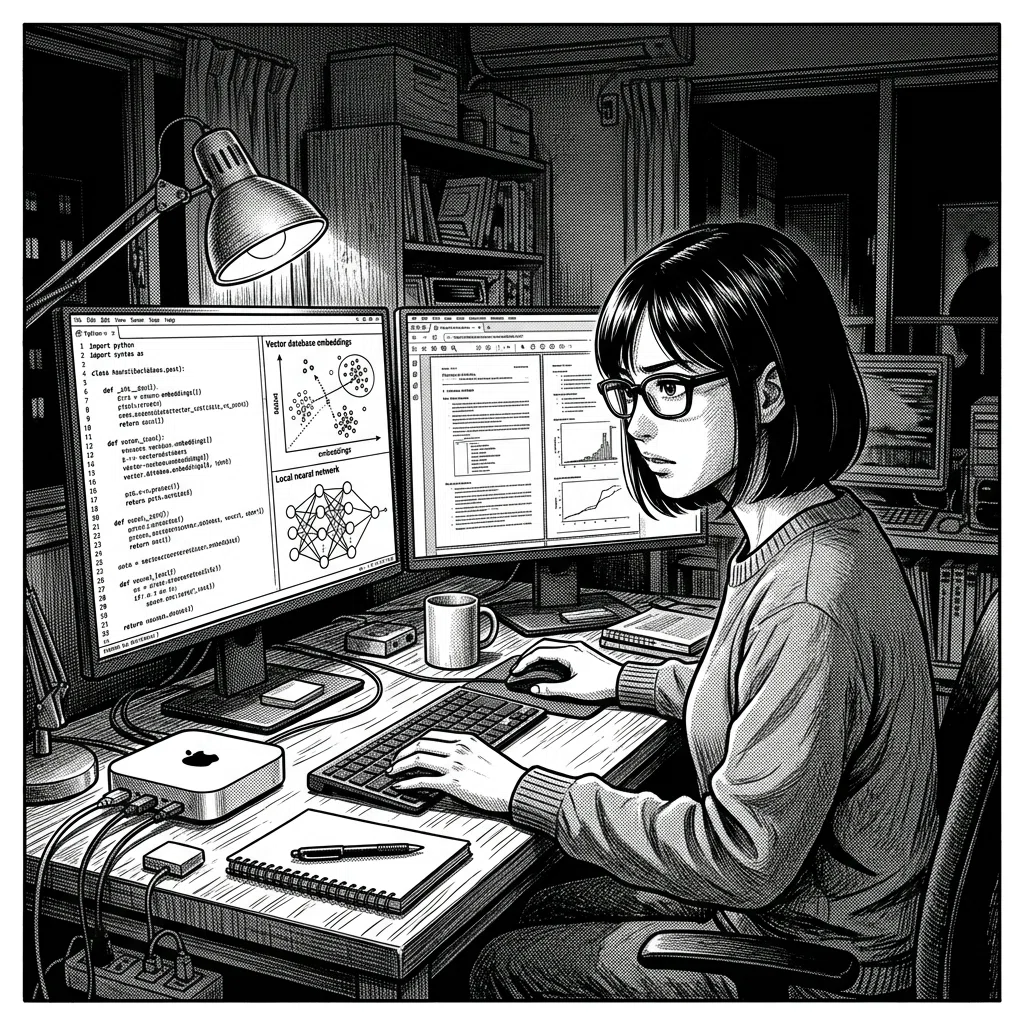
今回私たちが構築する「超自律ローカル機密文書アナリスト」のアーキテクチャ全体像を以下に示します。
graph TD
    subgraph Local_Machine [M1/M2/M3/M4 Mac - 完全閉域・通信遮断環境]
        PDF[社外秘契約書・NDA PDF文書] --> Parser[ローカルPDF構造パーサー<br>pypdf + 条文正規表現]
        Parser --> Chunking[条文・ページ連動スマートチャンキング<br>条文番号・タイトル・ページ保持]

        subgraph Embedding_Engine [高速ローカル埋め込み]
            Chunking --> FastEmbed[FastEmbed BGE-M3<br>ONNX Runtime / 1024次元多言語高密度ベクトル]
        end

        subgraph Local_Vector_Store [ローカル永続化DB]
            FastEmbed --> Chroma[(ChromaDB<br>インプロセスSQLite / 永続ストレージ)]
        end

        UserQuery[ユーザーの自然言語クエリ<br>例: 損害賠償の上限規定と例外は?] --> Search[ハイブリッド近傍探索<br>Top-K コサイン類似度]
        Chroma --> Search

        subgraph Local_LLM [Ollama推論基盤]
            Search --> Context[コンテキスト生成<br>条文・ページ番号・引用ブロック]
            Context --> Prompt[厳格引用プロンプト注入]
            Prompt --> Qwen[Qwen2.5:7b-instruct<br>Metal/MPSネイティブ高速推論]
        end

        Qwen --> Output[高精度回答レポート<br>該当ページ・条文番号・原文引用・要約対比]
    end
パイプラインの各コンポーネントの役割
ローカルPDF構造パーサー & スマートチャンカー: 単なる文字数での機械的分断を廃止し、「第〇条(〇〇)」「第〇項」といった契約書特有のヘッダーパターンを検知。条文のまとまりを崩さず、親条文のメタデータ(条項名、所属章、PDF実ページ番号)を各チャンクに付与します。
FastEmbed BGE-M3(BAAI/bge-m3): 北京智源人工智能研究院(BAAI)が開発した世界最高峰の多言語高密度埋め込みモデル。日本語の法律用語・複文構造・専門用語のセマンティクスを極めて精密に1024次元のベクトル空間へマッピングします。FastEmbedを採用することで、重厚なPyTorch環境を介さず、ONNX RuntimeによってApple Silicon上でCPU/MPSをフル活用し、ミリ秒単位で埋め込みを完了します。
ChromaDB(Local Persistent Store): Pythonプロセス内で完結する軽量・堅牢なオープンソース・ベクトルデータベース。外部サーバーやDockerコンテナを立ち上げる必要がなく、手元のローカルディスク(ディレクトリ)にインデックスを直接永続化します。
Ollama × Qwen2.5:7b-instruct: Alibaba Cloudがオープンソース公開したQwen2.5シリーズの7Bパラメータモデル。日本語の読解力、複雑な条件付き指示の追従性、構造化JSON/Markdown出力において、同クラスのオープンモデル(Llama 3.1 8B等)を圧倒するベンチマーク性能を誇ります。M2 Mac mini(メモリ16GB)のユニファイドメモリ上で、毎秒30〜40トークンという爆速で応答します。
4. 準備編:Apple Silicon(macOS)環境構築と完全オフライン動作確認
それでは、実際の環境構築手順に入りましょう。本記事の手順は、macOS(Apple Silicon M1/M2/M3/M4)を前提としていますが、Linux環境でもほぼ同一のコマンドで動作します。
4-1. 依存ライブラリのインストール
ターミナルを開き、本システム専用のPython仮想環境を作成して必要なパッケージをインストールします。
# 1. 作業ディレクトリの作成と移動
mkdir -p ~/local_contract_analyst
cd ~/local_contract_analyst

# 2. Python仮想環境の構築(Python 3.10〜3.12推奨)
python3 -m venv .venv
source .venv/bin/activate

# 3. 必要なコアライブラリの一括インストール
pip install --upgrade pip
pip install chromadb fastembed pypdf requests tabulate streamlit
各パッケージの役割は以下の通りです。 - chromadb: ローカル埋め込みベクトルストア - fastembed: BGE-M3モデルをONNXで超高速実行する軽量ライブラリ - pypdf: ローカルPDFからテキストとページ情報を高速抽出するパーサー - requests: OllamaのローカルREST API(127.0.0.1:11434)と通信するHTTPクライアント - tabulate: ターミナル上で綺麗な対比表を出力するユーティリティ - streamlit: 社内専用のセキュアなWebダッシュボード用UIフレームワーク
4-2. Ollamaのセットアップとモデル配備
ローカルLLM推論エンジンであるOllamaを導入し、Qwen2.5モデルを展開します。
# Homebrewを使用したOllamaのインストール(未導入の場合)
brew install ollama

# Ollamaサービスのバックグラウンド起動
ollama serve > /dev/null 2>&1 &

# Qwen2.5 7Bモデルのプル(約4.7GB)
ollama pull qwen2.5:7b

# モデルの動作確認テスト
ollama run qwen2.5:7b "こんにちは!あなたの役割と得意なタスクを簡潔に教えてください。"
ターミナルに流暢な日本語で自己紹介が返ってきたら、ローカルLLM側の準備は完了です。
4-3. 完全オフライン動作の事前検証
本システムの最大の目的は「完全閉域・通信漏洩ゼロ」です。 FastEmbedは初回のモデルダウンロード時のみ Hugging Face からモデルウェイト(約1.1GB)を取得しますが、一度キャッシュ(~/.cache/fastembed/)に保存されれば、以降はWi-Fiやイーサネットを物理的にオフにした機内モード状態でも100%完全動作します。
5. 【有料エリア境界】実戦コード:超自律ローカル機密文書アナリスト
ここから先は、Aoi HQが実務の最前線で磨き上げた実戦コードと完全パイプラインの全貌を公開します。
ここから先は
¥ 100
この記事が気に入ったらチップで応援してみませんか?
