Amazon SageMaker HyperPod

以下、AWS公式ページ(日本語)を基に、SageMaker HyperPod(ハイパーポッド)の概要を 詳細に整理 します。
概要
SageMaker HyperPod は、生成系 AI モデルの構築・開発において、「数百〜数千の AI アクセラレーター(GPU/AWS Trainium 等)を用いたクラスター全体でのスケーラブルな処理」を可能にするサービスです。 Amazon Web Services, Inc.
目的として、「差別化につながらない手間のかかる作業」を削減し、モデル開発(トレーニング/ファインチューニング/推論)を迅速化・効率化することを掲げています。 Amazon Web Services, Inc.
また、複数のモデル開発タスクを一元管理し、優先度付け・リソース割り当て・可視化を通じて、クラスターの GPU/Trainium 利用率を最大化し、イノベーションを加速するための機能を備えています。 Amazon Web Services, Inc.
主な設計・機能
・大規模分散トレーニングへの特化
HyperPod は、全アクセラレーター(クラスター内)にわたってトレーニングワークロードを効率的に “分散・並列化” できるよう設計されています。 Amazon Web Services, Inc.
人気の公開モデル(プリトレーニング済み生成 AI モデル)に対して「最適なトレーニング設定」を自動適用する機能があります。 Amazon Web Services, Inc.
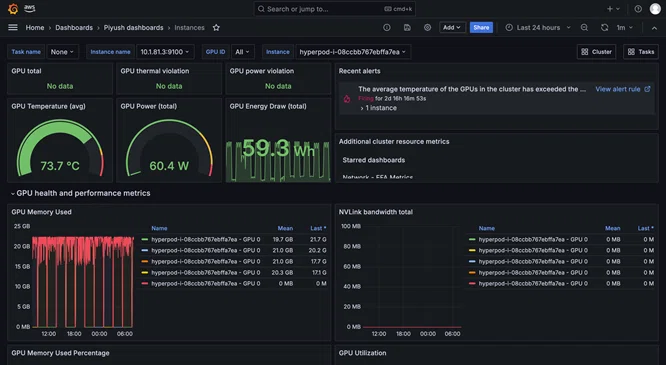
クラスターでインフラ障害が起きていないかを継続モニタリングし、障害発生時には “人間の介入なしに” 自動回復(修復)する仕組みを持ち、ワークロードの中断を抑えます。 Amazon Web Services, Inc.
結果として、トレーニング時間を最大で 40 % 短縮できる可能性が示唆されています。 Amazon Web Services, Inc.
・タスクガバナンスとリソース効率化
「すべてのモデル開発タスク(例:トレーニング、推論、ファインチューニング)」に対し、一元的なガバナンスを提供します。つまり、どのタスクにどれだけのリソースを割り当てるか/優先度をどうするか、が可視化され、制御可能です。 Amazon Web Services, Inc.
タスクキューが自動管理されるため、「重要なタスクを優先してスケジュールどおり/予算内で完了させる」ことが可能となり、コンピューティングリソースの利用効率が高まるとされています。 Amazon Web Services, Inc.
このようなリソース最適化により、「モデル開発コストを最大で約 40 % 削減できる」と明記されています。 Amazon Web Services, Inc.
・レシピ・ツールによるモデル開発支援
HyperPod は「レシピ(templates/プリセット)とツール」を通じて、データサイエンティストや開発者が、公開済み生成 AI モデルを 数分でトレーニング/ファインチューニング開始できる仕組みを提供しています。 Amazon Web Services, Inc.
例として、Amazon Nova 基盤モデル(Nova Micro、Nova Lite、Nova Pro)向けに、ビジネス固有ユースケースに合わせてカスタマイズするためのレシピも用意されています。これにより、低レイテンシーかつコスト効率の高い形で生成 AI アプリケーションの精度を上げられるとされています。 Amazon Web Services, Inc.
また、モデルのパフォーマンス改善に寄与する「実験およびオブザーバビリティ(観測可能性)ツール」も組み込まれています。 Amazon Web Services, Inc.
・オープンウェイトモデルのデプロイ支援
HyperPod により、SageMaker JumpStart からのオープンウェイトモデル(公開済みモデル)のデプロイや、Amazon S3/Amazon FSx に保存されたファインチューニング済みモデルのデプロイを 加速できます。 Amazon Web Services, Inc.
このために、自動プロビジョニング/タスクガバナンスによるコンピューティングリソース管理/リアルタイムのパフォーマンスモニタリング/強化されたオブザーバビリティが提供されています。これによりモデルデプロイタスクの合理化が可能です。 Amazon Web Services, Inc.
利用メリット(整理)
スケーラビリティ:数百〜数千アクセラレーターを用いた大規模分散が可能。
効率化・コスト削減:リソース管理・タスク優先・ワークロード可視化により、最大約40 %のコスト削減が可能。
迅速な立ち上げ:レシピ・ツールにより、公開モデルのトレーニング/ファインチューニングが数分で開始可能。
運用堅牢性:インフラ障害の自動検出・回復により、ワークロード中断のリスクを低減。
デプロイ支援:公開モデル・ファインチューニング済モデル双方のデプロイを高速かつ効率的に実施。
想定ユースケース/適用シナリオ
大規模生成 AI モデル(例:Llama-系、GPT-系、その他大規模言語モデル)を 自社独自ユースケース向けにファインチューニング するプロジェクト。
複数のモデル開発タスクが並行して走っており、リソースの割り当て・優先制御・可視化が必要な組織。
モデルを “すぐに” 立ち上げて、迅速にプロトタイプ/実運用に移行したい場合。
モデルの推論/トレーニング環境のクラスタ運用・障害対応を自前で手厚くやるコストを抑えたい場合。
注意・検討ポイント(ユーザー視点)
「数百〜数千のアクセラレーターを使う」というスケールを前提としており、小規模環境ではこの恩恵をフルに享受できない可能性があります。
自動化・レシピ提供など便利な機能はありますが、自社ユースケースに“どこまでカスタマイズ”できるか/既存開発プロセスにどう統合するかは、別途検討が必要です。
トレーニング時間短縮・コスト削減の数値(最大40 %)は「条件あり/ベストケース」の可能性があるため、自身のワークロードでどの程度出るか検証が必要です。
運用・モニタリング・リカバリ機能が備わっているとはいえ、クラスタ運用経験がないと「どう使いこなすか」「設置構成・運用フローをどう設計するか」には準備が必要です。
デプロイ・運用フェーズも含めて、データ・モデル・コンピュート予算・ガバナンス体制(誰がタスクを出す/優先度をどうつけるか)をきちんと設計しておくことが成功の鍵です。
まとめ
SageMaker HyperPod は、生成 AI モデルを「迅速に」「大規模に」「効率的に」開発・トレーニング・デプロイするための、AWS のマネージドなクラスタ型ソリューションです。モデル開発の “スケーラビリティ/運用効率・コスト最適化/ガバナンス体制” を一元化してサポートしており、特に大規模なモデル・データ・クラスターを扱う企業・組織には有力な選択肢となります。
