【動画生成】Sunoで作ったオリジナル曲をComfyUI-FLOATで歌ってもらうゾ!

「音楽AIで生成した日本語曲を動画AIに歌ってもらう」のが、思ったよりも自然にできて感動したので、記事にしてみました。
Sunoで生成した曲
AI音楽生成サービスのSunoでつくった曲を使いました。バージョンはv4.0、プロンプトは「mellow cute chip tune, female husky vocals」です。
同じ歌詞で生成した以下の4曲のうち、2番目の曲をえらびました。
この曲とAI動画生成を組み合わせて「歌ってみた」ができないかな、と思っていろいろ試した結果、FLOATという生成AIに行きつきました。
FLOATとは
人物画像と発話音声をもとにリップシンク動画を生成する「AIポートレート・アニメーション」系の技術です(いわゆるAIアバターの一種)。
この系統の生成AIは数多く公開されていて、古くはSadTalker、最近ではAniPortrait、Hallo、Sonic、FantasyTalkingなどが話題になりました。
FLOATはこうした類似技術に比べて、生成効率や安定性、感情表現の点で優れていることが売りのようです。
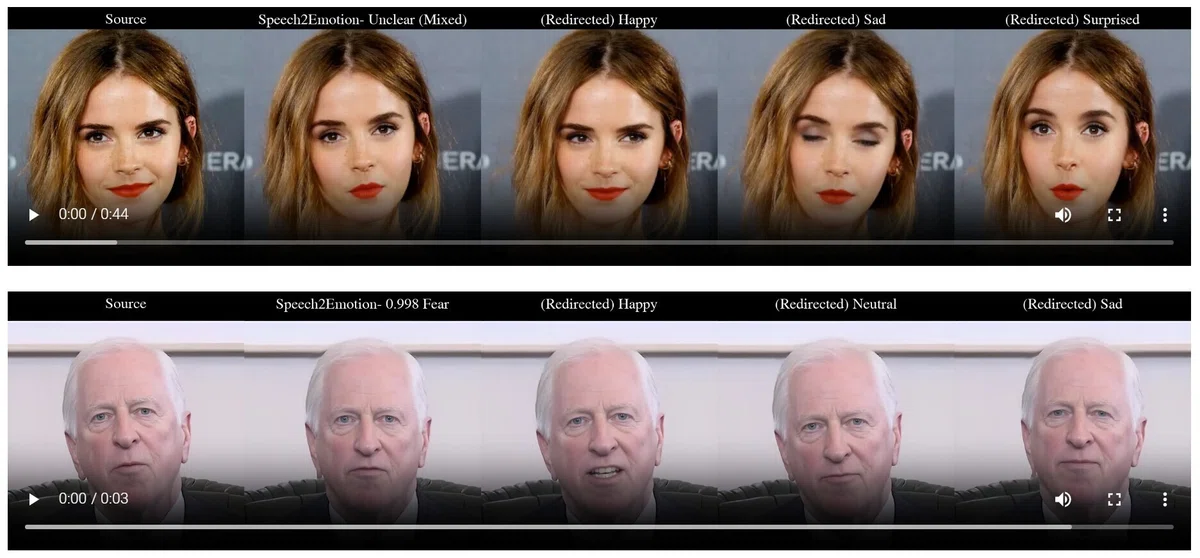
実際に使ってみたところ、確かに軽量で表情生成も自然、さらには日本語にも(一応ですが)対応できるなど、結構いい感じです。
FantasyTalkingはFLOAT以上に動画品質がいいのですが、数秒の動画生成にしか対応しません。日本語も全然ダメでした。
Sonicは一応日本語でも生成できますが、動画品質はFLOATよりやや劣っている印象で、生成速度も比較してかなり遅いです。
ただしFLOATには、出力動画が512x512サイズ限定という残念ポイントがあります。さらに、モデルが商用利用不可(CC BY-NC 4.0)なのも注意が必要です。
ComfyUIでFLOATを使う
FLOATは「ComfyUI-FLOAT」によってComfyUI向け実装が提供されています。Comfy Managerからもインストールできるカスタムノードです。
ワークフローサンプルをComfyUIに読み込み、適当な画像と音声をロード、実行すれば初回に生成モデルが自動ダウンロードされます。
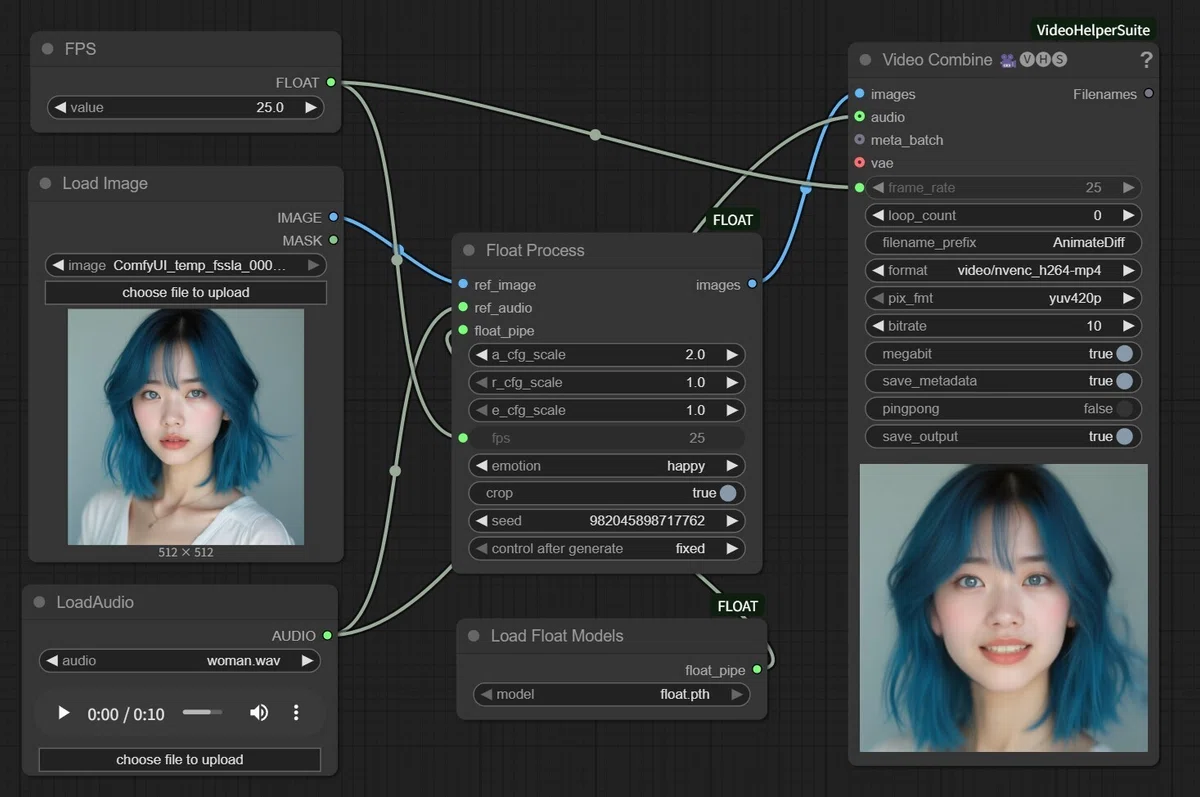
ファイルサイズはエンコーダーなどを含めても全部で3GB程度、生成AIモデルとしては小ぶりだと思います。
FLOATでは感情を指定して生成できます。と言っても、音声のトーンほうが強く影響するため、emotionは少し表情を調整できるくらいです。
FLOATの元論文に目を通すと、モデルは英語中心のデータセットで学習しているので、他言語はトレーニングの範囲外であるものの、なぜかマルチリンガルに動作するようです。
日本語で生成すると時々ズレて舌を噛んだみたいになりますが、個人的には他のポートレートAIに比べると相当いいな、と感じました。
日本語の楽曲で生成する
今回のように楽曲を使う場合は、ボーカルだけ抽出して使ったほうがよさそうです(声以外の音に反応してポートレートが動いてしまうため)。
ボーカル分離ツールとしてはClearVoiceが推奨されていますが、Comfyカスタムノードや、簡単なウェブサービスも多くあります。SunoのStem機能による分離はやや微妙でした。
ということで、楽曲の声に合いそうな雰囲気のポートレート画像を用意し、ボーカル抽出音声と合わせてFLOATで動画生成してみます。
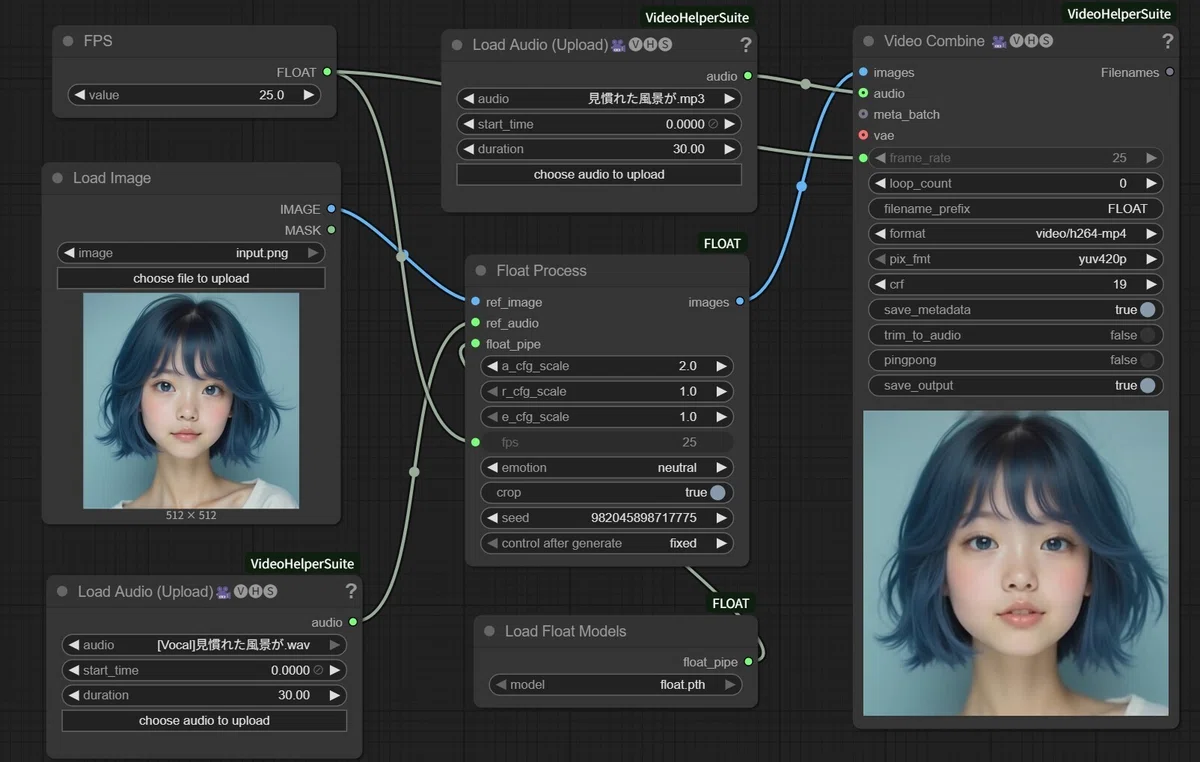
生成後に、動画のオーディオをボーカル音声から元の楽曲音源に差し替えるようにワークフローを変更しておきました。
VRAM16GBのRTX4080で、30秒間の動画を約70秒で生成(連続生成なら25秒ほど)という速度感で、動画生成AIにしてはかなり速いです。
参考まで使用したデータとワークフローをこちらにアップしておきます。
楽曲をフルで動画化する
今回Sunoで作った曲は、2分半ほどの長さがあります。分割生成してから編集でつなげるのも手ですが、今回はまるまる1曲を一括で動画化してみたいと思います。
どうやら2分半の生成自体はVRAMが20GBほどあれば足りるものの、動画のデコードのところでVRAM不足になり止まってしまいます。
ComfyUIのWanVideoのように分割デコードを実装できればよさそうですが、ここではクラウドで大型GPUを借りて物理的に解決しました。
最初はGoogle ColabのA100で試したのですが、40GBだと1.5分くらいの尺が限界。Vast.aiで80GB版のA100を借りました(0.84ドル/h)。
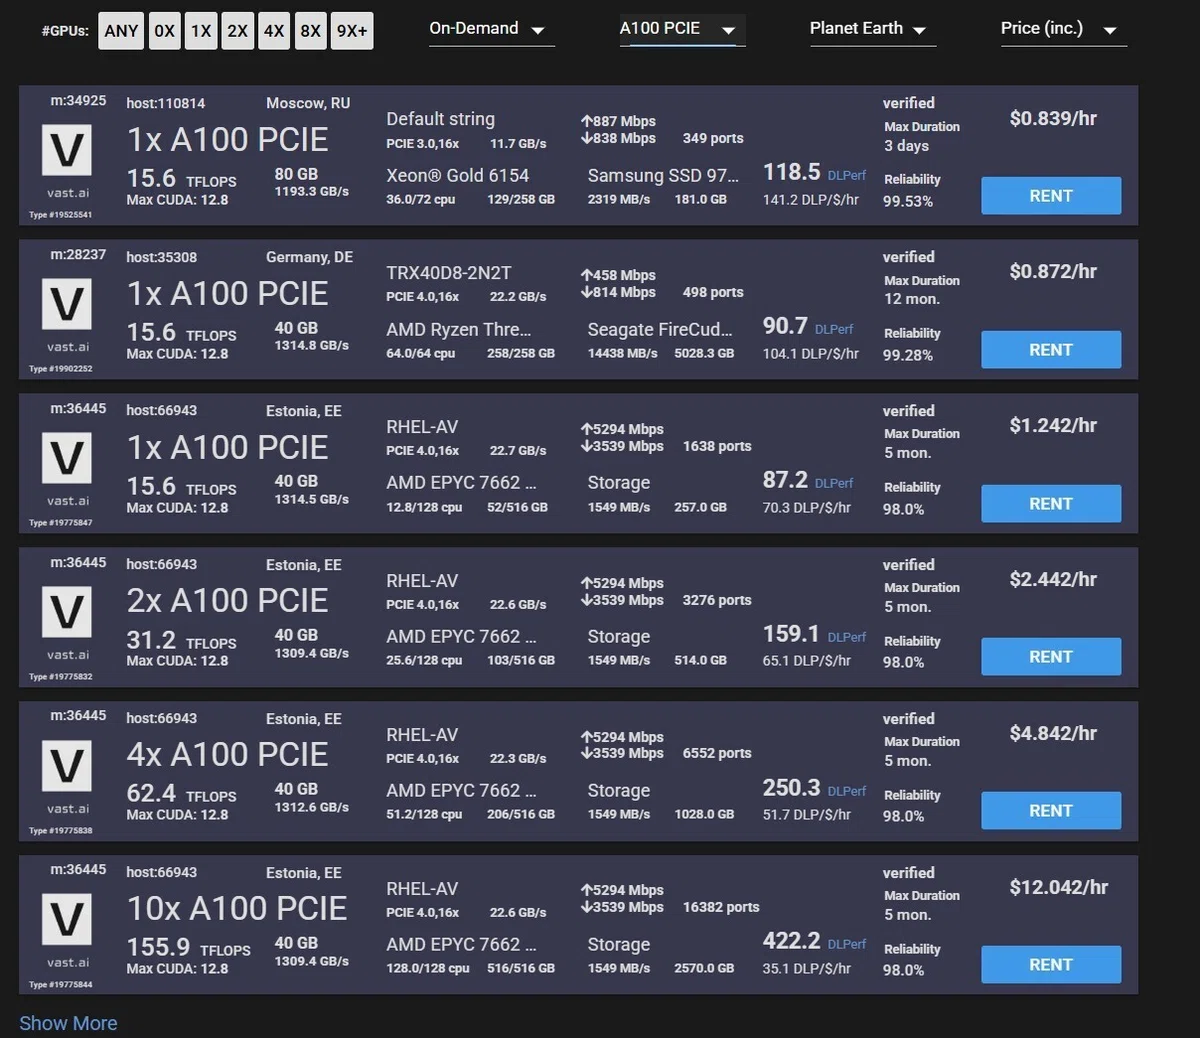
さすがに80GBあるとデコードもスムーズ。2.5分の音声をさくっと動画化できました。初回の生成はモデルダウンロード込みで7分、2回目以降は2分強でした。