生成AIによるシステム開発自動化とセキュリティガイドライン

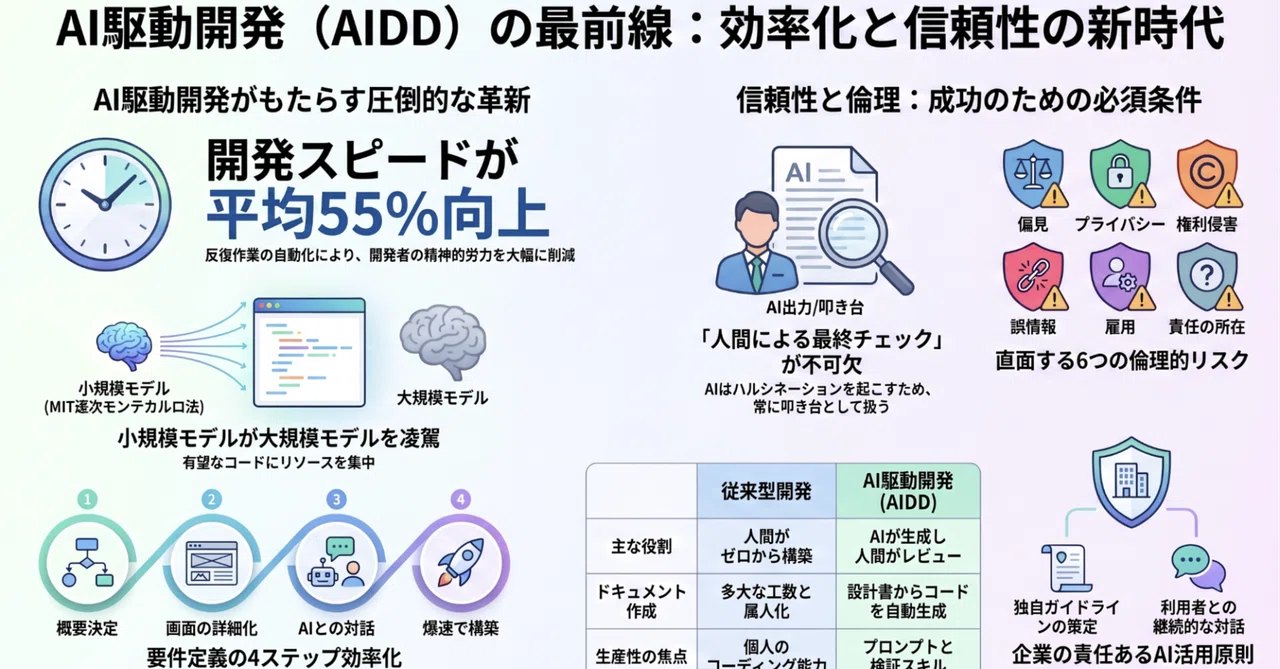
提供された資料は、AI技術がシステム開発の全工程にもたらす革新と、それに伴う倫理的課題について包括的に解説しています。MITの研究による「逐次モンテカルロ法」を用いたコード生成精度の向上など、小規模モデルでも大規模モデルを凌駕する最新技術が紹介されています。また、要件定義や画面設計の効率化、テストの自動化といった実務への応用事例が具体的に示される一方で、著作権侵害や個人情報の漏洩、ハルシネーションといった深刻なリスクへの警鐘も鳴らされています。企業には、ガイドラインの策定や人間による最終確認といった責任ある管理体制の構築が求められています。最終的にこれらのソースは、AIを単なる補助ツールではなく、開発者と共生するパートナーとして正しく活用するための指針を提示しています。
ゼロからわかる!システム開発の専門用語解説集
導入:システム開発の世界へようこそ
システム開発やプログラミングの世界に足を踏み入れたばかりの学生や新社会人の皆さん、ようこそ!たくさんの専門用語に出会って、「何から学べばいいんだろう?」と戸惑っていませんか?
このドキュメントは、そんな皆さんのためのガイドブックです。システム開発という一見複雑なプロセスを、誰もがイメージしやすい「家を建てるプロセス」という例え話を使いながら、一つひとつの専門用語を丁寧に解説していきます。このガイドを読めば、専門用語への苦手意識がなくなり、システム開発の全体像がスッキリと頭に入るはずです。
--------------------------------------------------------------------------------
1. システム開発の全体像:ものがたりで理解する一連の流れ
システム開発は、思いつきで進められるものではなく、決まった順序で進められる一連の物語のようなものです。この一連の流れを「ソフトウェア開発ライフサイクル(SDLC:Software Development LifeCycle)」と呼び、システムが生まれてから役目を終えるまでの一生を管理する考え方です。一般的に、以下の6つのステップで進んでいきます。
要件定義 (何を作るか決める)
設計 (どう作るか計画する)
実装 (実際に組み立てる)
テスト (問題がないか確認する)
デプロイ (使えるように公開する)
運用・保守 (使い続けられるように維持する)
これらの工程は、それぞれが大切な役割を担っています。ちょうど、家族の夢を聞き、設計図を描き、家を建て、安全性を確認して引っ越し、そして日々のメンテナンスをするという「家づくり」の物語のように、順番に進んでいくのです。
次のセクションから、この物語の各章を詳しく見ていきましょう。
--------------------------------------------------------------------------------
2. 各工程の解説:専門用語を「家づくり」で紐解く
2.1. 要件定義 (ようけんていぎ)
システムに必要な要件を明確化する工程です。
家づくりに例えると… 建築家が家族に「どんな家に住みたいですか?」とヒアリングする段階です。「部屋はいくつ必要か」「キッチンは対面式がいいか」「日当たりの良いリビングが欲しい」といった、家族の夢や要望(=要件)をすべて聞き出し、まとめる作業にあたります。
要件定義では、後の工程で手戻りが発生しないように、システム開発の土台となる部分を固める非常に重要な活動が行われます。
目的の明確化: なぜこのシステムが必要なのか、根本的なゴールを定めます。家づくりで言えば、「なぜこの家を建てるのか?」という動機を確認する作業です。家族が増えるから、仕事部屋が欲しいからなど、目的がはっきりすれば最適な家が見えてきます。
機能の洗い出し: システムに具体的にどのような機能が必要かをリストアップします。これは、要望を具体的な部屋や設備に落とし込む作業です。「寝室が3つ」「書斎が1つ」「食洗機付きのキッチン」といったように、必要なものをすべてリストアップします。
範囲の決定: 「どこまでを今回開発し、何はやらないのか」の境界線を引きます。家づくりで言えば、「今回は庭の造成まではやらず、建物本体の完成を優先しましょう」と決めるようなものです。限られた時間と予算の中で最も重要なことから実現するために不可欠です。
すべての要望がまとまったら、次はいよいよ家の設計図を描く「設計」の工程に進みます。
2.2. 設計 (せっけい)
システムの構造や技術仕様を設計する工程です。
家づくりに例えると… 建築家が、家族の要望を基に具体的な設計図を描く段階です。部屋の配置、柱の太さ、電気の配線、水道管の通り道など、職人さんが実際に家を建てられるように、あらゆる情報を詳細に図面に落とし込んでいきます。
この工程では、要件定義で決まった「何を作るか」という夢を、職人さんが迷わず作業できる「どう作るか」という具体的な計画に落とし込む、緻密な活動が行われます。
アーキテクチャ設計: システム全体の骨格や構造を決めます。家で言えば、木造にするか鉄筋コンクリートにするか、平屋にするか二階建てにするか、といった最も基本的な構造を決める作業です。
UI/UX設計: ユーザーが直接触れる画面の見た目や使いやすさを考えます。家の動線を考えることに似ています。スイッチは押しやすい場所にあるか、キッチンからダイニングまでの移動はスムーズかなど、住む人にとっての心地よさを設計します。
データベース設計: システムが扱う情報(データ)を、どのように保管し、整理するかを決めます。家の収納計画のように、どこに何をしまうかを決めておかないと、後で情報がぐちゃぐちゃになってしまいます。
完璧な設計図が完成したら、いよいよ職人さんたちが組み立て作業に入る「実装」の工程に移ります。
2.3. 実装 (じっそう)
設計書に基づいてシステムを構築する工程で、「コーディング」とも呼ばれます。
家づくりに例えると… 設計図をもとに、大工さんや電気屋さんといった職人さんたちが実際に家を建てる段階です。木材を切り、釘を打ち、配線をつなぎ、壁紙を貼る…といった、プログラミング言語を使って設計図を形にしていく作業です。
この工程では、設計図という「計画」を、実際に動く「製品」へと変換するための、精確さと品質が求められる活動が行われます。
プログラミング: 設計書に従い、プログラミング言語を使ってコードを書きます。これは、まさに大工さんが木材を切り、釘を打つ作業です。設計図に書かれた一本一本の線を、プログラミング言語という道具を使って現実の形にしていきます。
コードレビュー: 他のエンジニアが書いたコードをチェックし、品質を高めます。棟梁が他の大工さんの仕事を確認するようなものです。柱が垂直か、釘がしっかり打たれているかなど、第三者の目でチェックすることで、家の安全性が高まります。
ドキュメント作成: 後から他の人が見てもわかるように、コードの意図や使い方を記録します。ブレーカーボックスに各部屋の名前を記載したり、家電の取扱説明書をまとめておいたりする作業です。後からメンテナンスする人が困らないように記録を残します。
家が形になったら、本当に安全で快適に住めるかどうかを隅々までチェックする「テスト」の工程が待っています。
2.4. テスト
システムが要件を満たしているか、不具合がないかを確認する工程です。
家づくりに例えると… 完成した家の最終チェック(内覧会や検査)です。「蛇口をひねったらちゃんと水が出るか」「ドアはスムーズに開け閉めできるか」「雨漏りしないか」など、設計図通りに作られているか、そして安全に使えるかを徹底的に確認します。
この工程では、システムがお客様の期待通りに動作し、安心して使える品質であることを保証するための、徹底的な検証活動が行われます。
テスト計画: どのようなテストを、いつ、どのように行うかを計画します。家の完成検査の計画を立てるようなものです。いつ、誰が、どの部分(電気、水道、構造)をチェックするのかを事前に決めます。
テストケース作成: 確認したい項目をリストアップし、具体的な操作手順と期待される結果をまとめます。家の検査で言えば、「玄関の鍵が施錠・解錠できるか」「2階の窓がスムーズに開くか」といった具体的なチェック項目リストを作る作業です。
テスト実行とバグ報告: テストケースに基づきシステムを操作し、問題(バグ)が見つかったら開発者に報告します。検査員がチェックリストを片手に実際に蛇口をひねり、もし水漏れが見つかれば、すぐに建築チームに報告して直してもらいます。
すべてのチェックが完了し、安全性が確認された家は、いよいよ家族が住み始める「デプロイ」の段階に進みます。
2.5. デプロイ
開発したシステムをユーザーが使えるように、正式に稼働させる工程です。
家づくりに例えると… 完成した家への「引越し」と「鍵の引き渡し」です。家具を運び入れ、電気やガスを開通させて、家族が実際に生活を始められる状態にします。システム開発では、ユーザーがいつでも使えるようにインターネット上に公開する作業にあたります。
この工程では、開発されたシステムを、ユーザーが実際に触れて価値を享受できる「本番環境」へと安全かつ確実に届けるための、最終段階の活動が行われます。
環境構築: システムが動くためのサーバーなどを用意します。これは、家を建てるための土地を整備するようなものです。
リリース作業: 開発したプログラムをサーバーに配置し、公開します。家の完成見学会を開き、いつでも住めるようにドアを開放するようなもので、世界中の人がアクセスできる状態にします。
最終確認: 公開されたシステムが、ユーザーの環境で正しく動作するか最終チェックを行います。引渡し前の最終内覧会です。家族に実際に家の中を歩いてもらい、照明がつくかなど、彼らの環境で問題がないかを確認します。
引越しが完了し、新しい生活が始まった後も、家を快適に保つためのメンテナンスが必要です。これが「運用・保守」の工程です。
2.6. 運用・保守 (うんよう・ほしゅ)
システムが稼働し始めた後、安定して動き続けるように定期的な監視と改善を行う工程です。
家づくりに例えると… 住み始めた後の家のメンテナンスです。定期的な掃除や、壊れた箇所の修理、家族構成の変化に合わせたリフォームなどが含まれます。システムも公開して終わりではなく、安定して動き続けるように見守り、必要に応じて改善していくことが不可欠です。
システムは公開したら終わりではなく、まるで生き物のように日々のケアが必要です。この工程では、システムが安定して動き続け、常に価値を提供できるようにするための、継続的な活動が行われます。
監視: システムが正常に動いているかを24時間365日見守ります。家の防犯システムや火災報知器のように、常に家の状態を見守り、何か異常があればすぐに対応できるように備えます。
障害対応: システムに問題が発生した際に、原因を特定し、迅速に復旧させます。水道管の破裂や停電といった、突然のトラブルに対応する緊急修理です。一刻も早く普段通り使えるように復旧させます。
アップデート: 新しい機能を追加したり、セキュリティを強化したりするためにシステムを更新します。家族の成長に合わせて子供部屋を増築したり、古くなったキッチンを最新のものにリフォームしたりする作業です。
--------------------------------------------------------------------------------
3. まとめ:システム開発の旅を振り返る
これまで解説してきたシステム開発の各工程を、「家づくり」の例えと共に振り返ってみましょう。この表を見れば、全体の流れが一目でわかります。
システム開発の工程
家づくりに例えると…
要件定義
どんな家に住みたいか、家族の要望をヒアリングする
設計
要望をもとに、具体的な設計図を描く
実装
設計図通りに、職人さんたちが家を建てる
テスト
完成した家が安全で問題ないか、最終チェックをする
デプロイ
家族が引っ越してきて、新しい生活を始める
運用・保守
住み始めた後の、定期的なメンテナンスや修理を行う
システム開発は、一見すると専門的で難しく感じるかもしれません。しかし、このように一つひとつの工程を順番に進めていく、非常に論理的なプロセスなのです。
この解説集が、あなたのこれからの学習の第一歩となり、システム開発という魅力的な世界への興味を深める一助となれば幸いです。
以降は、2025年10月に書いた記事なので現在とはすこしかわった部分があるかもしれません。特に数値的なところはそれを考慮してよんんでください。
AIを活用した要件定義の効率化プロセスガイド:4つの基本ステップ
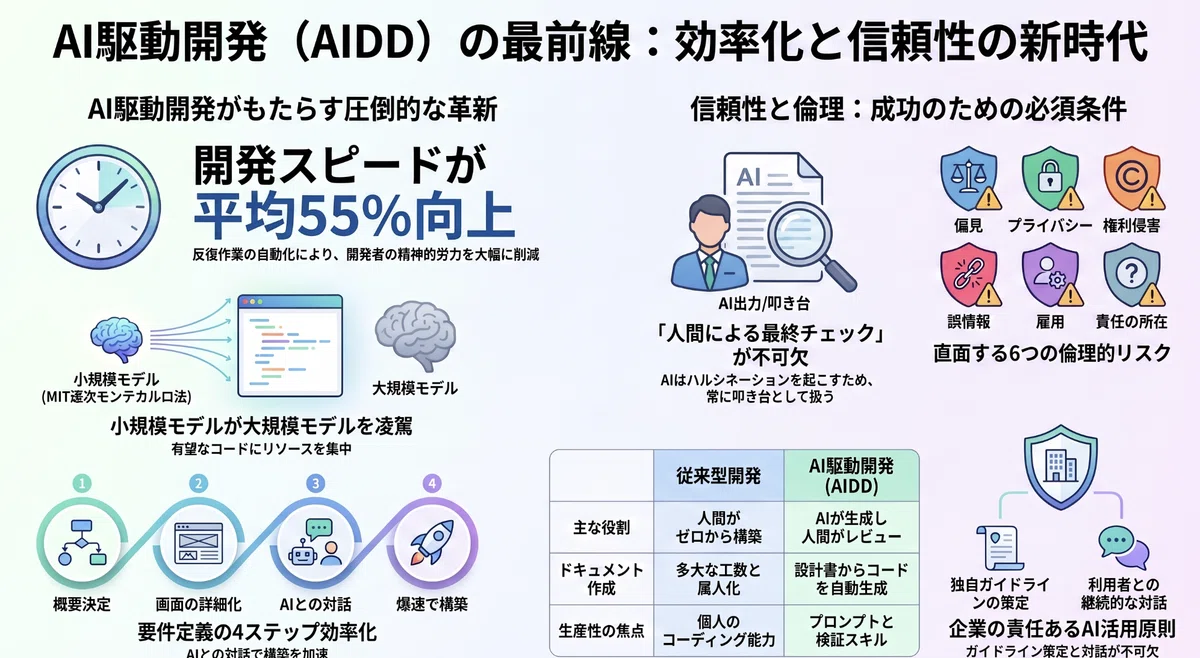
1. はじめに:AI駆動開発(AIDD)がもたらす革新
システム開発ライフサイクル(SDLC)において、最上流工程である「要件定義」は、プロジェクトの成否を分ける最も重要なフェーズです。しかし、伝統的な「要求工学」の現場では、情報の正確性の維持や統一性の欠如(バラつき)が長年の課題とされてきました。
この課題を打破するのがAI駆動開発(AI-driven development, AIDD)です。AIDDとは、大規模言語モデル(LLM)などのAI技術を開発プロセス全体に統合し、人間の知的な作業を支援・自動化するアプローチを指します。AIはもはや単なるツールではなく、あなたの隣で思考を補完する「ペアプログラマ」へと進化しています。
AIDD導入の3つの本質的メリット
劇的な生産性の向上 GitHubの調査では、AIを活用することでタスク完了速度が平均55%向上するというデータが出ています。特に「たたき台」をゼロから作る労力をAIが肩代わりすることで、人間は「判断」という本質的作業に集中できます。
要求品質の安定化と統一 個人の経験値に依存しがちな要件抽出において、AIが標準的なフレームワークに基づいて多角的に機能を洗い出すため、漏れや矛盾を早期に発見し、ドキュメントの粒度を一定に保つことが可能になります。
知識のエンジニアリングによるパラダイムシフト AIを「専門家ペルソナ」として振る舞わせることで、未経験のドメインであってもプロの視点を取り入れた要件策定が可能になります。
AI活用の意義を理解したところで、プロフェッショナルな「AI駆動型エンジニア」としての具体的な実践ステップを確認していきましょう。
2. 実践!AIによる要件定義の4つの基本ステップ
要件定義を効率化するには、AIを「ベテランSE」として扱い、段階的に情報を具体化させていくプロセスが不可欠です。以下に、顧客管理システム(CRM)などの実例をベースとした4つのステップを整理しました。
ステップ
実施内容
AIへの指示(プロンプト)のコツ
1. システム概要の策定
開発の目的、対象範囲(スコープ)、既存の概要書やマニュアルをインプットし、土台を固める。
「対象範囲を限定する」:回答の発散を防ぐため、既存の仕様書や業務フローを具体的に読み込ませる。
2. 機能の洗い出し
必要な機能を抽出し、**MVP(最小機能)と拡張機能(Phase 2以降)**を明確に分離する。
「ベテランSEのペルソナ」:あなたは経験豊富なSEです、と設定。実装観点(DB整合性等)を含めた整理を命じる。
3. 画面情報の抽出
特定された機能に基づき、ダッシュボード、一覧、詳細、設定といった必要な画面構成を特定する。
「役割の明確化」:機能一覧から「ユーザーが何をする画面か」をセットで書き出させる。
4. 画面の詳細化
各画面に配置すべきUI要素(入力項目、ボタン、表示内容)やUXの工夫を具体化する。
「配置の具体化」:ワイヤーフレームの構成要素(ヘッダー、メイン、サイド)を指定して出力させる。
これらのステップを機械的に進めるのではなく、AIとの「対話」を通じて、人間の意図を段階的に注入していくことが、高品質な成果物への近道です。
3. ハルシネーションの防止と品質担保のメカニズム
AIを実務で使う上で最大の障壁は、もっともらしい嘘をつく「ハルシネーション(幻覚)」です。MITの研究チームが提唱した「逐次モンテカルロ(SMC)法」という手法は、私たちの品質管理に重要な示唆を与えてくれます。
ハルシネーションを防ぐ3つの行動指針
「有望な候補への集中と早期の切り捨て」の実践 MITの研究が示すように、AIに一度に全てを答えさせるのではなく、複数の案を出させて筋の悪いものを早期に排除します。これは**「将棋のプロ棋士が有望な次の一手だけを深く読む」ことや、「投資家がパフォーマンスの良い銘柄に資金を集中させる」**メカニズムに似ています。AIの回答を鵜呑みにせず、ステップごとに「この筋で進めて良いか」を評価・軌道修正してください。
「構造」と「意味」のダブルチェック AIの出力が「ドキュメントの形式(構造)」として正しいかだけでなく、実際のビジネスロジックや「ユーザーの意図(意味)」を満たしているかを常に検証してください。文法的な正しさの裏に、機能的な欠落が隠れていることが多いためです。
賢いアルゴリズムによる小規模モデルの活用 MITの研究者は**「小さなモデルが自分の重さをはるかに超えるパンチを放てる」**と述べています。これは、巨大で高価なモデルを使わずとも、適切なプロンプト(アルゴリズム)と逐次的な評価フローを組み合わせれば、小規模なAIでも大規模モデルを凌駕する精度を出せることを意味します。
AIを賢く使うためには、人間が担うべき「責任」の境界線を明確にする必要があります。
4. 人間のチェックと倫理的責任の確立
AIは強力な補助者ですが、最終的な判断と責任を負うのは常に人間であるという原則を忘れてはいけません。Wikipediaの調査でも、初期のAI生成コードの約40%に脆弱性が含まれていた事例が報告されています。技術的な正確性だけでなく、社会的な公平性や権利保護も人間の重要な任務です。
特に「プライバシー」に関しては、統計処理にノイズを加えて個人の特定を防ぐ「差分プライバシー(Differential Privacy)」のような技術概念を理解し、設計に組み込む配慮が求められます。
倫理・品質チェックリスト
[ ] 正確性の検証: 事実に基づかないハルシネーションが含まれていないか。
[ ] バイアスの精査: 学習データの偏りに由来する不公平な判断(人種・性別・年齢等)がないか。
[ ] 権利侵害の確認: 生成物が他者の著作権やOSSライセンスを侵害していないか。
[ ] プライバシー保護: 個人情報の漏洩リスクはないか、差分プライバシー等の対策は検討したか。
[ ] セキュリティの担保: 生成された仕様やコードに脆弱性(インジェクション等)が含まれていないか。
5. まとめ:実務への第一歩を支援するプロンプトの要諦
最後に、質の高いたたき台を得るための「実戦的なプロンプト」の構成要素を整理します。一度で完璧な回答を求めず、何度も調整を繰り返すマインドセットこそが重要です。
質の高いプロンプトを構成する5つの必須要素
ペルソナ設定: 「あなたは銀行システムの要件定義に20年携わっているSEです」といった専門性の指定。
情報のインプット: 既存のシステム概要書、業務マニュアル、またはソースコードなどの具体的参照データの提供。
制約条件: 「MVPの範囲内で」「表形式で」「36協定の遵守を前提に」などの具体的なルール。
出力フォーマット: Markdownの表、UML(PlantUML)形式、ワイヤーフレームの構成要素リストなど。
反復と深化: 「ここまでの内容に矛盾がないか確認し、不足があれば質問してください」という対話の継続。
「賢いアルゴリズム」を使いこなすあなたの指示次第で、AIはあなたの重さをはるかに超えるパンチを放つ最強の武器になります。AIと共に歩むことで、より創造的で価値の高いエンジニアリングの世界へ足を踏み入れましょう。
小規模AIが巨大モデルを超える仕組み:逐次モンテカルロ法が起こすコード生成の革命
1. プロローグ:AIコード生成の「新しいステージ」
現在、AIによるコード生成は「書けないコードはない」と言われるほどの期待を集めています。しかし、現場のプログラマーが直面しているのは、生成されたコードが「見た目はもっともらしいが、実行すると動かない」という深刻な課題です。(2026年夏は、もうこの状態はないですね。現時点ではこの問題は人間側にあります。)
これまでの解決策は、モデルを巨大化させて「知識量」で押し切る力技が主流でした。しかし今、世界は「モデルの大きさ」ではなく、限られたリソースを賢く使う「アルゴリズムの洗練」に注目し始めています。本資料では、MITの研究チームが提唱した、小さなAIが巨大なライバルを圧倒する「逐次モンテカルロ法」の衝撃について解説します。
学習のゴール
[ ] AIが「もっともらしい嘘(ハルシネーション)」をつく構造を理解する。
[ ] 「逐次モンテカルロ法」の核心を、身近な比喩で直感的に把握する。
[ ] なぜ小規模なモデルが巨大モデルを上回る成果を出せるのか、その理由を説明できる。
では、そもそもなぜ現在の最新AIであっても、完璧なコードを書くことが難しいのでしょうか。既存の大規模モデルが抱える具体的な「弱点」へと視点を移してみましょう。
2. 既存LLMの壁:なぜ「幻覚(ハルシネーション)」は起きるのか
大規模言語モデル(LLM)は、本質的に「次に続く確率が高い言葉」を予測する統計マシンです。中学生の皆さんが「明日の天気は……」と言われたら「晴れ」や「雨」を予想するように、AIも確率だけで言葉を繋いでいます。
そのため、コード生成において「論理的な正解」よりも「それっぽい並び」を優先してしまい、文法は完璧なのに中身がデタラメな「ハルシネーション(幻覚)」が起きてしまうのです。
項目
具体的な影響
コード生成における課題
信頼性
確率的な「次の一言」予測
統計的に正しい言葉を並べるだけで、プログラムの「論理」を理解していない。
計算資源
巨大化によるコスト増大
精度を上げるためにモデルを大きくし続けると、膨大な電力やサーバーが必要になる。
データの偏り
過去のパターンの再生産
学習データに古い書き方が多いと、非効率なコードを「正解」として出力する。
この課題を、ただモデルを大きくするのではなく「知識のエンジニアリング(アルゴリズムによる制御)」で解決しようとするMITの研究チームの挑戦を紹介します。
3. 直感で理解する「逐次モンテカルロ法」:2つの魔法の比喩
MITが開発した新手法の鍵は、**「逐次モンテカルロ(Sequential Monte Carlo)」**というアプローチです。これは、AIがコードを生成する途中で「有望な選択肢」をリアルタイムで見極め、計算リソースを動的に配分する仕組みです。
2つの鮮やかな比喩で、その本質を掴んでください。
1. 将棋のプロ棋士の思考
プロ棋士は、数億通りある指し手をすべて等しく検討するわけではありません。盤面を読み、「筋が良い」と思われる有望な手順だけを深く掘り下げ、明らかに不利になる手は一瞬で切り捨てます。このアルゴリズムも同様に、エラーになりそうな道筋を早めに「剪定(せんてい)」し、AIが間違いの森で迷子にならないように導くのです。
2. 投資ポートフォリオ管理
優秀な投資家は、パフォーマンスの悪い銘柄からは資金を引き上げ、絶好調の銘柄に資産を集中させます。この手法では、限られた計算リソース(資金)を「将来性の高いコードの断片」に動的に再配分します。無駄な計算を徹底的に省き、勝利確実なコード案に全力を注ぎ込むのです。
この「有望な候補への集中」と「早期の切り捨て」という思考法が、どのように具体的なコードの品質保証につながるのか、その仕組みへ深掘りします。
4. 品質保証のダブルチェック:「構造」と「意味」の同時評価
この手法の凄さは、コードを生成するステップごとに「文法(構造)」と「機能(意味)」の両面から専門家のような視点でチェックを入れる点にあります。
評価の側面
チェック内容
手法による改善
構造(文法的正確さ)
プログラミング言語のルールを守っているか。
1行書くごとに文法ミスを検知。エラーが確定した瞬間にその案を「ボツ」にする。
意味(意図した機能)
ユーザーが求めた「目的」を達成できそうか。
完成を待たず、早い段階で「この書き方では目的からズレる」と判断し、正しい道へ修正する。
これは、**「LLMのすぐそばに厳しい専門家が座っていて、一歩一歩の選択に対して『そのコードで本当に動くのか?』と問いかけ、導いている」**ような状態です。単に文字を並べるAIが、論理を重んじる「エンジニアの思考」を手に入れたといえます。
この「賢いアルゴリズム」がもたらした、驚くべき実証結果について見ていきましょう。
5. 下克上の実現:小さなモデルが巨大モデルを圧倒する理由
この技術は、AI業界の常識であった「大きいほど強い」というルールを壊しました。まさに**「小さなモデルが、自分の重さをはるかに超える強力なパンチを放った」**のです。
MITの実証実験では、Pythonのコード生成において、ある小規模なオープンソースモデルが、その2倍以上のサイズを持つ商用クローズドモデル(巨大な最新AI)を上回る精度を叩き出しました。
小規模モデル + 逐次モンテカルロ法による3つの利点:
圧倒的なパンチ力(高精度): 巨大モデルでも苦戦する複雑な論理構造を、小さなモデルが正確に組み立てる。
最高の効率性: 計算リソースを「勝てる道筋」に集中させるため、低コストで最高の結果が得られる。
AI開発の健全な発展: モデルを肥大化させる「力技」に頼らず、知恵(アルゴリズム)で勝負する新しい道を示した。
この技術がプログラマーだけでなく、あらゆるビジネスパーソンにどのような恩恵をもたらすかを考察します。
6. 技術の広がり:非専門家が手にする「AIの魔法」
この「正確に正解を導き出す力」は、プログラミング以外の分野でも、専門知識を持たない人々を強力にサポートします。
未来の応用シナリオ①:ビジネスパーソンのデータ分析 プログラミングを知らない営業担当者が、普通の言葉で「エリア別の売上推移をグラフにして」と頼むだけで、AIが背後で完璧なSQLクエリを生成し、一分の隙もない分析結果を即座に提示する。
未来の応用シナリオ②:科学的発見と精密設計 創薬における複雑な分子構造の設計や、ロボットの精密な制御計画など、わずかなミスも許されない高度な領域で、AIが「信頼できる設計図」を自ら検証しながら生成する。
未来の応用シナリオ③:自己進化するAI AIが生成した正確なコードを、AI自身が「完璧な学習データ」として取り込む。自分自身の出力で学び、人間を介さずに賢くなり続けるループが実現する。
最後に、この技術が言語学的な問いにどう答えていくのか、研究の展望に触れます。
7. エピローグ:AIと共に歩む未来への招待
MITの研究は、AI開発のパラダイムを「量の拡大」から「質の洗練」へとシフトさせました。ここで研究者が投げかけているのは、非常に深い言語学的な問いです。それは**「言葉の意味は、いかに世界のモデルに根ざし、不確実性や曖昧さを乗り越えるのか」**という問題です。
逐次モンテカルロ法は、単にコードを正しく書くための道具ではありません。AIが言葉の裏側にある「意図」や「世界のルール」を理解し、不確実な選択肢の中から真実を選び取るための「知性の羅針盤」なのです。
AIは「信頼できない嘘つき」から、私たちの意図を正確に形にする「頼れるパートナー」へと進化しています。
明日から意識すべきアクション:
AIの「思考プロセス」を想像する: AIが答えを出すまでに、裏側でどんな「選択と剪定」が行われているか、その仕組みに興味を持ってみてください。
「論理的な指示」を心がける: 賢いアルゴリズムを活かすのは、人間の明確な「意図」です。AIに何をさせたいのか、ゴールを具体的に伝える練習をしましょう。
変化を楽しみ、AIを使い倒す: 技術の壁はアルゴリズムによって崩れつつあります。失敗を恐れず、AIと共に新しい創造に挑戦してください。
AIがあなたの想像力を正確に現実に変えてくれる未来。その扉は、もう開いています。
AI駆動開発(AIDD)導入戦略計画書:次世代ソフトウェアエンジニアリングへの移行
1. エグゼクティブ・サマリー:AI駆動開発がもたらすパラダイムシフト
現代のソフトウェア開発組織は、かつてない歴史的転換点に立たされています。AI駆動開発(AIDD: AI-Driven Development)は、単なる生産性向上ツールの導入を意味するものではありません。それは、従来のSDLC(ソフトウェア開発ライフサイクル)を根本から再定義し、技術的優位性を経営戦略へと直結させる「開発パラダイムの変革」です。
実績データは、この変革の必然性を証明しています。GitHub Copilotの導入により、開発者のタスク完了速度は平均55%向上し、定性面でも73%が「集中力の維持」、87%が「精神的労力の軽減」を実感しています。さらに、Gartner社の予測によれば、AI開発支援ツールの普及率は2023年の約10%から、2028年には約75%へと急増する見込みです。もはやAIDDの導入は「選択」ではなく、組織の生存をかけた「インフラ」へと進化しています。
本計画書では、開発組織が直面する「生産性の停滞」や「信頼性の欠如(ハルシネーション)」といった課題を、最新のアルゴリズムと戦略的な管理フレームワークによっていかに解決し、次世代のエンジニアリング組織へと移行するかを詳説します。
2. 技術的ブレイクスルー:逐次モンテカルロ法による精度革新
従来のLLM(大規模言語モデル)単体でのコード生成は、確率的な推測に基づいた「もっともらしい出力」に依存しており、実行不可能なコードを生成するリスクを排除できませんでした。この限界を打破するのが、MIT(マサチューセッツ工科大学)の研究チームが提唱する「逐次モンテカルロ法(SMC)」を用いた革新的なアプローチです。
「知識をエンジニアリングする」Smart Algorithm
この手法は、単にモデルを巨大化させるのではなく、計算リソースを「有望な出力」へ動的に配分する「Smart Algorithm」に基づいています。
有望な候補へのリソース集中と早期切り捨て: これは将棋のプロ棋士が有望な次の一手だけを深く読み、悪手を瞬時に切り捨てる「先読み」の仕組み、あるいは高いパフォーマンスが期待できる銘柄に資金を集中させる投資ポートフォリオ管理に酷似しています。AIが生成する複数のコード候補を並行評価し、エラーの可能性が高いパスを早期に排除することで、計算効率を最大化しつつ精度を劇的に向上させます。
「構造(文法)」と「意味(機能)」の二面的な品質保証: 生成過程において文法的な正しさ(構造)だけでなく、実行せずともユーザーの意図した機能(意味)を満たしているかを検証します。研究によれば、このアルゴリズムを採用した小規模なオープンソースモデルは、その2倍以上のサイズを持つ商用大規模モデルを精度で凌駕する事例が確認されており、「小規模モデルが自身の重さを遥かに超えるパンチを放つ(punching far above their weight)」時代の到来を示唆しています。
3. SDLC各フェーズへの段階的統合プラン
AIDDの真価は、コーディングのみならずSDLCの全工程にAIを統合することで発揮されます。特に、レガシーコードの「リバースエンジニアリング」や「ドキュメント復元」におけるAIの活用は、既存の技術負債を解消する強力な武器となります。
SDLC工程別AI活用・統合マトリクス
フェーズ
AIの役割と統合のインパクト
主要ツール・ソリューション
要求工学
議事録・FBからの要件抽出、ユーザーストーリー生成、矛盾検出。
Copilot4DevOps, aqua, IBM ERM
設計・アーキテクチャ
UML生成、UIプロトタイピング、リバースエンジニアリングによる設計書復元。
v0, Bolt.new, GPT-4o, Claude 3.5
実装
高精度なコード生成、リファクタリング、ドキュメント自動生成。
Cursor, Devin, Claude Code, Windsurf
テスト・品質保証
テストケース自動生成、テストスクリプトの自動修復(Auto-healing)。
mabl, Momentic, Katalon, Tricentis
運用・保守
ログ分析による根本原因特定、障害予測、自動監視アラート。
監視エージェント、生成AI API
開発者体験(DX)とメンタルウェルビーイング
AIDDの導入は、反復的な定型作業やドキュメント整理の苦労からエンジニアを解放します。精神的労力の軽減は、燃え尽き症候群(Burnout)を防止し、開発者が「より高度な設計」や「創造的な課題解決」に集中できる環境を提供します。
4. 戦略的リスク管理と倫理的フレームワークの構築
AIDD導入にあたっては、以下の5つの戦略的リスクを定義し、技術的・組織的な防御策を講じる必要があります。
Strategic Risk Mitigation Framework
ハルシネーションとセキュリティ脆弱性
Impact: 初期段階のGitHub Copilotでは生成コードの約40%に脆弱性が含まれていたとの報告もあり、未監視の生成は重大な欠陥を招く。
Defense: 「Human-in-the-loop」を原則とし、AI生成物の最終判断責任を人間が負う体制を確立。静的解析ツールとのパイプライン統合。
知的財産権とライセンス遵守
Impact: 学習データ由来のOSSコード再利用によるライセンス違反リスク。
Defense: Amazon CodeWhispererのような「OSSライセンスの出典表示機能」を持つツールの採用と、法務ガイドラインの策定。
アルゴリズムバイアスと公平性
Impact: 再犯リスク評価や人事採用の偏向事例に見られる、不当な差別の助長。
Defense: 判断ロジックの可視化と、多様性のある検証用データによる継続的な公平性テスト。
プライバシー侵害とデータ保護
Impact: 機密コードや個人データの外部学習への流出。
Defense: エンタープライズ版採用によるデータ非学習の保証に加え、技術的対策として「差分プライバシー(Differential Privacy)」を導入し統計的ノイズで個人を特定不能にする。
エンジニアのスキル低下(過度な依存)
Impact: 基礎能力の欠如による、AIトラブル時の解決不能事態。
Defense: AIを学習ツールとして位置づけ、NISC(内閣サイバーセキュリティセンター)の指針に則り「AIの出力を判断する責任能力」を教育プログラムの核とする。
5. 実装ロードマップ:MVPから組織全体への展開
AIDDの定着には、段階的な成功体験と技術的な深掘りが必要です。
ステップ1:MVP(実用最小限の導入)フェーズ
「顧客管理システム」や「勤怠管理システム」の要件定義プロセスにおいて、まずはChatGPTやGitHub Copilotを「たたき台作成」のパートナーとして活用します。数時間要していたドラフト作成を数十秒に短縮し、意思決定のフロントローディングを実現します。
ステップ2:アーキテクチャ・プロンプト仕様の確立
単なる自然言語入力から、エンジニアリング精度を高める「Architectural Prompt Specification」への昇華を図ります。
使用フレームワーク(例:Spring Framework)の明示
依存関係(Dependency Injection)のインジェクト明記
キャスト処理やバリデーションロジックの具体的制約注入
エラーコード(例:E_AR_CA_5001)や共通チェックメソッドの指定
ステップ3:AIネイティブ開発への文化変革
最終段階では、NISCや経済産業省の「AI事業者ガイドライン」に準拠した社内倫理原則を公開し、AIを前提とした開発文化を定着させます。これは、従来の文化的抵抗を打破し、AIを「ペアプログラマ」として尊重しつつ、人間が「グランドデザイン」を司る共生モデルです。
展望:AIと人間が共生するエンジニアリングの未来 AI駆動開発は、開発者を置換するものではなく、エンジニアの需要を「複雑なシステム設計」と「倫理的責任の遂行」へと高度化させるものです。我々は、AIの計算力と人間の創造性を融合させることで、これまでの限界を超えたスピードと品質でイノベーションを創出し続けます。
