
LTX-2.3 SI2Vが凄い!画像が喋るリップシンク動画生成|ComfyUI

ComfyUIで画像を喋らせる動画を作ろうと思って調べ始めると、モデルの配置場所や必要ファイル、ワークフローの組み方など、最初につまずきやすいポイントが意外と多いです。
この記事では、ComfyUIをインストールした直後の状態から、LTX-2.3 SI2V を使って静止画と音声からリップシンク動画を生成するまでの手順を、備忘録も兼ねて順番にまとめていきます。
これから初めて試す人はもちろん、あとから自分で環境を作り直すときにも見返せる内容を目指しています。
なお、今回の内容は、LTX-2 SI2Vを使った画像ベースの動画生成およびリップシンク表現 を中心にした技術メモです。検証・学習・創作用途を前提としており、実在人物の画像や音声を扱う場合は、権利やプライバシーに十分配慮したうえで活用してください。
それではまず、必要なモデルや関連ファイルの準備から進めていきます。
1. この記事の前提環境
本記事は、Stability Matrix上にComfyUIを導入した環境を前提に解説しています。
同じ環境を用意したうえで解説通りに進めたい方は、まずはこちらのYouTube動画を参考にしてください。
2. リップシンク動画の生成を実際に試してみる
2.1. 必要モデルのインストール
空のワークフローを開きます。
テンプレートをクリックします。
ビデオをクリックします。
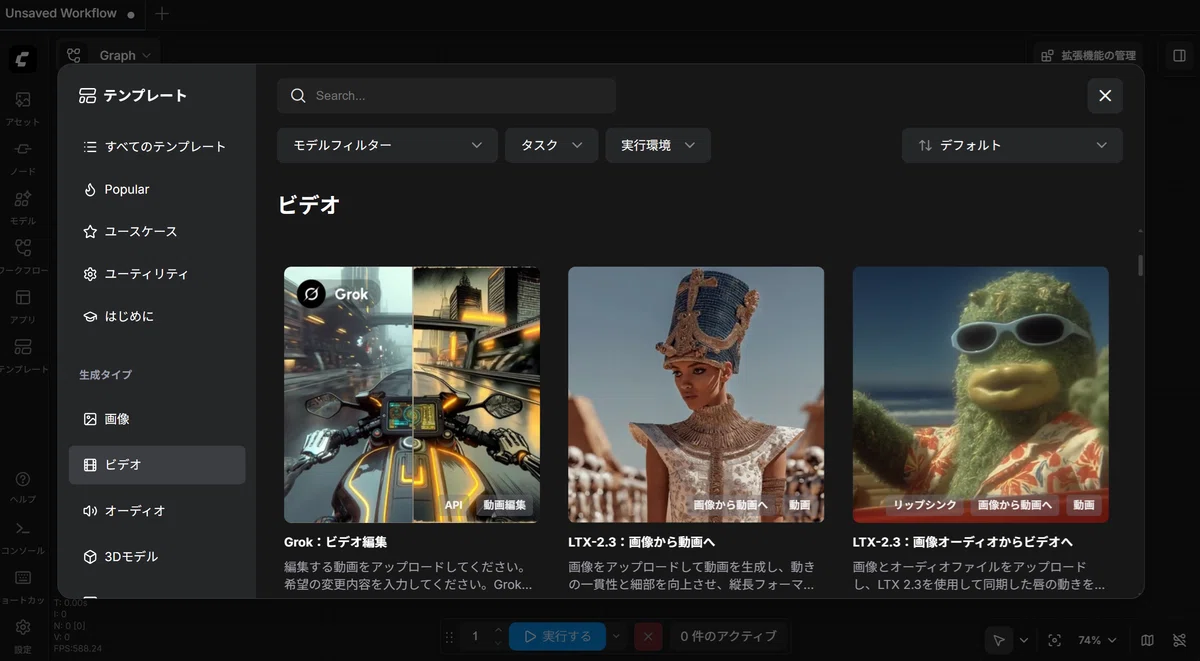
「画像オーディオからビデオへ」を選択します。
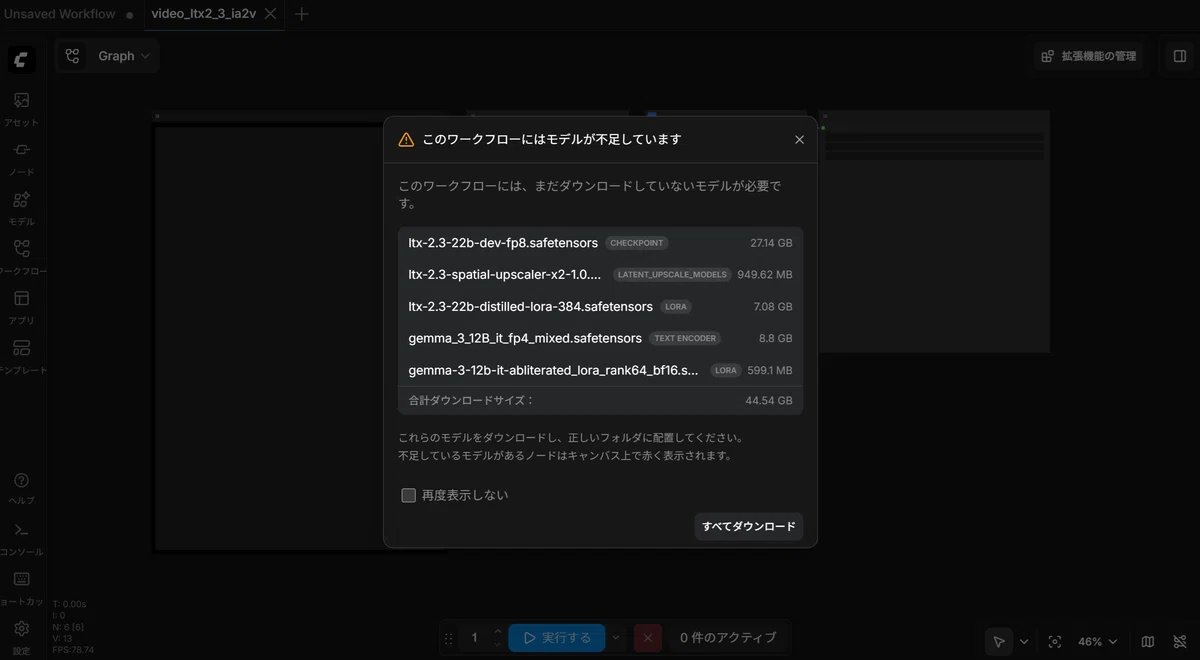
「このワークフローにはモデルが不足しています」と表示されますが、無視して「×」で閉じます。
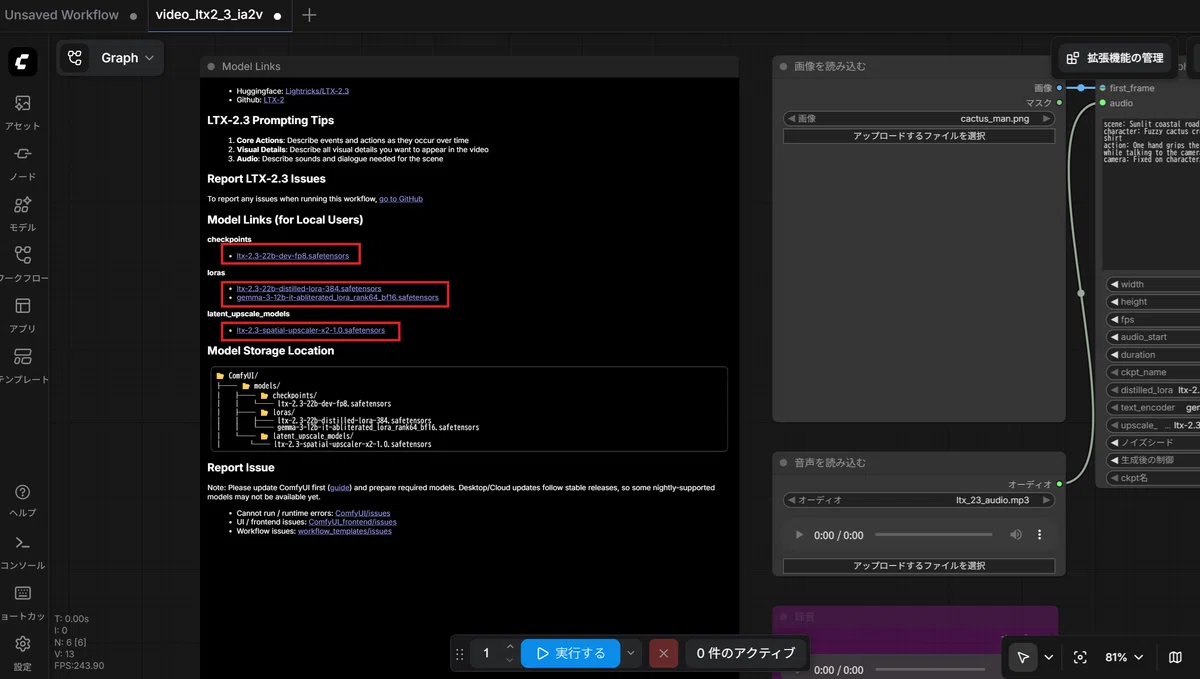
開かれたワークフローの左側に必要モデルのダウンロードリンクが4つ並んでいますので、それぞれクリックしてダウンロードします。
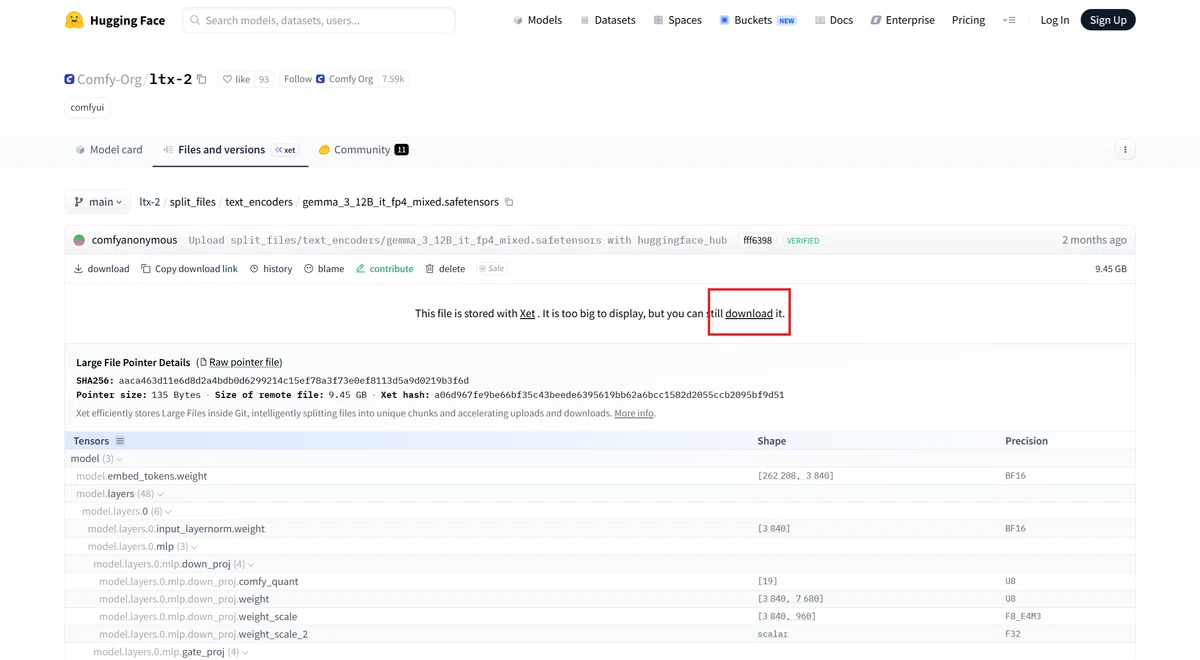
ダウンロードが完了したら、続いて、ワークフローに記載されていない不足モデルのダウンロードを行います。
「https://huggingface.co/Comfy-Org/ltx-2/blob/main/split_files/text_encoders/gemma_3_12B_it_fp4_mixed.safetensors」を開き、赤枠のリンクより「gemma_3_12B_it_fp4_mixed.safetensors」をダウンロードします。
ダウンロードしたモデルは以下の通り配置します。
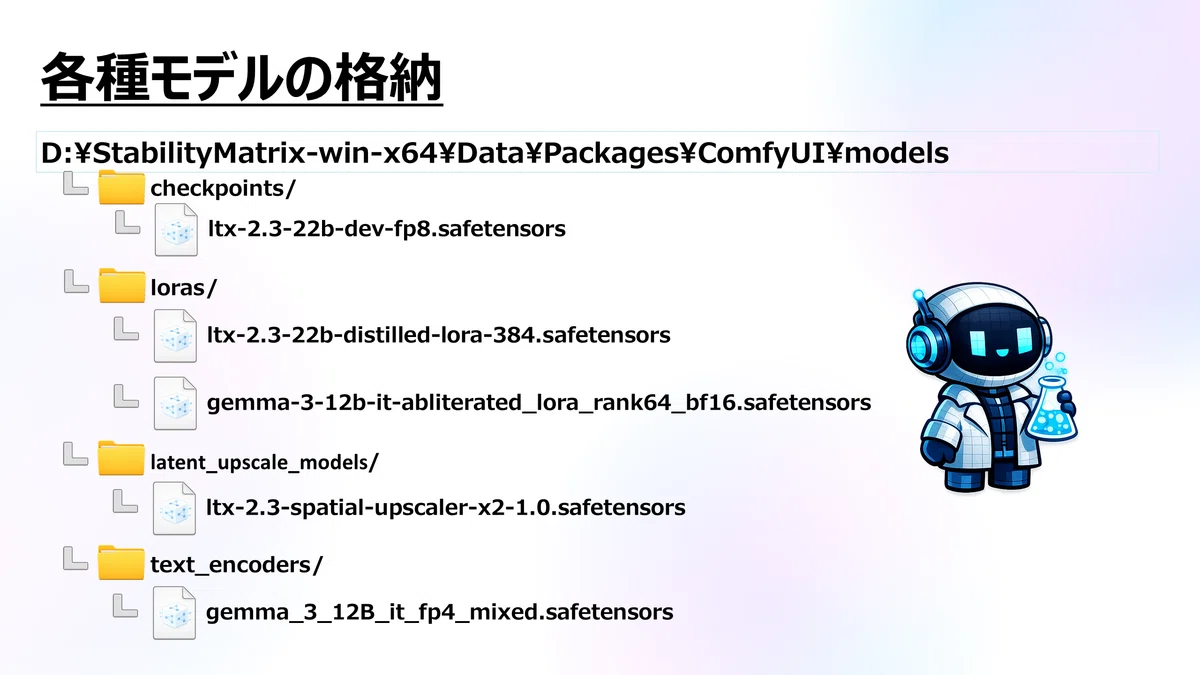
配置したらワークフロー画面でF5キーを押して画面を更新し、インストールしたモデルを反映させます。
2.2. リップシンク動画の生成
左上に開始フレームとなる静止画像を指定し、左下にリップシンクさせたい音声ファイルを指定します。
後述しますが、生成された動画のアップスケール考慮し、静止画像の解像度は960 x 540にしています。
それに伴い、赤枠のパラメータを静止画像の解像度に合わせています。
また、duration(生成される動画の秒数)が初期値の9だと短いため、14に変更しています。ただしここは注意が必要で、24fpsの設定で15秒以上の設定にすると、生成される動画が安定しませんでした(動画最後の方に変な文字が表示されたり、リップシンクされなかったり)。検証した結果14秒であれば安定した動画が生成されましたので、14秒としています。
ちなみにfpsを16にすると23まで安定した動画が生成できました。24秒にすると安定しませんでした。
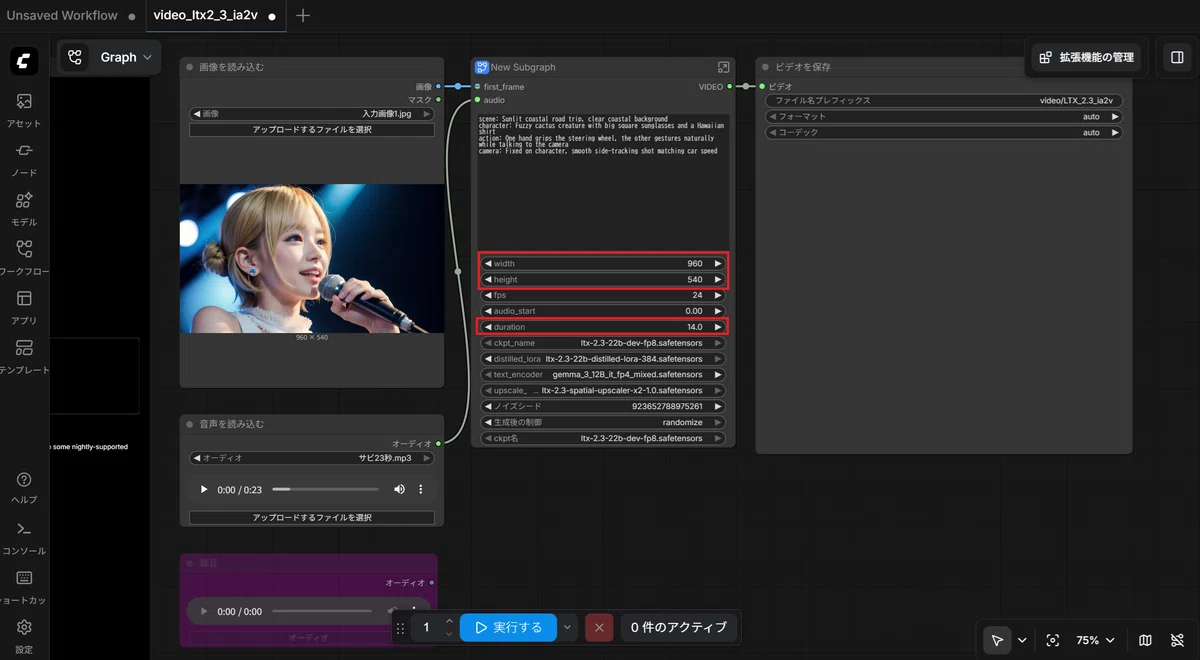
実行すると動画が生成されます。
上記ワークフローで生成した動画を視聴したい方は、こちらのYouTube動画を確認にしてください。
生成された動画の画質が少し荒い感じになっています。
アップスケールして綺麗な画質にしようと思います。
3. 動画のアップスケール
5.1. 必要モデルのインストール
「https://github.com/xinntao/Real-ESRGAN」にアクセスし、少し下にスクロールするとダウンロードリンクがありますので、そこから「RealESRGAN_x4plus.pth」をダウンロードします。
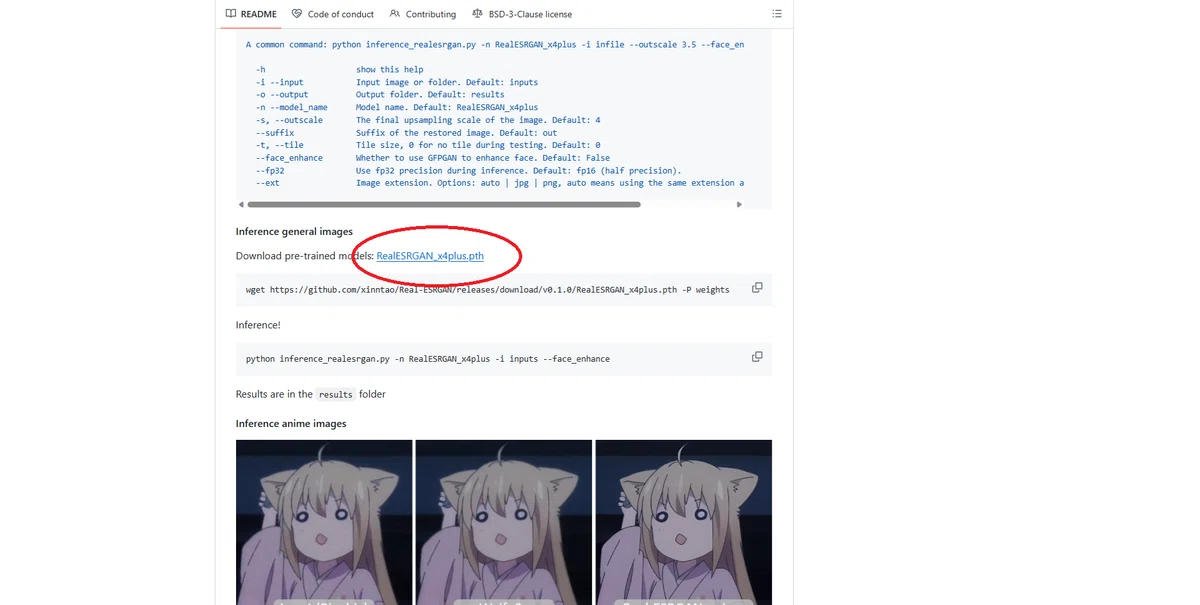
ダウンロードしたファイルは「D:\StabilityMatrix-win-x64\Data\Packages\ComfyUI\models\upscale_models」に配置します。
WebUIの画面をF5キーで更新し反映させます。
5.2. 動画のアップスケールを試してみる
ノード検索メニューを表示し、検索欄に「video upscale」と入力します。
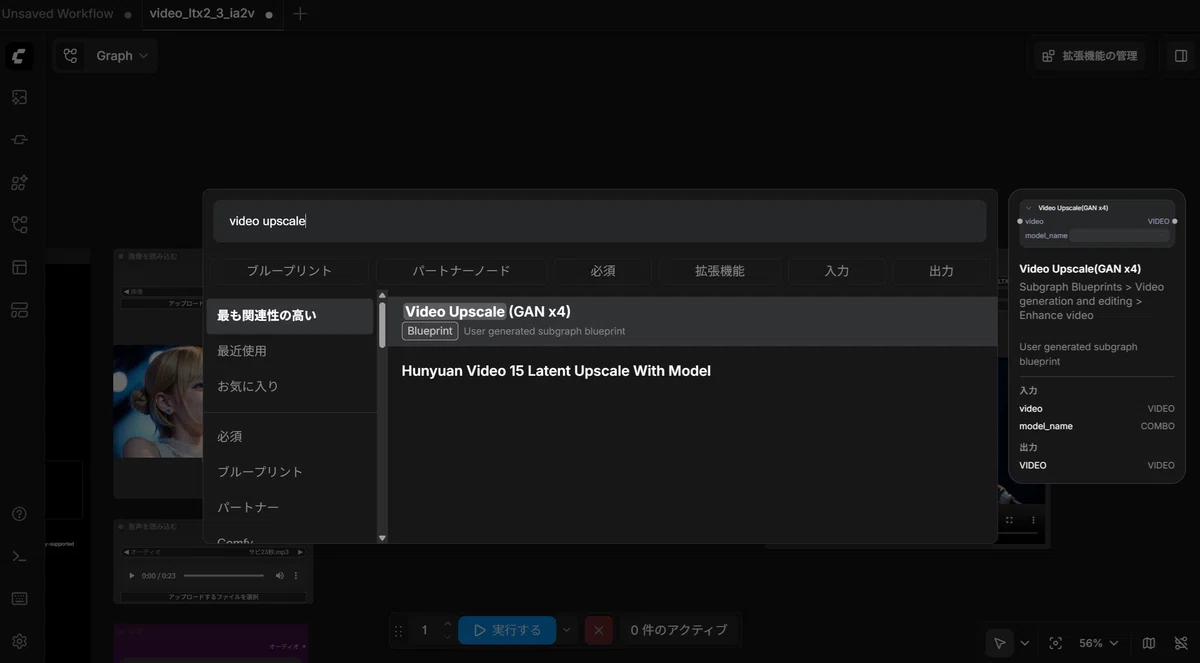
「Video Upscale (GAN x 4)」を選択し、以下の通りノードを繋ぎ変えます。
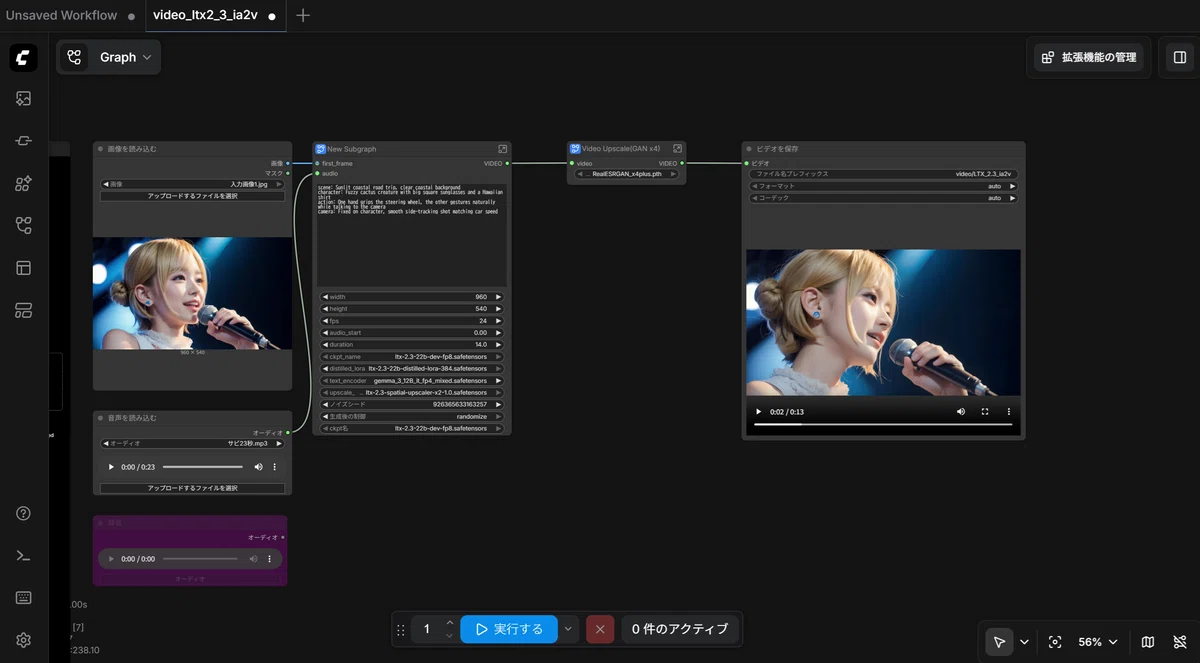
Video Upscaleノードのパラメータを「RealESRGAN_x4plus」に変更します。
実行するとアップスケールされた動画が生成されます。
上記ワークフローで生成した動画を視聴したい方は、こちらのYouTube動画を確認にしてください。
4. 補足
楽曲データ(3分程度の曲)を1枚の静止画像からリップシンクさせて最後まで歌わせようと思い、一つのワークフローで完結して生成できないか少し調べてみましたが、無理そうなので諦めました。
これをやるためには、生成された最後のフレームを最初のフレームに指定して、楽曲データも最終位置を覚えておいて「audio_start」に指定する必要があります。ただ、もし上記ができたとしても、「audio_start」を指定すると動画の生成が安定しなかったので、どちらにしろ駄目だということが分かりました。さらに、生成された動画の音声のクオリティや、入力音声に対して若干生成された音声は長さが異なっている感じがしました。おそらくパラメータで指定した長さよりも音声の方が長い場合にそうなるんだと思います。
以上、参考になればと思います。
