英語教育・英語学習に関する独り言 番外編 - TTSの性能比較
EIKEN先生 HIROKI氏の『大学受験で構文が難しいとされる英文のほとんどは音で聞いたら「意味の区切りが音に表れて」理解がしやすくなるのでは』という仮説を検証するべく、HIROKI氏より以下のテキストをシェアしてもらい、それをいくつかのTTS(Text To Speech)にかけてみた。なかなかおもしろい結果が得られたので、以下に共有する。
Margaret Mead’s assertion that war is a cultural invention that can be ‘uninvented’ if humans will it enough is reflected in the pacifist argument that over the past hundred years or so, institutions and norms have been developed to make war less acceptable or likely, even in an age that witnessed the two largest and costliest wars in world history.
自分がこのセンテンスを音読するなら
Margaret Mead’s assertion that (0.2秒の間) war (0.1秒の間) is a (エイと発音) cultural invention that can be ‘uninvented’ (0.1秒の間) if humans will it enough (0.3秒の間) is reflected in the pacifist argument (0.2秒の間) that over the past hundred years or so, institutions and norms have been developed (0.1秒の間) to make war less acceptable or likely, even in an age (0.1秒の間) that witnessed the two largest (0.1秒の間) and costliest wars (0.1秒の間) in world history.
みたいな感じだろうか(音節ごとの抑揚については省略)。
Without further ado, let's see - or rather, hear - what old and new TTS services are made of.
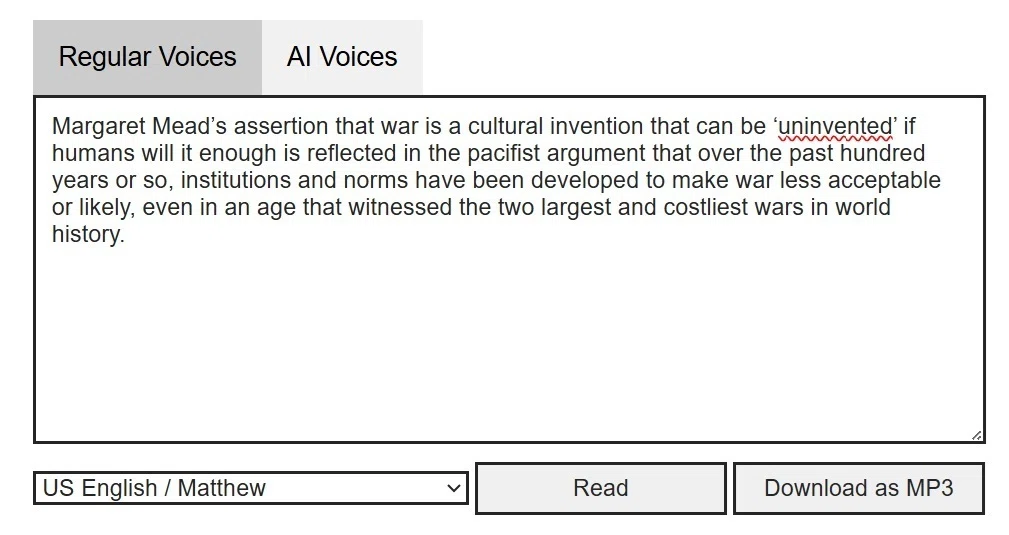
まずは10年以上前からあるTTSMP3から。音声は Matthew を選択。
出てきた音声はこちら。
はっきり言って、イマイチな出来。パンクチュエーションを表記通りにしか処理できない。まあ、かなり古い技術なのだからしゃーない。10点満点で2点。
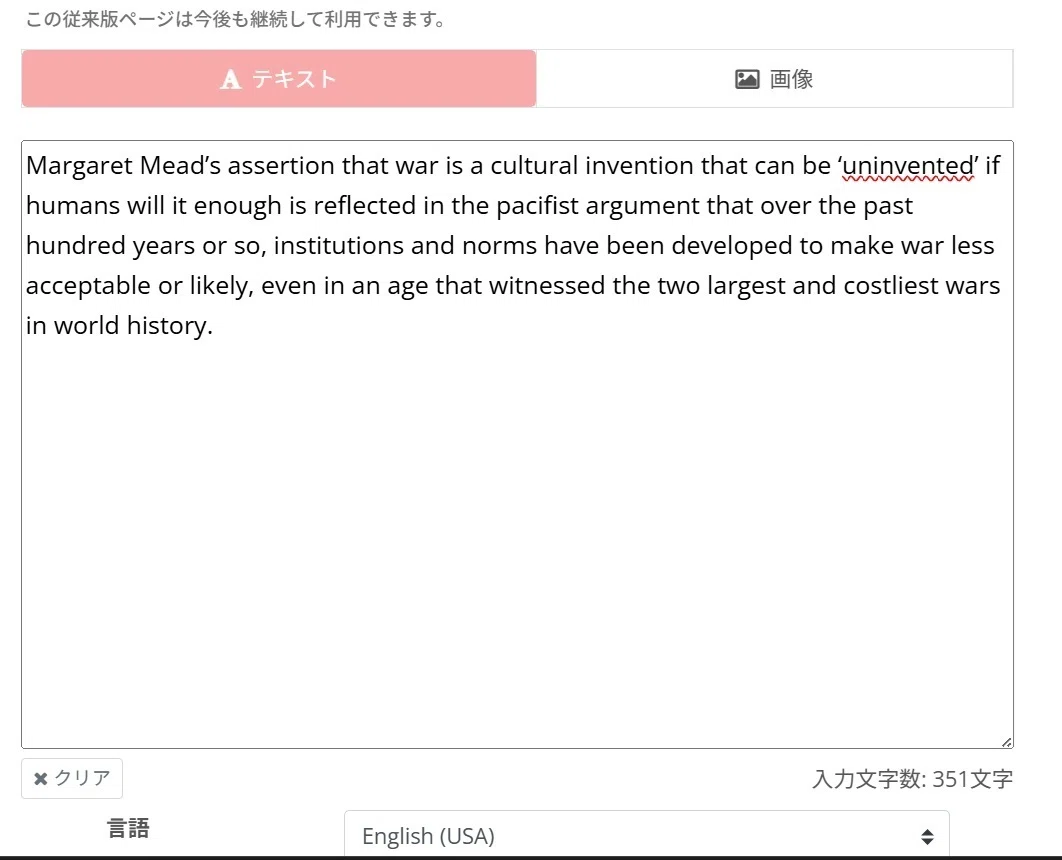
続いては音読さん。こちらもなかなかの老舗。元々は日本語サービスだが、英語も一応対応している。
出てきた音声はこちら。
決していい出来とは言えないが、悪くない仕上がり。意外にも if の前にほんの少しの間を入れられている。4点かな。
次は Speechify を試す。これもまあまあ古かったはず。記憶が正しいかどうか定かではないが、コロナ禍の前には一部の好事家の間では知られていた。VoiceはLunaを選択。
出てきた音声はこちら。
ややスローだが、悪くはない。良いわけでもないが・・・ 文節の区切りを理解しているようだが、意味のまとまりやつながりまで意識したspeech generationにはなっていないという印象。ただ開発背景が開発背景なので、これは製作者の意図通りと言えなくもない。6点といったところか。
次は Revoicer を試してみる。が、なんと原文のパンクチュエーション不足でオーディオ生成失敗・・・ 残念ながら文句なしに0点。
気を取り直して OpenAI.fm へ。今年の頭に ChatGPT の年間27,800円のプランに申し込んだが、サム・アルトマンがカネと権力にすり寄っていく様をリアルタイムに見てしまい、後悔している。それはそれとして Voice は Alloy を選択、Vibe は Calm を選択した。
出てきた音声はこちら(埋め込みのためWAVをMP3に変換した)。
素晴らしい出来栄え。'uninvented' が強調されているのはポイントが高い。普通、記号の類はTTSに何の影響も及ぼさないようにテキスト読み込み段階で除去されるものなのだが、ここでは意味をしっかりと把握した上で強勢が置かれている。また最初の war と二番目の war もその直後に短いポーズが挿入されており、これが強調されるべき主語であり目的語であるとAIは理解しているようだ。9点。
次はお待ちかねの Google AI Studio。Style Instructions(=Vibe)は Read aloud in a warm and friendly tone:を選択。
出てきた音声はこちら。
個人的にはこれが自分の音読に一番近いように感じる。これも OpenAI.fm 同様に、テキストの意味を理解しているかのように聞こえる。 have been de-VELOPED の部分が特に良い。9点。
次は最近評判が特に良い Inworld AI を試す。Voice は Alex を選択。Temperatureその他のパラメータはすべてデフォルトのものを使用した。
出てきた音声はこちら。
このアウトプットだけで評価をするのはフェアではないだろうが、業界内での評価は少々 hype 気味か。個人的には Speechify よりやや上ぐらい、という印象。7点だろうか。
最後に個人的に最も愛用している ElevenLabs を試す。音声は V3 ではなく V2 から Bella を選択。
出てきた音声はこちら。
まあまあ無難な出来。文節も、意味のまとまりもちゃんと理解できているようだ。ただ、Bella のクセなのか、それとも Stability や Style Exaggeration をもう少しいじくるべきだったか、やや抑揚に欠けるという印象。高校3年生にはこれぐらいがいいのかもしれない。やや甘めに見て8点かな。
英検、TOEIC、TOEFL、IELTSなどのリーディング素材をTTSで音声素材に作り変えるのは、適切なTTSを選択できるのなら、語学の指導者にとって有用なスキルになるだろう。もちろん適切な速度やピッチ、場合によってはタグやIPA、またMS Azure Audio Content Creationを使うぐらいのオーディオ・マニアなら SSML なども勉強したいところ。もちろん、大量のリスニングを行い、正しい音声アウトプット、あるいは自分が望む音声アウトプットのイメージをしっかり持てるようになることが望ましい。そういう意味でも、テクノロジーに頼るのではなく、テクノロジーを正しく使いこなすためのリテラシーと素の語学力の両方が重要であることは言うまでもない。
