AIコーディングのモデルを業務のIssueで比較してみた

AI事業本部公式noteアドベントカレンダー18日目🎄を担当します、
株式会社AI Shiftの木村です!
はじめに
日々の開発業務では、Cursor を使った AI コーディングがすっかり欠かせない存在になりました。 新しいモデルが登場するたびに実際に触ってみて、「なんとなくこっちの方が賢い気がする」「今回は周辺のコード理解が深いかも」と、体感ベースでモデルを評価している方も多いのではないでしょうか。
一方で、モデルの選択肢が増えるにつれて、
🤔💬 結局どのモデルが自分の業務に一番合っているのか分からない
🤔💬 モデルを切り替えて試すだけで意外と時間がかかる
🤔💬 評価が主観的になりがちで、あとから振り返りにくい
といった悩みも感じるようになりました。
既存のベンチマークとしては、HumanEval や MBPP など有名なものがいくつも存在します。 しかし、これらは新規関数の実装やアルゴリズム問題が中心で、
既存のコードベースを読む
Issue の背景を理解する
最小限の修正でテストを通す
といった、実際の業務に近いタスクをどこまで反映できているかというと、少し距離があるように感じていました。
そこで本記事では、
❶ 代表的なコード系ベンチマークにはどのようなものがあるのかを整理し
❷ その中でも特に実務に近いと感じた SWE-Bench の考え方を参考にしながら
❸ 業務リポジトリを使って、ローカル環境で複数モデルを比較する
という取り組みを紹介します。
「モデル比較をもう少し定量的にやりたい」「自分のプロジェクトに近い形で評価したい」と感じている方の参考になれば幸いです。
有名なコーディングベンチマークの比較
AIコーディングモデルを評価するためのベンチマークは、これまでにも数多く提案されてきました。 ここでは代表的なものを簡単に整理します。
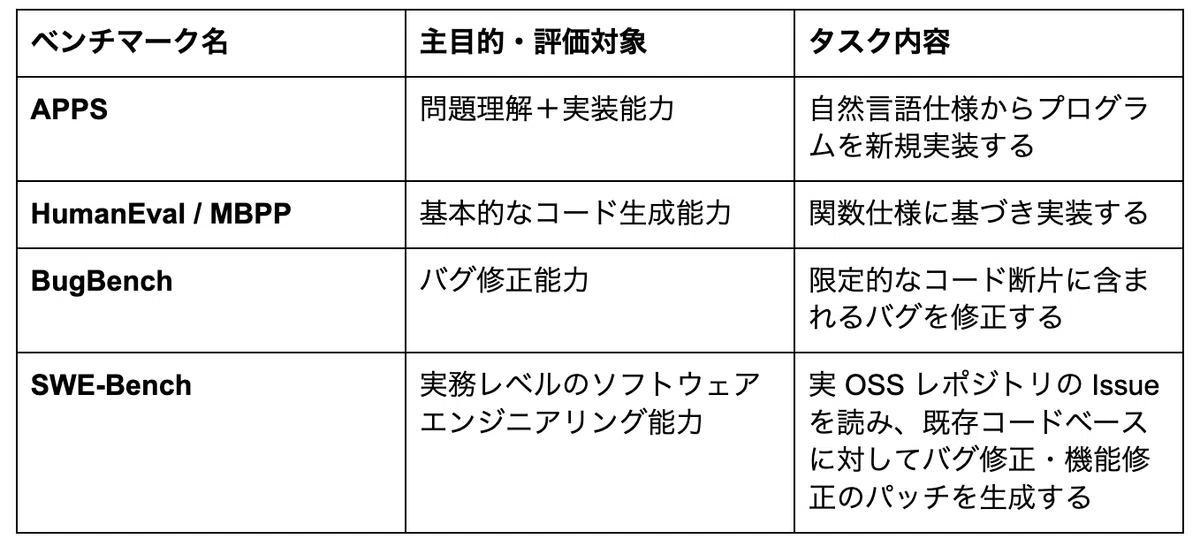
その中で SWE-Bench は、実在する Issue と既存コードを対象にしている点で、実務に近い構造を持っている と感じました。 そこで今回は、SWE-Bench の評価手法を参考にしつつ、自分たちの業務リポジトリでモデル比較を行うことにしました。
SWE-Benchとは?
SWE-Bench(Software Engineering Benchmark) は、 大規模言語モデルの 実務に近いソフトウェア開発能力を評価するためのベンチマークです。
HumanEval や MBPP が「小さな関数を正しく書けるか」を評価するのに対し、 SWE-Bench は 既存のコードベースを読み、Issue を理解し、修正してテストを通せるか という一連の流れをまとめて評価します。
実際の OSS Issue を題材に、生成した修正を適用してテストが通るかどうかで判定する点が特徴で、 実務にかなり近い形でモデルの振る舞いを見ることができます。
SWE-Bench風ローカルベンチマークのやり方
ここからは、SWE-Bench の考え方を参考にしつつ、 実務リポジトリ上で AI コーディングモデルを比較する方法を紹介します。まずは1つのIssueに対して複数のモデルでの修正を比較してみます。
< 全体像 >
~ 準備段階 ~
1.Issueの選定
2.評価用テストコードを作成(なければ)
3.Issueを解決するためのプロンプト作成
~ 実行段階~
4.修正コミットの前の状態に戻す
5.Cursorでプロンプトを実行
6.評価用テストを適用する
7.テストを実行する
Issueの選定と対象コミットの把握
過去に対応したIssueを用意して、そのIssueの解決を指示するプロンプトを作成します。業務においての難易度がわかっているので手触り感のあるモデルの評価を目指します。
また、対象のIssueに対応したコミットを探し、その直前のコミットIDを控えておきます。Cursorでプロンプトを実行するときは、そのIssueの対応前のコミットIDに戻してから実行します。
プロンプト作成
LLMに指示が上手く伝わるよう課題の背景やあるべきもプロンプトに盛り込みます。今回は以下のフォーマットで作成しました。 Cursorに対応済みのPRのリンクを貼ったうえで「このPRの対応をこの修正前の状態からLLMに対応させようとした場合のプロンプトを考えてください」という指示でプロンプトの叩きを作成してもらうと楽に作成できます。
# 課題: xxxxの場合にxxxxになる問題を解消

## 背景

## 問題の詳細

## 要件
評価用テスト
評価では「修正前では失敗し、修正後では成功するテスト」をあらかじめ用意しておくことが重要です。今回は別でテストコードを用意しておいて評価のタイミングで貼り付けて実行しました。
モデルによる修正実行
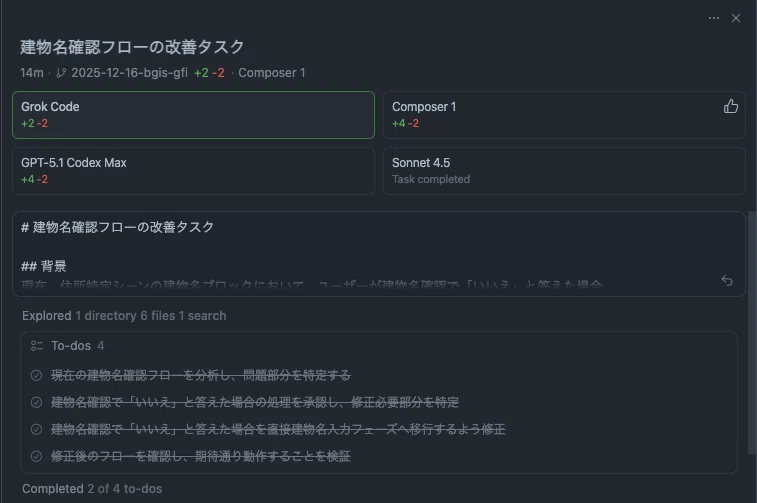
複数のモデルを同時に動かしたいのでCursor2.0から使用できるマルチエージェントモードで実行します。
評価用テスト実行
各モデルの修正結果を1つずつApplyしてテストを実行し成功/失敗を確認します。Undo replyして次のモデルの評価に移ります。
試した結果
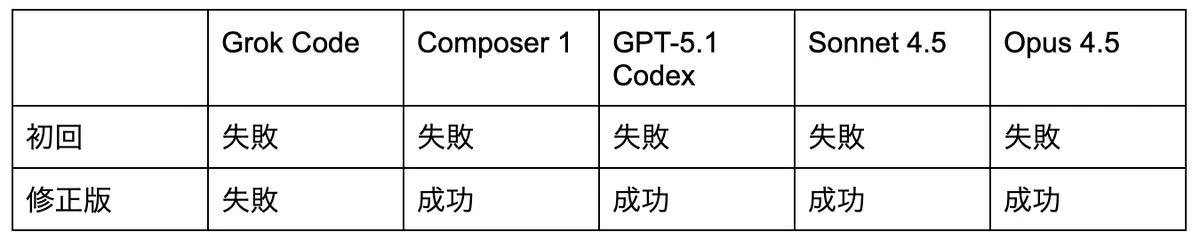
今回対象としたIssueは、複数の状態を持つロジックの中で考慮できていなかったパターンが見つかったというものです。最低でも2つのファイルを修正するため難易度はわりと高めです。
業務知識が入っているのでプロンプトはお見せできませんが、初回はプロンプトでの要件が曖昧だったため上手くいきませんでした。ある程度試行錯誤してプロンプトの指示を明確にしたところ4 / 5のモデルでテストをパスしました。
今後の展望
Issueのバリエーション
今回は1つのIssueだけを扱いましたが、難易度の異なる複数のIssueを用意しておくとモデルの評価の解像度を上げられそうです。(実際SWE-Benchでは約2,300のIssueを対象にしている)
課題に対して修正箇所が明確なIssueは最新のモデルならどれも解決できそうなので、難易度の高いIssueの準備が肝になりそうです。課題の粒度が大きかったり、依存が複雑な箇所を整合性を保ちながら修正しないといけないようなIssueです。
評価の自動化
複数のIssue x 複数のモデルとなると評価の実行が大変なので自動化したいところです。以下が自動化できそうなポイントかなと思っています。
修正のコードはgitのpatchファイルとして出力するようにプロンプトを変える
patchファイルはIssue名 x モデル名で名前を分けて保存
評価用のテストコードはmainブランチにマージしておいて、使用するときにcherry-pickで持ってくる
複数のIssue x 複数のモデル分のテストを実行できるように評価部分をスクリプト化
また、Cursorの実行部分もCloud実行する機能を使えば自動化できるかもしれません。
まとめ
今回は1件だけでしたが、対象のIssueの内容を理解しているため手触り感のあるモデル評価ができそうだと感じました。新しいモデルがでたら即評価できるようにして、モデル選びで迷う時間を削減していければと思います。
今回の記事を読んでおもしろいなと思ってくださった方はいいねを頂けますと励みになります!
明日の記事もお楽しみに!!!!
ぜひフォローをよろしくお願いいたします🌲🎅
