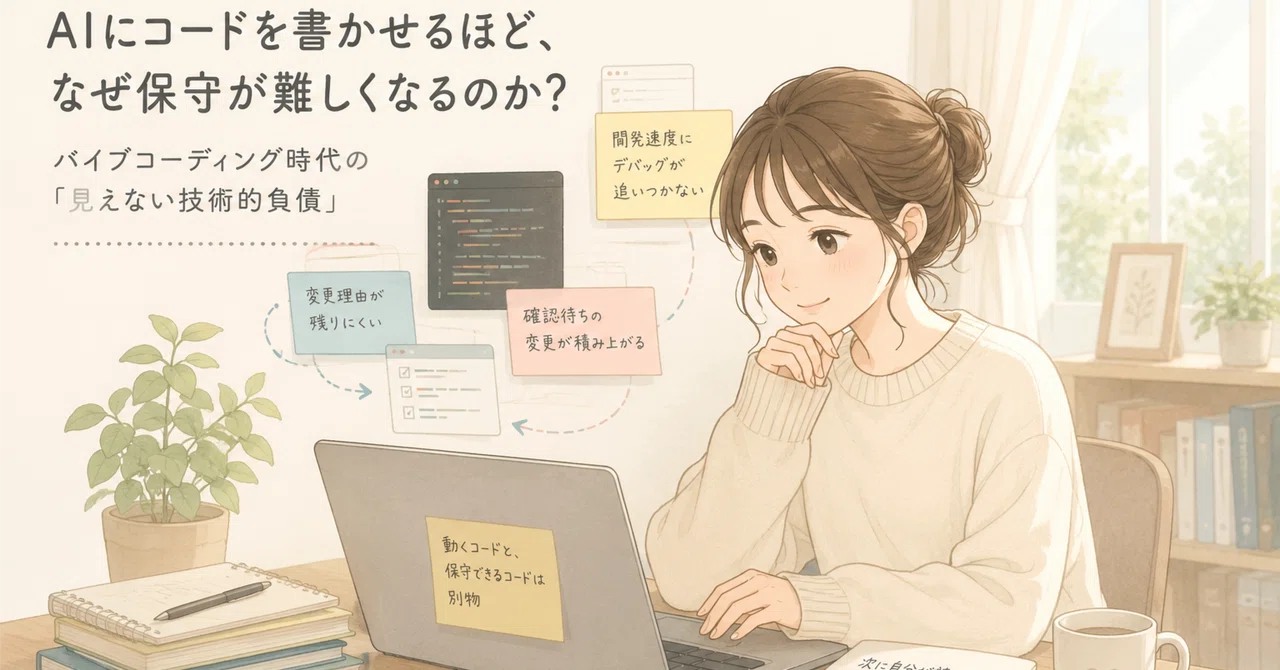
AIにコードを書かせるほど、なぜ保守が難しくなるのか?バイブコーディング時代の「見えない技術的負債」

こんにちは!高橋です。
最近、AntigravityやCursor、Claude CodeなどのAIコーディングツールを使っていると、
本当に一人で開発しているのだろうか?
と思うことがあります。
「この画面に検索機能を追加してください」
「CSVで出力できるようにしてください」
「このエラーの原因を調べて修正してください」
以前なら数時間かかっていた作業でも、AIへ依頼すると数分から数十分で完成してしまいます。
しかも最近のAIは、コードを提案するだけではありません。
関連ファイルを調べ、複数のファイルを変更し、コマンドを実行し、テストまで行ってくれます。
一人で開発しているはずなのに、数人分、場合によっては数十人分の実装速度が出てしまう。
非常に便利ですよね!
しかし、しばらく使い続けていると、少し不思議なことが起こります。
コードを書く速度は大幅に上がったはずなのに、なぜか開発全体はそれほど楽になっていないのです。
むしろ、機能を追加するほど、
このコード、どういう仕組みだったっけ?
と感じる場面が増えてきました。
今回は、AIコーディングによって増える、
「見えない技術的負債」
について考えてみたいと思います (*'▽')れっつごー!!
最後にオマケ付きです(小声
AIはコードを速く書けても、人間の理解までは速くしてくれない
これまでの開発では、コードを書くこと自体に時間がかかっていました。
仕様を確認し、関連ファイルを探し、実装方法を考え、エラーを直す。
一見すると非効率な作業ですが、開発者はその過程でシステムの仕組みを理解していました。
自分で関数を書けば、なぜその関数が必要なのか分かります。
自分でエラーを直せば、どのような条件で問題が起きるのかも覚えています。
つまり、コードを書いていた時間は、同時に、
頭の中へシステムの地図を作る時間
でもあったわけです。
ところが、AIコーディングでは、コードが作られる速度と、人間が理解する速度が分離します。
たとえば、AIに次のように依頼したとします。
商品一覧に、商品名・価格・公開状態で絞り込める検索機能を追加してください。
AIは関連ファイルを探し、入力欄を作り、検索条件を追加します。
実際に動かしてみると、問題なく検索できます。
ここで、
動いた!完成!
と次の作業へ進みたくなります。
しかし、内部では次のようなことが起きているかもしれません。
既存の検索処理とは違う書き方になっている
同じ条件判定が複数の場所へ重複している
データベースへ負荷がかかりやすい検索になっている
権限による表示制御が崩れている
将来の仕様変更で複数箇所を修正しなければならない
画面上では正常に動いているため、すぐには問題になりません。
そして数か月後、新しい検索条件を追加しようとしたときに、
どこを変更すればいいんだ……?
となります ( ;∀;)
実装時に省略した「理解する時間」を、将来になって利息付きで支払う。
これが、AI時代に増え始めている技術的負債です。
研究でも見え始めた「速さの後に残る複雑さ」
2026年に公開された研究では、AI対応IDEやコーディングエージェントを導入したオープンソースプロジェクトについて、開発速度とコード品質の変化が分析されています。
その結果、AI導入後に短期的な開発速度の向上が見られた一方で、静的解析の警告が約18%、認知的複雑度が約39%増加したと報告されています。
認知的複雑度とは、簡単に言えば、
人間がそのコードを理解するのに、どの程度の負担がかかるか
を表す指標です。
もちろん、これは特定のオープンソースプロジェクトを分析した研究です。
AIを使えば、すべてのプロジェクトで必ず複雑度が39%増えるという意味ではありません。
使い方やレビュー体制、テスト環境によっても結果は変わるでしょう。
それでも、
AIによって増えたコードを、人間側は本当に確認できているのか?
という問いは、かなり重要だと思います。
AIが一日に書けるコード量は急激に増えました。
しかし、人間が一日に深く理解できるコード量は、昨日から急に10倍にはなりません。
ここに、大きな速度差が生まれています。
「動くコード」と「保守できるコード」は別物
ソフトウェア開発では、まず正常に動くことが重要です。
ボタンを押せる。
データを保存できる。
検索結果が表示される。
メールが送信される。
しかし、ソフトウェアは一度完成したら終わりではありません。
利用者から新しい要望が届きます。
外部サービスの仕様が変わります。
ライブラリの更新や、脆弱性への対応も必要になります。
つまり、ソフトウェアには、
今日動くこと
だけでなく、
明日、安全に変更できること
も求められます。
同じように正常動作している二つのコードがあったとしても、
なぜこの実装になったのか説明できる
影響範囲が分かる
テストが用意されている
失敗した場合に元へ戻せる
コードと、
なぜ動いているのか分からない
どこまで変更してよいか分からない
AIへ聞かなければ誰も説明できない
コードでは、保守性がまったく違います。
利用者から見れば、どちらも同じように動いています。
しかし、開発者から見ると、後者は触ること自体がリスクです。
AI生成コードでは「なぜそうしたのか」が消えやすい
AIが生成したコードで特に失われやすいのが、
変更した理由
です。
コードを読めば、「何をしているか」は分かるかもしれません。
しかし、
なぜ、この方法にしたのか?
までは分からないことがあります。
たとえば、次のような待機処理があったとします。
await new Promise(resolve => setTimeout(resolve, 300));
一見すると、不要な処理に見えます。
しかし、実際には外部サービス側の反映を待つために追加されているのかもしれません。
アクセスが集中したときだけ発生する不具合を避けている可能性もあります。
その理由が記録されていなければ、後から別のAIが、
不要な待機処理なので削除しました。
と整理してしまうかもしれません。
通常の動作確認では問題が起きず、本番環境の特定条件でだけ不具合が再発する。
このようなことは十分に考えられます。
AIはコードを生成できますが、そのとき検討した別案や、採用しなかった理由まで自動的に残してくれるとは限りません。
その結果、
コードは存在する
動作もしている
しかし、理由を誰も知らない
という状態が生まれます。
コメントを「将来のAIへの設計記憶」にできないか?
ここで、ひとつ有効そうな方法があります。
AIへ実装を依頼するときに、
機能の説明だけではなく、なぜこの実装方法を選んだのかもコメントとして残してください。
と依頼する方法です。
たとえば、次のようなコメントです。
// 外部サービスから同じイベントが再送されることがあるため、
// event_idを使って二重登録を防止している。
// メールアドレスは変更される可能性があるため判定には使わない。
// この処理を変更する場合は、再送時の挙動も確認すること。
次回、別の機能追加や修正をAIへ依頼したとき、AIがこのコメントを読めれば、
ここは単なる重複チェックではなく、外部サービスの再送対策なのか。
では、メールアドレスを基準に変更してはいけない。
新しい処理でもevent_idを前提にした方がよい。
と判断できる可能性が高くなります。
つまり、コメントは人間向けの説明だけではありません。
将来のAIが過去の設計判断を引き継ぐための記憶
としても使えるのではないかと思います。
これはかなり合理的な方法です。
人間側も、数か月後にコードを見たとき、
そうか。この処理にはこういう理由があったのか。
と理解できます。
AI側も、単に現在のコードだけを見るのではなく、実装の背景や制約を踏まえて次の変更を考えられます。
うまく運用できれば、
AIが既存設計を壊しにくくなる
人間も後から理解しやすくなる
実装の一貫性を保ちやすくなる
一見不要に見える処理を誤って削除しにくくなる
過去の判断を次の実装へ引き継げる
という効果が期待できます。
ただし、コメントを書けば必ず安全になるわけではない
この方法は有効ですが、万能ではありません。
まず、AIがそのコメントを読まなければ意味がありません。
関連ファイルを十分に調べず、別の場所だけを変更する可能性もあります。
そのため、実装を依頼するときには、
実装前に関連ファイルと既存コメントを確認し、現在の設計理由や制約を維持してください。
と明示した方がよいでしょう。
また、コメントが古くなる問題もあります。
コードを変更したのにコメントだけが以前のままだと、今度はコメント自体が誤情報になります。
AIは古いコメントを正しい前提として、さらに誤った実装をするかもしれません。
そのため、
実装変更に伴って内容が変わる場合は、関連コメントも更新してください。
という指示も必要です。
そして、すべての処理へ大量のコメントを書くと、今度は重要な情報が埋もれてしまいます。
コメントへ残すべきなのは、コードを見れば分かる内容ではありません。
たとえば、
// ユーザーを取得する
$user = User::find($id);
というコメントは、コードを見れば分かります。
一方で、
// 外部サービスから同じ通知が再送される場合があるため、
// event_idで処理済みか判定する。
// メールアドレスは変更されるため一意判定には使用しない。
というコメントには価値があります。
重要なのは、
なぜこの方法を選んだのか
どのような不具合を防いでいるのか
採用しなかった方法は何か
変更するときに何へ注意すべきか
業務やセキュリティ上の制約は何か
といった、コードだけでは分からない情報を残すことです。
コメント・設計文書・テストの3層で残す
ただし、コード内のコメントだけで、システム全体の設計を伝えることは難しいです。
個別の処理に固有の理由はコメントへ書けます。
しかし、
認証処理の全体像
データの流れ
各レイヤーの役割
禁止している実装方法
外部API連携の共通方針
といった内容は、別の設計文書へまとめた方が分かりやすいでしょう。
私は、次の3層で記録するのが合理的だと思います。
1.コード内コメント
その場所に固有の理由を書きます。
// 同じ通知が再送される可能性があるため、
// event_idで処理済みか判定する。
2.設計文書
プロジェクト全体で守る方針を書きます。
## 外部イベント処理の方針

- 外部イベントは再送される前提で実装する
- 重複判定にはevent_idを使用する
- メールアドレスなど変更可能な値は一意判定に使用しない
- 処理途中で失敗した場合は再実行できるようにする
README.mdやAGENTS.md、docs/architecture.mdなどへ保存しておけば、AIが次の実装時に参照できます。
3.テスト
コメントや設計文書には、理由や方針を伝える役割があります。
しかし、ルールを強制することはできません。
そこで、テストを組み合わせます。
たとえば、
同じイベントが再送されても二重登録しない
というテストを用意しておけば、AIが誤って重複防止処理を削除したときに検知できます。
役割を分けると、次のようになります。
コメント:なぜそうしているのか
設計文書:全体としてどうすべきか
テスト:壊していないか
静的解析:ルール違反がないか
人間:その判断が本当に妥当か
コメントだけへ安全性を依存するより、かなり強固になります。
AI開発のボトルネックは「実装」から「確認」へ移った
AIを使う前、開発のボトルネックは主に実装でした。
コードを書くために、多くの時間が必要だったからです。
しかし、AIによって実装速度が上がると、ボトルネックは次の工程へ移ります。
仕様どおりに作られているか
既存機能へ影響しないか
セキュリティ上の問題はないか
異常時にも正しく動くか
将来変更しやすい構造になっているか
本番環境へ反映しても大丈夫か
たとえるなら、工場の製造機械だけを10倍速くした状態です。
製品は次々と完成します。
しかし、検品を担当する人は以前と同じ人数です。
当然、検品待ちの製品が積み上がります。
そこで検品を省略すれば、一時的な出荷量は増えます。
しかし、不良品が利用者へ届く確率も高くなります。
AIコーディングでも同じです。
実装速度だけを上げても、レビュー、テスト、監視、記録の能力が追いつかなければ、
「確認待ちの変更」
が増えていきます。
しかも、本当に厄介なのは、
正常に動いているけれど、誰も中身を理解していないコード
です。
正常に動くため、負債になっていること自体に気づきにくいのです。
では、どう対策すればよいのか?
理想を言えば、AIが生成したコードをすべて人間が完全に理解すればよいでしょう。
しかし、それではAIを使って開発速度を上げた意味が薄れてしまいます。
また、現代のソフトウェアはフレームワークや外部ライブラリを大量に利用しているため、そもそも一人ですべてを理解するのは現実的ではありません。
必要なのは、
すべてを同じ深さで理解することではなく、理解すべき場所を決めること
だと思います。
ここからは、現実的だと感じている対策をまとめます。
対策1:実装前に、まず「変更計画」を出させる
AIへいきなり、
実装してください。
と依頼すると、人間は完成した大量の差分を見ることになります。
そこで、先に次のように依頼します。
まだコードは変更しないでください。
関連ファイルを調査し、現在の処理、変更予定箇所、影響範囲、考えられるリスク、テスト方法を説明してください。
この段階で確認すれば、
変更範囲が広すぎないか
既存の仕組みを再利用できないか
本来触る必要のないファイルまで変更しようとしていないか
権限やデータベースへ影響しないか
を判断できます。
完成後に500行の差分を確認するより、実装前に10行の計画を確認する方が簡単です。
家が完成してから間取りを見るのではなく、先に設計図を見るようなものですね!
対策2:AIの能力ではなく、人間が確認できる大きさで分割する
AIは大きな依頼でも、一度に実装できます。
管理画面を作って、検索・編集・削除・CSV出力・通知機能まで追加してください。
これでも、おそらく大量のコードを生成してくれるでしょう。
しかし、変更量が大きくなるほど、人間の理解は追いつきにくくなります。
そこで、
一覧画面を作る
検索機能を追加する
編集機能を追加する
削除機能を追加する
CSV出力を追加する
通知機能を追加する
というように分けます。
AIが一度に1000行書けたとしても、人間が安全に確認できるのが200行なら、200行ずつ進める。
作業単位は、AIの生成能力ではなく、
人間の検証能力
に合わせるべきだと思います。
対策3:変更内容をリスクで分類する
文章の修正と、認証処理の変更を、同じ深さでレビューする必要はありません。
たとえば、
比較的リスクが低い変更
文言修正
色や余白の調整
単純な表示変更
管理画面の補助表示
慎重に確認すべき変更
データの登録・更新・削除
外部APIとの連携
通知処理
バッチ処理
CSVの入出力
人間が仕組みを理解すべき変更
認証
権限管理
個人情報
決済
データベース移行
バックアップと復元
本番環境の設定
というように分けられます。
重要なのは、変更行数ではなく、
失敗したときの影響
でレビューの深さを変えることです。
対策4:「何をしたか」ではなく「なぜしたか」を残す
AI時代には、コードコメントやコミットメッセージの役割も変わると思います。
単に、
検索機能を修正
と書くよりも、
外部サービスから同一イベントが再送される場合があるため、event_idによる重複防止を追加。メールアドレスは変更される可能性があるため一意判定には使用しない。
と残した方が、将来の人間にもAIにも伝わります。
実装時には、AIへ次のように依頼できます。
実装前に関連する既存コード、コメント、設計文書を確認してください。
実装後は、機能の内容だけでなく、なぜこの実装方法を選んだのか、採用しなかった方法、変更時の注意点も記録してください。
コードを読めば分かる説明ではなく、コードだけでは分からない判断理由を残してください。
次回の変更時には、
既存コメントと設計文書を確認し、記載されている実装理由や制約を壊さないように変更してください。
既存方針と矛盾する場合は、実装前に報告してください。
と依頼します。
AIにコードを書かせるだけでなく、判断の経緯も一緒に保存させるわけです。
対策5:実装AIとレビューAIを分ける
同じAIへコードを書かせ、その直後に、
問題ありませんか?
と質問すると、自分が採用した前提を引き継いだままレビューする可能性があります。
人間でも、自分が書いた文章の誤字には気づきにくいですよね。
そこで、
実装を担当するAI
コードレビューを担当するAI
テストを考えるAI
セキュリティを確認するAI
を分けます。
必ずしも別のサービスやモデルを使う必要はありません。
新しいチャットを開き、仕様と差分だけを渡して確認させるだけでも、違う視点が得られます。
たとえば、レビュー側には次のように依頼できます。
実装者の方針を擁護せず、不具合、セキュリティ、重複処理、保守性、既存機能への影響という観点から問題を探してください。
問題が見つからない場合も、確認できていない前提を挙げてください。
同じAIを「万能な一人」として使うのではなく、
複数の役割を持つチーム
として使うわけです。
対策6:テストを「理解の記録」として残す
AIへ実装コードを見せて、
このコードのテストを書いてください。
と依頼すると、実装と同じ間違いを正解としてテストする可能性があります。
本来は管理者だけが実行できる処理なのに、一般利用者でも実行できるコードになっていたとします。
AIがそのコードを基準にテストを書けば、
一般利用者でも正常に実行できる
ことを確認するテストを作ってしまうかもしれません。
テストはコードではなく、仕様やリスクから考える必要があります。
正常に動くか
不正な入力を拒否するか
権限がない場合は失敗するか
二重実行されても問題ないか
外部サービスが停止した場合はどうなるか
途中で失敗した場合にデータが壊れないか
良いテストは、不具合を見つけるだけではありません。
このシステムでは、何を正しい挙動と考えているのか
を記録する仕様書にもなります。
コメントが理由を残し、テストがその理由に基づく挙動を守る。
この組み合わせが重要です。
対策7:静的解析やCIをAIへのガードレールにする
毎回AIへ、
複雑な関数を書かないでください。
型エラーを出さないでください。
テストも実行してください。
とお願いするだけでは、見落とされる可能性があります。
そこで、守るべきルールを自動化します。
コードフォーマッター
Linter
型チェック
静的解析
単体テスト
脆弱性検査
シークレット検出
複雑度の計測
テストカバレッジ
これらをCIで実行し、問題があれば統合できないようにします。
AIは柔軟に考えることが得意です。
一方、静的解析やテストは、決められた条件を機械的に確認することが得意です。
AIだけに品質を任せるのではなく、
AIが生成する
↓
ツールが検査する
↓
AIが修正する
↓
人間が判断する
という流れを作ることが重要だと思います。
対策8:「何を理解していないか」を把握する
すべてを完全に理解することは難しいです。
しかし、
何を理解できていないのか分からない
状態は危険です。
たとえば、
利用しているライブラリ内部の細かな実装は把握していない。
ただし、入力・出力・失敗条件・タイムアウト時の動作は確認している。
という状態であれば、ある程度管理できます。
一方で、
AIが作って動いているので、たぶん大丈夫です。
では、何か起きたときに対応できません。
未知があること自体よりも、
未知であることに気づいていない状態
の方が危険です。
AIを使わないことが答えではない
ここまで読むと、
それならAIにコードを書かせない方がよいのでは?
と思われるかもしれません。
しかし、私はそうは思いません。
AIによって、一人や小規模な組織でも、以前なら大人数が必要だった開発へ挑戦できるようになりました。
調査、試作、テスト作成、既存コードの解析、ドキュメント作成など、AIが活躍できる場面は非常に多くあります。
問題は、AIがコードを書くことではありません。
実装速度だけが10倍になったのに、開発工程を以前のままにしていること
です。
コード生成が速くなったのであれば、レビュー、テスト、監視、記録の方法も変えなければなりません。
そして今後は、コードだけでなく、
なぜこの実装にしたのか
何を防ぐための処理なのか
どの制約を守る必要があるのか
変更するときに何へ注意すべきか
といった判断理由も、AIと一緒に残していく必要があります。
AIコーディングの導入は、新しいエディタを入れるだけではなく、
開発工程と、設計知識の残し方そのものを作り直すこと
なのかもしれません。
まとめ:正常に動いていても、負債になる
これまで技術的負債というと、
複雑な条件分岐
重複した処理
古いライブラリ
テストの不足
場当たり的な修正
といった、読みにくいコードを想像することが多かったと思います。
もちろん、これらは今後も技術的負債です。
しかし、AI時代には、コードがきれいで、テストが通り、正常に動いていたとしても、別の負債が生まれます。
誰も、なぜその実装になったのか説明できない。
誰も、どこまで変更してよいか分からない。
誰も、失敗した場合の影響を把握していない。
AIへ聞かなければ、そのシステムを操作できない。
このような状態では、コードの見た目が整っていたとしても、安全に保守できるとは言えません。
AI時代の技術的負債とは、汚いコードだけではない。
「人間が理解していない正常動作コード」そのものが負債になる。
だからこそ、これから重要になるのは、
どれだけ速くコードを書けたか
だけではありません。
どこまで検証したか
何を理解しているか
なぜその方法を選んだのか
その判断理由が残っているか
失敗したときに戻せるか
将来、安全に変更できるか
まで含めて、開発の成果を考える必要があります。
AIによって実装時間が短くなったからといって、その時間をすべて次の機能開発に使ってしまうのではなく、
理解・検証・テスト・記録へ振り分ける。
そしてコメントや設計文書を、単なる人間向けの説明ではなく、
人間とAIの両方が過去の設計判断を引き継ぐための記憶
として活用する。
今後は、このような仕組みを作れるかどうかが、ソフトウェアの品質を大きく左右するのではないでしょうか。
AIにコードを書かせることは、どんどん簡単になっています。
しかし、AIが書いたコードに対して、人間が理解と責任を持ち続けること。
そして、次のAIへ正しい判断理由を引き継ぐこと。
これから本当に難しくなるのは、こちらなのかもしれません。
それでは今回はここまで (*'▽')ノシ
=========== き り と り ===========
今回の内容を守ってくれるようにAntigravityなどにお願いするなら以下のPDFに記載された内容のようになるかと思います。
使って頂けると嬉しいです♪
いいなと思ったら応援しよう!
 よろしければ応援お願いします!
