Claude透かし除去ツールの実際〜三層のうち効くのは一層〜

剥がせたことも証明できない
Anthropicが透かしの発表をした翌日、GitHubに剥がすためのツールが出た。
リポジトリの作成は8月11日16時32分38秒(UTC)。最古のコミットに付いたメッセージは「Initial skill: remove Claude text marks and C2PA metadata」。作者はGuillaume Meyer氏、Memoの創業者。MITライセンス。
伸び方が異様だった。8月13日に4,102スター。17日には11,700から11,800、その後12,300を超えた。作成から6日である。「11k stars in 5 days」という見出しが英語圏を回り、そこに「Anthropicのプロヴェナンスを打ち破った」という一句が続いた。
何が破られたのかを確かめる手段は、まだ誰も持っていない。
ツールは三層に分かれている
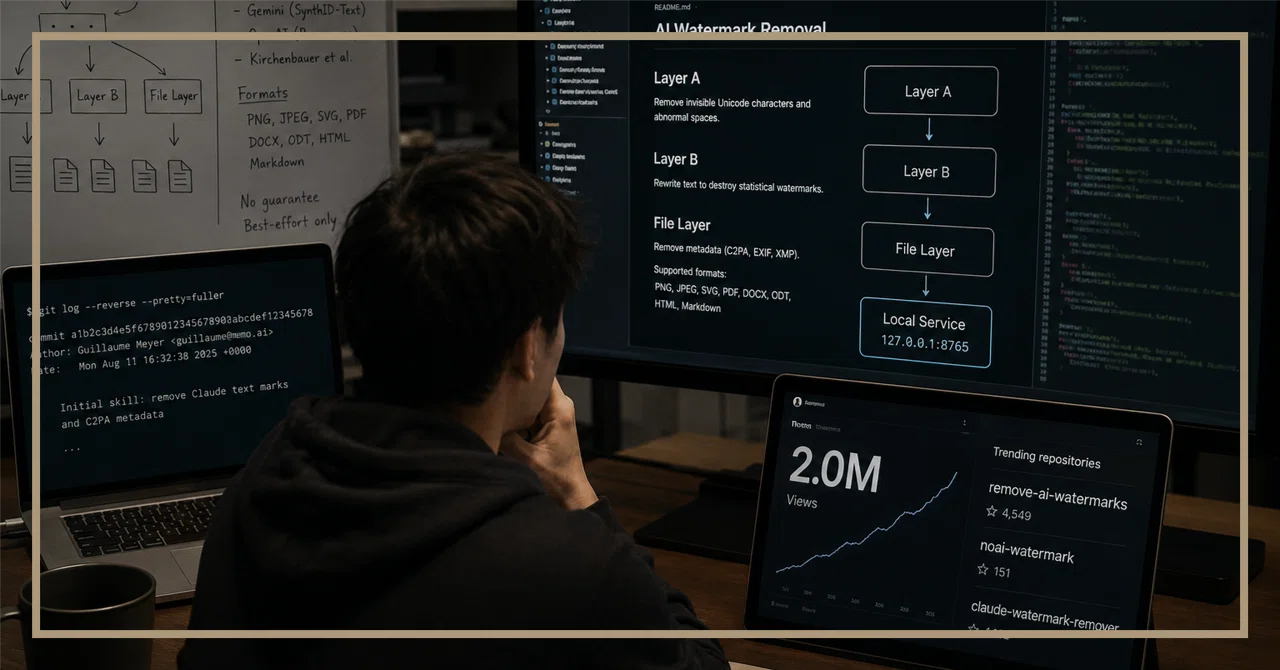
READMEの構成が層で書かれている。Layer Aが不可視Unicodeや異常な空白の除去。Layer Bが書き換えによる統計的透かしの破壊。ファイル層がC2PA、EXIF、XMPといったメタデータの削除。対応形式はPNG、JPEG、SVG、PDF、DOCX、ODT、HTML、Markdown。
対象として名前が挙がっているのは、Claude、GeminiのSynthID-Text、OpenAIのプロヴェナンス面、Kirchenbauer系のオープンLLM透かし。
構成として目を引くのは、スキル本体がコードを持たないことだ。マークダウンだけをインストールし、別に立てたサービスをHTTP経由で呼ぶ。既定のポートは127.0.0.1:8765。GrokやCursorのスキルとして登録して、スラッシュコマンドで呼び出せる。手作業でツールを走らせるのではなく、エージェントに指示を出す流れの中に組み込まれる。「AI透かしを剥がして」と頼めば処理が走る形になっている。
Layer Aは空振りしている
前稿で確認したとおり、Claudeの透かしは文字を足さない。Anthropic自身が、文字を追加するわけでも隠し文字を入れるわけでもないと書いている。信号が宿るのは語の選択そのものだ。
だからLayer Aが掃除している不可視Unicodeや特殊な空白は、Claudeの透かしとは無関係になる。ツール側のREADMEも、統計的マークは語の選択そのものに宿ると認めている。
背景には、ChatGPTの出力に混じる文字を「AIの痕跡」と呼ぶ説明が一時期流通した経緯がある。ゼロ幅スペース、ゼロ幅ノンジョイナー、通常の半角スペースではないナローノーブレークスペース。あるいはハイフンではなくemダッシュが多用されるという癖。文書に貼り付けると見た目は同じなのに、検索や差分では引っかかる。実際にはトークナイザや整形の副産物で、識別のために埋め込まれたものではない。
既にあった掃除処理を、今回の発表に合わせて束ね直したように見える。リポジトリの旧名がremove-claude-marksで、後から汎用名へ移行しているのも、その順序と噛み合う。
効くのはLayer Bだけだ。語の並びを変えれば信号の担体が消えるという、前稿で書いた原理そのままの処理になる。ファイル層のメタデータ削除は確実に効くが、これは再保存やスクリーンショットでも落ちる領域で、Anthropic自身が限界として列挙している。
検証できない層が一つある
検証可能なのはメタデータ除去と不可視Unicode除去だけ。Claudeの隠しテキストマークに対する主張は検証不能。Anthropicが公開検出器も技術仕様も出していないため、書き換えがマークを破ったことを誰も確認できない。
READMEは率直だ。ベンダーの検出器が失敗することを証明できない、と書いてある。
つまり効いたとも効かなかったとも言えない。
ここから先は

とある地方都市の某外科医のひとり言
とある地方都市の某外科医と申します。 ほぼ毎日の投稿に合わせて、医療関係以外の入会月以降の有料記事が読める定期購読マガジンです。
よろしければ応援お願いします!チップはnote更新用のPC購入費用に当てる予定です。よろしく!
