
User SimulationによるAIエージェント評価革新―静的ベンチマークから、ユーザー模倣による実践的評価へ

*技術トレンド*
生成AIの実用化が進む中、従来の静的ベンチマークでは測れない対話品質やユーザー体験を評価する手法として、User Simulationが注目を集めている。
■ 背景:静的ベンチマークの限界と実用化の壁
生成AIの急速な普及により、企業や研究機関では「AIをどのように正しく評価し、信頼できる形で運用するか」が重要なテーマとなっている。従来、AI評価にはMMLU、BIG-Benchなどの静的ベンチマークが広く使われてきたが、これらは固定化された質問集を使った一問一答形式であり、実際のユーザーとのインタラクションを反映できないという欠点があった。
特に生成AIのように文脈・会話・行動を伴うモデルでは、単なる正答率では実力を測ることができず、「テストでは高精度なのに実運用では不安定」という現象が多発した。その結果、多くの企業がPoC(概念実証)段階で成果を確認できたにもかかわらず、実環境への展開に踏み切れない、いわゆる“PoC止まり問題”に直面している。
■ 理論的枠組み:User Simulationによる動的評価
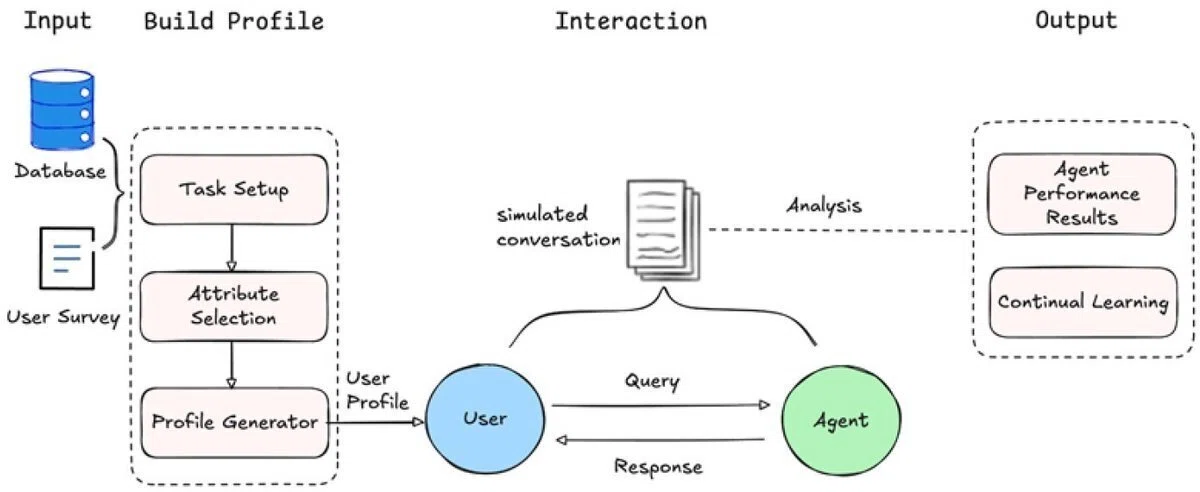
この課題を打開する新たな手法として注目されているのがUser Simulation(ユーザーシミュレーション)による評価である。これは実際のユーザーの発話・行動・反応を模倣した「仮想ユーザー」をAIが演じることで、LLMや対話エージェントの応答を動的・連続的な環境下で評価するアプローチである。
模擬ユーザーは、実際のログデータや観察結果をもとに構築され、AIと複数ターンの会話を行う。評価指標としては、単なる「正答率」だけでなく、
・応答の一貫性
・対話の自然さ
・ユーザー満足度の推定
・目標達成率
・感情反応の適切性
といった複合的要素が取り入れられている。
この手法は、AIモデルの行動特性と対話品質を定量化することを可能にし、AIの「思考」や「判断」を人間に近い形で分析できる点に革新性がある。
■ 実装・応用:品質保証からUX改善へ
User Simulationはすでに複数の業界で導入が始まっている。たとえばカスタマーサポートAIでは、実際の問い合わせシナリオをもとに模擬ユーザーを生成し、AIがどのように顧客対応するかを再現。その結果、従来1件ずつ人手で行っていた応答品質チェックを自動化し、テストコストを70%以上削減する事例も出ている。
教育AI分野では、生徒の質問傾向を模倣するシミュレーションにより、AIチューターの説明力・誤答率・フォロー力を測定。この結果、チューターAIの「教え方の癖」や「理解不足箇所」を定量的に可視化できるようになった。
また、プロダクト開発のUX設計においても、仮想ユーザーがAIを使う様子を行動ログレベルで再現し、ボトルネックの特定や改善策の検証が可能となった。 このように、User Simulationは単なるテスト自動化技術ではなく、AIの品質保証・改善サイクルを継続的に支える重要基盤として位置づけられつつある。
■ 実践と展望:AIガバナンスの次なる柱
今後、AIの社会実装が進むにつれて、課題は「精度」から「信頼性」「倫理性」へと移行する。User Simulationは、AIの出力だけでなく、そのプロセスや判断根拠の妥当性を検証する仕組みとして、AIガバナンス分野でも注目されている。
特に重要なのは、AIが長期的に利用される中で、ユーザーや環境の変化に適応し続ける能力をどのように測定・保証するかである。今後は、シミュレーション環境を標準化・共有化し、継続的なAI評価エコシステムを構築する動きが加速するだろう。
AIの評価はもはや静的なスコアではなく、“対話しながら進化するプロセス”そのものとなりつつある。User Simulationは、その新時代の評価フレームの中核として、研究・産業の両面からAIの信頼性向上を牽引していくと考えられる。
