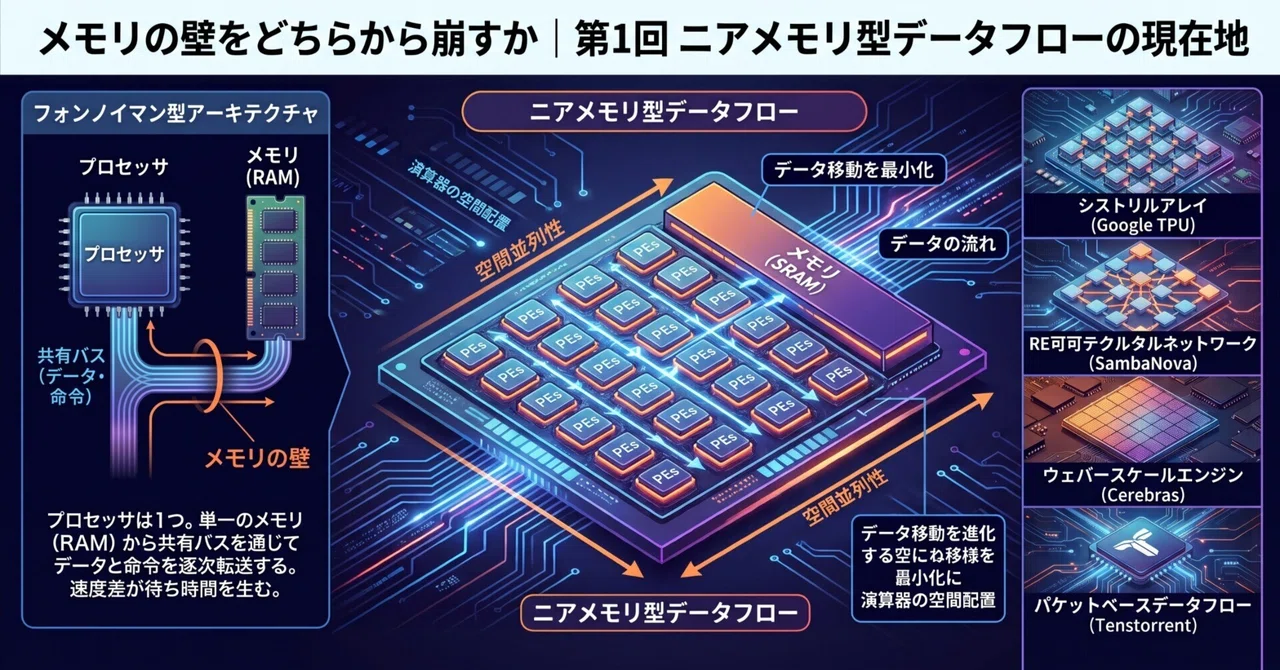
メモリの壁をどちらから崩すか|第1回 ニアメモリ型データフローの現在地

はじめに
いま、メモリ価格が歴史的な高騰を続けています。 2026年に入り、DRAMの契約価格は四半期で9割前後も上昇しました※1。 主要メーカーが生産能力の大半をAIデータセンター向けの広帯域メモリHBMへ振り向け、その分だけ一般的なメモリの供給が絞られているためです※1。
この高騰の根には、AIの計算が古い制約に突き当たっているという事情があります。 メモリの壁と呼ばれる、演算そのものではなくデータの移動がボトルネックになる問題です。 生成AIモデルのパラメータ数が数十億から数兆へと拡大するにつれて、この古い制約がAIチップの設計思想そのものを揺さぶり始めています。
問題の核心は演算器の性能不足ではありません。 プロセッサとメモリの間でデータを移動させるコストが、演算そのもののコストを上回っているという点にあります。
この連載では、この制約に対する二つの異なる進化を比較します。 一つは、メモリアレイそのもの、またはその直近の周辺回路に積和演算を担わせ、重みデータの移動を最小化するCompute-in-Memory(CIM)です。 In-Memory Computing(IMC)も近い意味で使われますが、IMCは文脈によってメモリ近傍演算やRAM常駐処理まで指すことがあります。 本稿では、セルやアレイの物理特性、あるいはアレイ内の回路を演算に直接使う方式をCIMと呼びます。 もう一つはメモリセルを変えずに、演算器の配置とデータの経路を空間的に最適化するニアメモリ型データフローコンピューティングです。
第1回ではニアメモリ型データフローを扱います。 CIMの各社比較と両者の住み分けは第2回で示します。
メモリが壁になる仕組み
現代のコンピュータの大半は、フォンノイマン型アーキテクチャに基づいて設計されています。 プログラムとデータを同じメモリ空間に置き、共有バスを通じてプロセッサへ逐次転送する方式です。
この方式では、プロセッサが演算を実行するたびに、メモリからデータが到着するのを待たなければなりません。 半導体の微細化によってトランジスタの演算速度は向上し続けてきましたが、配線を通じたデータ転送の帯域幅は同じペースでは伸びていません。 この速度差が生む待ち時間とエネルギーコストが、メモリの壁と呼ばれる制約です。
エネルギーの差は実測で示されています。 45nmプロセスの実測値では、32ビット浮動小数点乗算1回が約3.7ピコジュールであるのに対し、オフチップDRAMへの64ビットアクセス1回は1,300〜2,600ピコジュールで、差は二桁から三桁にのぼります※2。
大規模言語モデルの推論のうち、トークンを一つずつ生成する自己回帰的なデコードでは、各トークンの生成ごとに全層の重みを読み直します。 バッチサイズが小さいとこの重み読み出しが複数リクエストで償却されず、演算量よりも重みを供給するメモリ帯域が律速になりやすく、先ほどのエネルギー差がそのまま電力コストと発熱として効いてきます(長いコンテキストではKVキャッシュの読み出しも帯域と容量の要因に加わります)。 演算器がデータ待ちでアイドル状態に陥る時間も長くなります。
冒頭で触れたメモリ価格の高騰は、この壁の裏返しです。 AIがメモリ帯域を渇望するからこそ、帯域を稼ぐHBMに需要が集中し、その供給逼迫が一般的なメモリの価格まで押し上げています。 壁をどう崩すかは、価格の問題でもあるということです。
二つの処方箋
CIMは、メモリアレイそのものや、その直近の周辺回路に演算機能を持たせます。 重みをセルの抵抗値や磁化状態として保持し、電流や電圧の物理法則でその場で積和演算を行うか、アレイに密着した回路で演算を済ませることで、重みデータをアレイの外へ動かす必要を最小化します。
ニアメモリ型データフローは、メモリセルの構造は変えません。 代わりに、演算器を空間的に並べ替え、データの通り道をコンパイラが事前に確定させることで、移動の回数と距離を最小化します。
両者は「セルの中で計算を終わらせるか」「セルの外で計算をするが移動経路を研ぎ澄ますか」という選択の違いです。 第1回で扱うのは後者です。
時間で処理するか、空間で処理するか
CPUやGPUのような汎用プロセッサは、汎用の演算資源を時間多重で使う実行モデルに立っています。 命令を順番に取り出し、同じ演算器を時間方向に使い回す方式です。 どの命令がいつ実行されるかはハードウェアが実行時にスケジュールし、データはそのたびにレジスタ、キャッシュ、オフチップメモリの階層を行き来します。
ニアメモリ型データフローが立つのは、空間アーキテクチャという逆の発想です。 多数の演算器をチップ上に格子状に敷き詰め、計算グラフの各ノードを物理的な演算器に割り当てます。 データは階層をさかのぼってメモリへ戻るのではなく、隣接する演算器へ直接流れていきます。
実行のトリガーも異なります。 汎用プロセッサでは命令ストリームの進行に沿って演算が実行されますが、データフロー実行モデルでは必要な入力データが揃ったときに演算が発火するという原理が根にあります。 命令の順序を駆動力にするか、データの到着を駆動力にするかの違いです。
この方式を機能させる主役はコンパイラです。 どの演算をどの物理演算器に割り当てるか、データをどの経路でいつ流すかを、コンパイラが実行前に静的に決定します。 汎用プロセッサがキャッシュ管理やアウトオブオーダー実行といった動的な判断を実行時に行うのに対し、判断の重心を事前のコンパイルへ移すことで、動的スケジューリングへの依存を減らし、処理時間の予測性を高めやすくなります。
ただしこれは二者択一ではありません。 GPUにも空間並列性と静的コンパイルの側面はあり、データフロー型アクセラレータにもDMAやオンチップネットワークの転送制御、バッファリングといった実行時機構は残ります。 動的な形状や条件分岐、通信の輻輳、メモリ待ちも消えるわけではありません。 違いは、最適化と制御の重心を実行時に置くか、事前のコンパイルに置くかにあります。
その分、負担はコンパイラに移ります。 計算グラフの分割、演算器への割り当て、データ経路の決定をすべて事前に解かなければならず、この最適化問題の難しさがデータフロー型の実用化を長年阻んできました。 以下で見る各社は、この問題への解き方がそれぞれ異なります。
Google TPU
Googleが2015年に投入したTPU v1は、推論専用として設計され、256×256の8ビット整数シストリックアレイを核とした構成でした。 Googleの論文によれば、ピーク性能は92TOPSで、28MiBのオンチップメモリをソフトウェアが直接管理する方式を採っています※3。
シストリックアレイは、空間アーキテクチャの中でも最も規則的な形です。 重みをあらかじめ各演算器に固定してロードし、そこへ活性化データと部分和を波のように流し込む重み定常方式を採用しており、中間結果の書き戻しコストを回避しています。
以降の世代では、埋め込みテーブル参照のような不規則なメモリアクセスを専用のSparseCoreへ切り離し、密行列演算を担うメインの演算アレイの稼働率を落とさない設計へと進化しています。
SambaNova
SambaNovaのRDU(Reconfigurable Dataflow Unit)は、固定命令セットを持たない再構成可能アレイです。 シストリックアレイが単一の演算パターンに固定されているのに対し、演算ユニットとメモリユニットを結ぶスイッチ網を書き換えることで、モデルごとに異なる計算グラフを同じシリコンに載せ替えられます。
最新世代のSN40Lは、TSMC 5nmプロセスで製造した2ダイ構成のソケットに、オンチップSRAM 520メガバイト、HBM 64ギガバイト、DDR DRAM最大1.5テラバイトという三層のメモリを積んでいます※4。 DDRという低速だが大容量の層に混合エキスパートモデルの重みを保持し、実行時に必要な部分だけをHBM経由でSRAMへ運ぶことで、通常であればGPUクラスタを要する規模のモデルを、少数のソケットで動かすことを狙った設計です。
Cerebras
Cerebrasは、シリコンウェハを個々のチップに切り出さず、ウェハ一枚をそのまま単一のプロセッサとして使うウェハスケール・エンジンを実用化しています。 チップ間通信という距離の壁を、チップを分割しないことで消すという発想です。
最新のWSE-3は、TSMC 5nmプロセスで製造され、4兆個のトランジスタ、90万個のAIコア、44ギガバイトのオンチップSRAMを、46,225平方ミリメートルのダイ上に集積しています※5。 Cerebras自身の公表値では、SRAMの帯域幅は21ペタバイト毎秒、コア間通信を担うファブリックの帯域幅は214ペタビット毎秒とされています※5。
大容量ウェハの製造では欠陥の発生が避けられませんが、冗長コアで欠陥コアを代替する設計によって量産を成立させています。 重みデータの保持はオンチップSRAMではなく外部のMemoryXという専用ストレージに担わせており、計算とメモリ容量を物理的に分離している点が設計上の特徴です。 Cerebrasは2026年5月にナスダックへ上場しており、ウェハスケールという設計思想が投資家からも評価を受けている段階にあります※6。
Tenstorrent
Tenstorrentは、RISC-Vコアと独自の行列演算エンジンを組み合わせたTensixコアを格子状に配置し、オンチップネットワークを介したパケットベースのデータフロー制御を採用しています。 テンソルを小さなタイルに分割してパケットとしてネットワークに流し、宛先のコアをコンパイラが明示的に指定する方式です。
コア間通信の経路指定を含め、データ移動の大半をハードウェアではなくコンパイラの静的な判断に委ねる設計思想を採っており、キャッシュコヒーレンシ機構をハードウェアから排除することでシリコン面積を演算に回しています。 キャッシュミスやスケジューラの競合という実行時の揺らぎが減るため、処理時間の予測性が高く、低精度演算を多用する推論でも安定した動作が得られやすくなります。
先駆者の結末
同じデータフロー型の潮流には、Wave Computingという先駆者もいました。 グローバルクロックを排除した非同期回路によって、データが到着した演算器だけが起動するという徹底した省電力設計を2017年に発表し、当時の業界に衝撃を与えています。
しかしWave Computingは2020年4月にChapter 11破産を申請し、2021年3月の再建に際して社名をMIPSへ変更しました※7。 その過程でデータフローDPU事業と自社が開発してきたMIPS命令セットアーキテクチャの双方を放棄し、RISC-V専業へ転換しています。 2025年7月には、そのMIPSがGlobalFoundriesに買収され、RISC-VコアIPベンダーとしてGF傘下に入りました※7。
技術思想の先進性と事業の存続は別問題である、という教訓として記憶しておく価値があります。
第2回へ
ここまで見てきた各社は、メモリセルには手を付けず、演算器の空間配置とコンパイラの静的スケジューリングでデータ移動を削るという共通の土俵に立っていました。
では、メモリセルそのものに演算をさせるとどうなるのでしょうか。 第2回では、SRAM、フラッシュ、ReRAM、相変化材料という素材ごとに成熟度の異なるCIMの勢力図を整理し、二つの処方箋の住み分けを考えます。
この記事の技術的事実は、脚注に示した各社の公式発表、査読済み学術論文、業界専門メディアの報道に基づいています。
以下の点は確度が異なることを明記します。
汎用プロセッサの時間多重実行と空間アーキテクチャの対比、およびコンパイラへの負担移転という整理は、公開されている技術資料をもとにした筆者の構成であり、単一の一次資料による分類ではありません。
各社の帯域幅などの数値は、断りのない限り各社の公表値であり、第三者による実測値ではありません。
脚注
※1 TrendForce等の市場調査による2026年前半の市況。主要メモリメーカーが生産能力の大半をHBMへ振り向けた結果、2026年第1四半期のDRAM契約価格が前四半期比で9割前後上昇したと報じられている。HBMはDDR5に対しおよそ3対1の消費比率を持ち、HBM向けに転用されたウェハがその数倍の一般DRAMを市場から取り除く構造が価格高騰の主因とされる。数値は時点により変動する。
※2 M. Horowitz, "Computing's Energy Problem (and what we can do about it)," ISSCC 2014 基調講演。45nmプロセス、0.9V動作の実測値として、32ビット浮動小数点乗算が約3.7pJ、オンチップキャッシュアクセスが10〜100pJ、オフチップDRAMの64ビットアクセスが1,300〜2,600pJと報告されている。
※3 N. P. Jouppi et al., "In-Datacenter Performance Analysis of a Tensor Processing Unit," ISCA 2017。65,536個(256×256)の8ビットMACユニット、ピーク92TOPS、28MiBのソフトウェア管理オンチップメモリ、2015年からのデータセンター配備が報告されている。
※4 R. Prabhakar et al., "SambaNova SN40L: Scaling the AI Memory Wall with Dataflow and Composition of Experts"(arXiv:2405.07518)およびISSCC 2025発表。520MiBオンチップSRAM、64GiB HBM、最大1.5TiB DDR、TSMC 5nmという構成が示されている。
※5 Cerebras Systems、2024年3月13日プレスリリースおよびHot Chips 2024発表資料。4兆トランジスタ、90万AIコア、44GBオンチップSRAM、21PB/s SRAM帯域、214Pb/sファブリック帯域、TSMC 5nm、46,225mm²。
※6 Cerebrasは2026年5月14日にナスダック上場(業界報道による)。
※7 Wave Computingは2020年4月にChapter 11を申請し、2021年3月の再建完了時に社名をMIPSへ変更、RISC-Vアーキテクチャへ転換した。2025年7月、GlobalFoundriesがMIPSの買収を発表(各社報道による)。

