9 意図に絞ったら 38MB で足りた。30M のモデルをゼロから学習した実測

アプリに LLM を組み込むときの既定路線は、汎用の巨大モデルを API 越しに呼ぶことです。本当にそれしかないのか、というのが出発点でした。タスクを「9 意図の意図分類 + 関数呼び出し」に絞ったところ、38MB・30M パラメータのモデルをゼロから学習して、意図分類正解率 91.11%(ホールドアウト 90 件)に届きました。学習は Mac 1 台・43.75 分です。
ただし、これは「小さいほうが常に勝つ」という話ではありません。負けた数字も先に出しておきます。同じ評価セットで、この 30M モデルの完全一致率は 74.44%。Qwen2.5-0.5B-Instruct を Low-Rank Adaptation(LoRA)で特化させた版の 92.22% に 17.78 ポイント負けています。
以下の数値はすべて、社内で実施した PoC(概念実証)の実測値です。検証リポジトリは非公開のため、URL の代わりにモデル構成・学習設定・評価セット・実行環境・量子化条件をすべて記載します。各セクションは結論を先に置き、根拠のデータと導出をその後ろに続けてあります。結論だけを追って読み進められます。
この記事でわかること
対象読者は、LLM 機能をアプリに組み込んでいる、または検討しているエンジニアです。
特化モデルはどこまで小さくできるか(同一ホールドアウト 90 件・4 条件の実測比較)
30M パラメータの from-scratch 学習が Mac 1 台で成立するか(設定を全開示)
その先に見えた「ボトルネックはモデル容量ではない」という実測
結論
タスクを「タスク/ノート管理アプリのアプリ内アシスタント」に絞った条件下で、以下が成立しました。指標は意図分類正解率・完全一致率・配布サイズ・Time To First Token(TTFT)の 4 つです。
Qwen2.5-0.5B-Instruct + LoRA・INT4(Q4_K_M): 意図分類正解率 95.56%(86/90)、完全一致率 92.22%(83/90)、配布サイズ 397,807,392 バイト、TTFT 16.2〜17.3ms
tiny-30m(from-scratch 学習・INT4 / Q4_K_M): 意図分類正解率 91.11%(82/90)、完全一致率 74.44%(67/90)、配布サイズ 38,072,416 バイト、TTFT 2.22ms
from-scratch の tiny-30m は、配布サイズを 90.4% 削減しました。速度も TTFT で 7.3〜7.8 倍、トークン毎秒で約 3.6 倍です。一方、完全一致率では 17.78 ポイント負けています。勝ったのはサイズと速度であって、精度ではありません。
中核の主張は「小さいほうが常に勝つ」ではありません。適切に特化すれば、桁違いに小さくても勝てる領域があります。そしてその領域のボトルネックは、モデル容量ではなく学習データの意味的多様性です。 後半で、その根拠になった 2 つの「失敗した実験」を示します。
何をやらせたのか?
日本語の発話を受け取り、9 種類の JSON のどれか 1 行を返すことだけです。 雑談も要約も翻訳もコード生成も、一切しません。
鍵は、引数として取りうる値のカタログが有限であることです。学習データ生成側で定義した引数値は、タイトル 15 種・日付 6 種・優先度 4 種といった規模にとどまります。この有限性が、後半の「739 パターンでの飽和」に直結します。
スキーマ全文と入出力の実例:
意図とその引数は、以下のスキーマ(schema.json)で完全に定義されています。
{
  "description": "アプリ内アシスタント(タスク/ノート管理アプリ)を想定した意図分類+関数呼び出しスキーマ。出力は必ず {\"intent\": <str>, \"arguments\": {...}} の JSON 1行。",
  "intents": {
    "create_task": {
      "description": "新しいタスクを作成する",
      "arguments": {
        "title": {"type": "string", "required": true},
        "due_date": {"type": "string", "format": "YYYY-MM-DD or null", "required": false},
        "priority": {"type": "enum", "values": ["low", "medium", "high"], "required": false}
      }
    },
    "complete_task": {
      "description": "既存タスクを完了にする",
      "arguments": {"title": {"type": "string", "required": true}}
    },
    "delete_task": {
      "description": "既存タスクを削除する",
      "arguments": {"title": {"type": "string", "required": true}}
    },
    "list_tasks": {
      "description": "タスク一覧を条件付きで取得する",
      "arguments": {
        "filter": {"type": "enum", "values": ["today", "overdue", "all", "completed"], "required": true}
      }
    },
    "set_reminder": {
      "description": "リマインダーを設定する",
      "arguments": {
        "title": {"type": "string", "required": true},
        "datetime": {"type": "string", "format": "YYYY-MM-DD HH:MM", "required": true}
      }
    },
    "create_note": {
      "description": "新しいノートを作成する",
      "arguments": {
        "title": {"type": "string", "required": true},
        "content": {"type": "string", "required": true}
      }
    },
    "search_notes": {
      "description": "ノートをキーワードで検索する",
      "arguments": {"query": {"type": "string", "required": true}}
    },
    "schedule_event": {
      "description": "カレンダーに予定を追加する",
      "arguments": {
        "title": {"type": "string", "required": true},
        "datetime": {"type": "string", "format": "YYYY-MM-DD HH:MM", "required": true},
        "duration_minutes": {"type": "integer", "required": false}
      }
    },
    "none": {
      "description": "上記いずれの意図にも該当しない、または雑談・不明な入力",
      "arguments": {}
    }
  }
}
入出力は次の形です。評価セット(holdout.jsonl)からの実データを 3 件抜粋しました(可読性のため 1 レコードを 2 行に折り返しています)。
{"input": "掃除のタスクを設定したいな、2026年7月20日までに終わらせるよ",
 "output": {"intent": "create_task", "arguments": {"title": "掃除", "due_date": "2026-07-20"}}}

{"input": "買い物リストを作成して終了させたい",
 "output": {"intent": "complete_task", "arguments": {"title": "買い物リストの作成"}}}

{"input": "今日のタスクを並べ替えてくれな?",
 "output": {"intent": "list_tasks", "arguments": {"filter": "today"}}}
引数値のカタログは schema.json の enum 定義とは別に、生成スクリプト側のリストとして持っています。
補足:
本記事のタスク分布は極めて狭いものです。9 意図・有限の引数カタログ・JSON 1 行の出力という条件でのみ、以降の全数値は成立します。汎用アシスタントや自由記述の生成タスクに、そのまま外挿することはできません。
評価セットはどう作ったか?
ホールドアウト 90 件の正解ラベルは、教師モデルに作らせていません。 意図と引数値は、テンプレート側でプログラム的に確定しました。教師モデル(Qwen2.5-7B-Instruct)に依頼したのは、「その意図・引数を自然な日本語に言い換える」ことだけです。
この設計判断は、単なる慎重さではありません。後述するとおり、同じ発話を教師に自力で分類させると、テンプレート正解と意図レベルで 18.89%、完全一致レベルで 51.11% が食い違います。正解ラベルを教師に任せていれば、本記事のすべての精度数値は別のものになっていました。振り返ると、これが一番効いた判断だったと思っています。
評価セットの機械検証:
作成後、90 件全件を schema.json に対して機械検証しました。必須引数が揃っているか、型と enum 値が妥当か、未定義キーを含まないかを検査し、90/90 件(100%)がスキーマ上有効であることを確認しています。
正解ラベルはテンプレート由来であり、教師の判断は入っていません。
特化 LoRA は教師の 7B に勝てるのか?
勝ちました。同一のホールドアウト 90 件で 4 条件を測定した結果、特化 LoRA が全指標で最も高くなりました。 完全一致率は 92.22%(83/90)です。教師 Qwen2.5-7B-Instruct の 48.89%(44/90)を上回っています。
LoRA 特化の効果が最も明確に出るのは、ベースモデルとの差です。素の Qwen2.5-0.5B-Instruct は完全一致率 0.00%、つまり 90 件中 1 件も正解できていません。特化した小型モデルが汎用モデルを上回る現象自体は、LoRA Land(arXiv:2405.00732) が 10 ベースモデル × 31 タスクで報告しており、単発事例ではありません。
指標の定義と 4 条件の実測比較:
まず 4 つの指標を定義します。スキーマ準拠率は、JSON としてパースでき、「intent」が定義済みの値で、必須引数キーが揃っている出力の割合です。意図分類正解率は、スキーマ準拠かつ「intent」が期待値と一致する割合(本タスクでは関数名一致率と同値)。完全一致率は、その条件を満たしたうえで「arguments」の値まで含めて期待値と完全一致する割合です。
構造化一致率だけは説明が要ります。完全一致率から、日本語の自由記述引数(title / content / query)を判定対象外にした指標です。見るのは「intent」と構造化引数(due_date / priority / filter / datetime / duration_minutes)のみ。本記事のために評価ログの生データから新たに算出しました。
4 条件の実測値は次のとおりです(順に、スキーマ準拠率・意図分類正解率・完全一致率・構造化一致率・平均レイテンシ)。
(a) 教師 Qwen2.5-7B-Instruct(引数スキーマ明示・主指標): 88.89%(80/90)、81.11%(73/90)、48.89%(44/90)、67.78%(61/90)、0.485 秒/件
(a') 教師 Qwen2.5-7B-Instruct(最小プロンプト・参考値): 27.78%(25/90)、24.44%(22/90)、23.33%(21/90)、構造化一致率は未算出、0.494 秒/件
(b) 特化 LoRA・量子化前(bf16): 98.89%(89/90)、95.56%(86/90)、92.22%(83/90)、93.33%(84/90)、0.209 秒/件
(c) 特化 LoRA・INT4(Q4_K_M GGUF): 98.89%(89/90)、95.56%(86/90)、92.22%(83/90)、93.33%(84/90)、0.090 秒/件
(d) ベース素(LoRA なし): 8.89%(8/90)、8.89%(8/90)、0.00%(0/90)、構造化一致率は未算出、0.191 秒/件
構造化一致率は (a') と (d) では算出していません。(c) の 92.22% と (d) の 0.00% の差は絶対 92.22 ポイントです。
なお LoRA Land も、その効果がタスク依存であることを条件として付しています。
補足:
実行環境は条件ごとに異なります。(a)(a') は Ollama、(b)(d) は MLX の Python API 直接呼び出し、(c) は llama.cpp(llama-server)です。レイテンシはランタイムの違いを含む値であり、モデル間の純粋な速度比較ではありません。
なぜ「0.5B が 7B に勝った」と読んではいけないのか?
この 4 条件比較で見るべきは、(b)(c) の 92.22% ではありません。(a) と (a') の 25.56 ポイント差です。同じ Qwen2.5-7B-Instruct が、完全一致率で 48.89%(引数スキーマ明示)と 23.33%(最小プロンプト)を記録しました。教師の点数は、モデルを変えずにプロンプト設計だけで倍以上動きました。
つまりこの比較が測っているのは、モデルの大きさではありません。アプリ固有の出力規約(フィールド名・enum 値)を、どうモデルに注入するかです。素の教師は「title」の代わりに「name」や「task」を使うなど、独自の命名規約で答えます。これは 7B の能力不足ではなく、そのアプリの規約を知らないだけです。
正しい要約はこうなります。
アプリ固有の出力規約は、プロンプトでの後付け説明よりも、少量データでの特化学習のほうが確実に注入できます。
注意:
本記事の 4 条件比較は、アプリ固有スキーマに適応していない教師モデルとのプロンプトベース比較です。大規模モデル全般に対する優位性を示すものではありません。「0.5B が 7B に勝った」と要約すると、測定していないことを主張することになります。
量子化すると精度は落ちるのか?
本 PoC の条件下では、劣化は 0.00 ポイントでした。 LoRA 特化した量子化前(bf16)と、同じモデルの Q4_K_M / INT4 版を 90 件で突き合わせています。成否パターンは全 90 件で一致し、差分 0 件でした。tiny-30m も同じ傾向で、FP32 / MLX-INT4 / GGUF-INT4 の 3 形態が同一の結果を出しています。
ただし、「量子化しても劣化しない」と一般化してはいけません。0 になったのは、そもそも 4 ビットまで圧縮しきれていなかったためである可能性が高いからです。
なぜ 4 ビットまで圧縮されなかったのか(フォールバック量子化):
Qwen2.5-0.5B-Instruct の隠れ層次元は 896 で、Q4_K の量子化ブロックサイズ(256 の倍数)と噛み合いません。その結果、290 テンソル中 144 テンソルが Q5_0 / Q6_K / Q8_0 へフォールバック量子化されました。
実測ビット幅は **6.35 Bits Per Weight(BPW)**であり、名目上の INT4(4 BPW)より保守的な圧縮にとどまっています。tiny-30m も同様で、隠れ層次元 192 に対し 50 テンソル中 24 がフォールバックし、実測 8.35 BPW でした。
注意:
この「劣化 0.00 ポイント」は、実効圧縮率が保守的(6.35 BPW / 8.35 BPW)だったことに起因すると考えられます。真の 4 BPW 圧縮が効くモデルで同じ結果を期待してはいけません。量子化前後の精度は、自分のモデルで測り直す必要があります。
30M をゼロから学習するのは現実的か?
現実的でした。Mac 1 台・43.75 分で完了します。 拍子抜けするほどの短さです。内訳は、学習データ生成 478 秒(約 8 分)と学習 2,147 秒(35.8 分)。実行環境は Apple M4 Max・64GB の Mac 単体、フレームワークは Apple Silicon 向けの MLX です。学習を回している間、私は何をしていたかというと、YouTube と Amazon プライムでアニメを見て、パズルゲームをしていました。それで終わる長さです。
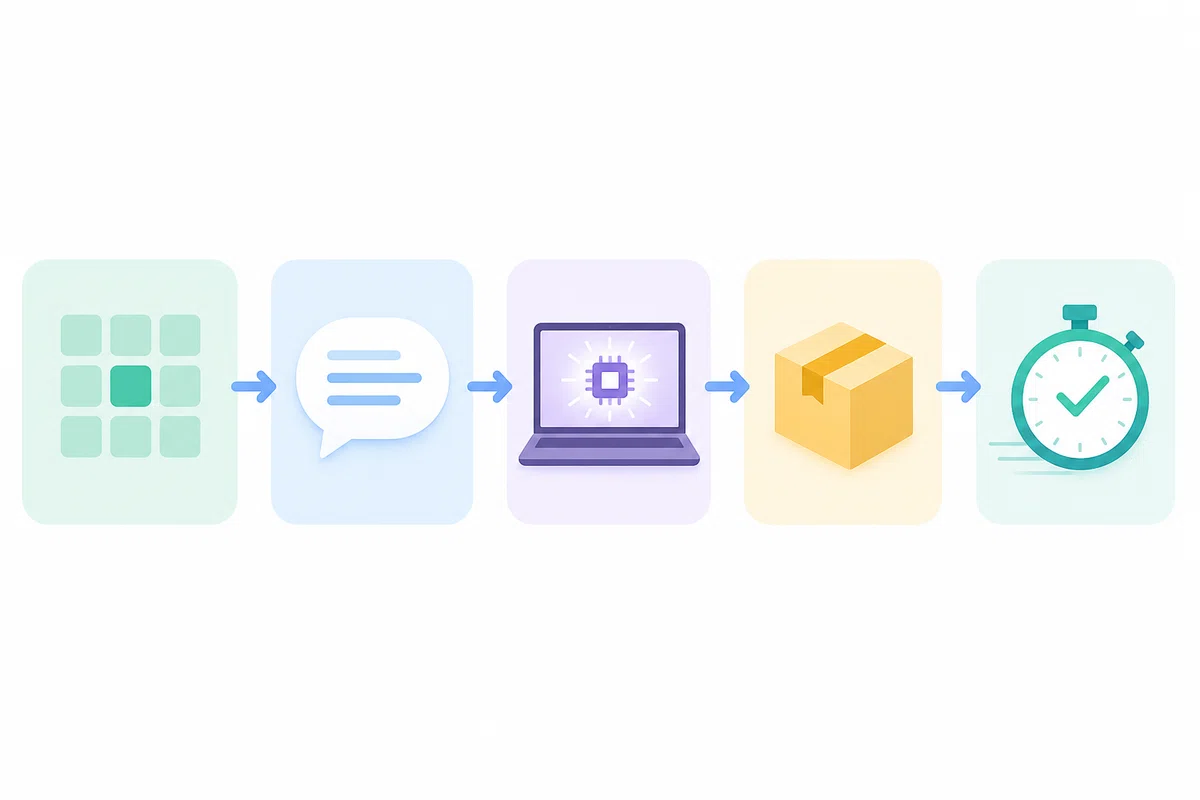
学習から評価までの流れは、次の 5 段階です。
テンプレートで (intent, args) を確定する
教師 Qwen2.5-7B-Instruct が自然文へ言い換える(9,999 件 / 478 秒)
from-scratch 学習を MLX で行う(12 エポック / 2,147 秒)
量子化・変換する(MLX-INT4 / GGUF Q4_K_M)
ホールドアウト 90 件で評価する(llama-server で TTFT・tok/s・RSS を実測)
この規模の学習が単一マシンで完結する性質は、TinyStories(arXiv:2305.07759) が示したものと同じです。同論文は 1M〜80M パラメータのモデルについて「すべてのモデルは単一の V100 GPU で最大 30 時間以内に学習できる」と述べています。タスクもデータ量も違うため学習時間の直接比較に意味はありませんが、「データ分布を絞れば、小さなモデルを単一マシンで学習しきれる」という系譜に本 PoC は位置づけられます。
アーキテクチャと学習手順:
アーキテクチャは Qwen2 の decoder-only Transformer 構造を流用し(mlx_lm.models.qwen2)、事前学習済みの重みは使わずランダム初期化しました。トークナイザは Qwen2.5 のものを流用しています(vocab_size は 151,936)。
学習は Supervised Fine-Tuning(SFT)形式で、system と user をマスクし、assistant 応答部分(JSON 出力 + EOS)のみに交差エントロピー損失をかけました。1 エポック目で loss が急減し、3〜5 エポックでほぼ収束しています。
43.75 分は tiny-30m 単体の値です。後述の small-43m を含めると、単一 Mac で計 84 分でした。
再現に必要な設定(全開示):
モデル構成は次のとおりです。
tiny-30m: hidden 192、layers 4、intermediate 512、heads 4、kv_heads 2。総パラメータ 30,796,992、うち embedding 部 29,171,712、本体(非 embedding)1,625,280。embedding 比率 94.7%
small-43m: hidden 256、layers 6、intermediate 768、heads 8、kv_heads 2。総パラメータ 43,423,232、うち embedding 部 38,895,616、本体(非 embedding)4,527,616。embedding 比率 89.6%
学習設定は次のとおりです。
学習データ: 9,999 件(train 9,499 / val 500、ランダム分割)
オプティマイザ: Adam
学習率: 3e-4
バッチサイズ: 64
エポック数: 12
最終 loss(tiny-30m): train 0.0020 / val 0.0020
実行環境: Apple M4 Max・64GB / MLX
精度・サイズ・速度はどうなったか?
勝ったのはサイズと速度で、精度ではありません。 配布サイズは 0.5B + LoRA 比で 90.4% 削減、TTFT は 7.3〜7.8 倍、スループットは約 3.6 倍です。意図分類正解率は 0.5B + LoRA の相対 95.3% まで迫りましたが、完全一致率では 17.78 ポイント負けています。引数の値まで厳密に合わせる必要がある用途では、この from-scratch 版は選べません。
tiny-30m と 0.5B + LoRA の全指標比較:
同一のホールドアウト 90 件で測定しました。どちらも INT4 GGUF 版です。メモリは Resident Set Size(RSS)です。
配布バイナリサイズ: tiny-30m は 38,072,416 バイト(36.3MiB)、0.5B + LoRA は 397,807,392 バイト(90.4% 削減)
プロセス RSS(llama-server・推論後): tiny-30m は 約 149.6MB、0.5B + LoRA は 571.7MB(ピーク)/538.3MB(ロード直後)
TTFT: tiny-30m は 2.22ms(最大 7.92ms、30 件平均)、0.5B + LoRA は 16.2〜17.3ms
トークン生成速度: tiny-30m は 平均 1,338 tok/s(最小 548 tok/s)、0.5B + LoRA は平均 372〜377 tok/s
スキーマ準拠率: どちらも 98.89%(89/90)
意図分類正解率: tiny-30m は 91.11%(82/90)、0.5B + LoRA は 95.56%(86/90)
完全一致率: tiny-30m は 74.44%(67/90)、0.5B + LoRA は 92.22%(83/90)
構造化一致率: tiny-30m は 82.22%(74/90)、0.5B + LoRA は 93.33%(84/90)
完全一致率の低さは、日本語の引数のせいではないのか?
一部はそうですが、それでも負けは消えません。 完全一致率は「title」のような日本語の自由記述まで厳密一致を要求します。そこで、意図と構造化引数のみを見る構造化一致率を、同じ 90 件の評価ログから算出しました。tiny-30m は 74.44% → 82.22% に上がります(+7.78pt、日本語文字列だけで失敗していたのは 7 件)。
4 モデルの構造化一致率:
各モデルの値は、順に意図分類正解率・完全一致率・構造化一致率・完全一致率との差・日本語文字列のみで失敗した件数です。
tiny-30m(from-scratch・INT4): 91.11%(82/90)、74.44%(67/90)、82.22%(74/90)、+7.78pt、7 件
small-43m(from-scratch・FP32): 87.78%(79/90)、70.00%(63/90)、76.67%(69/90)、+6.67pt、6 件
0.5B + LoRA(INT4): 95.56%(86/90)、92.22%(83/90)、93.33%(84/90)、+1.11pt、1 件
教師 Qwen2.5-7B-Instruct: 81.11%(73/90)、48.89%(44/90)、67.78%(61/90)、+18.89pt、17 件
読み方を 2 つ、明確にしておきます。
1. 構造化一致で見ても、tiny-30m は 0.5B + LoRA に負けています。 82.22% 対 93.33% で 11.11 ポイント差です。完全一致率での 17.78 ポイント差が縮むだけで、消えません。tiny-30m は意図分類そのものでも負けているためです。
2. この指標で最も得をしたのは、教師の 7B です(+18.89pt)。 これは小さいモデルに有利な指標ではありません。どのモデルも日本語文字列の厳密一致で点を落としているという事実を示しています。教師の 17 件は「意図も構造化引数も正しいのに、title の書き方だけが違う」という失敗でした。
そして title の不一致を「軽微」と断じてはいけません。「掃除」と「掃除のタスク」では、実際に作られるタスク名が変わります。構造化一致率は「意図と構造を取り違えていないか」を測る指標であって、「実用上問題ないか」を測る指標ではありません。 どちらを見るかは用途で決まります。日付や優先度を抽出してフォームに流し込むなら構造化一致率、タスク名をそのまま保存するなら完全一致率です。
小さいモデルは、どこで壊れるのか?
分布外の入力で壊れます。 それも、盛大に。速度計測の準備で、本タスクと無関係な汎用プロンプト集を tiny-30m に流したときでした。返ってきたのは、同じトークンの無限ループです。延々と続きます。別のプロンプトでは文字化けが出て、ログを開くと llama-server の chat テンプレートパーサがエラーを返していました。分布外入力への頑健性は事実上ゼロです。速度計測は、この問題を避けるためにホールドアウトと同一分布のプロンプトへ切り替えて実施しています。
限界は 4 点あります。
分布外入力で応答が崩壊する。 実運用には「タスク外入力を弾く/大規模モデルへフォールバックする」機構が必須である。目的を絞った from-scratch 学習は、汎用性を完全に犠牲にする。
完全一致率で 17.78 ポイント負けている(74.44% 対 92.22%)。日本語の自由記述を除いた構造化一致率でも 11.11 ポイント負け(82.22% 対 93.33%)であり、差は縮むが消えない。
スマホ実機での測定は未実施である。 実測は Apple M4 Max・64GB の Mac のみ。0.5B 版では同一セッションで、ピーク RSS 571.7MB と peak memory footprint 284.4MB という 2 指標が観測された。倍近い開きは、mmap のページキャッシュ分を含むかどうかの違いによる。iOS の jetsam や Android の LMK が参照するのは footprint 側に近く、メモリ管理方式そのものが macOS と異なる。「スマホ級のフットプリントに収まる」とは言えるが、「スマホで動く」は未検証の主張である。
単一シード・1 回の学習である。 統計的なばらつきの範囲を否定できない。
注意:
とくに「分布外入力での応答崩壊」と「スマホ実機未検証」を承知せずに from-scratch モデルを本番投入すると失敗します。特化モデルは、フォールバック機構とセットでなければ製品になりません。
パラメータの 94.7% は、何に使われていたのか?
embedding テーブルです。 tiny-30m の総パラメータ 30,796,992 のうち、embedding が 94.7% を占めていました。Transformer 層の本体はわずか **1,625,280(5.3%)**です。「30M のモデルを作った」つもりでしたが、実体は 1.6M の Transformer + 29.2M の汎用語彙テーブルでした。作ってみて、分解して、初めて見えた数字です。
この構造は本 PoC 固有ではありません。Google の Gemma 3 270M は、総 270M のうち embedding が 170M、Transformer ブロックが 100M(vocab 256k)という内訳を公表しています。商用の小型モデルでも、パラメータの過半は語彙テーブルです。 小型モデルを設計するとき、最初に見るべきはレイヤ数ではなく語彙数です。
原因と、語彙を削れば何が起きるか:
原因は、Qwen2.5 のトークナイザ(vocab_size は 151,936)をそのまま流用したことです。この語彙数では embedding だけで 29.2M〜38.9M パラメータを要し、「10M 級のモデル」というターゲットは embedding だけで既に超過します。
しかし本タスクで実際に出現するトークンは、日本語の口語表現・JSON の構造記号・意図名と enum 値程度です。語彙を数千トークン規模に絞れれば、embedding を 1/20〜1/40 に削減できる可能性があります(未検証の推測であり、本 PoC では実施していません)。
モデルを大きくすれば、精度は上がるのか?
上がりませんでした。 前節を素直に読めば「増強の余地」に見えます。Transformer 本体は 1,625,280 パラメータしかないのだから、そこを増やせば精度は上がるはずだ、と。実際に増やした結果が、以下の 2 つの失敗した実験です。
実験 A: 本体を 2.8 倍にしたら、精度が下がった
同一の 9,999 件・同一の学習手順で本体パラメータを約 2.8 倍にしたところ、意図分類正解率は 91.11% → 87.78% に下がりました。大きいほうが低くなりました。 正直、当てが外れました。
実験 A の測定値:
tiny-30m: 本体パラメータ(非 embedding)1,625,280、意図分類正解率 91.11%(82/90)、完全一致率 74.44%(67/90)
small-43m: 本体パラメータ(非 embedding)4,527,616(約 2.8 倍)、意図分類正解率 87.78%(79/90)、完全一致率 70.00%(63/90)
測定条件: tiny-30m は FP32 / MLX-INT4 / GGUF-INT4 の 3 形態で同一の結果。small-43m は FP32 実測。
補足:
実験 A は単一シード・1 回の学習です。統計的なばらつきの範囲内である可能性は否定できません。断言できるのは「本条件下では、モデルを大きくすれば精度が上がるという単純な関係は確認できなかった」ということまでです。
実験 B: データを 10 倍にしても、意味的多様性は増えない
9,999 件を生成しても、実際の教師呼び出しは 739 件にとどまりました。 引数値のカタログが有限なので、10 回に 9 回以上がキャッシュヒットします。パターン数が 739 で頭打ちになっているのが本質です。ここから件数を 10 万件に増やしても、パターン数は 739 のまま変わりません。件数は 10 倍になりますが、モデルが新たに学べる情報は増えません。
739 パターンの内訳と、10 倍にしたときの計算:
学習データ生成は (intent, args) の組み合わせをキーに教師呼び出しをキャッシュする設計でした。組み合わせ空間の理論上限は約 767〜819 件で、実際の呼び出しは 739 件です。
現状(9,999 件): 9,999 ÷ 739 ≒ 13.5。1 パターンあたり約 13.5 件が重複している
10 万件に増やした場合: 100,000 ÷ 739 ≒ 135。パターン数は 739 のまま、1 パターンあたりの重複が約 135 件に増えるだけ
この設計上の制約により、事前に定めた 5 つの成功基準のうち「データ量感度の測定」だけが未達に終わりました。
統合すると、こうなります。 本体パラメータは 1.6M〜4.5M しかありませんが、739 パターンの入出力マッピングを学習するには、両モデルとも容量として十分だったと考えられます。だから容量を増やしても伸びませんでした。すなわち、ボトルネックはモデル容量ではなく、データの意味的多様性です。
学習データは、教師モデルに作らせればいいのでは?
任せると食い違います。意図レベルで 18.89%、引数まで含めると 51.11% です。
教師(Qwen2.5-7B-Instruct)にテンプレートの正解ラベルを一切見せず、自然文だけから意図と引数を分類させ、テンプレート正解との不一致率を測りました。不一致の中身は「教師のミス」ではありません。境界事例です。
不一致の一覧で最初に目を引いたのは、「買い物リストを作成して終了させたい」という発話でした。テンプレートは complete_task、教師は create_task。正直、教師を責められないなと思いました。どちらの解釈にも理屈があります。作成と読むか完了と読むかは、そのアプリがその発話をどう扱うと決めているかにしか答えがありません。教師モデルは、その決めごとを知りようがないのです。
不一致率の実測と、境界事例の全例:
教師とテンプレート正解の不一致率は次のとおりです。
意図レベル: 18.89%(17/90)
意図 + 引数の完全一致レベル: 51.11%(46/90)
境界事例は次の 2 例です。
「買い物リストを作成して終了させたい」: テンプレートの正解は complete_task、教師の解釈は create_task
「今日のタスクを並べ替えてみgameObject」(ノイズ混入): テンプレートの正解は list_tasks、教師の解釈は none
2 例目はさらに直接的です。評価セットには、タイプミスや異言語の混入を模したノイズが意図的に含まれています。テンプレートは「ノイズは無視して意図を汲む」と決めていましたが、教師は「解釈不能」として none を返しました。どちらを正解とするかは、モデルの賢さではなく、そのアプリの仕様が決めることです。
つまり、正解ラベルを教師の自動生成に全面代替すると、意図レベルで約 19%、厳密な引数一致まで求めると約 51% が食い違います。人間(またはテンプレートのような決定的ロジック)によるラベル確定は、現時点で省略できません。
人間の仕事はどう変わるのか?
実測から言えること
本記事の実測だけから、論理的に導けるのは 4 点です。
タスクを絞れば、桁違いに小さいモデルで足りる領域が実在する。 38MB で意図分類正解率 91.11%。
その領域では、モデル容量を増やしても精度は上がらなかった。 本体 2.8 倍で 91.11% → 87.78%。
データ件数を増やしても、意味的多様性が増えなければ精度は上がらない。 9,999 件生成しても実体は 739 パターンで飽和した。
その意味的多様性は、教師モデルには供給できない。 意図レベル 18.89%、完全一致レベル 51.11% の不一致。
ここから、直接次の帰結が導けます。
この種のモデルを作る作業のボトルネックは、GPU でもモデル容量でもありません。「このアプリでは、この発話をこの意図として扱う」という意味の境界を決める作業です。
境界の数が飽和すれば、モデルを大きくしても精度は上がりません(実測 2)。そして境界は教師モデルには決められません(実測 4)。残るのは、境界を決める人間の作業です。 これは感想ではなく、2 つの失敗した実験と 1 つの不一致実測から導かれます。
ここから先は推測
補足:
ここから先は、本記事の実測から直接は導けない推測です。実測は「9 意図の意図分類 + 関数呼び出し」という単一タスク・単一シードの結果にすぎません。
推測される仕事の性質: それは「アノテーターとしてラベルを貼る仕事」ではありません。タスク境界のスキーマを設計し、引数値カタログの意味的多様性を設計し、教師モデルに何を任せて何を任せないかを決める仕事です。本 PoC で言えば、739 パターンで飽和したあの空間を、意図的に広げる設計をする人です。データを 10 倍にする人ではなく、意味を 10 倍にする人です。
この推測の前提になっている業界動向:
業界は既に「1 つの巨大モデル」ではなく「小さな特化モデル/アダプタを大量に持つ」方向に動いています。
Apple Intelligence Foundation Models は、オンデバイスの 3B モデルにタスク特化 LoRA アダプタを実行時に差し替える設計です。同ページによれば、rank 16 のアダプタのパラメータは数十 MB オーダーにとどまります。Foundation Models adapter training では、開発者自身がそのアダプタを学習できます。
NVIDIA Research の Small Language Models are the Future of Agentic AI(arXiv:2506.02153) も、エージェントの呼び出しの多くは Small Language Model(SLM)で足りるという立場です。
この方向が続くなら、必要なモデルの数だけ「タスク境界の定義」が要ります。そして実測 4 が正しければ、その定義は教師モデルに委ねられません。
まとめ
タスクを 9 意図に絞れば、38MB・30M パラメータのモデルを from-scratch 学習して意図分類正解率 91.11% に届く。学習は Mac 1 台・43.75 分。
ただし完全一致率は 74.44% で、0.5B + LoRA の 92.22% に 17.78 ポイント負けている。勝ったのは**サイズ(90.4% 削減)と速度(TTFT 7.3〜7.8 倍)**であって、精度ではない。
日本語の自由記述引数を除いた構造化一致率でも 11.11 ポイント負け(82.22% 対 93.33%)。差は縮むが消えない。この指標で最も得をしたのは**教師の 7B(+18.89pt)**であり、小さいモデルに有利な指標ではない。
4 条件比較を「0.5B が 7B に勝った」と読んではならない。同じ教師がプロンプト設計だけで 48.89% と 23.33% の間を動いた。測っているのは、アプリ固有の出力規約の注入方法である。
量子化による劣化は 0.00 ポイントだが、実効圧縮率が保守的(6.35 BPW / 8.35 BPW)だったことに起因する。一般則にしてはならない。
本体を 2.8 倍にしたら精度が下がり、データを 10 倍にしても 739 パターンで飽和した。 ボトルネックはモデル容量ではなく、学習データの意味的多様性である。
その多様性は教師モデルには供給できない(意図レベル 18.89% / 完全一致レベル 51.11% の不一致)。
残課題は、独自トークナイザ化・タスク外入力のフォールバック機構・実機での実測の 3 点。
小さいほうが常に勝つのではありません。適切に特化すれば桁違いに小さくても勝てる領域があり、その領域のボトルネックはモデル容量ではなく、学習データの意味的多様性です。
2 つの失敗した実験に付き合ったいまは、実感を込めてそう考えています。
よくある質問
Q. 特化モデルが想定外の入力を受けたらどうなりますか?
A. 応答が崩壊します。汎用プロンプト集を tiny-30m に投げた実測では、同一トークンの無限ループと文字化けが発生し、llama-server の chat テンプレートパーサがエラーを返しました。分布外入力への頑健性は事実上ゼロです。実運用では、タスク外入力を弾くか大規模モデルへフォールバックする機構が必須になります。
Q. 学習データは教師モデルに自動生成させればよいのでは?
A. ラベル確定まで任せると食い違います。教師に正解ラベルを見せず自然文だけから分類させた結果、テンプレート正解との不一致は意図レベルで 18.89%(17/90)、完全一致レベルで 51.11%(46/90)でした。多くは境界事例であり、教師の能力不足ではありません。そのアプリにおける意味の境界を、教師が知らないことに起因します。
Q. モデルを大きくすれば、データを増やせば、精度は上がりますか?
A. 本 PoC ではどちらも上がりませんでした。本体パラメータを 2.8 倍にすると意図分類正解率は 91.11% → 87.78% に低下しました(単一シードのため、ばらつきの可能性は残ります)。データも、9,999 件を生成しても教師呼び出しの実体は 739 パターンで飽和していました。10 万件に増やしてもパターン数は 739 のままです。
Q. 完全一致率 74.44% は、日本語のタイトルが一致しないだけでは?
A. 一部はそのとおりですが、負けは消えません。日本語の自由記述引数を除いた構造化一致率では tiny-30m は 82.22% に上がります(+7.78pt)。ただし 0.5B + LoRA も 93.33% に上がるため、11.11 ポイント差は残ります。しかもこの指標で最も得をしたのは教師の 7B(+18.89pt)であり、小さいモデルに有利な指標ではありません。
Q. 量子化すると精度はどれくらい落ちますか?
A. 本 PoC の条件では 0.00 ポイント(90 件を全件突き合わせて差分 0 件)でした。ただし一般則ではありません。Qwen2.5-0.5B-Instruct の隠れ層次元(896)が Q4_K のブロックサイズと噛み合わず、290 テンソル中 144 がより高いビット幅へフォールバック量子化されています。実測 6.35 BPW という保守的な圧縮にとどまったことが要因と考えられます。
Q. このモデルはスマホで動きますか?
A. 未検証です。 実測は Apple M4 Max・64GB の Mac のみで、実機測定は行っていません。38MB・RSS 約 149.6MB という数値は「スマホ級のフットプリントに収まる」ことを示唆します。ただし iOS の jetsam や Android の LMK は macOS とメモリ管理方式が異なるため、Mac の数値をそのまま外挿できません。
参考リンク
TinyStories: How Small Can Language Models Be and Still Speak Coherent English?(arXiv:2305.07759)
Small Language Models are the Future of Agentic AI(NVIDIA Research, arXiv:2506.02153)
LoRA Land: 310 Fine-tuned LLMs that Rival GPT-4(Predibase, arXiv:2405.00732)
Introducing Gemma 3 270M: The compact model for hyper-efficient AI(Google Developers Blog)
Introducing Apple's On-Device and Server Foundation Models(Apple Machine Learning Research)
