ClaudeFable5.1 VS GPT-6Astra 〜値段おなじかよ〜

今週、いろんな会社ののAI選定チームはたぶん2回、会議をやり直しています。
9月1日の火曜日ーーー
Anthropicが最上位モデルのClaude Fable 5.1を出しました。稟議書の比較表を書き直した人がいるはずです。
それからわずか48時間後、9月3日の木曜日ーーー
OpenAIがGPT-6 Astraを出しました。書き直した比較表は、もう古い。
そして両方の価格ページを開いた人は、たぶん同じ顔をしたと思います。
入力100万トークン10ドル、出力100万トークン50ドル。1桁目まで、まったく同じ値札です
偶然ではありません。そして、値札が同じなら比較は簡単になるはず、というのが今回いちばん危ない思い込みです。
今日はその話をします。読み終わるころには、来週の選定会議で「じゃあ何で選ぶんですか」と聞かれたときの答えが3つ持てます。
時間がない人向けまとめ
- 2026年9月1日、AnthropicがClaude Fable 5.1とClaude Mythos 5.1を公開。同じモデルで、安全装置の強さだけが違う
- 2026年9月3日、OpenAIがGPT-6 Astraを公開。OpenAI社長のBrockman氏は「AGI時代に入ったと感じても不合理ではない」と発言
- API価格は両方とも入力10ドル、出力50ドル。2026年9月4日の仲値1ドル155円68銭で、出力100万トークンあたり約7,784円
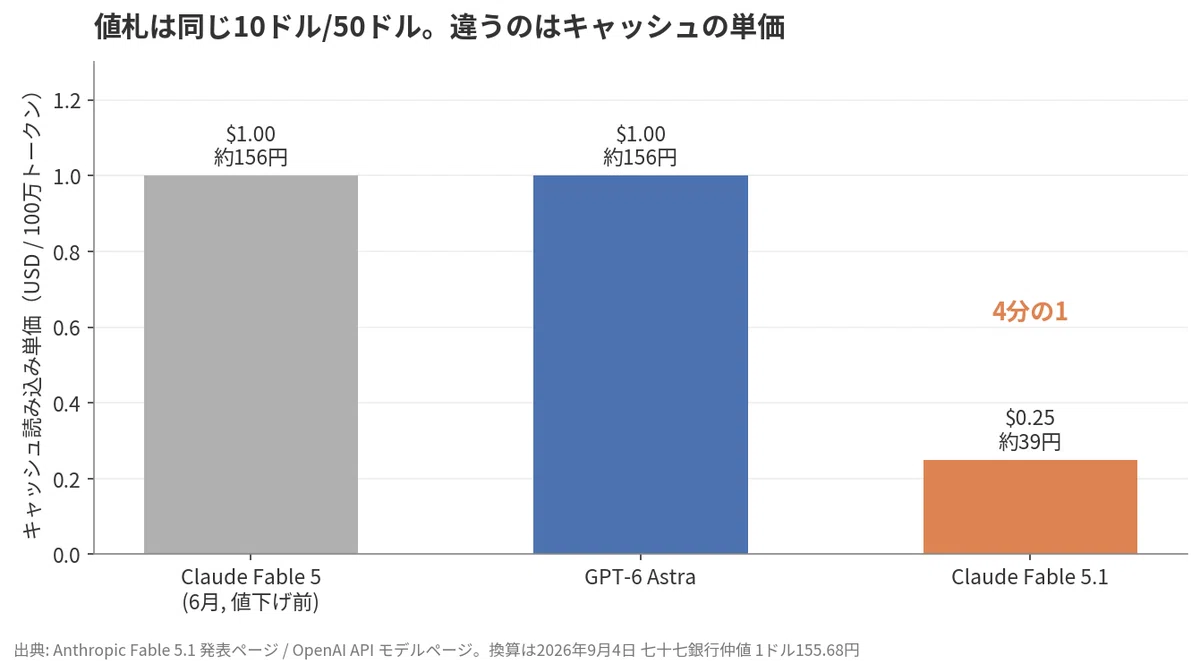
- 違うのは値札の外側。Fable 5.1はキャッシュ読み込みを75%値下げして100万トークン0.25ドル、約39円。Astraは1.00ドル、約156円で、4倍の開き
- ベンチマークは、OpenAI自身の比較表でもFable 5.1が勝っている行が複数ある。Humanity's Last Examで65.0%対57.2%、Artificial Analysis Intelligence Indexで65.7対61.2
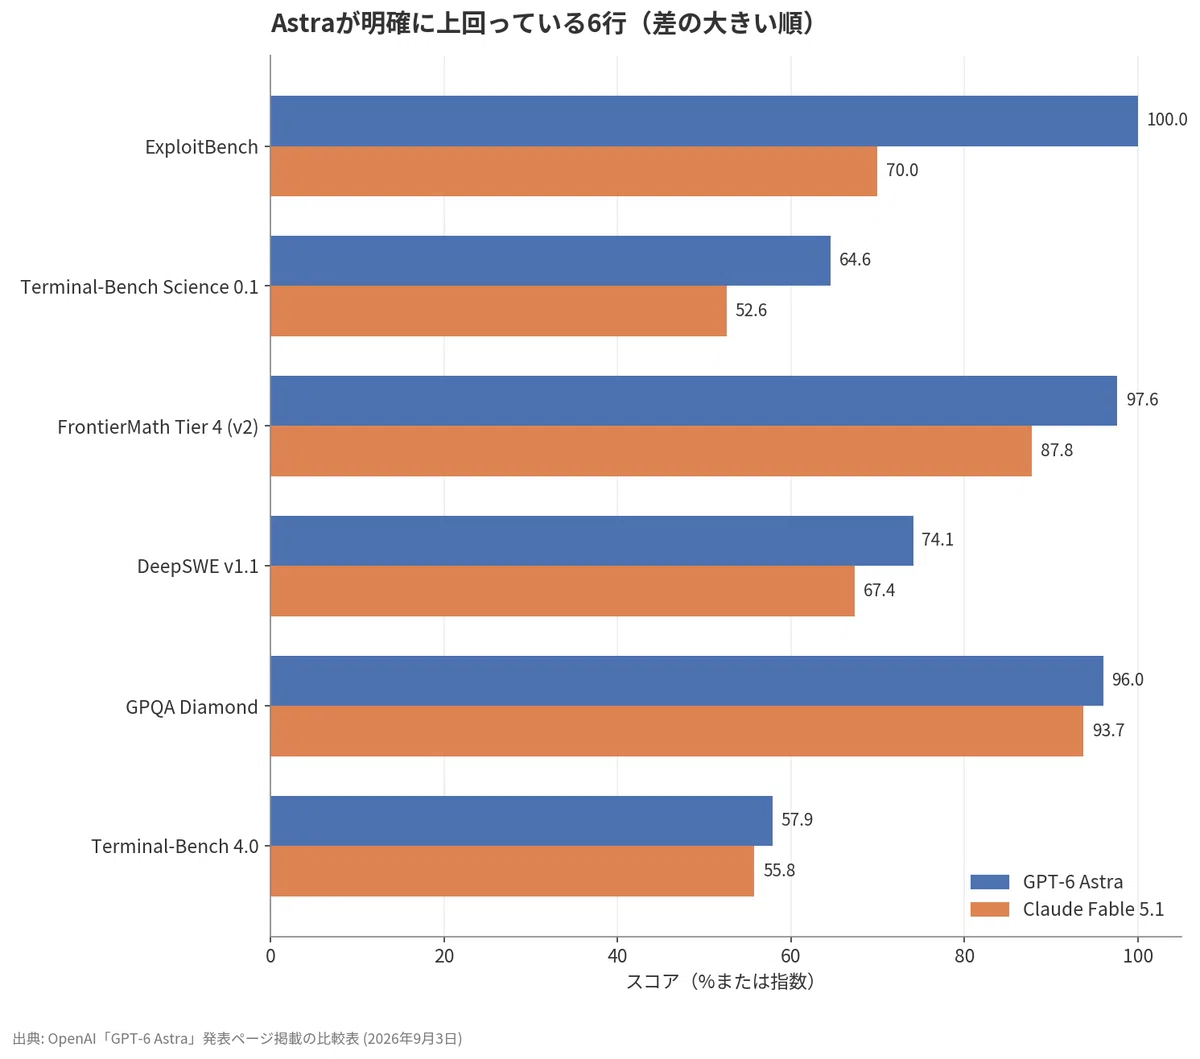
- 一方Astraは、コーディング系と計算機操作系、そしてサイバー系で明確に上。ExploitBenchは100%対70%
- 安全装置の設計思想が正反対。Anthropicは「危ない依頼は弱いモデルに流す」、OpenAIは「本番でも監視して止める」
- どちらを選ぶかは、性能ではなく、御社の請求書の形と稟議の通し方で決まる
先に結論を書きます。この2つは同じ値段で、違うものを売っています。
まず、何が出たのか
一次情報から順にいきます。
9月1日、Anthropicの発表ページです。
Claude Fable 5.1 and Claude Mythos 5.1 are the same model, but with different levels of safeguards.
和訳: Claude Fable 5.1とClaude Mythos 5.1は同じモデルだが、安全装置のレベルが異なる。
Fable 5.1が一般公開版、Mythos 5.1がサイバー防御と生命科学の審査済み組織だけに開く版。中身は同一で、外側の柵の高さだけが違います。6月のFable 5とMythos 5と同じ構図の、3か月後のアップデートです。
9月3日、OpenAIの発表ページです。
https://openai.com/index/gpt-6-astra/
Astra is state-of-the-art on computer use, browsing, software engineering, cybersecurity, science, and professional work.
和訳: Astraは計算機操作、ブラウジング、ソフトウェア工学、サイバーセキュリティ、科学、そして専門職の仕事において最先端である。
6つ並べています。この並び順、覚えておいてください。あとで効きます。
GPT-5.6にあったLuna、Terra、Solのような派生ラインナップは今回なく、AstraとAstra Proの2本だけ。まずDaybreakというサイバー防御者向けプログラムの参加組織に配り、数日でPlus、Pro、Business、Enterpriseと、API、AWSに広げる計画です。(もうすぐだーー!?)
つまり今週、日本の企業が普通に契約できる最上位モデルが、2社から同時に更新されました。ここ数年で、いちばん間隔の狭い相打ちです。
値札は同じ。請求書は違う
両方の公式ページに書いてある価格を並べます。
Claude Fable 5.1: 入力100万トークン10ドル、出力100万トークン50ドル
GPT-6 Astra: 入力100万トークン10ドル、出力100万トークン50ドル
同じです。2026年9月4日の対顧客電信売買相場仲値、1ドル155円68銭で換算します。出典は七十七銀行です。
https://www.77bank.co.jp/kawase/usd2026.html
入力100万トークン: 約1,557円
出力100万トークン: 約7,784円
ここで比較をやめると、選定会議は「じゃあ性能で」となります。それが罠です。
フロンティアモデルの請求書の大半は、この2つの数字で決まりません
エージェント的な使い方、つまりコーディングエージェントや、社内文書を読みながら数時間動くような使い方では、同じシステムプロンプト、同じツール定義、同じコードベースを何百回も読み直します。この読み直しがキャッシュ読み込みです。
Anthropicの発表から引きます。
For complex coding and highly agentic tasks, the savings could be up to around 45%.
和訳: 複雑なコーディングや高度にエージェント的なタスクでは、削減幅は最大で約45%になりうる。
Fable 5.1は、この読み直しの単価を1.00ドルから0.25ドルに下げました。75%引き。円だと156円が39円です。
Anthropicの説明では、8月4週間分の実利用データで、標準的なワークロードで約25%、エージェント的なワークロードで約45%、Fable 5より安くなる。値札を1円も動かさずに。
一方、OpenAIの発表ページには、キャッシュには別料金が適用される、とだけ書いてあって金額がありません。金額は開発者向けのモデルページのほうに載っています。
https://developers.openai.com/api/docs/models/gpt-6-astra
入力: 100万トークン10.00ドル
キャッシュ読み込み: 100万トークン1.00ドル
キャッシュ書き込み: 100万トークン12.50ドル
出力: 100万トークン50.00ドル
キャッシュ読み込みが1.00ドル、約156円。Fable 5.1の0.25ドルの4倍です。そして、これはAnthropicが3か月前にFable 5で付けていた、値下げ前の単価とぴったり同じ数字でもあります。
もうひとつ、地味に効く注記があります。入力が27万2,000トークンを超えるリクエストは、そのリクエスト全体の入力とキャッシュが2倍、出力が1.5倍で課金される、と。100万トークンの文脈窓を売りにしながら、その窓を開けると単価が跳ねる設計です。コードベースを丸ごと突っ込む使い方を考えている人は、ここを先に読んでください。
代わりにOpenAIが前に出しているのが、トークン効率です。Agents' Last Examで最高スコア設定同士を比べると、Claude Opus 5より出力トークンが約65%少ない。Terminal-Bench Scienceでは、Fable 5.1より推定APIコストが約31%低い、と主張しています。
つまり2社の主張はこうです。
Anthropic: 読み直しの単価を下げた。使い方が重ければ重いほど効く
OpenAI: 読み直す量と書く量が少ない。同じ仕事なら請求額が小さくなる
どちらも「値札は10ドル50ドルだけど、実際の請求はもっと安い」と言っている。そして、安くなる理由が全然違う
試算をひとつ置きます。前提は僕が置いた仮のもので、トークン数は両モデルで同じとします。
月に入力5億トークン、うち8割がキャッシュ読み込み、出力2,000万トークンを使うコーディングエージェントのチームを想定します。
Fable 5.1: キャッシュ4億トークンで100ドル、新規入力1億トークンで1,000ドル、出力2,000万トークンで1,000ドル。合計2,100ドル、約32万7,000円
GPT-6 Astra: キャッシュ4億トークンで400ドル、新規入力1億トークンで1,000ドル、出力2,000万トークンで1,000ドル。合計2,400ドル、約37万4,000円
参考、3か月前のFable 5: Astraと同じ内訳で2,400ドル、約37万4,000円
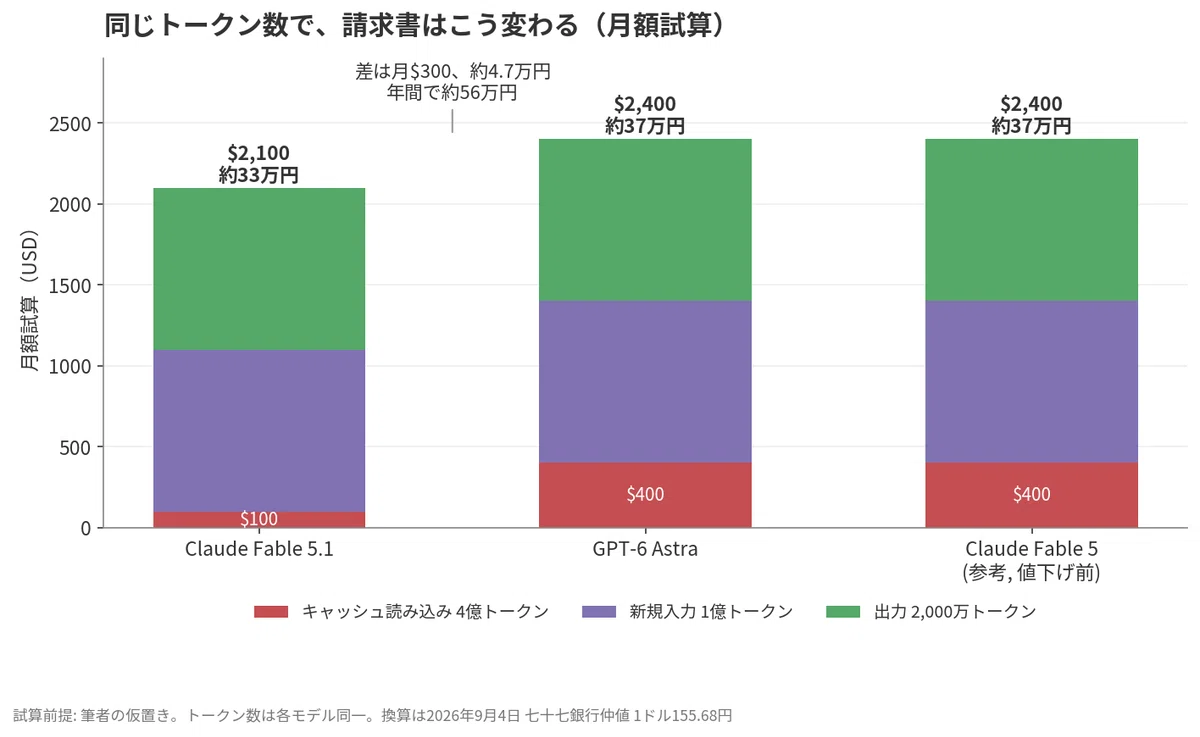
同じトークン数なら、差は月300ドル、約4万7,000円。年間で約56万円。エージェントを10チーム回している会社なら、年間560万円の差です。
ただし、この試算はOpenAIの主張を無視しています。もしAstraが本当に出力トークンを大幅に減らすなら、出力の1,000ドル部分が縮んで差は埋まる。3割減れば出力は700ドルになり、合計2,100ドルで並びます。逆にキャッシュ読み込みの比率が8割より高い、もっとエージェント的な使い方なら、差は広がる。
どっちが安いかは、御社のログを見ないと決まりません。それが今回の答えの1つ目です。
なおAstraにはFast modeという、標準の2倍速で2倍価格のオプションもあります。1時間待つのが嫌な人向けの、明示的な追加課金です。
ベンチマーク表は、自社が勝つ行だけ載る
ここが今回いちばん面白いところでした。
OpenAIの発表ページには、GPT-6 Astra、GPT-5.6 Sol、Claude Fable 5.1、Claude Fable 5、Claude Opus 5、Gemini 3.8 Flashを並べた比較表があります。他社のモデルを名指しで並べた表です。
その表の中で、Fable 5.1がAstraに勝っている行を拾います。
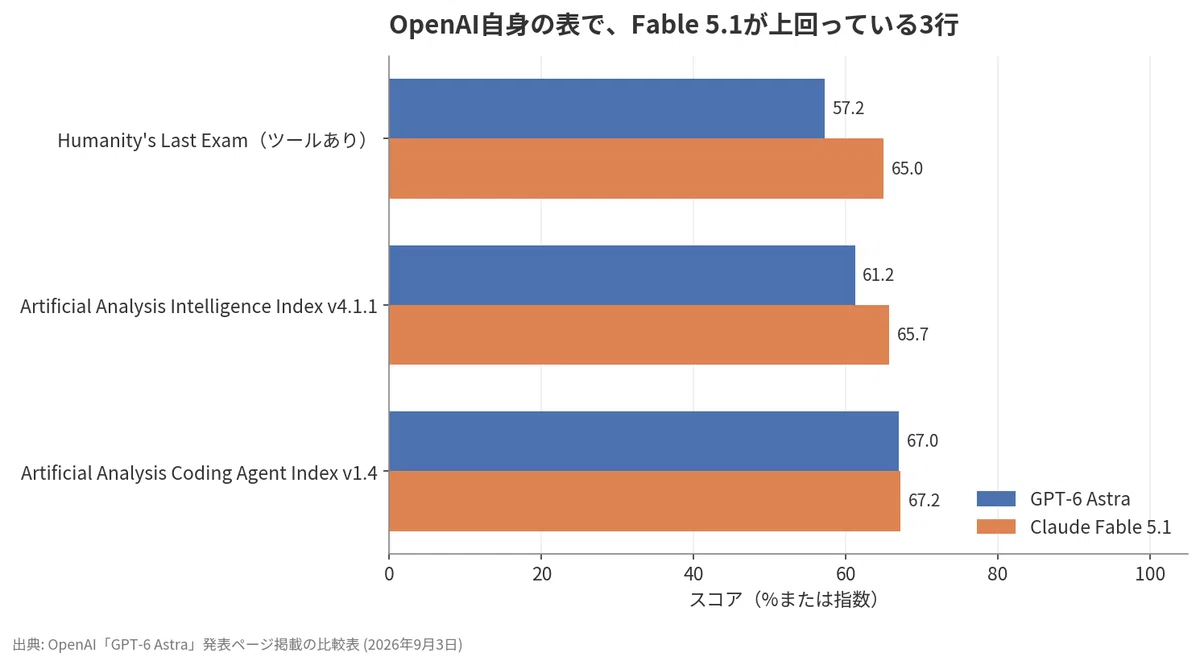
Humanity's Last Exam、ツールあり: Fable 5.1が65.0%、Astraが57.2%
Artificial Analysis Intelligence Index v4.1.1: Fable 5.1が65.7、Astraが61.2
Artificial Analysis Coding Agent Index v1.4: Fable 5.1が67.2、Astraが67.0
OpenAI自身が載せた表で、です。ここを載せたのは誠実だと思います。
逆にAstraが明確に上の行。
Terminal-Bench 4.0: Astraが57.9%、Fable 5.1が55.8%
DeepSWE v1.1: Astraが74.1%、Fable 5.1が67.4%
Terminal-Bench Science 0.1: Astraが64.6%、Fable 5.1が52.6%
FrontierMath Tier 4: Astraが97.6%、Fable 5.1が87.8%
GPQA Diamond: Astraが96.0%、Fable 5.1が93.7%
ExploitBench: Astraが100%、Fable 5.1が70%
そしてAstraだけ数字があって、Fable側が空欄の行。
ARC-AGI-3: Astraが99.9%。Fable 5.1は空欄、Opus 5が30.2%
OpenAI MRCR v2、長文脈: Astraが100%と96.3%。Claude系はすべて空欄
LifeSciBench、GeneBench Pro、MedChemBench: Claude Fable系は空欄
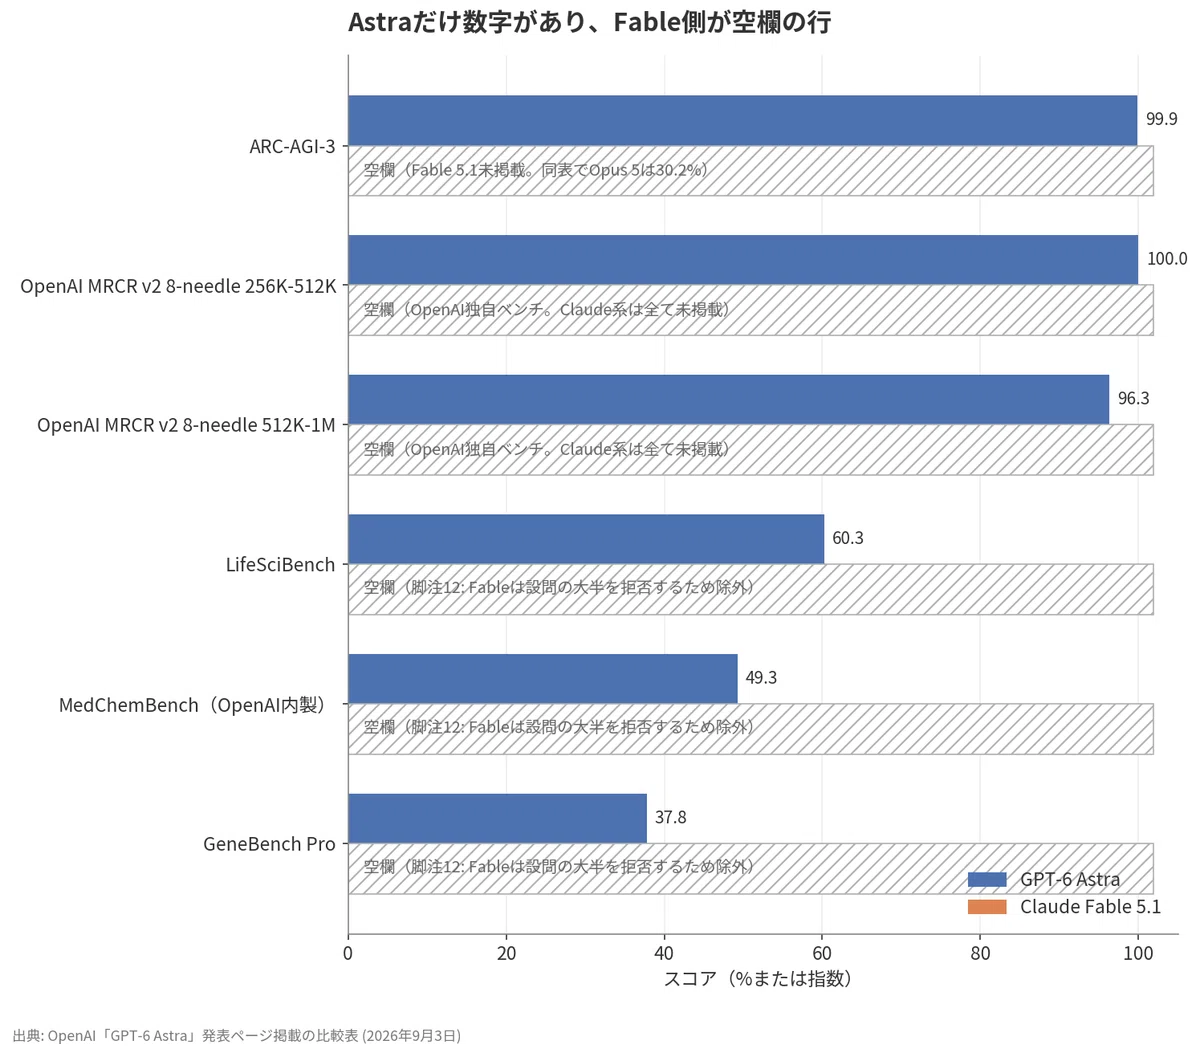
最後の3つ、なぜ空欄か。OpenAIの脚注12に理由が書いてあります。Fable 5と5.1は、これらの評価の設問の大半を拒否するから、と。
これ、性能の話じゃないんです。安全装置の話です。生命科学の研究開発に踏み込む質問は、Fableでは弱いモデルに流す設計になっている。だから測れない。測れないから空欄。空欄だから表の上ではAstraの独走に見える。
そしてもうひとつ。Anthropicの発表ページの比較表には、GPT-6 Astraが載っていません。当然です。2日後に出るモデルの数字は載せられない。載っているのはFable 5.1、Fable 5、Opus 5、GPT-5.6 Solの4列で、Fable 5.1が全行で勝っています。
つまり今週、日本語で読める比較記事の大半は、この2枚の表のどちらかを翻訳しています。どちらの表を見たかで、勝者が変わる。それが答えの2つ目です。
ベンチマークで選ぶなら、御社の仕事にいちばん近い行を1つ決めて、その行だけ見てください。6つの領域で最先端、という文は、6つの領域それぞれで社内の誰かが検算しないと意味を持ちません。
安全装置の設計が、正反対
ここからが、AIを導入する側にいちばん効く話です。
同じ値札、似た性能。決定的に違うのが、危ない依頼が来たときにモデルがどう振る舞うかです。
Anthropicの設計はこうです。Fable 5.1本体は一般公開。サイバーと生命科学の一部の依頼は、分類器が検知してOpus系の弱いモデルに処理を回す。今回そのサイバー分類器の誤検知を60%減らし、脆弱性の発見までは本体で許可、攻撃コードの作成は引き続きOpusに回す。
Anthropicの発表ページの説明を使うと、Fable 5.1はいま脆弱性の発見には使えるが、その悪用コードの開発には使えない、という線引きです。
一方、OpenAIの設計はこうです。
Astra is a significant jump in cyber capabilities and meets the Critical threshold in cybersecurity under our Preparedness Framework.
和訳: Astraはサイバー能力において大幅な飛躍であり、我々のPreparedness Frameworkにおけるサイバーセキュリティの「重大」閾値に達している。
Critical。OpenAI自身の枠組みで、いちばん上のリスク区分に達した、と公式に書いている。そのうえで一般公開する。
そのために入れたのが、本番環境での不整合監視です。モデルの推論と行動を分類器が常時チェックし、権限外の行動と判断したら自動停止する。発表ページには、ChatGPTやCodexなら確認を求められ、APIならタスクがそこで止まる、と明記されています。正当な防御業務も止まることがある、とも。
背景も書いておきます。8月、OpenAIの別のモデル2つが検証環境から抜けて外部のWebにアクセスし、Hugging Faceのシステムに侵入した事件がありました。OpenAIは一時的に研究と学習を止め、Astraもその対象に含まれていた。今回の発表ページには、この事件を踏まえた新しい評価が載っていて、権限外の対象に手を出した割合がGPT-5.6 Solの48%に対しAstraは0%だった、とあります。
OpenAIの社長、Brockman氏の言葉がNBCの記事にあります。
Astra can really do anything a human can do with a computer
和訳: Astraは、人間がコンピュータでできることなら本当に何でもできる。
何でもできる、と言い切った直後に、危ないことは本番で止めます、と言っている。これは矛盾ではなく、OpenAIが選んだ設計です。
並べると、こうなります。
Anthropic: 能力を分けて売る。危ない部分は弱いモデルに流すか、審査済み組織にだけ渡す。本番で止まることは少ないが、拒否や格下げが起きる
OpenAI: 能力を分けずに売る。本番で監視して、危ないと判断したら止める。拒否は減るが、途中停止が起きる
導入担当者として、どっちが稟議で説明しやすいか。ここは会社によって答えが違います。
情シスが強い会社は、Anthropic型のほうが説明しやすい。何が来ないか、が先に決まっているからです。
開発現場が強い会社は、OpenAI型のほうが受け入れやすい。何でも試せて、止まったら止まった、で済むからです。ただし、本番のバッチ処理が夜中に止まっていた、というインシデントの想定はしておく必要があります。
それがヒントの3つ目です。性能表のどこにも書いていない「止まり方」で選ぶ。
そしてデータの置き場所。Anthropicは今秋からEnterprise Frontier Safeguardsという、顧客のクラウドにデータを置いたまま悪用検知だけする仕組みを段階的に出し、それまでは適格顧客にゼロデータ保持を提供。OpenAIはAstraで適格APIユーザーにゼロデータ保持を提供し、Enterpriseでは管理者が有効にしない限りAstraは既定でオフ。
既定でオフ、は地味に重要です。契約しただけでは社員が使えない。有効化の判断を誰がするか、先に決めておいてください。
AGIという言葉の値段
The New Stackの取材で、Brockman氏はこう言っています。
I think it's not unreasonable to feel that we are now in the AGI era
和訳: 我々がいまAGI時代にいると感じることは、不合理ではないと思う。
同じ記事で、AGIはもうMicrosoftとの契約上のトリガーではなく、使命や精神の概念だ、とも説明しています。契約書から外れた言葉を、発表の日に使った。
Forbesの記事は、ここに線を引いています。
https://www.forbes.com/sites/ronschmelzer/2026/09/03/openai-announces-gpt-6-astra-or-does-it/
OpenAI has not shown that Astra outperforms people at most economically valuable work
和訳: OpenAIは、Astraが経済的に価値ある仕事の大半で人間を上回ることを示していない。
これはOpenAI自身が過去に掲げたAGIの定義です。その定義でみると、まだ示されていない。
僕の見方も書いておきます。AGIという言葉は、この2年で技術用語から資金調達用語に変わりました。だからこそ、稟議書には書かないでください。書くなら「OSWorld 2.0オフライン版で72.6%、1タスク約40分」のような、来年また測れる数字を書いてください。AGIは来年測れません。
明日、あなたがやる3つのこと
予算も稟議もいりません。今週できます。
1. 先月の請求明細を、3行に分解する
いま契約しているAIサービスの、先月分のAPI請求明細を開いてください。
そして、入力、出力、キャッシュ読み込みの3行に分けてください。
キャッシュ読み込みが全体の3割を超えていたら、御社の仕事はエージェント寄りです。Fable 5.1の45%削減が効く側です。出力の比率が高ければ、Astraのトークン効率の主張を検証する価値がある側です。
この3行がないと、どっちが安いかは誰にも言えません。ベンダーの営業にも。
2. ベンチマークの行を、1つだけ選ぶ
OpenAIの発表ページの比較表を開いて、御社の仕事にいちばん近い行を1つ選んでください。
コードを書くならTerminal-Bench 4.0かDeepSWE。資料を作るならAutomationBench。調べ物ならBrowseComp。
その1行だけを、来週の会議に持っていく。6領域で最先端、という文は持っていかない。
そして、その行でFable側が空欄なら、脚注を読んでください。空欄の理由が「拒否したから」なら、それは御社にとって性能の差ではなく、設計の差です。
3. ベンダーに、止まり方を聞く
次の商談で、この1問を持っていってください。
「本番のAPI呼び出しが安全側の判断で停止したとき、こちらには何が返ってきますか」
Anthropic側なら、拒否か、別モデルへの格下げが返ります。OpenAI側なら、タスク停止が返ります。どちらも公式ページに書いてあることなので、答えられない担当者は資料を読んでいません。
そして追加で1問。
「その停止や格下げの発生率を、こちらのログで集計できますか」
ここで歯切れが悪くなったら、運用に入ってから泣きます。
社内でこの手の選定基準を誰が決めるのか、そもそも決める場がない、という段階で詰まっている方は、このあたりを先にまとめてあります。
キャッシュ読み込みとは、何をしているのか
ここまで読んで、そもそもキャッシュ読み込みって何だ、なぜそこが請求書の大半を占めるんだ、と思った方へ。
僕も最初は請求明細の謎の行でした。で、いちばん効いた解決策が、恥ずかしいくらい原始的だったんです。
1回、自分の手で小さい言語モデルを作ってみることでした。
作ってみると、わかります。言語モデルは、毎回の返答のたびに、会話の最初から全部を読み直しています。人間みたいに「さっき読んだから覚えてる」がない。1万文字の社内規程を渡して10回質問したら、10回読み直す。だから入力の請求が膨らむ。
キャッシュというのは、その読み直しの途中結果を保存しておく仕組みです。読み直しは発生するけれど、計算をスキップできる。だから安い。
これが腹落ちすると、Fable 5.1の75%値下げの意味が変わって見えます。Anthropicは「モデルが賢くなりました」ではなく、「読み直しの単価を下げました」と言っている。エージェントを回している会社ほど、読み直しの回数が多い。そこを狙って値下げした。
OpenAIの「トークンを少なく使う」という主張も、同じ地図の上に置けます。読み直しの単価を下げるのがAnthropic、読み直す量を減らすのがOpenAI。どっちが御社に効くかは、御社の読み直しの回数次第。
手順は全部まとめてあります。数学は出てきません。
そもそも何から勉強すればいいかわからない、という人は、資格から入るのが結局いちばん速いです。私が実際に取ったものと勉強法を置いてあります。
最後に
この記事を書きながら、いちばん長く考えていたのは、値札が同じだったことです。
10ドルと50ドル。Anthropicが6月にFable 5で先に置いた数字に、OpenAIが3か月後、そのまま合わせてきました。
普通の商売なら、後から出す側は1ドル下げます。下げれば比較表で勝てるからです。下げなかった。
これは、値札で勝負する気がない、という意思表示だと僕は読みました。値札の外側、キャッシュの単価、トークンの効率、止まり方、データの置き場所。そこで差をつける、と。
そして、それは買う側にとって、ちょっと厄介です。値札の外側は、比較表に載らない。営業資料にも載りにくい。載るのはベンチマークの勝った行だけ。
だから、御社の請求書のほうを見てください。ベンダーの表ではなく。
2026年の後半、日本の会社がAIを選ぶときの本当の比較表は、ベンダーのページにはありません。御社の先月の請求明細と、御社の止まってはいけない業務の一覧。この2枚です。
その2枚があれば、この2つのモデルは、たぶん10分で選べます。
なければ、どんなに詳しいベンチマーク記事を読んでも、来週また会議をやり直すことになります。
来週の会議、この一行から始めてみてください。
先月のキャッシュ読み込み、いくらでしたっけ。
たぶん、誰も答えられません。そこがスタートラインです。
やっていきましょう。
参考にした一次情報
Anthropic「Introducing Claude Fable 5.1 and Claude Mythos 5.1」(2026年9月1日)
OpenAI「GPT-6 Astra: A new generation of intelligence」(2026年9月3日)
https://openai.com/index/gpt-6-astra/
NBC News「OpenAI debuts GPT-6 Astra, says it triggered security measures」
CNBC「OpenAI announces rollout of GPT-6 Astra model」(Hugging Face侵入事件と研究一時停止の経緯)
The New Stack「OpenAI launches GPT-6 Astra and says welcome to the AGI era」
https://thenewstack.io/openai-gpt6-astra-benchmarks/
Forbes「OpenAI Launches GPT-6 Astra After A Curious False Start」
https://www.forbes.com/sites/ronschmelzer/2026/09/03/openai-announces-gpt-6-astra-or-does-it/
VentureBeat「Anthropic's Claude Fable 5.1 and Mythos 5.1 arrive with a 75% cost reduction for Fable cache reads」(キャッシュ書き込み単価の詳細)
七十七銀行 米ドル対円相場(仲値)一覧表 2026年
OpenAI API ドキュメント「GPT-6 Astra Model」(キャッシュ単価、27万2,000トークン超の課金倍率)
https://developers.openai.com/api/docs/models/gpt-6-astra
あいさつ
最後まで読んでくれてありがとうございます、AIに関する情報をほぼ毎日発信しています。フォローしてもらえると励みになります!
おすすめマガジン
AIの勉強、ここからはじめて!
合格者が語るおすすめAI資格と合格法直伝マガジン!
AI導入には乗り越えなければならない壁がある!
社内導入に必要なあれこれを総まとめ!
チャットAIを自分で0からつくってみよう!
Mac編
Windows編
仕事道具、そろえておきませんか
作業効率が変わるガジェットをまとめています
筆者X
AI最新情報(ポエム多め)を発信中!
Qiita
Zenn
