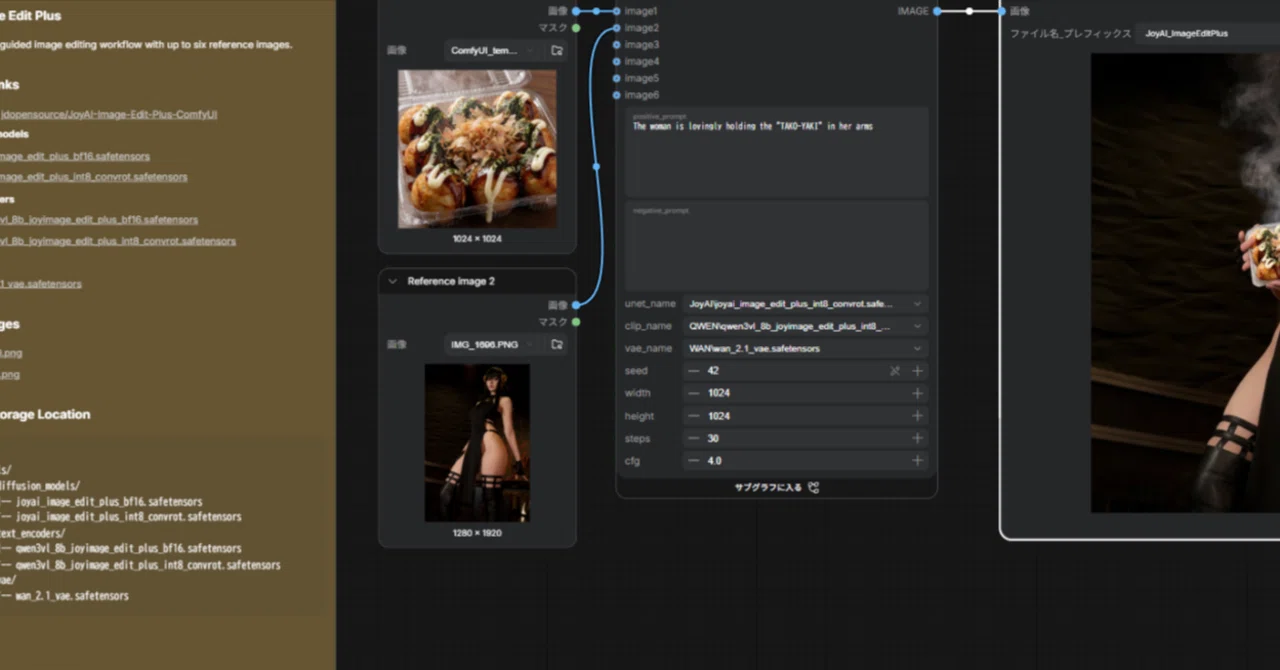
出来立てのJoyAI-Image-Edit-Plus-Comfyui を触ってみたー

ということでアップされたばかりのようなJoyAI-Image-Edit-Plus-Comfyui というモデルを触ってみました。
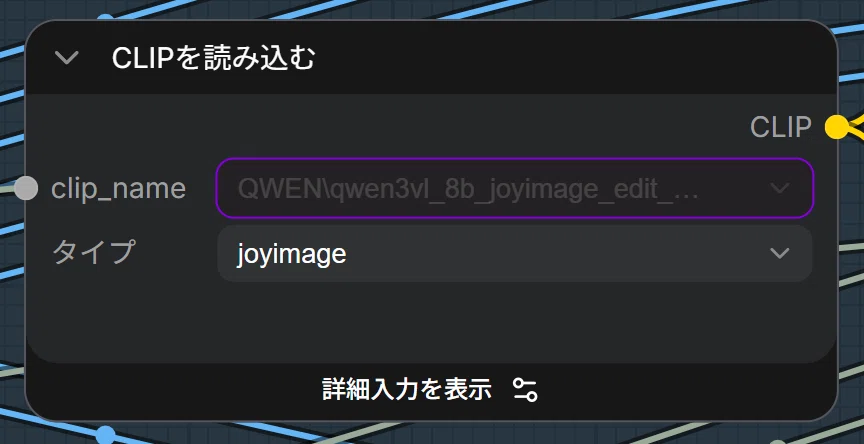
必要なモデル、テキストエンコーダ、VAE、は hugginface、github にて入手可能、テキストエンコーダとモデルがセットなので使用するにはComfyのアップデート必須でタイプを合わせる必要があるようです。
入力画像1、入力画像2にそれぞれ指定して作った画像がこれ。
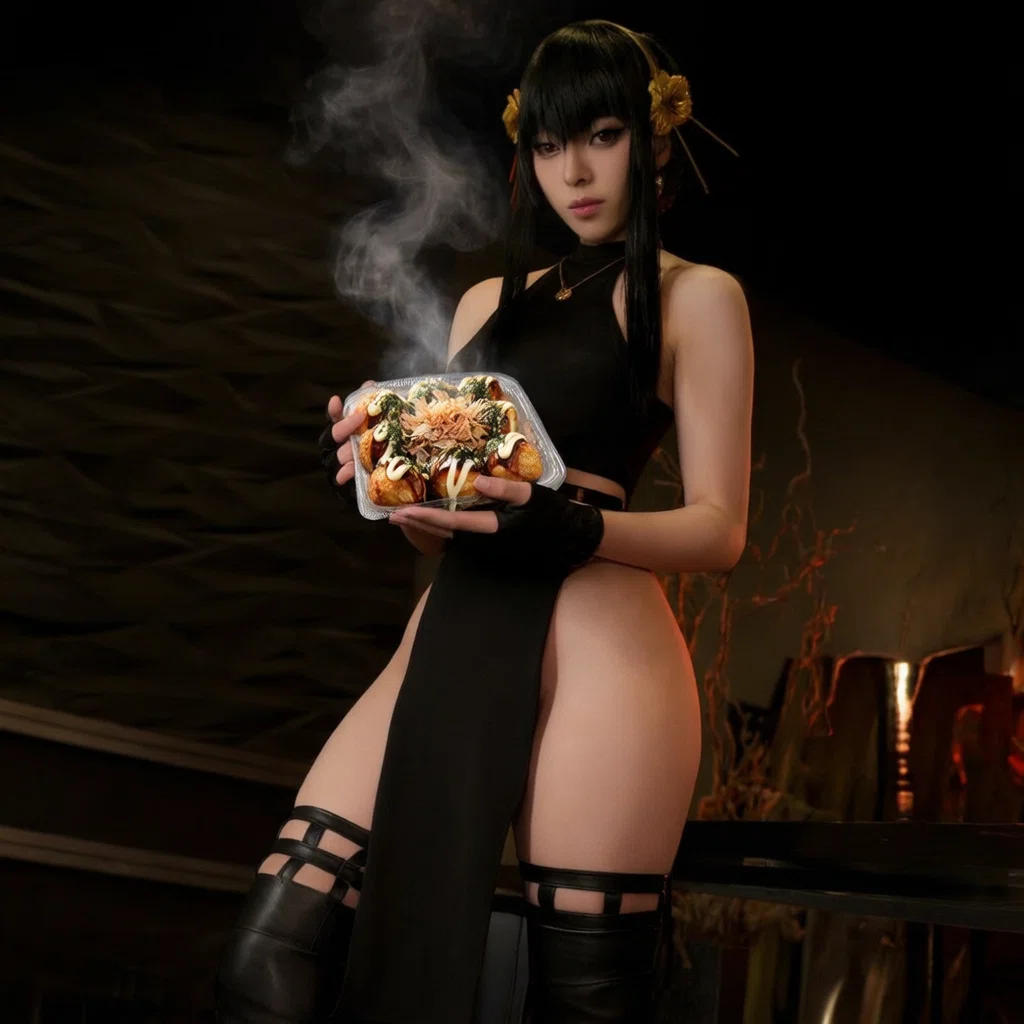
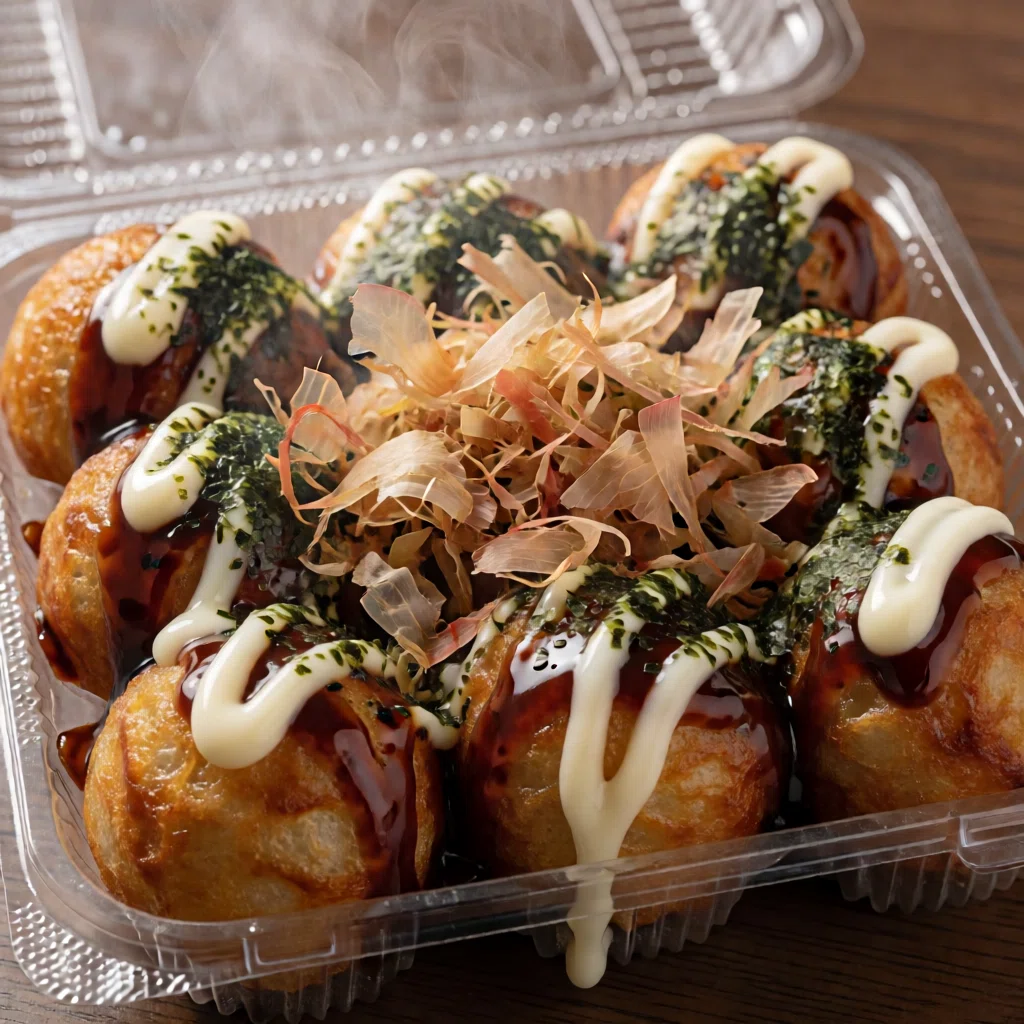
プロンプトに「The woman is lovingly holding the "TAKO-YAKI" in her arms」とだけ。
このモデルの秀逸なところは画像1とか2とか指定しなくても"woman","TAKO-YAKI"と書くだけで勝手に判断してくれるところ。
サンプルワークフローも同じページに載ってました。サンプルでは「子犬」になってたところを「たこ焼き」に替えただけ。出力は1024x1024の正方形のみみたいですが、勝手にアウトペイントまでしてくれています。
以上です。
