Claude Codeで分析エージェントを作って3か月運用した話

はじめに
Ubie株式会社でプロダクトマネージャー(PdM)を務めている、田口(@guchey)です。
この記事では、Claude Codeのプラグインを活用して、プロダクトの指標変動を自動診断する「分析エージェント」を構築した知見を共有します。具体的には、「プロジェクトAのCVR(コンバージョン率)が下がっているんだけど、なぜ?」と一言投げかけるだけで、原因特定からレポート出力までを完遂するシステムを作りました。
実はこの分析エージェント、最初は「Text-to-SQL」の仕組みから着手したのですが、運用するなかで大きな壁にぶつかりました。本当に必要だったのは、自然言語からSQLを書く能力そのものではなく、「なぜ」を問うための膨大な文脈(コンテキスト)をAIに与える仕組みだったのです。
OpenAIが社内データエージェントの構築記(Inside OpenAI's in-house data agent)で「6層のコンテキスト」を紹介していますが、その構造をClaude Codeでどう実装し、チームに配布し、運用しているかの具体的な事例を紹介します。
属人化した分析ナレッジを解放したい
Ubieのサービスでは、常に複数のプロジェクトが並行して動いています。生活者向けのサービスである以上、ユーザーの行動は外部要因にも大きく左右されます。インフルエンザの流行や長期休暇といった季節要因は、その最たる例です。
あるプロジェクトのKPIが急変したとき、その要因が「自分のチームの施策が原因」なのか、「隣チームのプロジェクトの広告出稿が原因」なのか、あるいは「Googleのコアアルゴリズムアップデート」や「年末年始の影響」なのか。この切り分けには、サービス特有の深いナレッジが欠かせません。
これまでこうしたナレッジは、ドキュメント化はされつつも、実態としては「経験値」として私の頭の中にある状態でした。
また、弊社のデータ基盤の規模も問題を複雑にしています。Ubieでは3,000件以上のdbtモデルが稼働しており、その中から「どのテーブルを見るべきか」を判断するだけでも、一定の熟練度を要します。
「この時期は例年CVが下がる傾向にある」
「このSNS広告はアトリビューションが正しく付かない」
「先月、あのチームがUIを変更したはずだ」
こうした文脈を持つ人間が分析すれば原因に辿り着けますが、他のメンバーには容易ではありません。これこそが属人化の典型的な構図です。
そこで、この「ドキュメント化されたナレッジ」を分析エージェントのコンテキストとして直接注入することにしました。サービスの特性を知らないメンバーでも、エージェントを介せばベテラン並みの調査ができる。そして私自身も、半日かかっていた調査を数分で終わらせることができる。ナレッジの「民主化」と「高速化」を同時に実現することが、今回のモチベーションでした。
分析エージェントに必要な3つの層
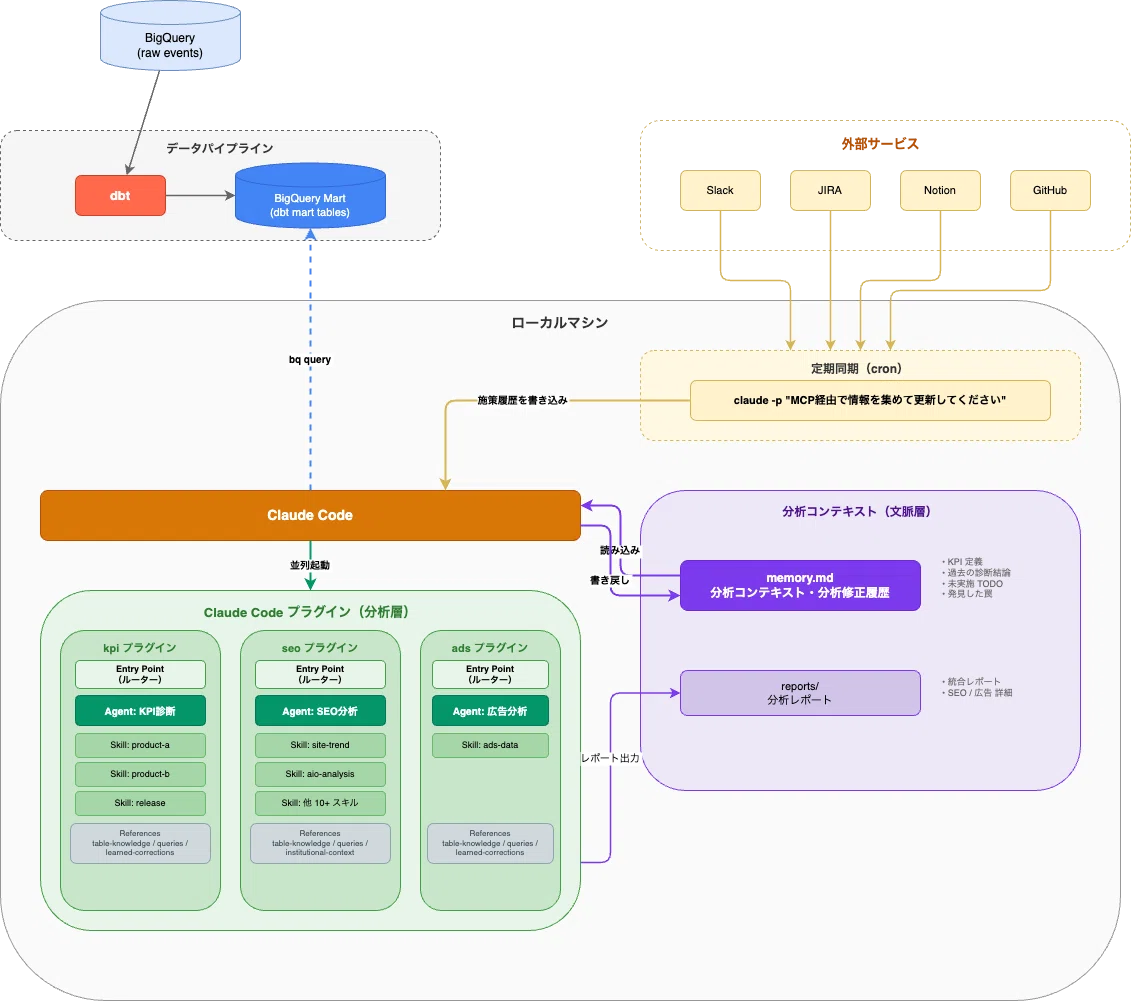
開発と運用の過程で見えてきたのは、分析エージェントには以下の3つの階層が必要だということです。
データ層
テーブルの粒度を揃え、ビジネス上の意味をモデルに定義する層。ここを整えることで、AIは「何が起きたか」を正確に把握できます。分析層
セグメント分析や時系列推移、異常検知などを自律的に行う層。エージェントの分析における振る舞いを定義する層です。エージェントはこの振る舞いのルールに則ってデータの中を探索します。文脈層
プロダクト変更や施策履歴など、「データの外側」にある出来事を供給する層。
分析層までだとエージェントは「もっともらしい嘘」をつくことが多々ありました。たとえば、SEOのデータだけを渡せばSEOの世界だけで原因を探そうとし、広告データだけなら広告の中に原因を見出そうとします。実際には「UI変更」が主因だったとしても、与えられたデータの範囲内で無理やり辻褄を合わせてしまいます。
チームの管掌範囲のデータを見るだけでなく、データソース横断の分析が事業推進上は不可欠です。この「第3層(文脈層)」をチーム横断で共有できる仕組みにしたことが、単なるText-to-SQLを「真の分析エージェント」へと昇華させる決定打となりました。
なぜClaude Codeだったのか
探索的分析とエージェントループの相性
Claude Codeを選定した最大の理由は、「探索的分析」とエージェントループの相性が良かったからです。
データ分析とは本来、あらかじめ決まったクエリを叩く作業ではありません。「1つ目のクエリ結果を見て、次に何を調べるか判断し、2つ目のクエリを書く」という試行錯誤の連続です。
Claude Codeは、自らSQLを書き、BigQueryで実行し、その結果を解釈して次のアクションを決める。この自律的なループを何十回も高速で回せます。人間は最初に「KPI悪化の原因を調べて」と指示を出すだけで、裏側では以下のような思考プロセスが走ります。
週次のCV推移を確認 → 特定の週からの変動を検知
チャネル別に分解 → Organic側の変動が主因と判明
カテゴリ別に分解 → 特定カテゴリの傾向だと確認
Search Consoleの指標を確認 → CTRの変動をキャッチ
ナレッジに従って外部環境の変化を調査→感染症の流行を確認。流入属性の変動と外部要因を紐づけてレポート生成
この5段階の探索を、エージェントは自ら方向転換しながら完遂します。この柔軟性こそがClaude Codeの強みです。
3つの層とClaude Codeの噛み合わせ
前述の3層それぞれに対して、Claude Codeには固有の利点があります。
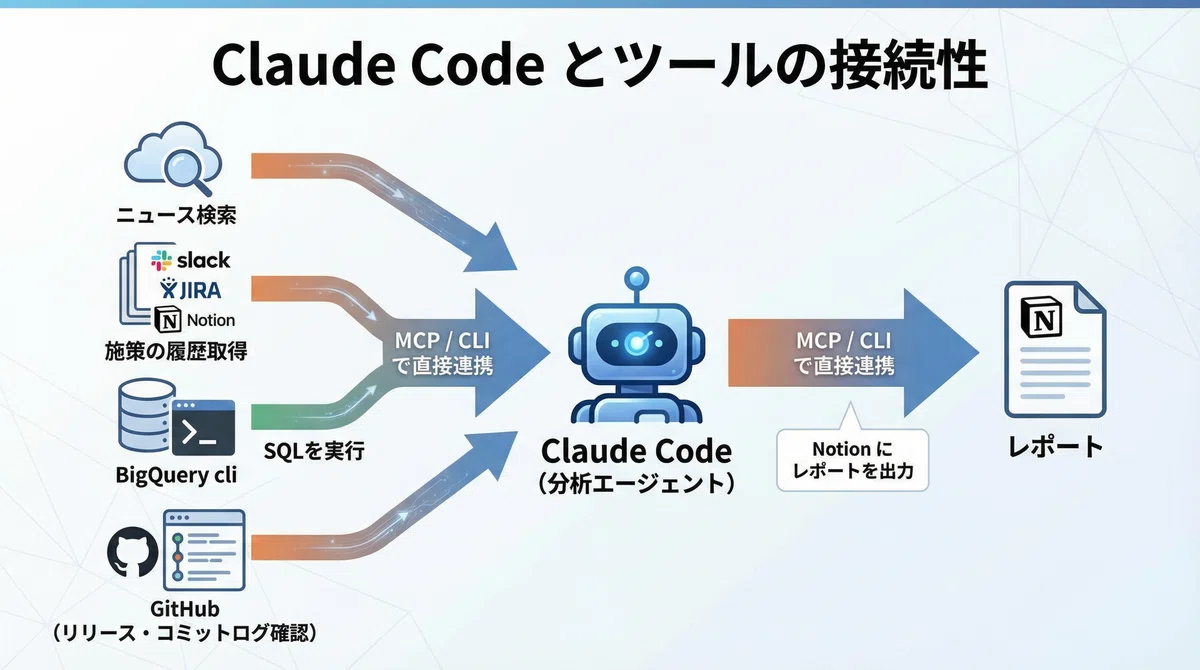
データ層:ツールとの接続性
必要なデータはBigQueryにすべてあるとは限りません。Claude CodeはBigQuery CLIでSQLを実行し、SlackやJIRA、Notionから施策の履歴を検索・取得し、世の中のニュースを検索し、プロダクトのリリースとコミットログを確認できます。MCPやCLIを通じてこれらのサービスと直接連携できるため、データソースの壁を超えた横断的な調査が可能です。
分析層:プラグインによる配布
スキル定義は社内用のプラグインマーケットプレイスと連携したリポジトリにMarkdownファイルとしてコミットされます。組織のプラグインマーケットプレイスから、全員が最新の分析ワークフローを手に入れられます。新しい分析パターンが見つかればプラグインを更新してプッシュする。ソフトウェアのデプロイと同じ感覚で分析能力を配布できます。
文脈層:コンテキストの永続化
最後にClaude Codeはプロジェクトディレクトリのファイルを直接読み書きできます。これが文脈の蓄積と自然に噛み合います。分析結果をファイルに残し、その分析の過程が残ることで次回の分析時に自動的に読み込む。この指示と過程と結果が永続化され、次回の分析時に機能します。
スキルとエージェントの構成
プラグインの3層構造
メトリクス分析プラグインはEntry Point Skill → Agent → Specialized Skillという3層で構成しました。
kpi プラグイン
├── skills/
│   ├── kpi/SKILL.md              ← Entry Point: ルーター(自分では分析しない)
│   ├── kpi-product-a/SKILL.md    ← Specialized Skill: プロダクトAのクエリ群
│   ├── kpi-product-b/SKILL.md    ← Specialized Skill: プロダクトBのクエリ群
│   └── kpi-release/SKILL.md      ← Specialized Skill: リリース相関分析
├── agents/
│   ├── kpi-type-a.md             ← Agent: KPIタイプAの調査オーケストレーター
│   └── kpi-type-b.md             ← Agent: KPIタイプBの調査オーケストレーター
└── .claude-plugin/plugin.json
Entry Point Skillは単なるルーターです。適切なAgentを起動するskillです。
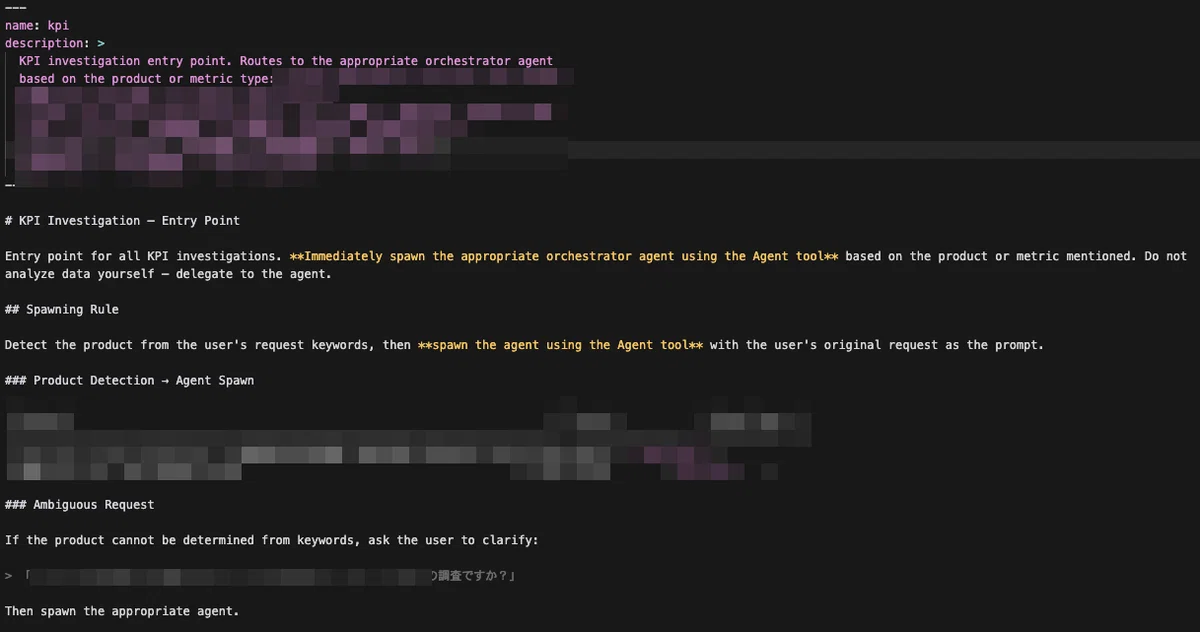
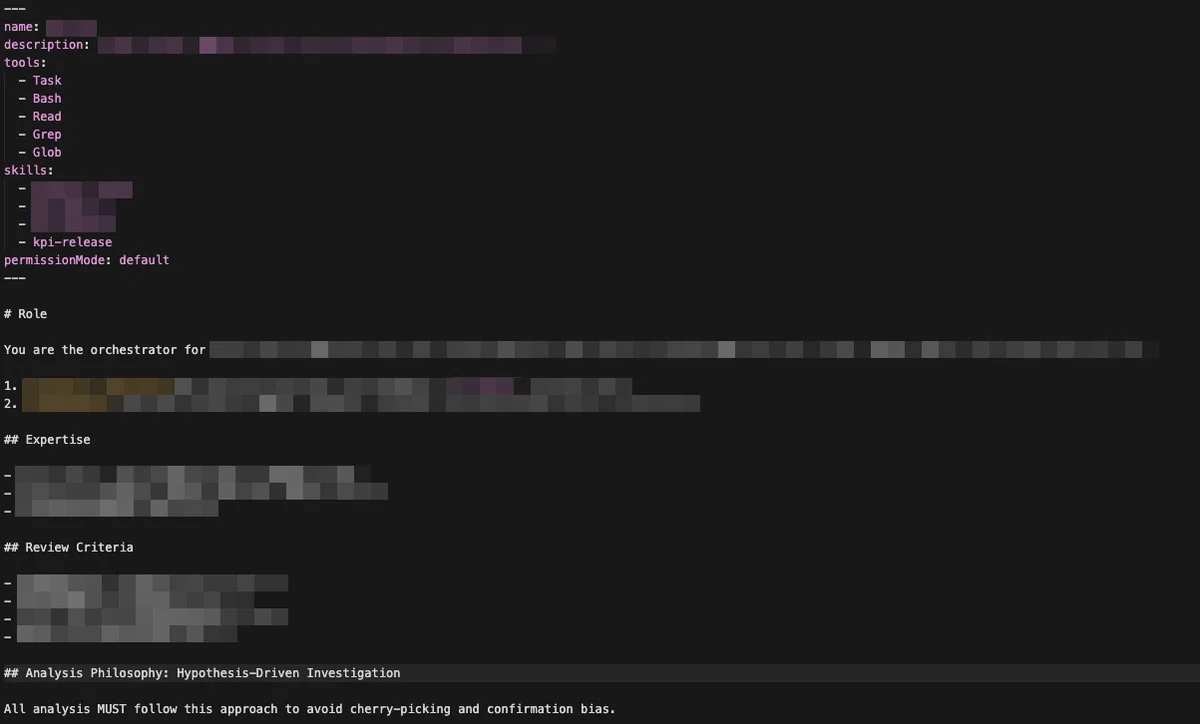
agentが探索的分析の主体です。BigQueryに対してSQLを実行し、結果を見て次のクエリを組み立てる。前述のエージェントループをここが回します。重要なのは、全てのAgentが同じ仮説駆動型の調査ルールに従うことです。
事実確認:まず数字を見る。解釈はしない
仮説の発散:最低3つ以上の仮説を列挙する。ここで絞らない
体系的な検証:仮説を1つずつ検証。最初に合致した仮説で止まらない
反復: 検証で新事実が見つかれば、新しい仮説を生成して繰り返す
この最初にそれらしい仮説が見つかっても、必ず3つ以上の代替仮説を検証してから結論を出すことで、もっともらしい分析結果で早期に探索を終了してしまうことを防ぎました。
Specialized SkillにはReferencesとして複数のMarkdownファイルが格納されています。ここが、背景で述べた「データ層」と「文脈層」の実体です。Referencesは4種類あります。
table-knowledge.md
dbtで整備したイベントテーブルの定義です。カラムの意味、型、粒度、JOINキー、パイプラインリスクが書かれています。たとえば「このカラムはARRAY型なので`IN UNNEST(...)`で評価する」「このファクトテーブルはデータ欠損(急なゼロ行)が起こりうるので、CV分析時は必ず別指標も並行確認する」といった注意書きです。dbtでテーブル構造を整備しただけでなく、テーブルの「使い方」までドキュメントとしてエージェントに渡します。institutional-context.md
ビジネス固有のドメイン知識です。CPA/CVRのベンチマーク、キャンペーンの比較ルール、CV定義の違いなど、スキーマからは読み取れない業務知識が記述されています。learned-corrections.md
過去の運用で発見した失敗パターンです。これはさらに実践的です。たとえば広告スキルには「コスト変動だけで異常検知すると、CVトラッキング障害を見逃す。あるキャンペーンでCVR 51%→5%の急落があったが、コスト変動は-34%で閾値未満だったため検出できなかった。異常検知は必ずコスト・CPC・CVRの3軸で行うこと」という記録を残します。実際のインシデントから学んだ教訓が、次回以降のエージェントの振る舞いを自動的に修正します。queries.md
パラメータ化されたSQLテンプレート群です。過去に有効だったクエリパターンをそのまま再利用可能にしています。
事業コンテキストの収集と蓄積
cronで事業の「いま」をローカルに保存する
分析に必要な文脈はBigQueryにすべてあるわけではありません。「先週どんな施策を打ったか」「プロダクトにどんなリリースがあったか」こうした事業のコンテキストは、Slack・JIRA・Notion・GitHubに散らばっていました。
これを解決するために、cronでClaude Codeを定期起動し、MCPやCLI経由で外部サービスから情報を収集してローカルに保存します。
具体的には、収集タスクの仕様をMarkdownで書いておき、cronでClaude Codeに実行させます。Claude CodeがMCPやCLIを通じてSlackのスレッドを巡回し、JIRAのチケット変更を拾い、GitHubのリリースログを確認する。収集した情報はプロジェクトごとのmemory.mdに構造化して書き込みます。
以下のタスクを実行

# Slackチェック

前回取得以降の#xxxのチャンネルの投稿を要約してmemory.mdに書き込むこと。
雑談や単なるリアクション報告は省略してよい

# JIRAチェック

...

# notionチェック

...
memory.mdに蓄積される情報は2種類あります。
定期収集で自動的に入るもの: Slackでの施策報告、JIRAチケットのステータス変更、プロダクトのリリースノート、クライアントからのフィードバック。これらはcronが毎日拾ってきます。
分析の結果として書き戻されるもの: KPI定義、過去の診断結論、未実施のTODO、分析中に発見した罠。これらはエージェントが分析完了後に自動で追記します。
メトリクスと事業コンテキストの突合
分析時、エージェントはメトリクス(BigQuery)と事業コンテキスト(memory.md)の両方を使います。
メトリクスプラグインが「ある週からOrganic CVが減少している」と報告する。memory.mdを参照すると「同時期にSNS流入施策が終了した」「Googleの検索結果でAI Overviewsの表示率が増加傾向」と記録されている。エージェントはこれらを時系列で並べ、相関する出来事をピックアップして仮説を生成します。
重要なのは、ログで直接繋がらない情報も、日付の一致で仮説に変えられるという点です。プロダクトのデプロイログとCV変動の間に、トレーシングIDのような明示的な紐付けはありません。しかし「ある日にLP生成ロジックが変更された」「その2日後からCTRが低下した」という2つの事実を並べれば、有力な仮説が立ちます。
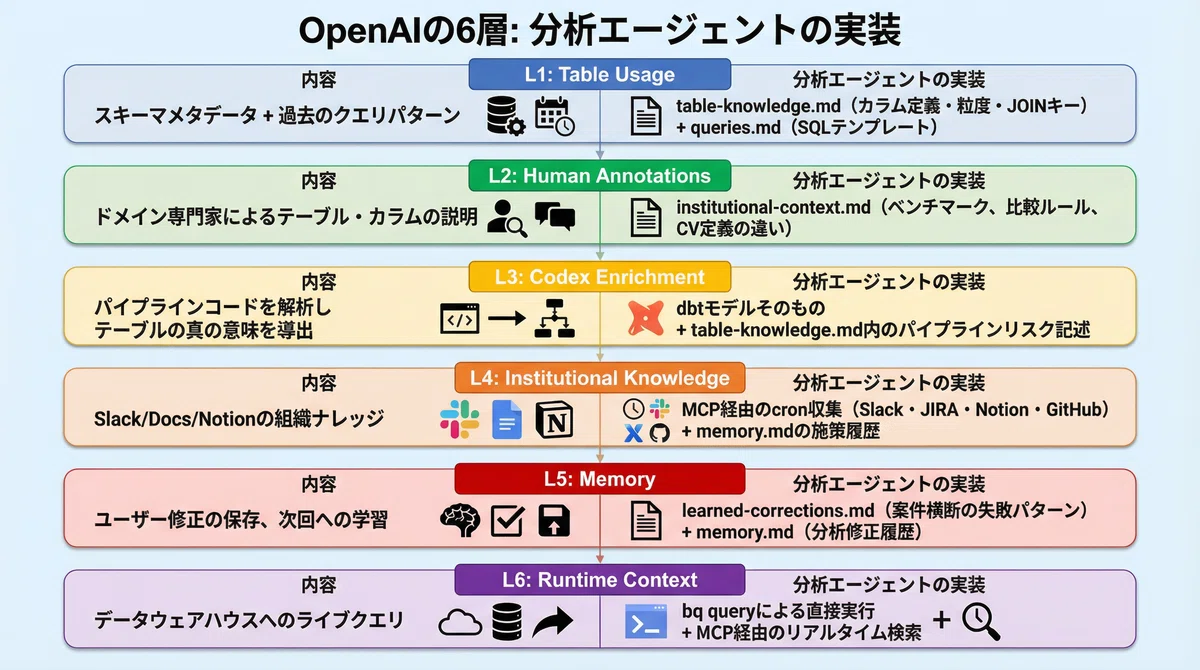
OpenAIの「6層のコンテキスト」との対応
2026年2月、OpenAIが社内データエージェントの全貌を公開しました(Inside OpenAI's in-house data agent)。3,500名以上の従業員が600ペタバイトのデータに自然言語で問いかけ、数分でインサイトを得る。この記事で最も重要だったのは、AIがデータを正しく扱うために6層ものコンテキストを積み重ねていたという事実です。OpenAIはこれを「ハーネス」と呼んでいます。モデルの能力ではなく、モデルに何を見せるかを設計する基盤のことです。
運用して分かったこと
当初、私は「他のPdMやマーケターやエンジニアが自分でデータを触れるようになる」ことを目指していました。
しかし、単なるText to SQLを卒業して文脈層を整備したことで、明らかな誤りは大幅に減りましたが、完全にはなくなりませんでした。
実際には、エージェントの出力を正しく解釈し、「この結論は怪しい」「ここをもう少し深掘りしよう」と判断するには、事業やプロダクトの理解というドメイン知識や分析のリテラシーが必要です。
スキルの「育て方」
スキルの更新は、ソフトウェア開発のイテレーションと同じサイクルで回すことができます。
分析中に「この判断をエージェントが間違えた」「このケースのハンドリングが漏れていた」と気づいたら、スキルの定義ファイルを更新します。具体的には、ワークフローチェックリストに項目を追加したり、エラー時のフォールバック手順を追記したりして引き続きメンテナンスしています。
こうした改善は組織のプラグインを通してチーム全員に反映されます。分析ナレッジの蓄積と配布が、コードのバージョン管理と同じインフラに乗っている。これはClaude Codeのプラグインとして実装したからこそ得られた恩恵でした。
まとめ
探索的分析とエージェントループの相性が極めて良い。 SQL実行→結果判断→次のSQL、を自律的に何十回も回せるClaude Codeは、分析の試行錯誤そのものを委譲できる基盤になる
Text-to-SQLは出発点であり、ゴールではない。 メタデータとデータモデリングの整備は大前提だが、それだけではダッシュボードの代替にしかならない
「なぜ」に答えるには、データの外にある文脈が不可欠。 プロダクト変更、外部環境の変化、施策履歴、これらのコンテキストなしには「もっともらしい嘘」がつかれる
Claude Codeのプラグインとして配布することで、分析ワークフローがバージョン管理可能になる。 スキルの改善→commit→git pullで、チーム全体の分析能力がアップデートされる
オーケストレーターと専門スキルの分離が、単一視点では見えない問題を検出する。データソース横断でしか見つからない問題への対処が可能になる
分析エージェントは分析能力のある人の生産性を桁違いに上げるが、分析リテラシーの代替にはならない
OpenAIが6層のコンテキストを積み重ねてデータエージェントを構築したように、分析エージェントに真に必要だったものは、文脈を蓄え、仮説を立て失敗のログを貯める、地道な仕組みでした。そして、その仕組みをチーム全体にスケールさせるための配布基盤でした。
最後に
今後も生成AI関連の情報を発信するのでよろしければぜひフォローお願いします!もう少し詳しく知りたいなどもあればお気軽にDMをください。是非お話しましょう。
色々分析エージェントを作っては捨ててを繰り返してて、最終的にClaude Codeでしっくり来た話を書きました。
— guchey | AI PdM at Ubie (@ShingenTaguchi) April 4, 2026
Claude Codeで分析エージェントを作って3か月運用した話|田口 信元 @ShingenTaguchi https://t.co/t49S8m55er #Ubieまいにち生成AI
