コスパ重視のAI推論:AMD MI355XでGLM 5.2を最適化するアプローチ

Wafer.aiのブログ記事である Performance per dollar is getting faster and cheaper を読み、コストパフォーマンスを追求する上でのAMD製ハードウェアの現状が実務的にも非常に参考になると感じたので、内容を自分なりに整理してみました。
AMDのCPUも良いかも。
現在、大規模言語モデル(LLM)の推論需要は凄まじい勢いで伸びており、NVIDIAのBlackwellといった最新ハードウェアの供給が追いつかない状況が続いています。その結果、GPU価格の高騰がトークンコストに直結してしまっているのが現状です。
こうした状況下で、解決策として注目されているのがAMDのハードウェアです。今回は、AMD MI355X を使って最新モデル「GLM 5.2」をいかに効率よく動かすか、という点にフォーカスしてみます。
ハードウェアスペックと「Day-0 サポート」の壁
AMDのInstinct MI350シリーズ、特にMI355Xは、シリコンレベルのスペックではNVIDIAのBlackwellと肩を並べる性能を持っています。特筆すべきはその「価格」で、MI355XはNVIDIAのB300と比較して、GPU1枚あたりの平均価格が約2.75倍も安いと言われています。
しかし、実際に導入しようとすると「ソフトウェアの壁」に突き当たります。NVIDIAには強力なエコシステムと、新型モデルがリリースされた当日から動かせる「Day-0 サポート」があります。一方でAMD(ROCmスタック)の場合、最新モデルを動かすためのイメージを探すだけでも一苦労で、カーネルやモデルの最適化に数週間のエンジニアリング工数がかかることも珍しくありません。
ただ、この「ソフトウェアの差」は、近年のエンジニアリングツールの進化によって急速に縮まりつつあるようです。
MI355Xにおける推論パフォーマンス
実際に、MI355Xを用いたノード(8枚構成)でGLM 5.2を稼働させた際のデータを見てみましょう。入力20k / 出力1k、キャッシュヒット率60%という、実用を意識したワークロードでの測定結果です。
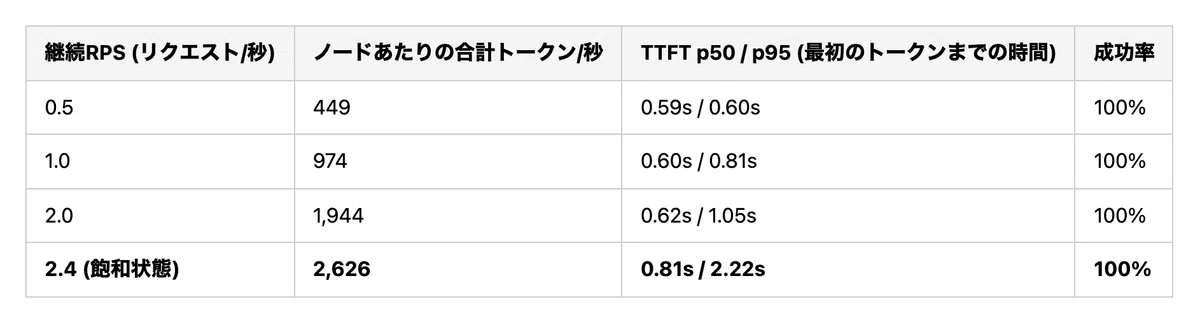
特筆すべきは、ノードあたり合計2,626トークン/秒というスループットです。これは、コストが2倍以上高いNVIDIA B200で測定されたパフォーマンスの約80%に相当します。「8割の性能を半額以下のコストで手に入れられる」と考えると、かなり現実的な選択肢に見えてくるのではないでしょうか。
最適化の手法:量子化とフレームワークの選定
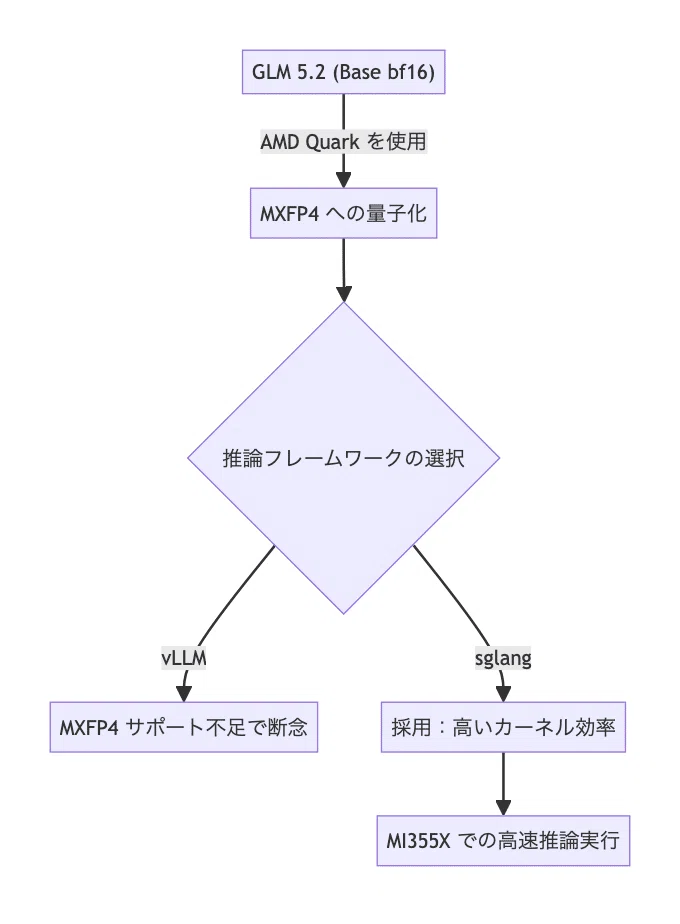
なぜこれだけのパフォーマンスを出せたのか、その裏側にある手法を整理します。プロセスの流れとしては、以下のようなイメージです。
1. MXFP4 量子化
まず、モデルの軽量化(量子化)ですが、今回は「AMD Quark」を用いて、ベースのbf16(bfloat16)から MXFP4 形式へと変換しています。
一般的に量子化を行うと精度が落ちるのが悩みどころですが、今回のMXFP4への変換では、FP8量子化と比較しても精度低下がほとんど見られなかったようです。ベンチマーク結果の一部をこちらに示します。
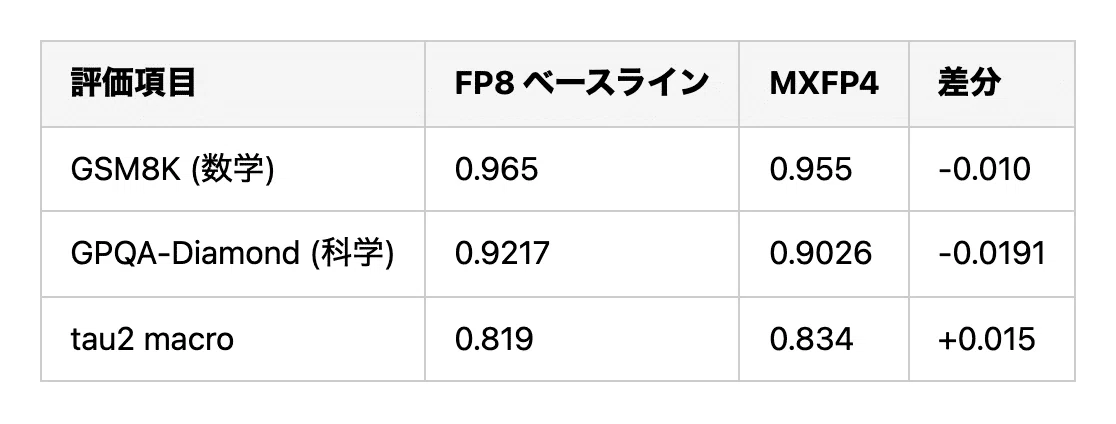
精度を維持したまま計算負荷を下げることで、ハードウェアのポテンシャルをうまく引き出しているかと思います。
2. 推論フレームワークの選択
次に重要なのが、どのソフトウェアで推論を回すかという点です。候補としては vLLM、ATOM、sglang の3つが挙がりましたが、最終的には sglang が選ばれました。
vLLM: GLMモデルに対するMXFP4のサポートがまだ不十分。
sglang: カスタムカーネルの最適化が進んでおり、AMD環境下でも高いパフォーマンスを発揮しやすい。
このように、ハードウェアだけでなく、適切な量子化手法とフレームワークを組み合わせることが、コストパフォーマンスを最大化する鍵になるようです。
まとめ
これまでは「とりあえずNVIDIAを選んでおけば安心」という状況でしたが、AMD MI350シリーズの登場とソフトウェア側の最適化が進んだことで、その常識が変わりつつあるのかもしれません。
もちろん、最初にお伝えした通り、AMD環境での構築にはまだ相応のエンジニアリング力が必要になるかと思います。ですが、2.75倍という価格差を考えると、初期の苦労に見合うだけのメリットは十分にあると言えるでしょう。
「安くて速い」は、AIインフラの現場でも確実に現実のものになりつつあるようです。
参照記事
詳しくはこちらをご覧ください。
