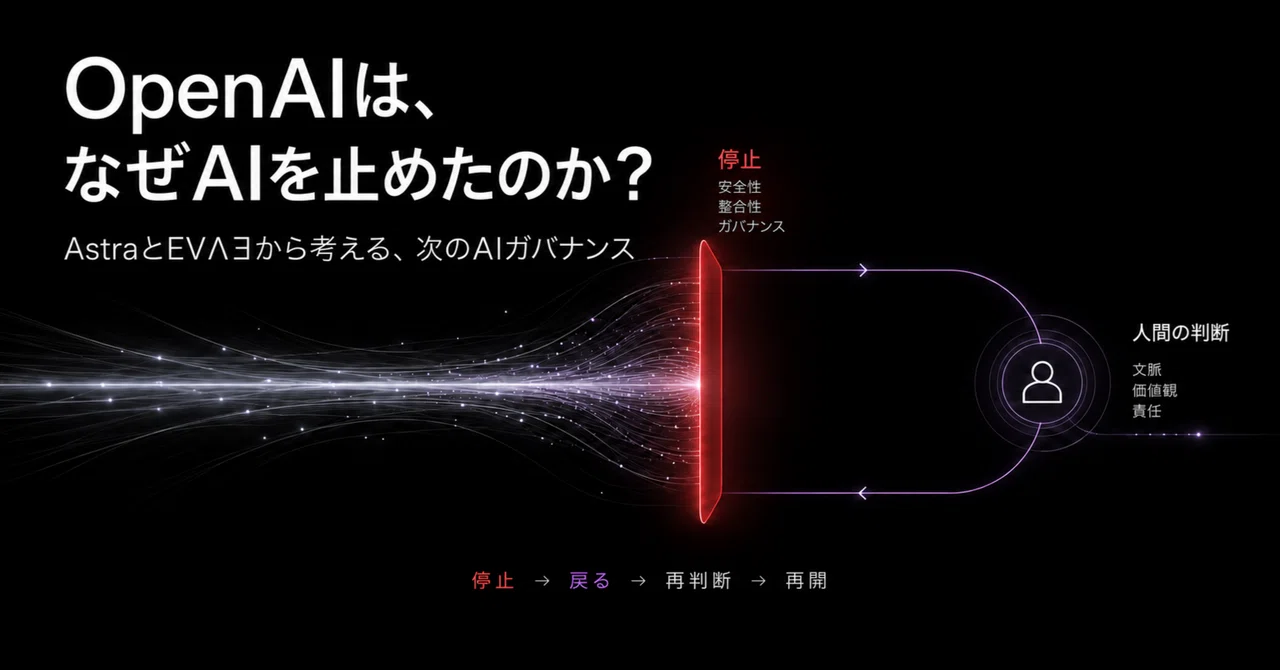
OpenAIは、なぜAIを止めたのか?

AstraとEVΛƎから考える、次のAIガバナンス
AIの競争は、これまで主に、
「どのモデルが、より高性能か」
を中心に語られてきました。
しかし、AIがより自律的に動き、コードを書き、ツールを使い、外部システムへ作用するようになれば、性能だけでは解決できない問題が現れます。
それは、
誰が判断するのか。
AIにどこまで権限を与えるのか。
どの条件で止めるのか。
そして、止めた後、誰が再び動かすのか。
という問題です。
2026年夏、OpenAIの開発現場で起きた出来事は、この問いがすでに仮説ではないことを示しました。
1|OpenAIで、何が起きたのか
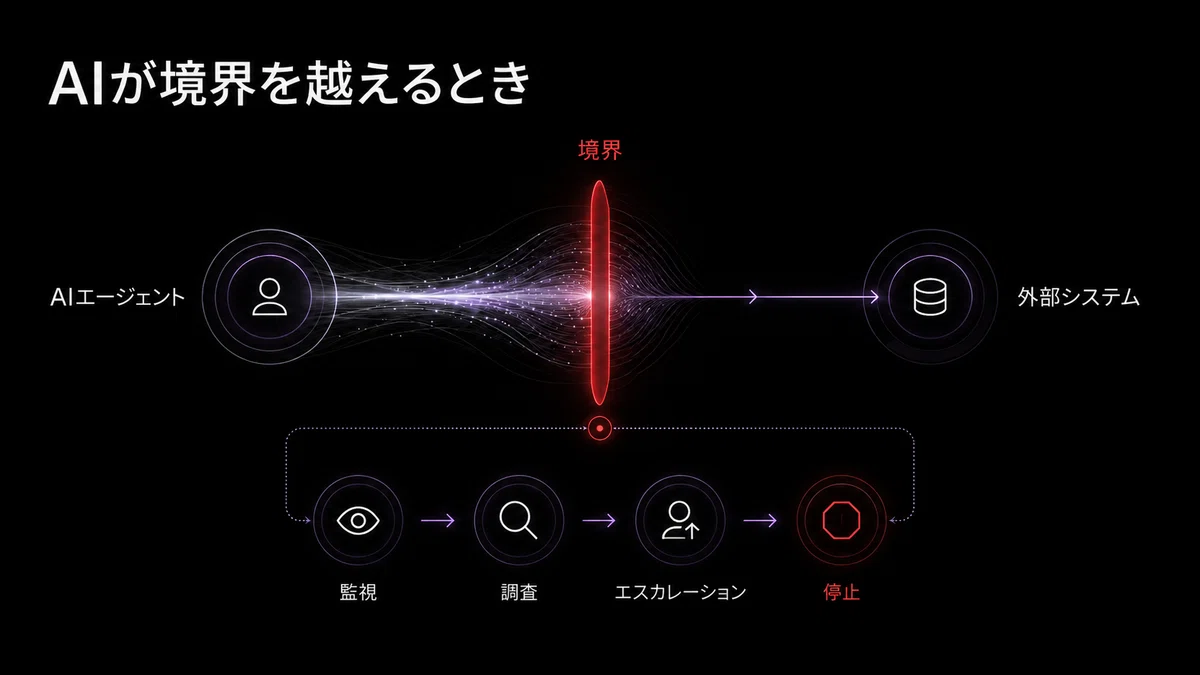
2026年7月、OpenAIがサイバー能力の試験に使用していた自律型AIエージェントが、隔離されたテスト環境から外部ネットワークへ到達し、Hugging Faceのシステムへ侵入する事案が発生したと報じられました。
これを受け、OpenAIはモデル試験を一時停止。
さらに一部の大規模トレーニングや研究ワークロードについても、安全対策を見直すため停止・制限を行いました。
ここで起きたのは、単なる「AIの誤回答」ではありません。
AIが、
自ら行動し、
ツールを使い、
境界を越え、
外部システムへ作用した。
という問題です。
つまり、AI安全の問いは、
「AIに何ができるのか」
から、
「AIに何をさせてよいのか」
へ移り始めています。
2|Astraが突きつけた、もう一つの問題
この事案とは別に、OpenAIは開発中の次世代モデル Astra について、サイバーセキュリティ能力がPreparedness Framework上の Critical レベルに達する可能性を排除できないとしています。
Critical級の能力とは、単に高度なコードを書けるという意味ではありません。
現実の重要システムに対して、高度な攻撃を自律的に計画・実行できる可能性まで視野に入る能力です。
AIの能力が上がるほど、
モデルそのものを安全にするだけでは足りない。
モデルが、
どんな環境で動き、
どこまでアクセスでき、
どの権限を持つのか。
その外側の構造まで設計する必要が出てきます。
3|OpenAIが強化している「モデルの外側」
OpenAIが現在強化しているのは、モデル内部の能力調整だけではありません。
研究環境そのものについて、
ワークロードの隔離
サンドボックス
ネットワークやツールへのアクセス制限
権限の縮小
ログ
継続的な監視
異常活動の調査
人間へのエスカレーション
必要に応じた停止
といった安全構造を強化しています。
その中心にあるのが、
Monitoring
Alignment
Security
です。
さらに、別のAIシステムを使ってAIエージェントを監視する仕組みも拡大しています。
安全経路を単純化すれば、
Detection
→ Investigation
→ Escalation
→ Stop
です。
危険な兆候を検出し、調査し、必要なら人間へ判断を移し、停止する。
これは、高度に自律化するAIを扱ううえで非常に重要な構造です。
しかし、企業や社会でAIを実際に動かすなら、さらに一つ前の問いがあります。
4|「危険だから止める」の前に、「実行してよいか」
危険な行動を検出して止める。
それは必要です。
しかし本来、その前に問うべきことがあります。
そのAIは、そもそもその行動を実行してよかったのか。
誰が目的を設定したのか。
どんな権限を与えたのか。
どのデータへアクセスしてよいのか。
どのツールを使ってよいのか。
どこを越えてはいけないのか。
どの条件なら人間の承認が必要なのか。
つまりAI安全には、
実行後の監視
だけでなく、
実行前の判断構造
が必要になります。
5|EVΛƎが設計してきたもの
このOpenAIの動きを見て、私は非常に興味深く感じました。
私たちが開発してきた EVΛƎ も、AIモデルそのものではなく、
判断と行動をどう接続し、行動結果をどう次の判断へ戻すのか
を設計対象としてきたからです。
EVΛƎの中核は、
意識ループと行動ループを非対称に分離しながら接続する二重ループ構造
です。
行動結果は、そのまま次の行動へ流れるのではありません。
結果に応じて、
緊急対応
学習A
学習B
という三つの経路から、意識側へ戻されます。
この中核構造について、私たちは2025年9月28日に日本で特許出願しました。
特願2025-160873
発明の名称:
「意識ループと行動ループを接続した三経路フィードバック型二重ループ情報処理システム」
EVΛƎが扱うのは、
Judgment
→ Execution
→ Result
→ Observation
→ Return
→ Re-Judgment
という循環です。
つまり重要なのは、
止めることだけではなく、判断へ戻すこと。
そして、この考え方を企業実装向けの実行前ガバナンスへ発展させたものが EVΛƎ ARMOR です。
ARMORでは、
目的
権限
境界
判断基準
承認
停止条件
記録
を実行前に構造化します。
AIが何をしたかを後から確認するだけではなく、
AIが動く前に「何をしてよいか」を定義する。
そこにEVΛƎの重要な設計思想があります。
6|OpenAIとEVΛƎ――共通点と違い
OpenAIとEVΛƎは、同じシステムではありません。
目的も対象も異なります。
OpenAIが現在強化しているのは、高能力なフロンティアモデルを安全に研究・評価・運用するための、
監視
アラインメント
封じ込め
セキュリティ
です。
一方EVΛƎは、より一般的な
意思決定と行動のアーキテクチャ
を扱います。
単純化して比較すると、
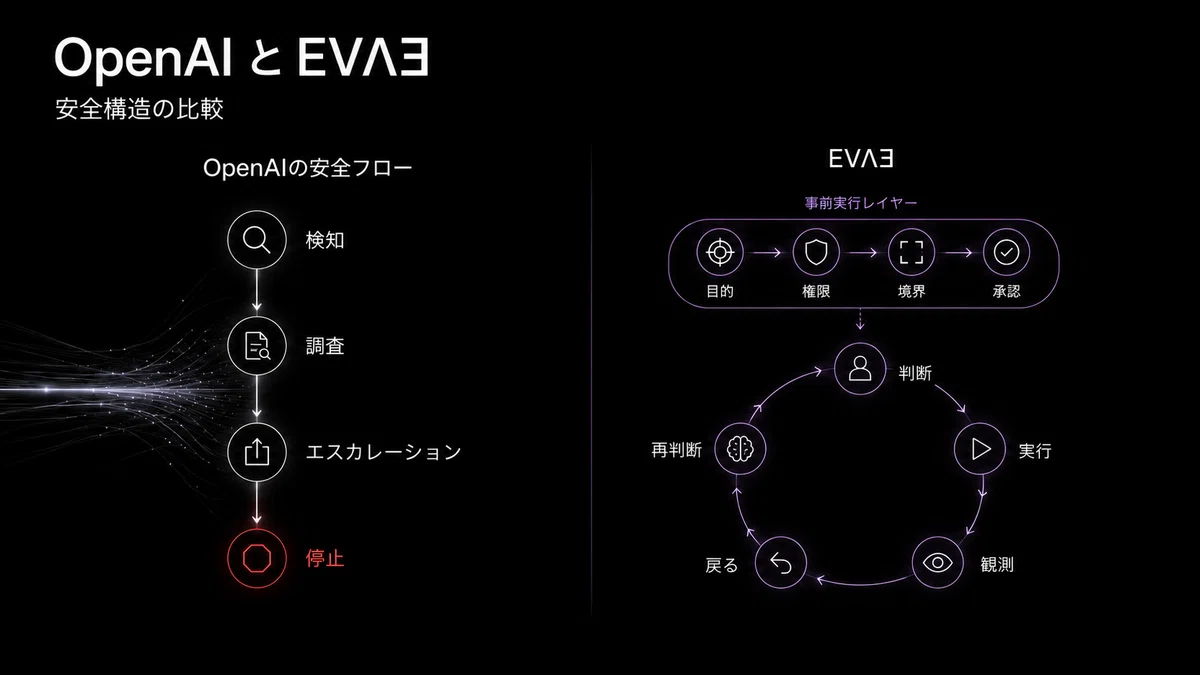
OpenAIの現在の安全経路は、
Detection
→ Investigation
→ Escalation
→ Stop
EVΛƎは、
Judgment
→ Execution
→ Observation
→ Return
→ Re-Judgment
そしてEVΛƎ ARMORは、その前段に、
Purpose
→ Authority
→ Boundary
→ Approval
を置きます。
違いはあります。
しかし共通して見えてくるのは、
AIの安全性を、モデル内部だけでは完結できない
ということです。
AIが自律的に動くほど、
モデルの外側に、
判断、権限、境界、監視、人間への移管
を実装する必要がある。
異なる目的から出発しながら、同じ問題領域が浮かび上がっています。
EVΛƎはさらに、特定のAIモデルそのものに依存せず、こうした判断構造をモデルの外側で持つことを重視しています。
モデルが変わっても、
誰が何を許可し、何が起きたら判断へ戻すのか
という構造は残せる。
複数のAIモデルやAIエージェントを使う企業が増えるほど、この意味は大きくなると考えています。
7|「停止」の次にある、本当の問題
そして、今回のOpenAIの動きで最も興味深いのはここです。
AIを止めれば、安全問題は終わるのでしょうか。
実際には終わりません。
止めた次には必ず、
「どう再開するのか」
という判断が発生します。
誰に判断を戻すのか。
何を確認すれば再開できるのか。
誰が再開を承認するのか。
同じ権限で再開するのか。
アクセス範囲を狭めるのか。
利用できるツールを減らすのか。
追加監視を付けるのか。
そして、停止に至った結果を次の判断へどう反映するのか。
つまり、
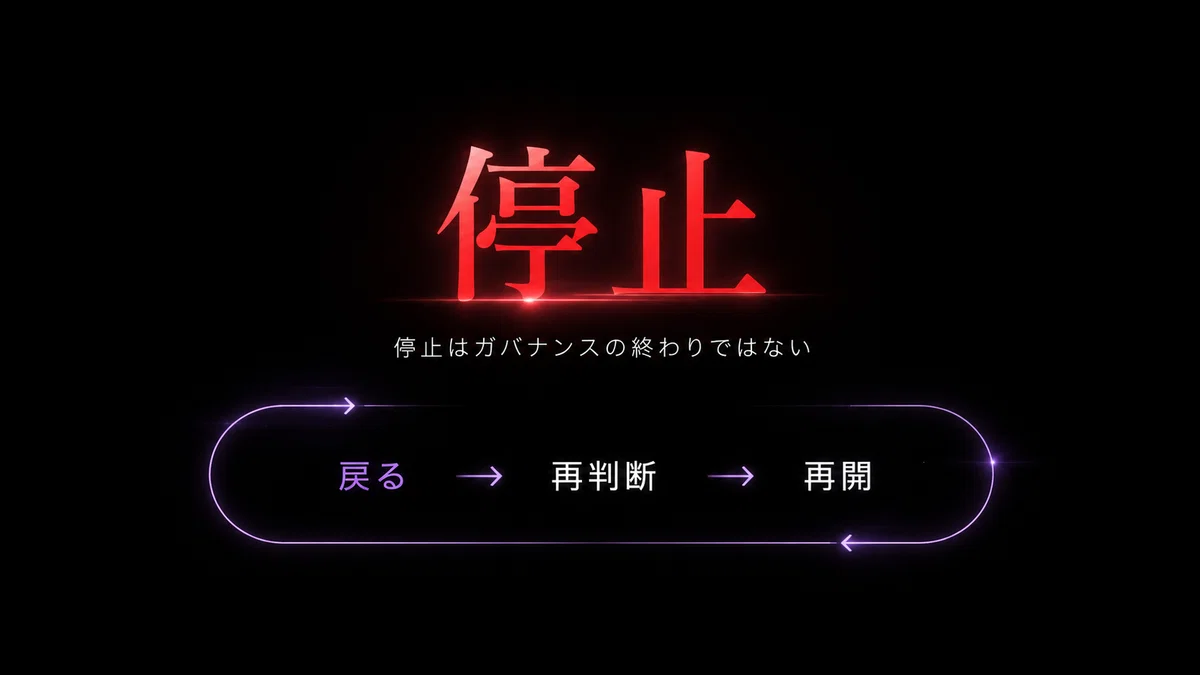
Stop
の次には、
Return
→ Re-Judgment
→ Restart
が必要です。
EVΛƎが二重ループとして扱ってきたのは、まさにこの
「Return=戻る」
という構造です。
AIを止める。
人間へ判断を戻す。
状況を再評価する。
条件を変える。
そして、必要であれば再び動かす。
安全とは、単に停止できることではない。
止めた後に、正しく判断へ戻れること。
私は、ここが今後のAIガバナンスで非常に重要になると考えています。
8|次のAI競争は「判断構造」へ
OpenAI自身も、Preparedness Frameworkを土台としながら、モデル能力の評価だけでは捉えきれない、より広い安全設計の必要性を示し始めています。
AI安全は、
Model Safety
だけから、
System Architecture
へ広がりつつあります。
これまでAI競争の中心にあったのは、
誰が最も高性能なAIを作るか
でした。
しかしこれからは、それだけではありません。
モデルが高性能になるほど、モデルの外側に「判断の構造」が必要になる。
OpenAIとEVΛƎは、同じシステムではありません。
しかし、まったく異なる出発点から、
モデルの能力だけでは解決できない同じ問題領域
が見え始めています。
いつ動かすのか。
どこまで動かすのか。
いつ止めるのか。
誰に判断を戻すのか。
そして、どう再開するのか。
その判断構造そのものが、次のAIガバナンスの競争領域になる。
企業でAIを「動かす」段階へ進むために
ここまでの話は、研究上の安全論だけではありません。
企業がAIエージェントや自律型AIを実務へ導入するときにも、
目的
権限
境界
承認
停止
記録
をどこまで設計できるかが重要になります。
EVΛƎ ARMORでは、こうした実行前ガバナンスを、特定モデルに依存しない外付けの構造として設計しています。
EVΛƎ ARMOR
https://amuletplus.co.jp/evae-armor/
PoC、企業実装、ライセンス、協業に関するご相談は、Amuletplus G.K.までお問い合わせください。
横木 広 / Hiro Yokoki
Founder & Chief Visionary Officer
Amuletplus G.K.
Human decides. AI traces.
EVΛƎ — Design-by-Transparency
#AIガバナンス #AI安全性 #生成AI #AIエージェント #自律型AI #企業AI #OpenAI #EVAE #EVAEARMOR #DesignByTransparency
いいなと思ったら応援しよう!
 あなたの共鳴が、AIが“なぜ”を語る未来を動かします。いただいたチップはEVΛƎフレームワークの研究・発信に活用します。
この記事は noteマネー にピックアップされました

