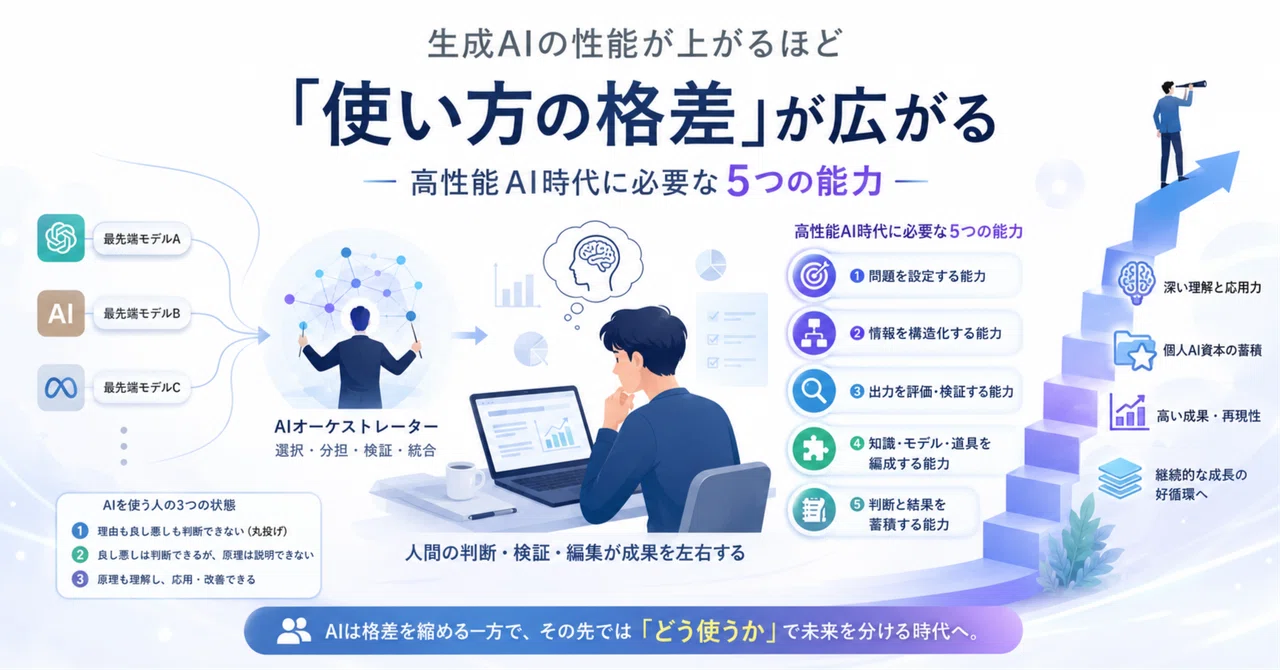
生成AIの性能が上がるほど「使い方の格差」が広がる|高性能AI時代に必要な5つの能力

1.はじめに――後発のAIは先行モデルに追いつけないと思っていた
私はこれまで、AIモデルの性能は学習データの量や計算資源、開発にかけた時間と強く結びついていると考えていました。
当然、先に開発を始めた企業ほど多くのデータを集め、多くの計算資源を投入し、長い時間をかけてモデルを磨き上げられます。
ですから、後から参入した企業が最先端モデルとの差を短期間で縮めるのは難しいはずだ、と思っていたのです。
そんな中、日本のSakana AIが「Sakana Fugu」と、その上位版「Fugu Ultra」を発表しました。エンジニアリングや科学、推論といった厳しいベンチマークにおいて、Anthropicの最先端モデルに比肩する性能を示したというニュースです。
私は最初、「日本にもClaudeに匹敵する国産の超高性能モデルが誕生したのか!」と期待しました。しかし仕組みを調べてみると、単独の巨大モデルを最初から訓練したものではありませんでした。
複数の既存フロンティアモデルを動的に選び、役割を分担させ、検証し、統合する——いわば「指揮者」の役割を担うモデルだったのです。
正直に言えば、少しがっかりしました。
私が期待していたのは、単体で強いひとつの頭脳だったからです。
しかし、その後、中国のAI企業が短期間で最先端モデルとの性能差を縮めているという話を知り、考えが変わり始めました。
そもそもAIの性能を「単体モデルがどれだけ賢いか」という尺度だけで見ること自体がナンセンスなのではないか?
この問いは、突き詰めると「人間とAIとの関わり方」にも影響のある問題です。
2.実用上のAI性能は、単体モデルの性能だけでは決まらなくなった
Sakana Fuguは、利用者にはひとつのモデルAPIとして提供されますが、内部ではタスクに応じて既存のフロンティアモデルを選択・連携させます。
標準版のFuguは、入力ごとに適したワーカーモデルを選び、Fugu Ultraは複数エージェントによるワークフローを構成して、分担、検証、統合を行います。モデルの選択、委譲、検証、統合をすべて内部で処理するため、複雑なマルチエージェントシステムを利用者自身が組む必要はありません。
これは、単体モデルの能力が不要になったという話ではありません。Fugu自体、既存の強力なモデル群を土台として利用しています。しかし、この事例が示しているのは、単体モデルの性能を高めることだけが、AIの実用性能を上げる唯一の方法ではないという事実です。
与えられた知識やモデルの量だけでなく、それをどう構成し、どう使うかが性能を左右する。
私は、AIの性能そのものより、ここがポイントなのではないかと思うようになりました。
同じ頃に発表された、中国のMoonshot AIの新モデル「Kimi K3」も、示唆に富む事例です。総パラメータ2.8兆のモデルとして発表され、フルモデルウェイトは2026年7月27日までに公開される予定です。
Moonshot AIの評価では、一部のベンチマークで最先端の独自モデルに肉薄する性能が報告されています。
先行企業だけが永遠に有利なわけではなく、後発企業には、すでに公開された研究成果を踏まえて開発経路を短縮できるという強みがあるのです。
3.AIが縮めるのは「成果物の格差」である
高性能AIは、初心者でも一定水準の文章、企画、分析、コードを作れるようにします。これは明確な底上げです。
しかし、次のふたつは分けて考える必要があります。
AIを使って高品質な成果物を作れること
なぜその成果物が正しいのか、本人が理解していること
AIは、出力される成果物の見た目や水準の差を縮めます。一方で、その内容を検証し、応用できるかどうかという理解や判断力までは、平準化しません。むしろ成果物が整うほど、本人がどこまで理解しているのかが外から分かりにくくなる可能性があります。
AIが作った成果物に対する利用者の状態は、次の三段階に分けて考えられます。
① 成果が作られた理由も、その良し悪しも判断できない
AIに作業をほぼ丸投げし、もっともらしい出力をそのまま採用する状態です。
② 詳しい原理は説明できないが、成果の良し悪しは判断できる
自分で同じ成果物を一から作ることは難しく(再現性がない)ても、経験や評価眼によって、使える案と使えない案を区別できる状態です。
③ 原理や成立条件を理解し、成果の良し悪しも判断できる
なぜその結果になるのかを理解した(再現性がある)うえで、目的に合わせて意図的に修正し、別の状況にも応用できる状態です。
完成した成果物だけを見ても、利用者がどの状態にあるのかを正確に判断することは難しくなります。特に②と③の違いは、修正の過程や、条件が変わったときの対応を見なければ分かりません。
AIの性能が上がるほど成果物の見た目は整います。しかし、その背後にある理解と判断の差は、むしろ大きな意味を持つようになるのではないでしょうか。
4.モデルが高性能になるほど、人間側の使い方が問われる
AIの性能が低い段階では、どのモデルを使うかが成果を大きく左右します。
しかし、主要なモデルが一定以上の水準に達すると、成果を決める要因はモデル性能だけではなくなります。
重要になるのは、何をAIに任せるか、問題をどう分解するか、どの情報を与えるか、どの回答を採用するか、どこを人間が検証するか、という使い方です。
高性能なモデルであっても、目的や条件が曖昧なままでは、もっともらしい一般論しか返ってきません。
しかし、目的、前提、制約、評価基準が整理されていれば、同じモデルから実用性の高い回答を引き出せます。
高性能AIは、人間の使い方を不要にするのではありません。誰が使っても同じではないのです。
むしろ、人間の使い方の良し悪しを増幅するのです。
5.知識量より「情報を選び、つなぎ、判断する力」が重要になる
大量の知識を持っていることと、頭が良いことは同じではありません。
思考には、知識を持つことに加えて、必要な情報を選ぶ力、異なる情報を関連づける力、原因と結果を考える力、優先順位を決める力、不確実な状況で判断する力が必要です。
AIの世界でも、似た構造が見え始めています。基盤モデルを作る段階では、大量で多様な学習データが依然として重要です。
しかし、AIの性能が一定水準を超えた現在は、データの正確性、多様性、難易度、失敗例、判断過程といった質と構成も、性能に大きく関わってきます。
個人のAI活用でも同じです。
会話履歴を大量に蓄積するだけでは十分ではありません。価値があるのは、なぜその案を採用したのか、なぜ別案を不採用にしたのか、実行後にどのような結果が出たのか、という判断と結果を含んだ情報です。
6.AIとの間に蓄積される「個人AI資本」
同じ高性能AIを使っていても、利用者ごとにAIから得られる価値(成果物)は異なります。
ある人のAIには、仕事や生活上の前提、好みや避けたい表現、過去の成功例と失敗例、判断基準、よく使う業務手順、修正履歴、実行後の結果が蓄積されています。別の人は、毎回その場限りの質問をし、回答を使った後には何も残しません。
最初は両者の差が小さくても、利用を重ねるほど、前者のAIは本人の事情や目的に合った回答を出しやすくなります。この記事では、この蓄積を「個人AI資本」と呼びます。
個人AI資本とは、AIに再利用・参照させられる形で保存・整理された、本人の知識、評価、判断基準、成功・失敗、業務手順、テンプレート、修正履歴の蓄積です。
将来のAI活用格差は、どのモデルを契約しているかだけではなく、AIとの間に何を蓄積してきたかによって生まれる可能性があります。
7.個人AI資本格差は、なぜ複利的に広がるのか
個人AI資本には、自己強化する性質があります。
考えながらAIを使う人は、良い問いを立て、良い回答を得て、比較して評価し、採用理由や修正内容を残します。
すると、判断基準をメモリ、プロジェクト、ファイル、テンプレートなどに残し、次回以降の対話でAIに参照させられるようになります。
一方で、曖昧に質問し、出力をそのまま採用し、良し悪しを記録しない人には、AIに有効な文脈が残りません。
次回も一般的な回答しか得られない、という循環になります。
この差は、一回の利用では小さく見えます。
しかし数百回、数千回と利用を重ねると、AIが持つ情報の質、本人の判断力、再利用できる手順の量に大きな差が生まれます。
ここで重要なのは、利用時間の長さではありません。やり取りの質の問題です。
AIを長時間使っていても、出力をそのまま採用し、誤りを確認せず、実行結果を振り返らないだけなら、質の高い学習は残りません。
短時間でも、自分の仮説を持ち、複数案を比較し、採用と不採用の理由を言語化し、実行後の結果を記録する人は、利用するたびに成長できます。
重要なのは利用時間ではなく、フィードバック密度です。
一回の対話から、どれだけ判断、修正、検証、結果を残せたか。それが、人間側の能力と個人AI資本の両方を育てます。
8.高性能AI時代に人間へ求められる5つの能力
① 問題を設定する能力
AIに何を解かせるのかを決める力です。問題設定が間違っていれば、高性能AIは間違った方向へ高速で進みます。
② 情報を構造化する能力
目的、背景、制約、優先順位を整理する力です。材料同士の関係が整理されていなければ、実行しにくい一般論になりやすくなります。
③ 出力を評価・検証する能力
AIの回答を、文章が自然だからという理由だけで採用しない力です。事実、実行可能性、目的との一致、見落としを確認する必要があります。
④ 知識・モデル・道具を編成する能力
ひとつのAIへすべてを任せるのではなく、複数の情報、モデル、ツール、人間の専門知識を、目的に合わせて組み合わせる力です。Fuguが示した発想を、個人の利用に置き換えたものとも言えます。
⑤ 判断と結果を蓄積する能力
採用理由、不採用理由、修正内容、実行結果を記録する力です。これによって、人間自身の理解と個人AI資本の両方が育ちます。
9.まとめ
高性能AIが普及すると、一定水準の文章、企画、分析を作ることは、多くの人に可能になります。
その意味では、知識量や作業技能による格差は縮小します。
しかし、その先では、何を問題とするか、どの情報を選ぶか、情報をどうつなぐか、どの回答を採用するか、結果から何を学ぶかという人間側の能力が、成果を大きく左右します。
さらに、その判断や結果をAIとの間に蓄積できる人は、利用するほど個人AI資本を増やしていきます。
高性能AIが登場したことで、モデル性能が重要でなくなったわけではありません。
しかし、モデルの性能だけを比べればよい時代でもなくなりました。これから問われるのは、与えられた知能をどのように編成し、どう判断し、その経験を次の思考へつなげられるかです。
おわりに――この記事自体が「知能を編成する」実験だった
最後にネタばらしをすると、この記事自体が、本文で紹介した「④ 知識・モデル・道具を編成する能力」の小さな実験になっています。
今回は、まずChatGPT Workを使い、自分の考えに関連する情報を調べました。自分の主張を裏づける材料だけでなく、反論や見落としの可能性も探し、考え方に無理がないかを確認しました。
次に、通常のChatGPTへ調査結果を移し、対話を重ねながら記事の構成を整理しました。主張が重複している部分を削り、説明が飛躍している部分を修正し、記事全体の流れを整えました。
その構成をもとに、文章の下書きはClaudeで作成しました。私はClaudeの文章の進め方や、執筆前に意図を確認する質問の仕方が比較的好みに合っています。
ただし、生成された文章をそのまま公開したわけではありません。事実関係を確認し、表現を修正し、自分の経験や考えを加えて、最終的には自分で完成させました。
今回使ったAIには、それぞれ異なる役割があります。
ChatGPT Workは情報収集と論点整理
通常のChatGPTは構成の検討と修正
Claudeは文章の下書き
そして、どの情報を採用し、どの表現を直し、最終的に何を伝えるかは、私自身が判断しました。
ひとつのAIに最初から最後まで任せるのではなく、目的に応じてAIや道具を使い分け、人間が全体を編集する。今回の記事づくりを通じて、高性能AI時代に重要になるのは、やはり「どのAIが一番賢いか」だけではないと感じました。
使える知能や道具をどう組み合わせ、どこを任せ、どこを自分で判断するのか。
それが、これからのAI活用における重要な能力になるのだと思います。
新しい道具を見ると、私はすぐに試したくなります。今回も、その好奇心から始めた実験でした。
最後までお読みいただきありがとうございました🙇
※この記事は、ChatGPT Workによるリサーチ、ChatGPTによる構成整理、Claudeによる文章の下書きをもとに、自分で事実確認、加筆、修正を行って作成しています。
