「再起動したら直った」は悪魔のささやき。RHEL障害対応、証拠(ログ)を消す前にまずsosreportを。

tempting...(悪魔のささやき)
システムが極端に遅い。サービスが応答しない。
深夜の障害対応中、高まるプレッシャー。
その時、あなたの頭に魅力的な言葉が響きます。
「とりあえず、再起動してみよう」
そして、再起動すると...システムはあっさり正常に戻る。
「よし、直った。これで朝まで様子を見よう」
これは、問題解決ではありません。根本原因(犯人)を野放しにした「証拠隠滅」です。
なぜなら、「再起動したら直った」は、「原因は不明のまま闇に葬られた」とほぼ同義だからです。RHELの障害対応において、その「悪魔のささやき」に屈してはいけません。
プロのエンジニアが最初に行うべき行動は、ただ一つ。
問題が発生している「まさにその瞬間」のsosreportを取得することです。
なぜ「再起動」が最悪の証拠隠滅になるのか?
トラブルシューティングにおける最大の敵は「証拠の消失」です。
そして、システム再起動は、最も致命的な証拠隠滅行為です。
再起動は、以下の「揮発性データ(真っ先に消える証拠)」をメモリ上から完全に消し去ります。
カーネルリングバッファ (dmesg)
カーネルが記録する最新のイベントログ。再起動で完全にクリアされます。
/proc ファイルシステム
全プロセスの詳細な状態(psコマンドの元ネタ)。ハングアップの状況証拠です。
メモリ状態 (free, /proc/meminfo)
OOM Killer(メモリ不足によるプロセス強制終了)が発生する直前の、逼迫したメモリ状況。
ネットワーク状態 (ss, netstat)
TIME_WAITやCLOSE_WAITの異常な蓄積。通信が詰まっている様子。
■ よくある「迷宮入り」のケース
「システムが極端に遅くなったため、再起動したら正常に戻った」
この場合、再起動後に取得した sosreport では、リソースは正常に見え、ログにも異常な記録は残っていません。これでは「原因不明(再現性なし)」として処理するしかありません。
しかし、もし問題発生中(再起動前)に sosreport を取得していれば、
そこには「決定的な証拠」が残っていたはずです。
ps.txt には、数百のプロセスがDステート(I/O待ち)で停止している記録。
top-b-n1.txt では、CPUの "wa"(I/O Wait)が90%に達していた事実。
この「スナップショット」が存在するだけで、調査の焦点は即座に「ストレージI/Oのボトルネック」に絞り込めます。sosreport は、憶測を排除し、事実に基づいた分析を可能にする、唯一の「証拠保全」の手段なのです。
sosreport:完全な「現場スナップショット」
では、なぜ sosreport がそれほど強力なのでしょうか。
それは、障害対応に必要な3つの要素を完璧に満たしているからです。
1. 圧倒的な「網羅性」
「messages だけ送ってください」という依頼は、当て推量を助長する危険な行為です。システム障害は、複数の要因が複雑に絡み合って発生します。
sosreport は、診断に必要な情報の99%を、単一コマンドで体系的に収集します。
ログ: messages, dmesg, journalctl の完全なダンプ
設定: /etc 配下のほぼ全て(fstab, sysctl.conf など)
リソース: ps, top, free, df, ss
HW/カーネル: lspci, lsmod, sysctl -a
パッケージ: rpm -qa, rpm -Va(整合性検証)
「アプリがハングした」原因が、dmesg に記録された「I/O error」だった、というように、一見無関係な情報が根本原因を指し示すことは日常茶飯事です。
2. サポートプロセスの「標準化」
sosreport は、エンジニア間の「共通言語」として機能します。
これが無い場合、サポートプロセスは非効率な情報の往復に終始します。
「messages をください」
「異常ありません。top と free の出力をください」
「I/O Waitが高いです。dmesg をください」
このやり取りだけで数日を要することもあります。
sosreport は、この「情報の往復」を初回で撲滅します。Red Hatサポートにケースを起票する際も必須であり、エンジニアが即座に分析フェーズに入れるようにすることで、MTTR(平均修復時間)を劇的に短縮します。
膨大な証拠から「犯人」を見つける最初の一歩
sosreport を取得したはいいものの、その膨大なファイル群(情報の洪水)を前に、どこから手をつければよいか分からない、という状況はよくあります。
専門家は、まず以下の「トリアージ(優先順位付け)」から始めます。
これは、システム全体に影響する「致命的な兆候」を5分以内に特定するための手順です。
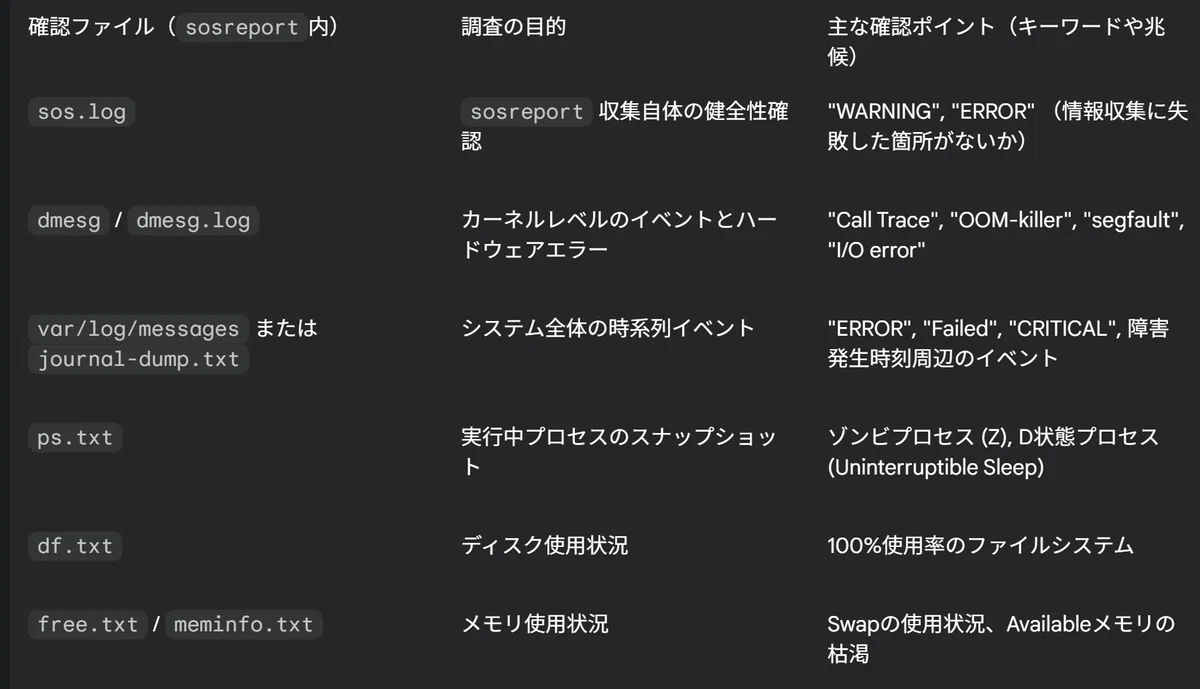
■ 現場トリアージ・クイックリファレンス
dmesg / dmesg.log (最優先)
見るもの: カーネルとハードウェアの"悲鳴"がないか。
キーワード: "Call Trace" (カーネルパニック), "OOM-killer" (メモリ枯渇), "segfault", "I/O error" (ストレージ障害)
messages / journal-dump.txt
見るもの: システム全体の時系列イベント。
キーワード: "ERROR", "Failed", "CRITICAL"。障害発生時刻周辺のイベント。
リソース枯渇チェック
df.txt: 100%の使用率に達しているファイルシステムはないか(特に /var)。
free.txt: Swapが大量に使用されていないか。Available(利用可能)メモリが枯渇していないか。
プロセス状態チェック
ps.txt: ゾンビプロセス (Z) や、Dステート(Uninterruptible Sleep = I/O待ち)のプロセスが多数存在しないか。
この初期トリアージは、ベテランエンジニアの「まずここを見る」という経験則(ヒューリスティクス)を形式知化したものです。以下のクイックリファレンス・テーブルは、分析の効率を最大化するためのチェックリストとして機能します。
これらの初期調査だけでも、問題がメモリ、ストレージ、あるいは特定のアプリケーションのどれに起因するかの大まかな切り分けが可能です。
結論:「まず sosreport」を合言葉に
「再起動したら直った」という"悪魔のささやき"は、その場しのぎの安心感しか与えてくれません。根本原因(犯人)はシステムに潜伏したままであり、必ず同じ問題(再犯)を引き起こします。
組織のインフラ運用において、「障害発生時には、まず sosreport を取得する」ことをSOP(標準作業手順書)に組み込むことは、極めて重要です。
これにより、憶測による無駄な作業を排除し、エンジニアが即座にデータに基づいた体系的な調査に着手できる、プロフェッショナルな障害対応文化が醸成されます。
次に障害が起きたら、再起動の前に、まず一呼吸。
そして、こう唱えましょう。
「証拠(ログ)を消す前に、まず sosreport を」
