ローカルTTSを試す【第3回】VoxCPMをMacで動かして日本語を喋らせた

こんばんは。ほったりたです。
ローカルで動くTTSを順番に試している連載、今回は3回目です。
第1回と第2回では、軽量な Supertonic を試して、導入方法までまとめました。今回からはもうひとつ気になっていた VoxCPM のほうに移ります。
先に言っておくと、今回はけっこう手こずりました。
なお、ここから書くのはあくまで僕の環境(Apple SiliconのMac・特定のバージョンの組み合わせ)で、僕が試した範囲の話です。VoxCPMそのものの評価ではないですし、環境が違えば結果も変わると思います。そのつもりで読んでもらえるとうれしいです。
まず、実際にMacで喋らせた日本語の音声がこちらです。
VoxCPMって、どんなTTS?
VoxCPM は、OpenBMB というところが出している読み上げAIです。Supertonic がとにかく軽いのが売りだったのに対して、VoxCPM は 2B(20億パラメータ)クラスのちょっと大きめのモデルで、そのぶん音の自然さに期待できます。
特徴的なのは「トークンフリー」という作りで、ざっくり言うと音声をいったん文字記号みたいなものに変換せず、もっと地続きな形で扱うタイプです。むずかしい説明は置いておくとして、聴いた印象としては、たしかに日本語が自然でした。
こういう大きめのモデルは「どうせNVIDIAのGPU(CUDA)がないと動かないんでしょ」と思われがちです。僕も最初はそう思っていました。でも公式を読むと、Apple Siliconでも動くと書いてある。それなら手元のMacで試したくなります。
CPUなら動いた。でも、おそい
まず素直に動かしてみたら、CPUではちゃんと日本語が喋れました。音質も良い。さすが2Bだなと思いました。
ただ、ひとつ問題がありました。おそいんです。
6秒くらいの音声を作るのに、1分半近くかかりました。一回試すぶんには我慢できますが、いくつも作るとなるとつらい速度です。
そうなると、当然こう思います。「MacのGPUを使えば速くなるはずでは?」と。
GPUで動かそうとしたら、いきなり止まった
ここで少しだけ用語の話をさせてください。
WindowsのゲーミングPCに入っているようなNVIDIA製のGPU(その仕組みを「CUDA」と呼びます)は、Macには載っていません。
ただ、Mac(Apple Silicon)にもチップの中にApple製のGPUが入っています。これを使うための仕組みが「MPS」というもので、今回はこのMPS経由でMacのGPUを使おうとしました。
ところが、いざMPSで動かしてみたら、生成の最後でエラーが出て止まりました。
NotImplementedError: Output channels > 65536 not supported at the MPS device.
ざっくり訳すと「その計算、MacのGPU(MPS)では対応してません」。モデルの読み込みまではGPUでできていたのに、最後の音声を組み立てる段でつまずいた形です。
最初は「VoxCPMがMac非対応なのかな」と思いました。でも調べてみると、これはVoxCPMだけの問題ではなさそうでした。
同じエラーが、ほかのいくつかのTTSのページでも報告されていました。どうやらMacのGPU(の土台になっているPyTorchというライブラリ)と、こういうモデルの組み合わせで起きることのようです。VoxCPMに限った話ではない様子。
ただ、ここでもうひとつ気づいたことがありました。短い文だと、ふつうにGPUで動くんです。落ちるのは長めの文を読ませたときでした。だから「Macでは絶対に動かない」わけではなく、「長い音声を作ろうとすると引っかかる」という感じでした。
エラーメッセージと、実際の原因がずれていた
ここからが今回いちばん面白かったところです。
エラーは「Output channels(出力チャンネル)が65536を超えてるからダメ」と言っています。なので最初は素直に「じゃあそのチャンネルを分割して、小分けにGPUへ渡せばいいんじゃない?」と考えて、そういう処理を書きました。
ところが、直りませんでした。
おかしいなと思って、止まっている場所の数字を実際に表示させてみたら——出力チャンネルは256しかありませんでした。65536どころか、ぜんぜん足りていない。
じゃあ何が大きかったかというと、音声の長さ(時間の方向のデータ)でした。長い文だと、ここがぐっと大きくなる。さっき「短い文なら動いた」のも、これで説明がつきます。
つまり、エラーメッセージは「出力チャンネルが原因」と言っているのに、実際に引っかかっていたのは別のところだった。メッセージの文言と中身がずれていたわけです。だから僕の「出力チャンネルを分割する作戦」は、そもそも見当違いのところを直そうとしていたので、効くわけがなかった。
エラーの文言をそのまま信じると、こうやって遠回りします。実際に数字を見にいって正解だった、という出来事でした(このあたりは僕の手元のバージョンでの挙動なので、将来のアップデートで変わるかもしれません)。
詰まったところだけCPUに逃がしたら、GPUで動いた
原因のとらえ方を変えました。
無理にGPUで全部やろうとせず、「GPUがどうしても無理という計算だけ、その瞬間だけCPUに肩代わりさせて、終わったらGPUに戻す」という作戦です。
VoxCPMの中で、GPUが嫌がる計算はほんの数か所だけ。そこだけCPUに逃がせば、いちばん重たい本体部分はGPUのまま走らせられる。
これがうまくいきました。
そして、肝心の速度がこちらです(同じ短い文を、CPUだけのときとGPUを使ったときで比べたものです)。
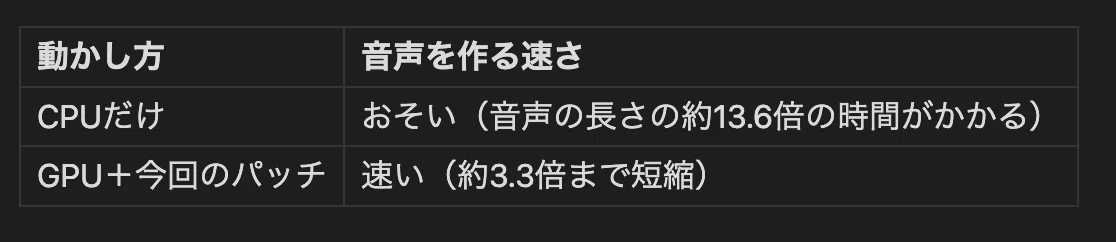
ざっくり4倍ちょっと速くなりました。6秒の音声が、1分半→20秒くらいに。これなら何回も試す気になれます。
「ぱっと見では動かなそうなものを、ちょっとした工夫で動かせた」というのは、やっぱり気持ちがいいですね。
ところで、肝心の日本語はどうだったか
速くはなった。では、読み上げの中身はどうか。ここはちゃんと聴いてみました。
音質そのものは、やっぱり2Bだけあって自然です。ただ、Supertonicのときと同じ落とし穴もありました。むずかしい言葉を読み間違えるんです。
たとえば「一朝一夕」。これを漢字のまま渡すと、正しく読んでくれませんでした。
第1回でも書きましたが、TTSは基本、むずかしい漢字を読み間違えるものだと思っておいたほうがいいです。VoxCPMも例外ではありませんでした。なので、ここはSupertonicのときと同じで、読み間違える言葉は先にひらがなへ書き換えておくのが安全です。
まとめ
次回は、この VoxCPM を実際に自分のMacに入れる「導入方法」 を、手順そのまま記事にする予定です。今回出てきた「GPUで動かすためのパッチ」も、そこで具体的に書きます。
「試してみたいけど、どうやって入れるの?」という人は、次回をのぞいてみてください。
参考リンク
◆ VoxCPM(GitHub):
◆ モデル本体(HuggingFace):
◆ 公式ドキュメント:
最後まで読んでいただきありがとうございました!
普段は「はっきんぐパパ」として、子どもと作ったものづくりの記事も書いていますので、ぜひ覗いてみてください
↓
いいなと思ったら応援しよう!
 いつも読んで頂きありがとうございます!
いただいたサポートは子どものためのもの作りの活動費に使わせていただきます!
