GPU不要で驚きの精度。リアルタイム多言語文字起こしツール「hayamimi」使ってみましたー。

日本の開発者さんっぽいリポジトリだーと思ってみたら、物凄い高性能な文字起こしツールでした。凄いなコレ。
貰い物の半壊PCでも全然CPUだけで文字起こし出来るし、翻訳でもかなり性能高い感じ。唯一の弱点は複数言語をいっぺんに読み取れないくらいしか、今のところは見当たらない。
こんなの出来るんだ、凄いってなりました。
1. はじめに:なぜ今、ローカル文字起こしツールが重要なのか
音声認識(STT)技術の進化は目覚ましく、私たちは会議の議事録作成や動画の字幕付けを自動化できるようになりました。
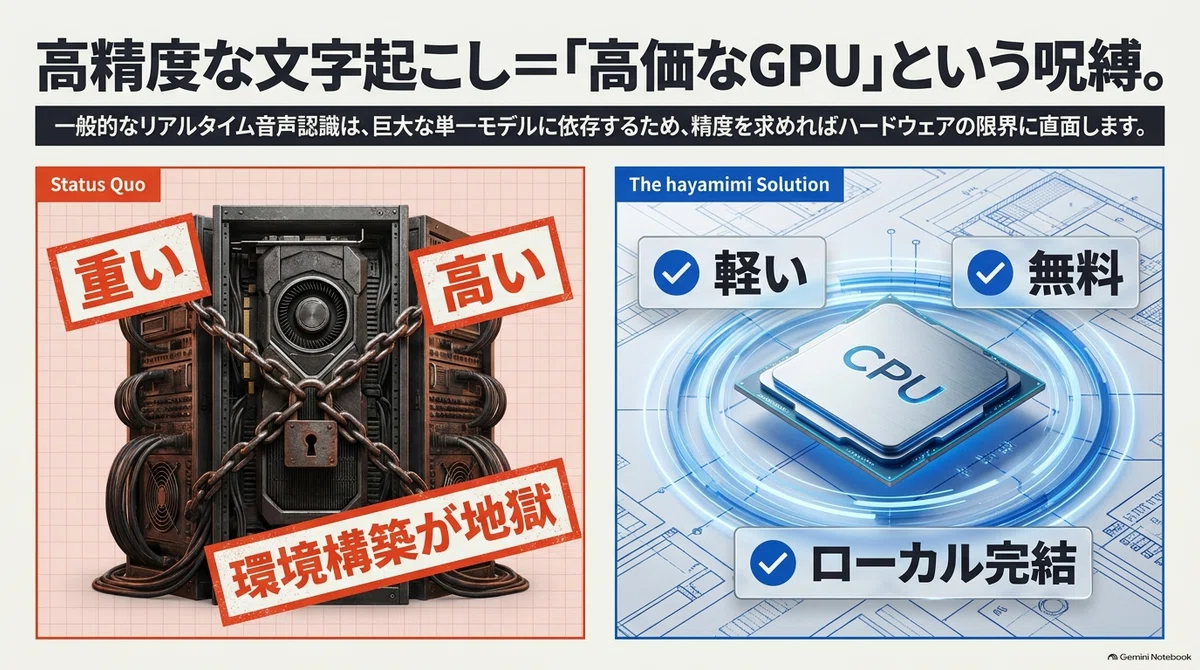
しかし、その多くは強力なGPUを積んだ高価なPCを必要としたり、機密情報をクラウドへ送信するリスクを伴ったりするもの。
こうした壁を打ち破るべく登場したのが、オープンソースの文字起こしツール「hayamimi」。なんと日本人制作者っぽい。こういうのは心から応援し続けたい。
その名の由来は、情報をいち早くキャッチする「地獄耳」や「目ざといこと」を意味する日本語から。話が終わるか終わらないかのうちにテキストを生成する驚異的なレスポンスこそが、このツールのアイデンティティ。
最大の画期性は、高価なハードウェアや外部サービスに頼らず、一般的なビジネス用PCの「CPUだけ」で、プライバシーを守りながらプロレベルの精度を実現している点にあります。嬉しい。
2. 概要:CPUだけで動く「hayamimi」とは何か
「hayamimi」は、CPUのみで動作するリアルタイム多言語音声認識ツール。PyTorchやCUDAといった重厚な環境構築を必要とせず、ノートPC一台で高度な文字起こしと翻訳を可能に。
その技術的基盤と機能のポイントは以下の通り。
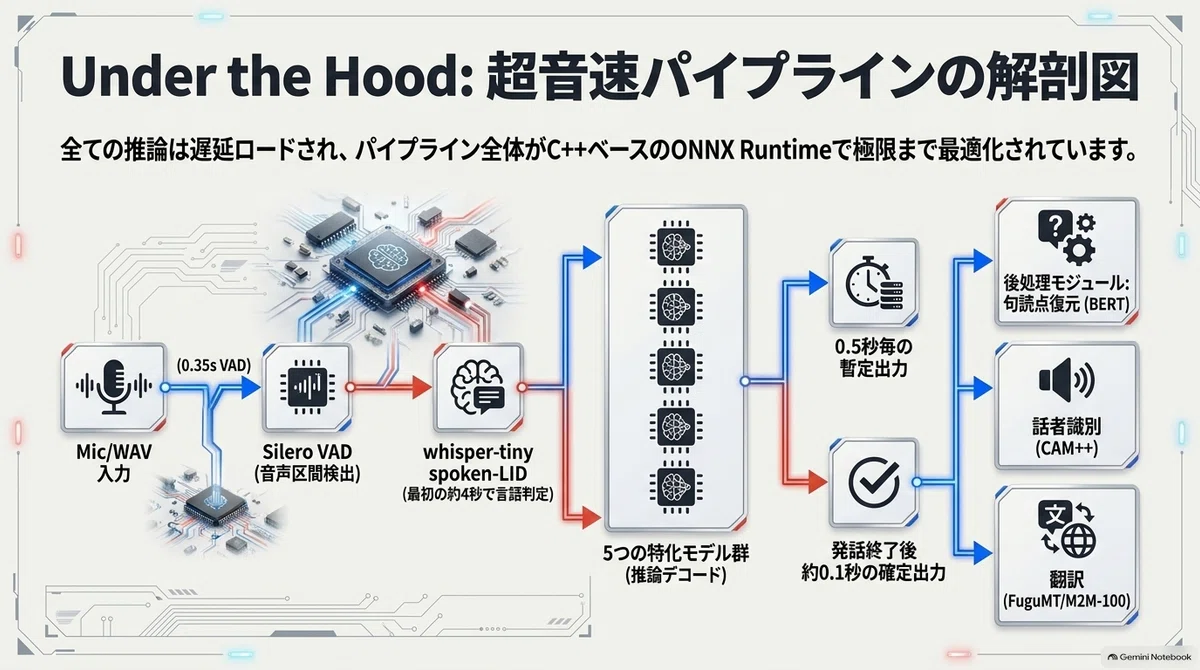
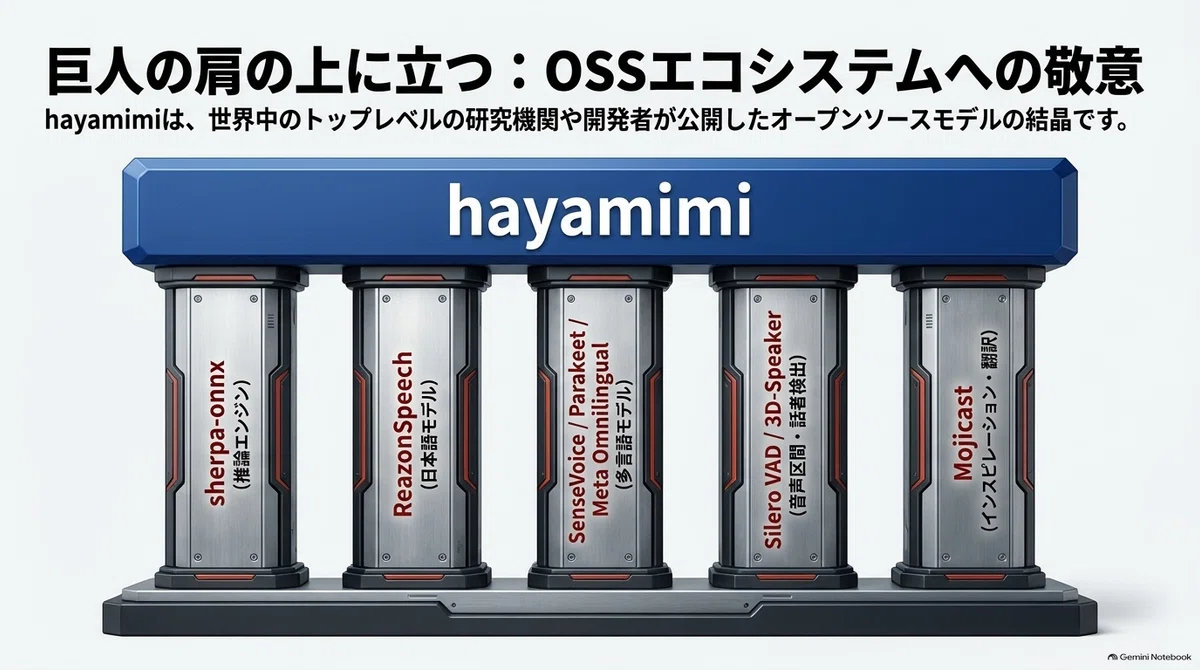
多言語への圧倒的な対応力: 日本語、中国語、韓国語、広東語、英語、および欧州24言語に対しては、それぞれの言語に最適化された「最高クラスの専門モデル」を自動で割り当てます。さらに、それ以外のマイナーな言語についても、Metaが開発したモデル(Omnilingual ASR)を活用することで、約1600言語という驚異的なカバー率を実現。
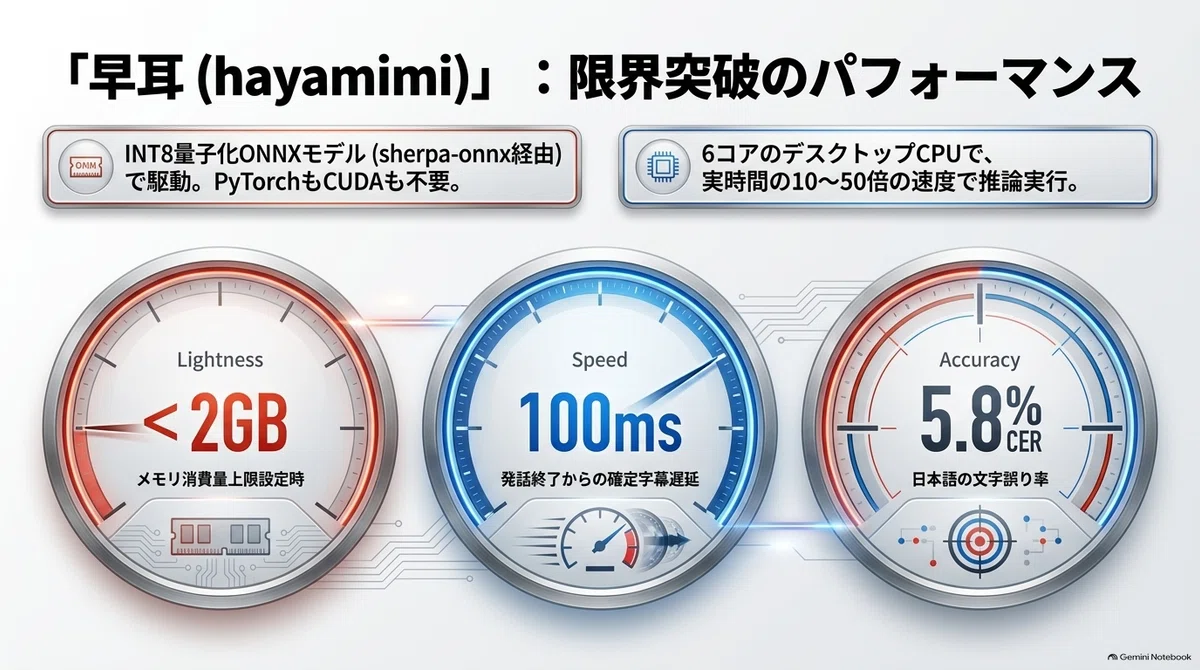
軽量・高速な実行エンジン: ONNX形式に変換され、さらに「INT8量子化」を施したモデルを「sherpa-onnx」というエンジンで実行。この量子化という技術は、例えるなら「高解像度の写真を見た目の美しさを損なわずに、一瞬で読み込める高画質JPEGへギュッと圧縮する」ようなもの。これにより精度を保ったまま劇的な高速化と軽量化を達成。
実用的な機能群:
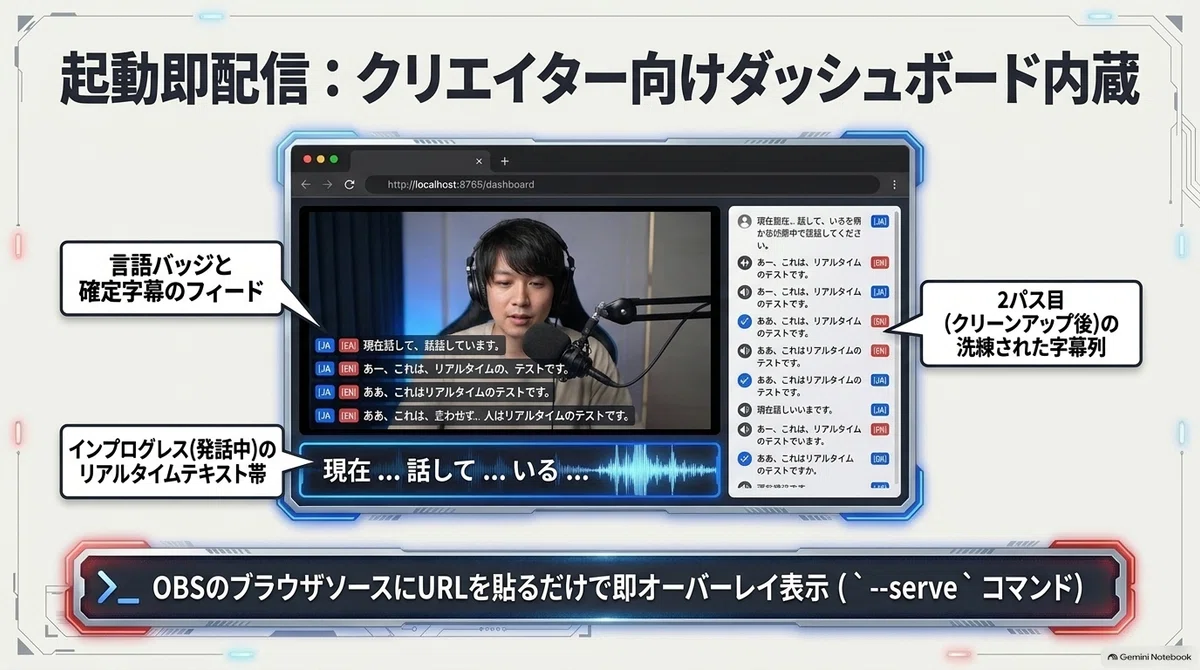
ライブ字幕表示: 発話中も0.5秒ごとに仮のテキストを表示し、リアルタイム感を演出。
ブラウザベースのダッシュボード: 専用URLにアクセスするだけで、文字起こし結果や翻訳結果をグラフィカルに確認できます。
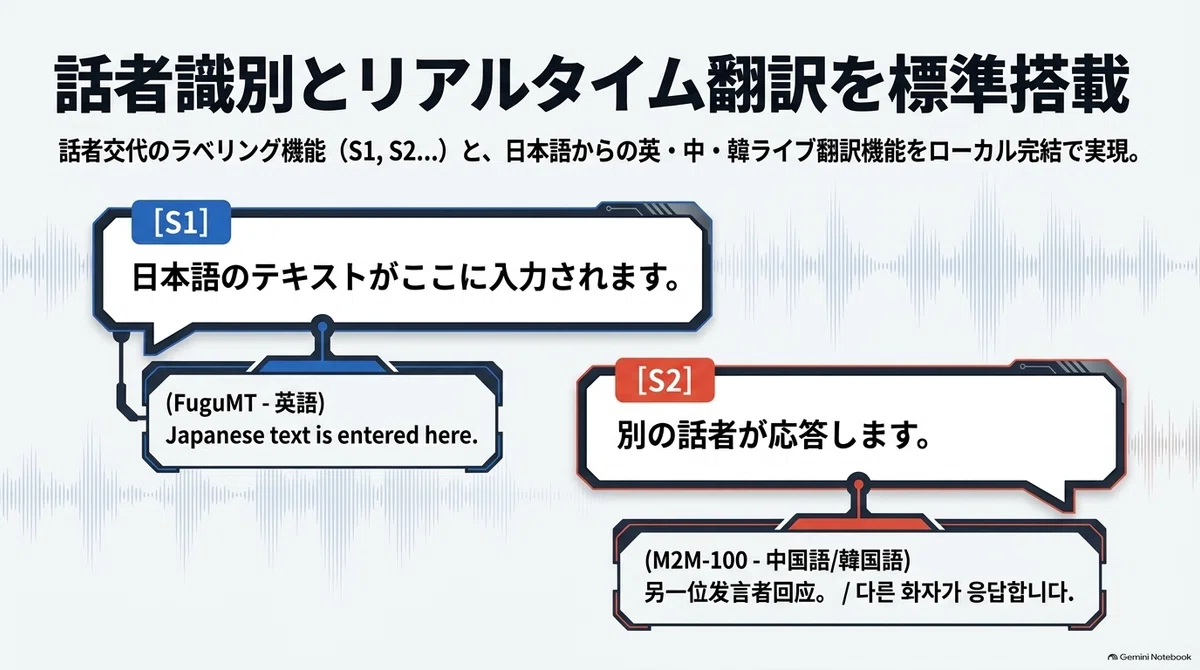
話者ラベル機能: CAM++という技術を用い、誰が話しているかを識別して「S1, S2...」といったラベルを自動で付与。
リアルタイム翻訳: 日本語の発話を英語、中国語、韓国語へ即座に翻訳して表示することが可能。
3. このツールが向く人・向かない人の徹底判定
「hayamimi」は非常に強力ですが、万能ではありません。利用環境や目的によって、その価値は大きく変わります。ちゃんと使わないなら、どんな優秀な道具も役立たずになっちゃう。
わたしのような貧乏PCでの文字書き起こしはむっちゃ推奨かもです。
このツールが向いている人
ライブ配信者(OBS利用者): GPUをゲームや配信ソフトにフル活用したい配信者にとってCPUだけで動く「hayamimi」は理想的な字幕ツール。
プライバシーを最優先するビジネスパーソン: 会議の内容を一切外に出したくない場合、インターネット接続不要の完全ローカル動作は唯一無二の安心材料。
一般的なビジネスPCユーザー: 高価なグラフィックボードを搭載していないノートPCでも、快適に高精度な文字起こしを体験したい方に最適。
海外動画や会議をリアルタイムで理解したい人: 言語の壁を感じている方が、低遅延の翻訳字幕を補助として使うのに非常に適しています。
このツールが向かない人
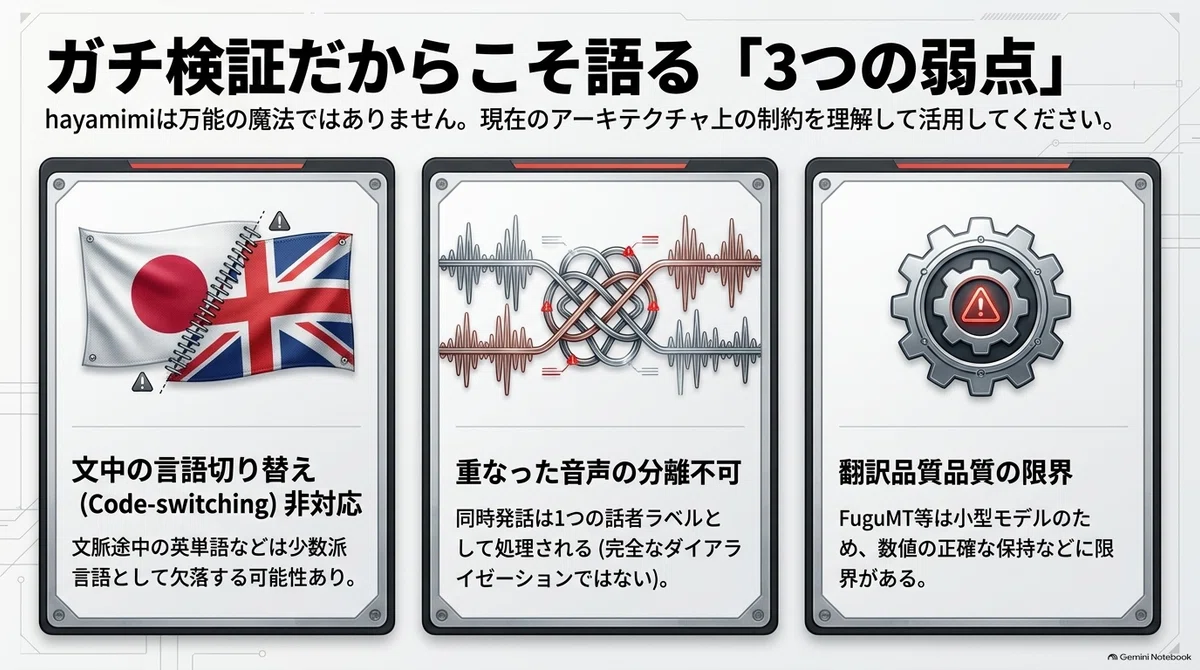
コードスイッチングが頻発する環境: 「一つの文章の中」で日本語と英語が入り混じるような話し方には弱く、どちらかの言語が脱落する可能性があります。これは向きませんでした。
多人数が同時に重なって話す環境: 複数の発話が完全に重なり合うと、話者の識別や正確な文字起こしが困難になります。
完璧な翻訳精度を求める場合: 翻訳モデルの特性上、特に金融や数値に関わる翻訳において、数字が正確に保持されないリスクがあります。こういうのは用途が違うかなーって感じです。
4. 性能評価:数字で見る驚異のレスポンスと精度
「hayamimi」の実力は、主観的な感想ではなく、客観的なデータによって証明されています。
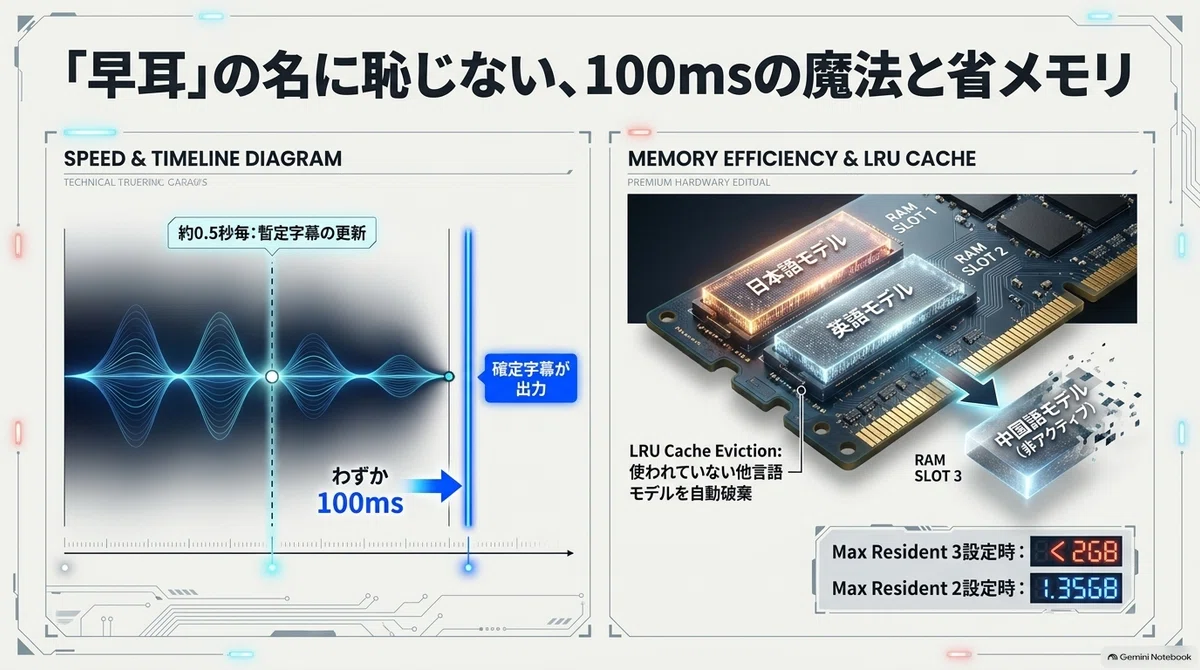
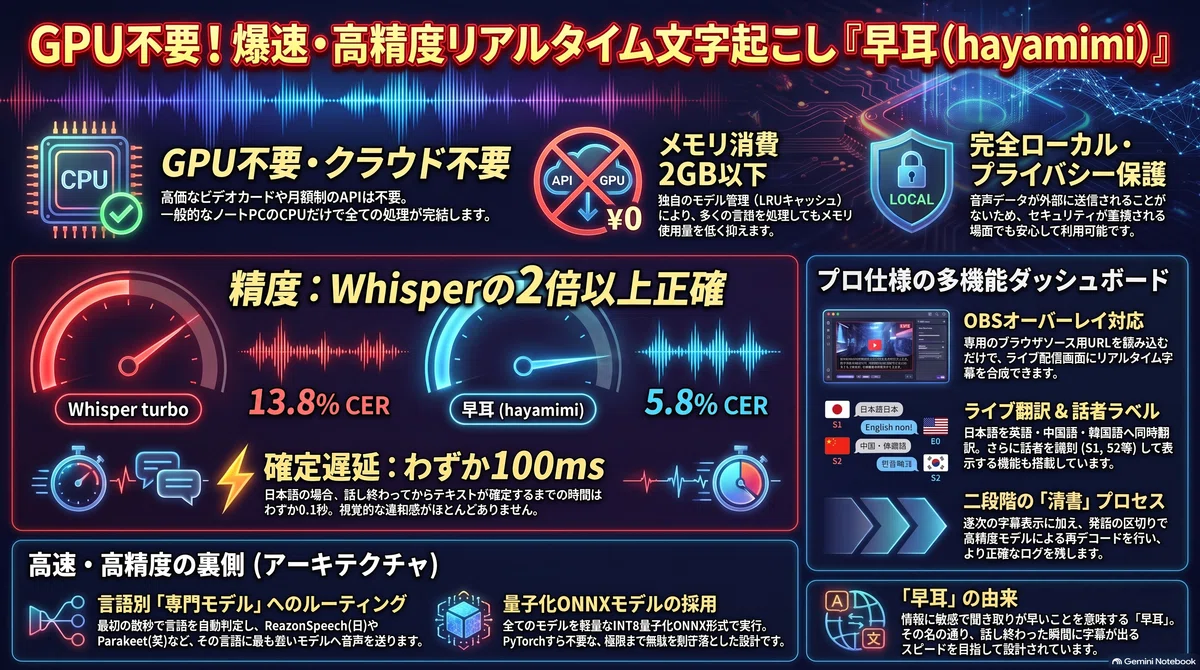
驚異の低遅延(レスポンス速度): 日本語の場合、発話を終えてから確定したテキストが表示されるまでの時間は、わずか 約100ms(0.1秒) 。これは人間が「一瞬」と感じる速度であり、会話のテンポを崩しません。
圧倒的なCPU効率: RTF(リアルタイム・ファクター)は0.07〜0.10という数値を記録。これは1秒の音声を処理するのにCPUの能力をわずか0.1秒分しか使わないことを意味し、一般的なPCでも9倍〜16倍の速さで余裕を持って処理できる計算。
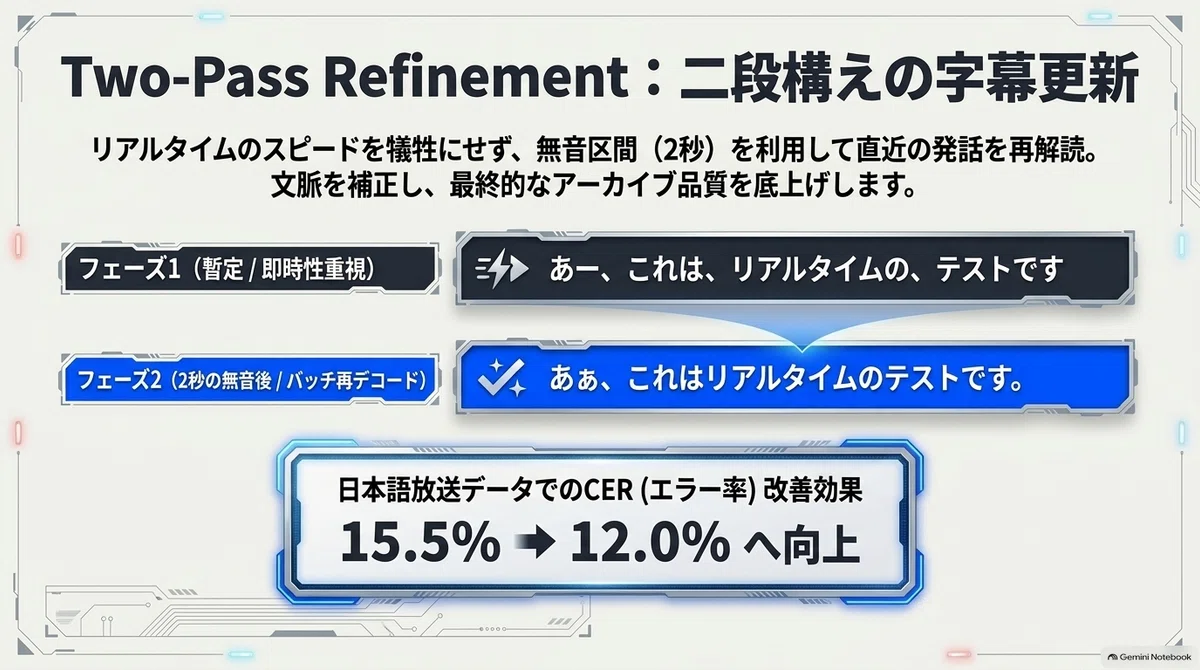
「二段構え」の精度向上: リアルタイムでの速報性に加え、2秒間の無音を検知した後に再度解析を行う「二段階のリファイン(再デコード)」機能を搭載。これにより日本語の放送音声を用いたテストでは、当初15.5%だったCER(文字誤り率)が 12.0% まで改善され、より「正しい記録」へと昇華されます。
軽量なメモリ効率: 動作に必要なメモリは 2GB以下。設定によっては1.35GB程度まで削減可能で、数年前のPCでも余裕を持って動作します。
最高水準の認識精度: 最も精度の高い設定では、日本語の放送音声において CER 5.8% という驚異的な数値を叩き出しています。
5. 他ツールとの性能比較:Whisperを超えた「日本語特化」の意地
現在、音声認識の業界標準はOpenAIの「Whisper」ですが、「hayamimi」は特定の条件下でこれを凌駕します。
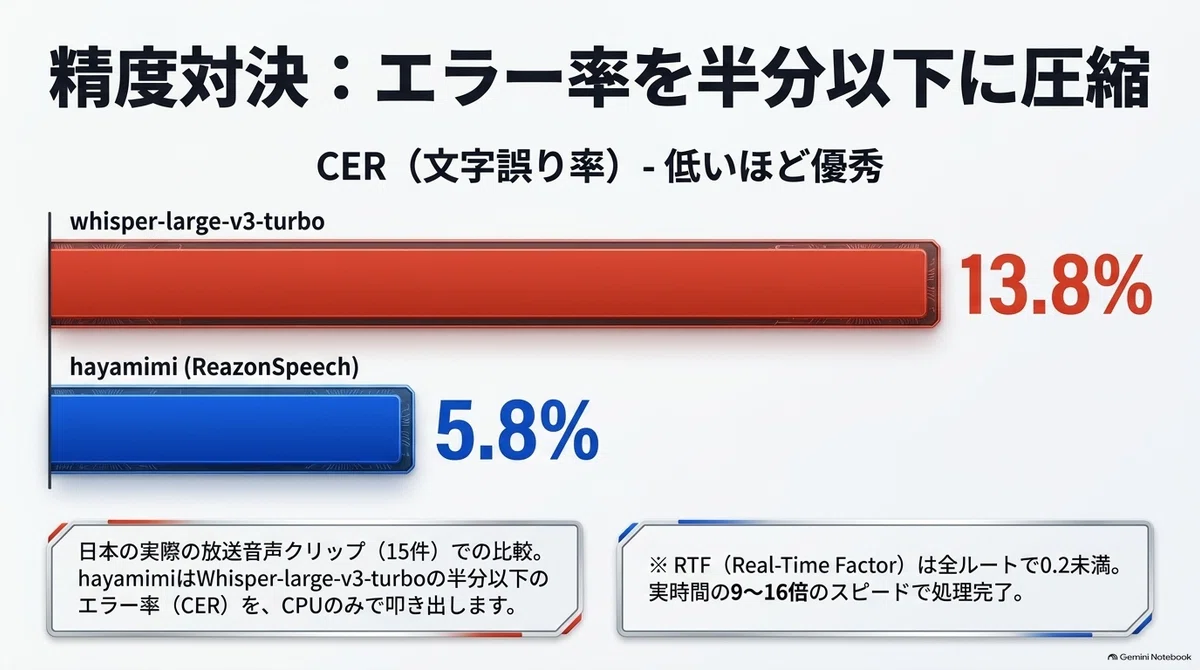
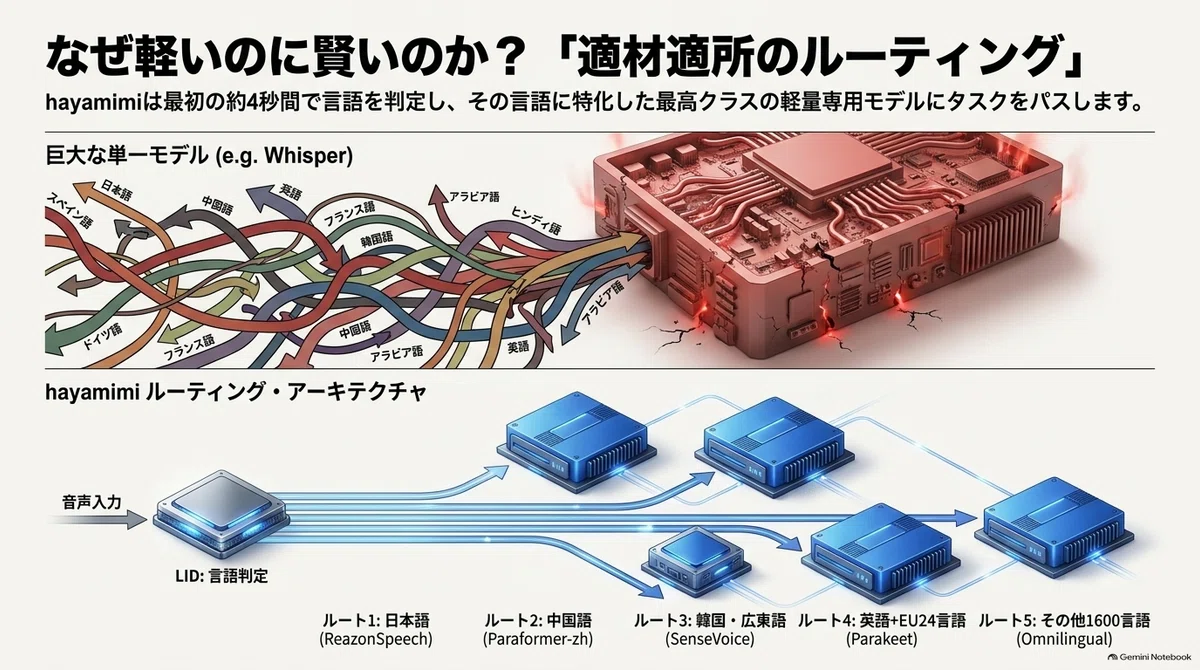
Whisperの最新高速モデル(whisper-large-v3-turbo)がCER 13.8%であったのに対し、「hayamimi」が採用している日本語特化モデル(ReazonSpeech)は 5.8% という、半分以下のエラー率を記録。
この差が生まれる理由は、その「戦略的アプローチ」の違いに。Whisperが一つの巨大な汎用モデルで全部こなそうとする「総合診療医」だとすれば、hayamimiは 各言語に最強の「専門医」を待機させ、最適な担当者を瞬時に割り当てるチーム医療 のような仕組み。
日本語には日本語に最も強いモデルを、英語には英語に強いモデルを。状況に合わせて最適なスペシャリストを呼び出すルーティングこそが、CPU動作でありながら最高峰の精度を実現する鍵。
6. メリットとデメリット:公平な視点での評価
ツール選びのために、メリットとデメリットを公平に。
メリット
究極のプライバシー保護: 音声がクラウドに送信されないため、社外秘の情報も安心して扱えます。
API料金不要のゼロコスト: 一度セットアップすれば、24時間使い続けても無料です。
低負荷なマルチタスク: CPU負荷が極めて低いため、他の作業をしながら並行して動作させてもPCが重くなりません。
OBS連携の容易さ: 配信ソフトにそのまま取り込めるブラウザソース機能が標準搭載されています。
デメリット
文中の言語混在: センテンスの途中で言語が切り替わる話し方は、誤認識の原因となります。
翻訳の不安定さ: 日本語から他言語への翻訳において、繰り返しが発生したり、特に数字の正確性が損なわれたりすることがあります。「正確な請求書の金額を確認する」といった用途には絶対に使用しないでください。ミスの原因です。これはもうやろうとした人が悪いよ。
短すぎる発話へのリスク: ジングルやBGM直後の極端に短い発話は、言語判定を誤る可能性があります。
7. どんな悩みを解決するか:具体的な課題解決シナリオ
「hayamimi」は、あなたの業務や活動における以下の悩みを解消します。
「議事録作成に時間がかかりすぎる」 会議中にリアルタイムで文字起こしを行い、テキストとして保存。二段階のリファイン機能により、後で読み返すだけで正確な内容を把握できます。
「海外とのオンライン会議で内容が追いつかない」 相手の英語をリアルタイムで文字化し、補助的な「カンニングペーパー」として活用。理解のスピードと安心感が格段に向上。
「ライブ配信に字幕を出したいが、GPU負荷が心配」 GPUをゲームに100%割り当てたまま、CPUの余力だけで高品質な字幕配信が可能に。
8. 導入方法:シンプルに始めるためのステップバイステップ
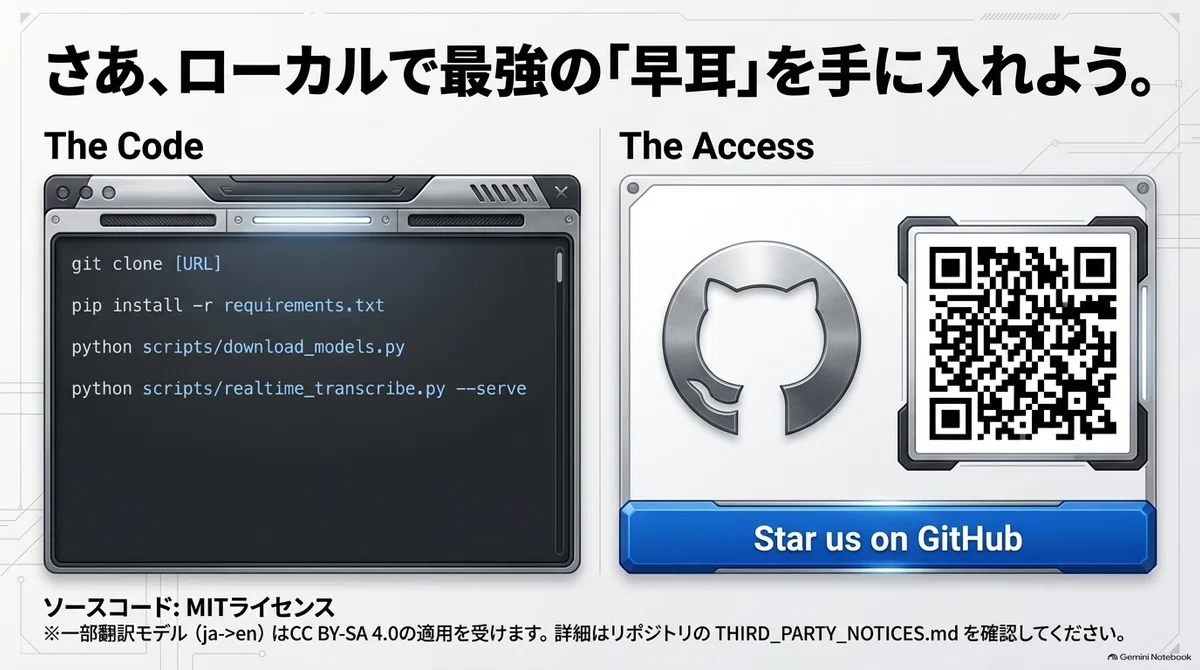
導入には Python 3.10以降 と、パスの通った ffmpeg が必須となります。これらが準備できていることを確認し、以下の手順を進めてください。
仮想環境の構築: PCの環境をクリーンに保つため、専用の環境を作ります。 python -m venv .venv
依存ライブラリのインストール: Windows: .venv\Scripts\pip install -r requirements.txt mac/Linux: .venv/bin/pip install -r requirements.txt
モデルのダウンロード: 通常は約3.1GBのモデルをダウンロードしますが、日本語と英語のみで良い場合は容量を節約できる --minimal オプションが便利です。 python scripts/download_models.py --minimal (これによりダウンロードサイズを約1.1GBまで圧縮できます)
実行: マイクからリアルタイムで文字起こしを開始。 python scripts/realtime_transcribe.py --serve
実行後、ブラウザで http://localhost:8765/dashboard を開くと、視覚的なダッシュボードが表示されます。
9. ビジネス事例:実務での活用アイディア
「hayamimi」を単なるツールから「ビジネス加速装置」へと昇華させる活用法はざっと調べた感じはこんな感じです。
多国籍チームのハイブリッドミーティング: 日本語話者の発言を英語・中国語・韓国語へリアルタイム翻訳し、共有画面に表示。言語の壁による情報格差を解消。これはかなり有用そう。むっちゃ軽いし。
機密情報を扱う専門職の商談: 弁護士や医師など、高度な守秘義務が求められる現場での自動記録。クラウドを介さないため、セキュリティポリシーへの抵触を防げます。ろーかるふぁーすと
コンプライアンス上の注意: ビジネス利用において注意すべきはライセンス。本ツールのコード自体はMITライセンスですが、日本語から英語への翻訳モデル(FuguMT)は「CC BY-SA 4.0」ライセンス。企業で利用・再配布する際は、このライセンス条項を遵守するよう留意してください。
10. まとめ:早耳が切り拓く「ローカルAI」の未来
「hayamimi」は、GPUやクラウドという制約からAIを解き放ち、誰でもどこでも高精度な音声認識を手に入れられるようにしました。
ONNX変換やINT8量子化といった高度な技術の進化が、巡り巡って「自分のPCで、無料で、安全に文字起こしができる」という、極めて具体的で身近な便利さに直結しているのです。
まずは一度、あなたのPCでその「速さ」を体感してみてください。話した瞬間に文字が紡ぎ出されるその快感は、あなたのワークスタイルを一段上のステージへと引き上げてくれるはずです。
いいなと思ったら応援しよう!
 よろしければ応援お願いします♡ いただいたチップはクリエイターとしての活動費に使わせていただきます!
