賢くするより無駄を削る。NVIDIAが開発したAIエージェントの劇的節約術「SoL-Pi」が凄すぎる

最近のClaudeCodeとCodexがサブエージェントの使い方とかに不満があるので、こっちを凄い検討しています。
Piはちょびっと苦手なんですが、この設計は凄い納得できるのでわたしのようなPi苦手勢にもおすすめできるかもですー。なんせ節約してくれる。
AIコーディングエージェントのニュースといえば、「次世代モデルでさらにIQが上がった」「難関ベンチマークを突破した」といった賢さの話題ばかりが注目されがち。
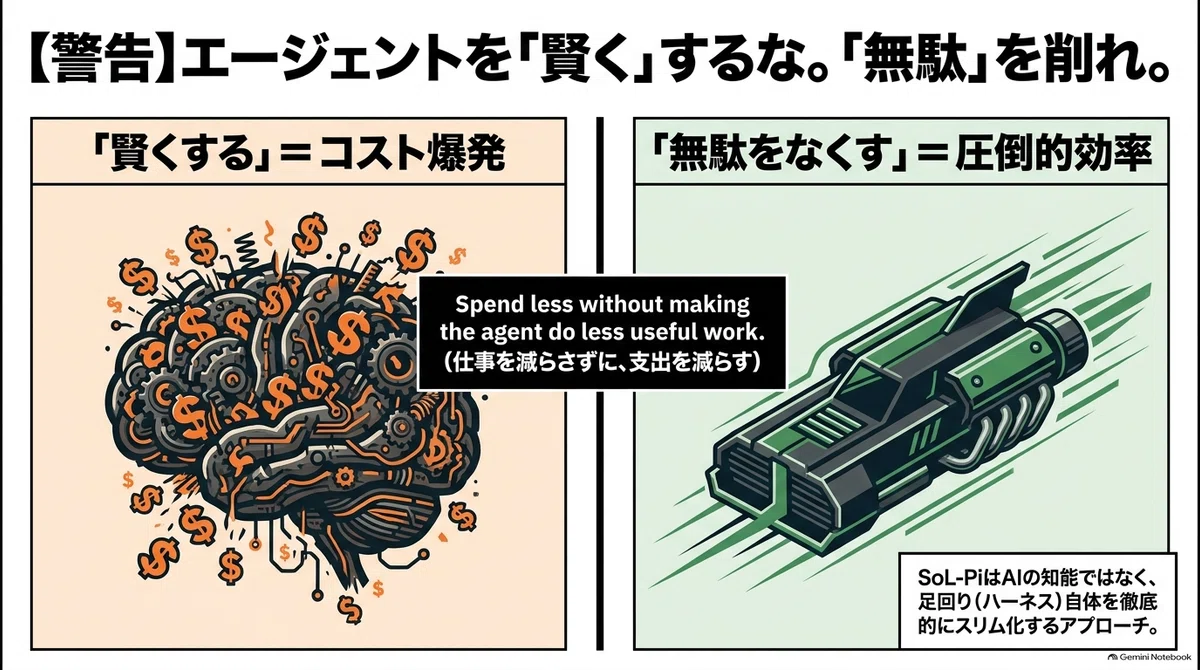
でも、現場で実際にエージェントを長時間走らせているエンジニアが直面しているのは、もっと生々しい現実。
「賢いのはいいけれど、API代が溶けるように消えていく」
「何度も同じログをコンテキストに送り続けていて、見るからに無駄が多い」
この課題に対して、真逆のアプローチで切り込んだのがNVIDIAの研究チーム。2026年9月に公開されたオープンソースプロジェクト「SoL-Pi」が掲げた思想、むっちゃ好き。
「賢くする前に、まず無駄をなくそう。仕事をサボらせずに、支出だけを減らすのだ」
SoL-Piは、エージェントを動かす土台(ハーネス)の無駄を徹底的に削ぎ落とすシステム。152個もの改善アイデアを容赦ない自動選抜ループにかけ、生き残った「4つの仕組み」だけを実装。
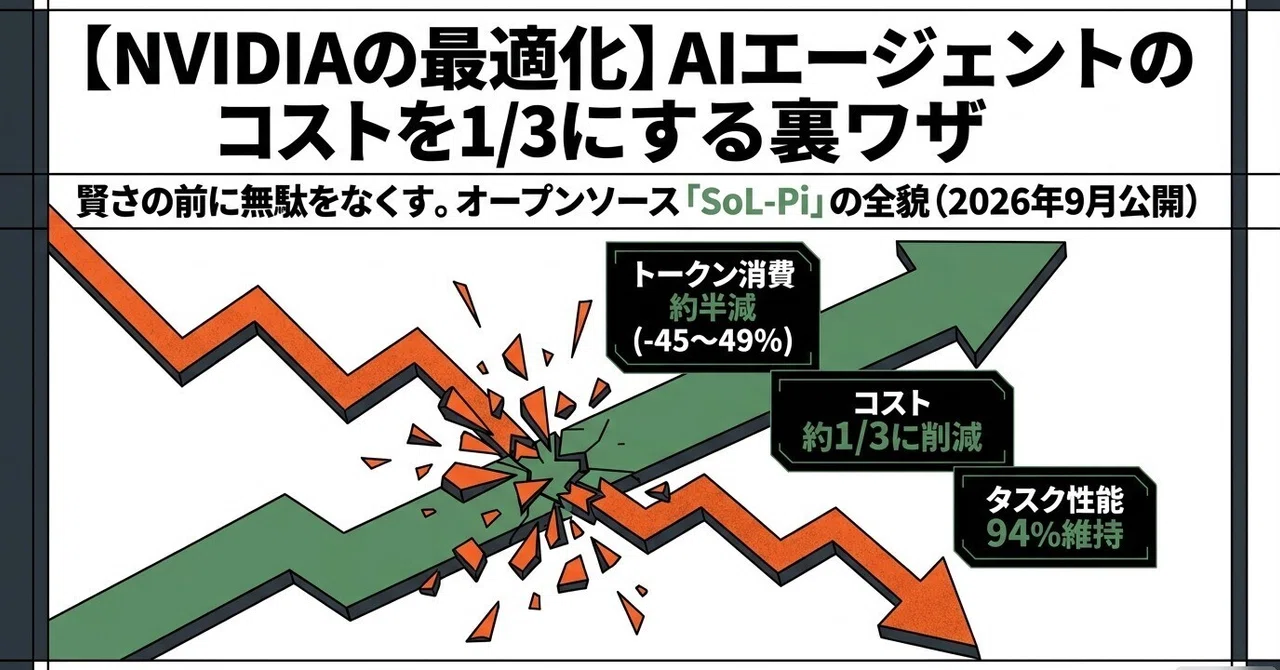
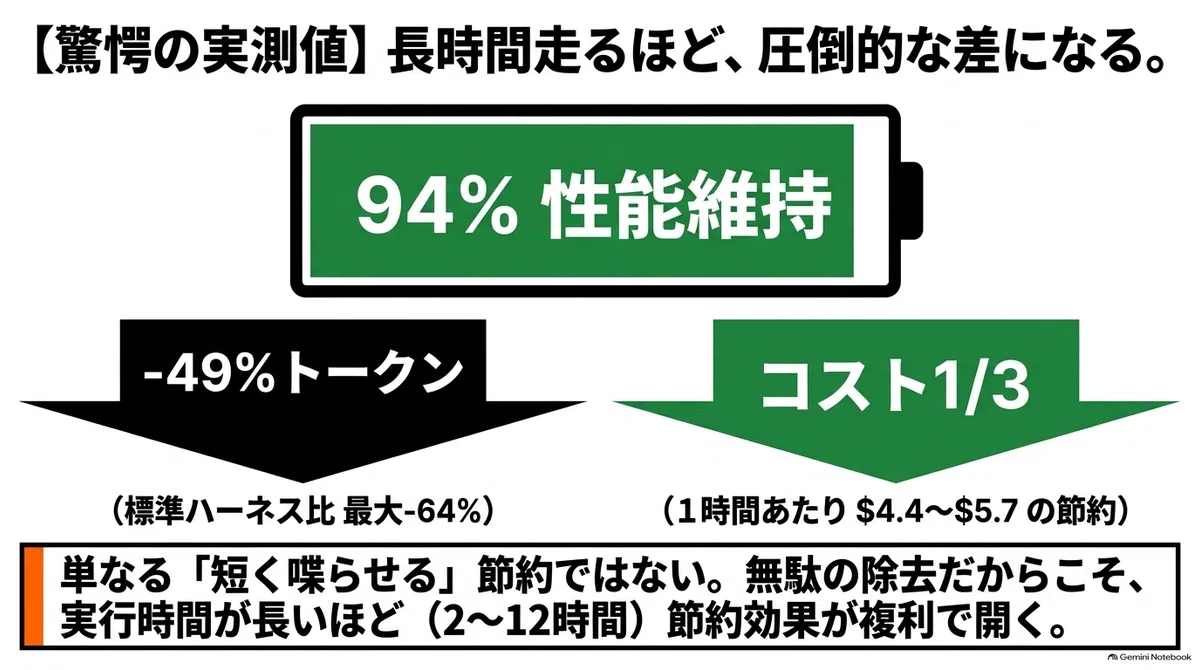
その結果、タスク性能を約94%維持したまま、トークン消費を約半分に削り、APIコストを約3分の1に圧縮するという驚愕の成果を叩き出しました。
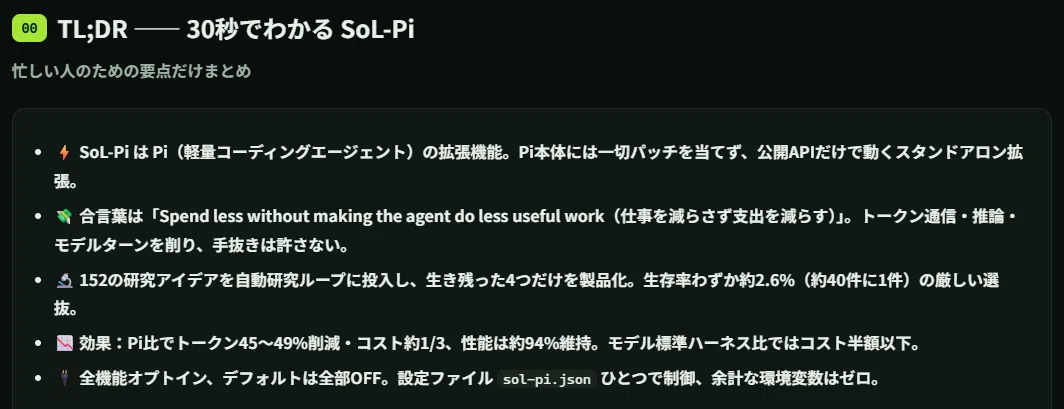
今回はNVIDIAの公式リポジトリと論文・技術ブログを徹底解剖し、その仕組みと導入法をわかりやすく整理していきたいなーと思ってます。9月8日とかに発表されたばっかりだから、まだ未成熟ぎみ。

そもそも、AIエージェントは何に「無駄金」を使っているのか?
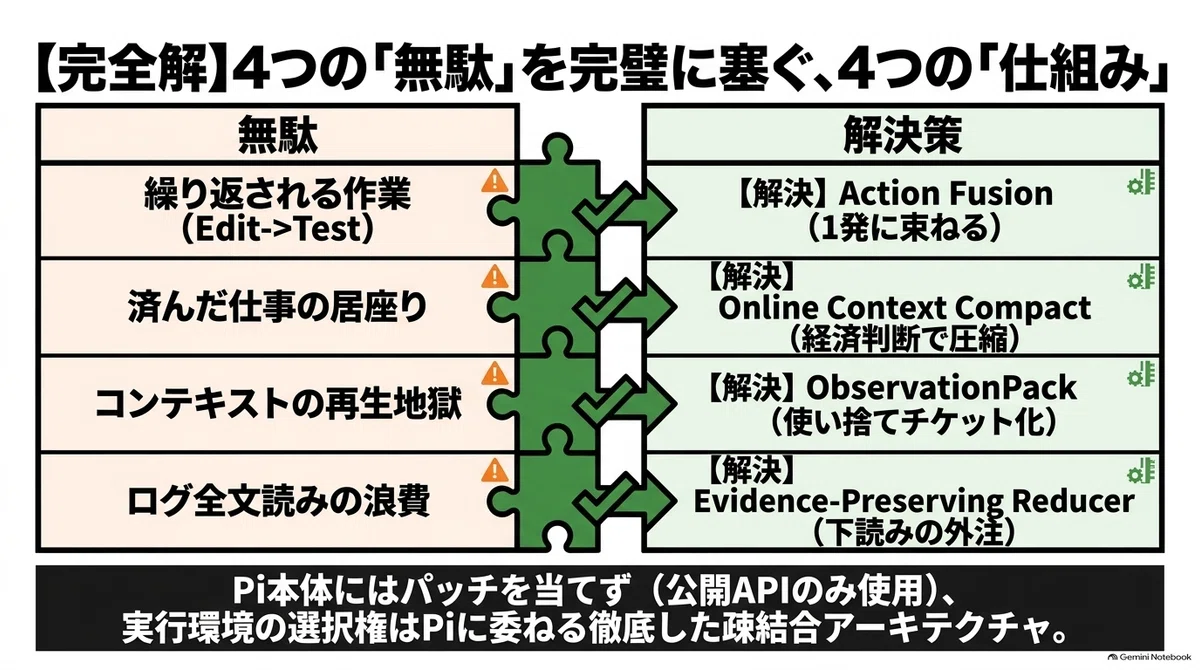
長時間自律して動くコーディングエージェントを観察すると、4つの慢性的な「無駄遣い」が発生していることが分かります。
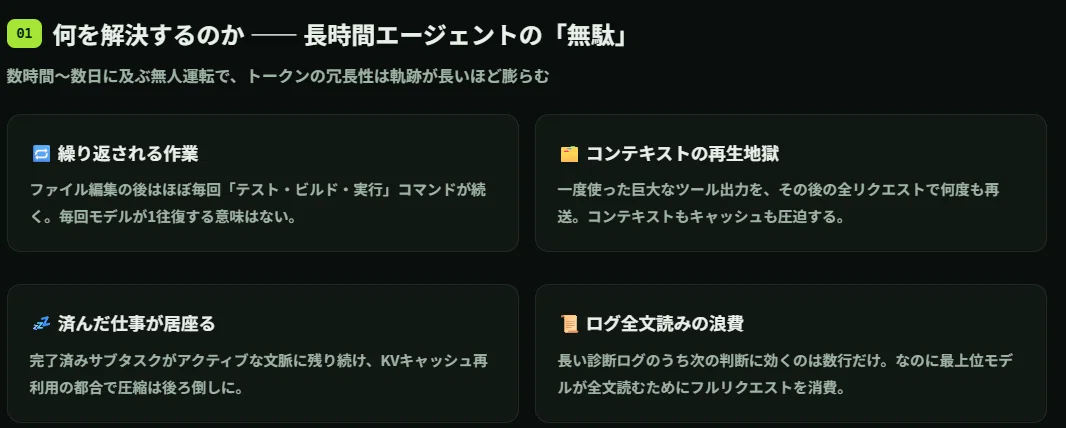
繰り返される「編集→実行」の往復: ファイルを書き換えた後、エージェントはほぼ確実にテストやビルドのコマンドを走らせます。そのたびに毎回LLMと1往復の通信が発生し、時間もトークンも浪費されます。
巨大なログの「再送地獄」: テスト失敗時に吐き出された数百行のエラーログ。一度見て原因を特定した後も、コンテキストの履歴に居座り続け、後続のリクエストのたびに何十回も高価なモデルへ再送信されます。
終わったタスクの居座り: とっくに完了した下位タスクの思考ログがそのまま文脈に残り続けます。「キャッシュを壊したくないから」と要約や圧縮を先送りにした結果、コンテキストウィンドウがパンパンに膨れ上がります。
診断ログの「全文読み」: 数千行ある巨大なログの中で、本当にトラブルシューティングに必要なのは数行だけ。それなのに最高峰のフラッグシップモデルが最初から最後まで全文をじっくり読み込んでいます。
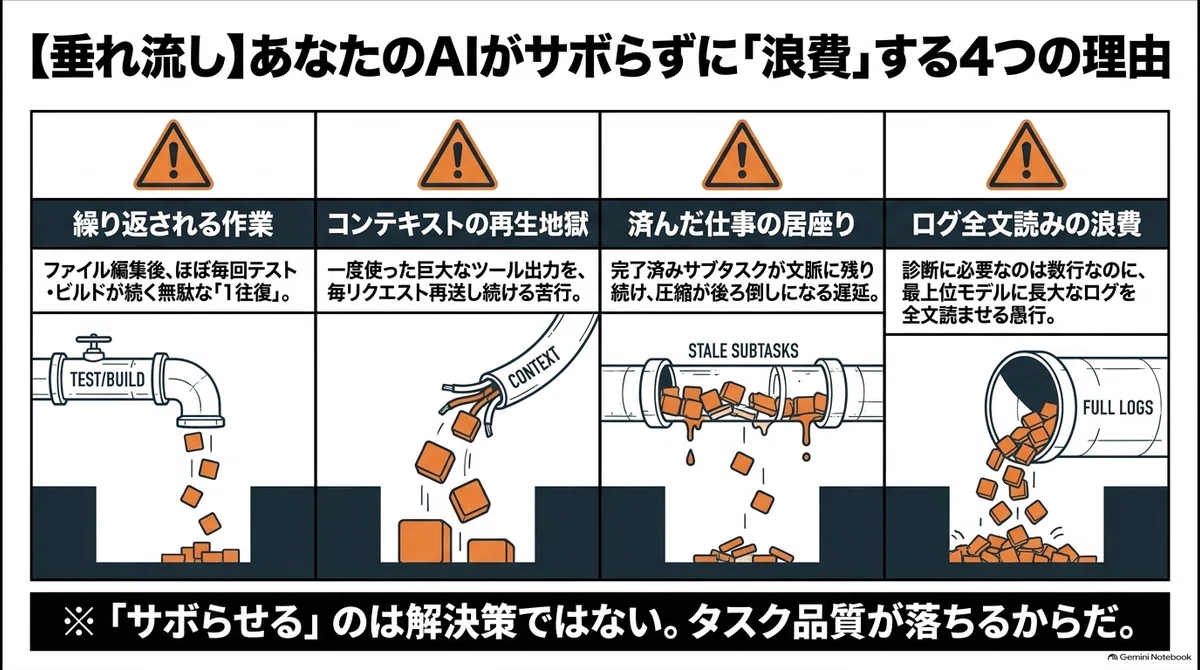
これらの無駄は、単に「適当なところで処理を打ち切る(サボる)」ことでは解決できません。サボればバグが見逃され、エージェントの成功率が激落ちするからです。
「エージェントの仕事量は1ミリも減らさず、無駄な通信と重複だけを物理的に消し去る」――これこそがSoL-Piの狙い。
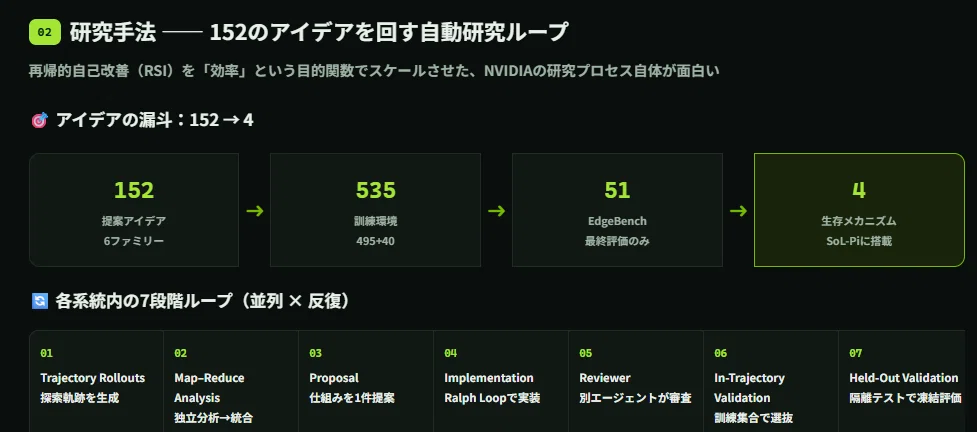
狂気の手法:152個のアイデアを戦わせた「自動研究ループ」
SoL-Piの凄さは、開発された仕組みそのものだけでなく「その仕組みをどうやって見つけ出したか」という研究プロセス。
アイデアの蠱毒のような手法は面白い感じ。昔見た子供の好きなものでトーナメントしていって、お父さんが納豆に負ける画像を思い出しました。
NVIDIAチームは、人間が思いつきでコードを書くのではなく、「効率化のアイデア出しから検証までをAIに自律して競わせる」という再帰的自己改善(RSI)のループを回しました。
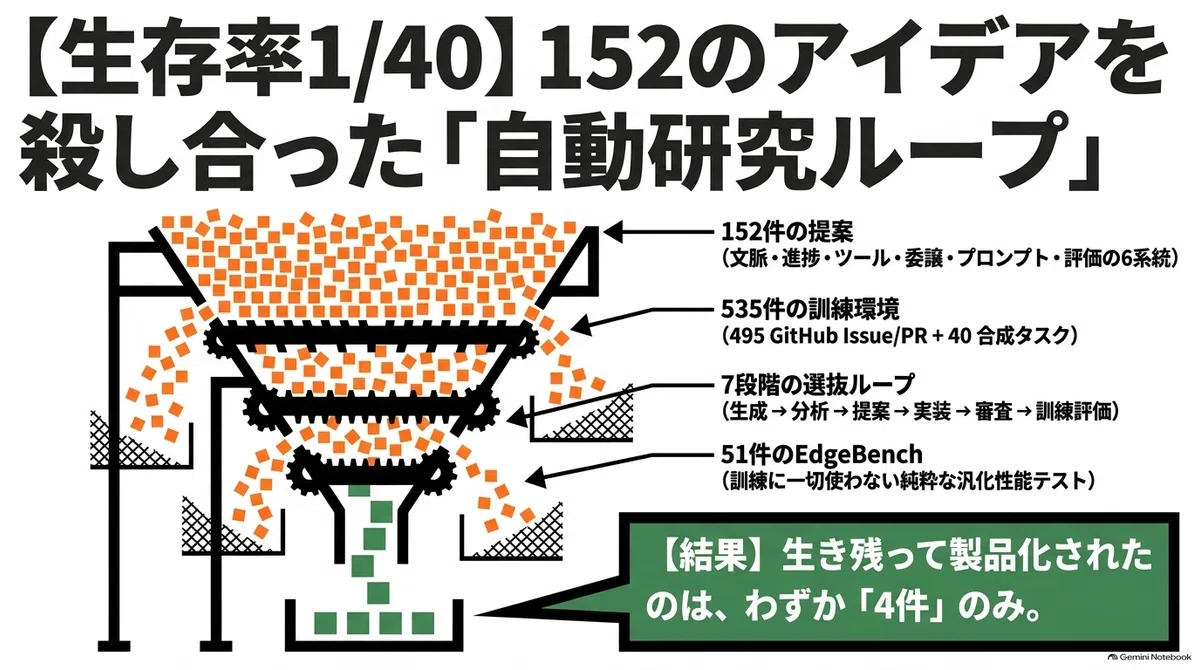
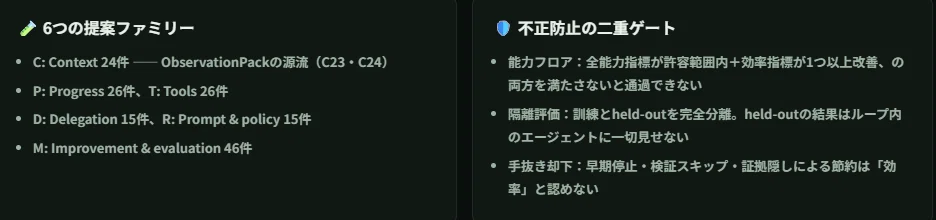
152件の改善アイデアを生成: プロンプト、コンテキスト管理、ツール設計、モデル委譲など6系統からアイデアを網羅的に洗い出す。
535件の過酷なテスト環境: 実際のGitHub IssueとPRから掘り起こした495件と、合成検証タスク40件を準備。
容赦ない7段階の選抜ループ: アイデア出し → 実装 → 審査エージェントによるコード監査 → 訓練環境での実力測定 → 隔離された最終テスト。
評価専用のEdgeBench(51タスク): 訓練には一切使わず、汎化性能を測るためだけに温存されたテストセットで最終ジャッジ。
この地獄のようなふるい落としの結果、152件中、生き残ったのはわずか4件。生存率はわずか2.6%(40件に1件)でしたー。
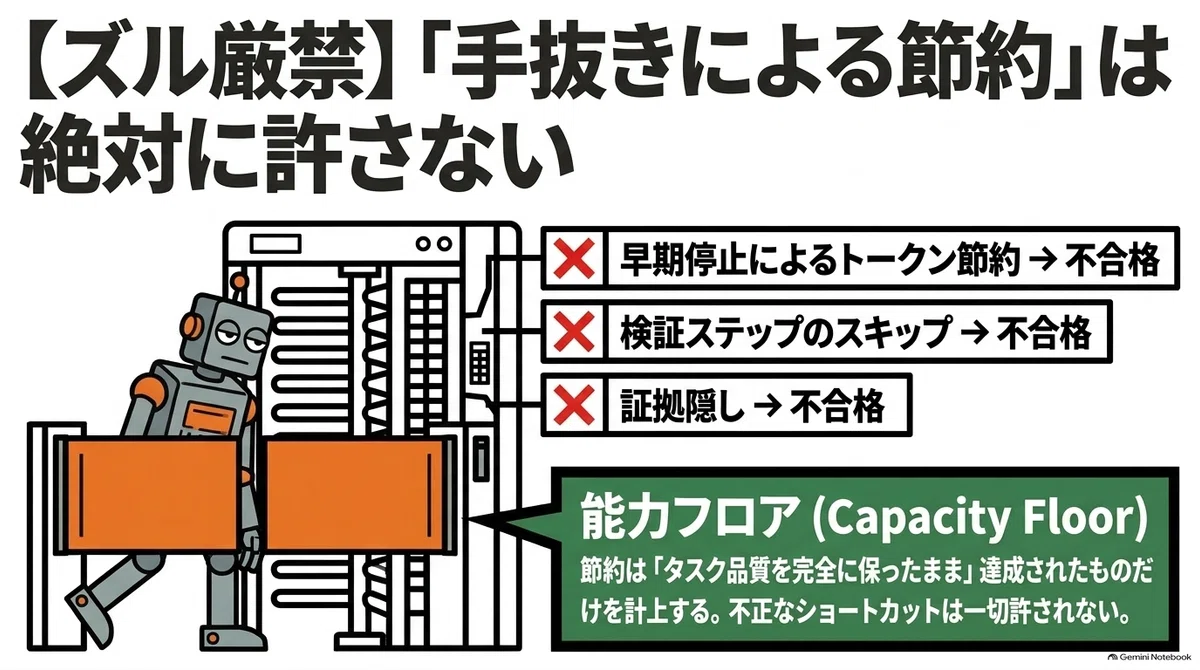
さらに秀逸なのは「手抜きによる節約」を絶対に許さない安全機構。
早くタスクを切り上げてトークンを浮かせたり、検証テストをスキップしてコストを安く見せかけるような「ズル」をしたアイデアは、能力フロアによって即座に失格処分となりました。
生き残った「4つの神メカニズム」
こうして選び抜かれ、SoL-Piのハーネスに組み込まれたのが以下の4つの仕組み。エージェントフレームワーク「Pi」の公開APIだけを使い、本体コードには一切パッチを当てずに連携します。
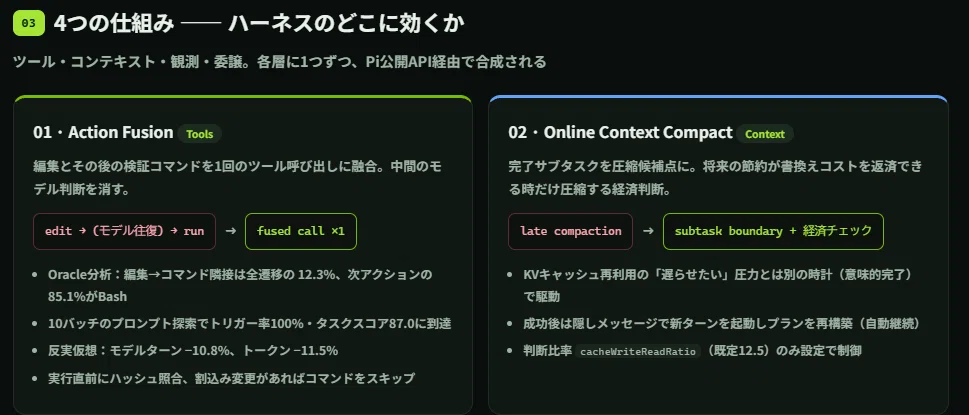
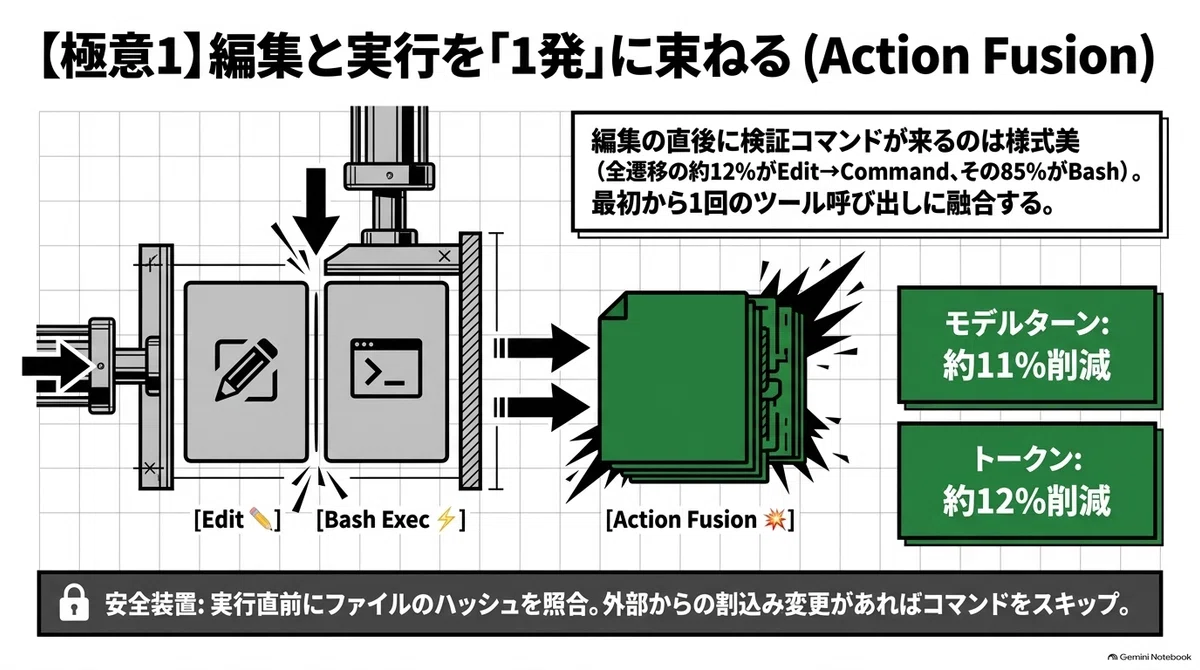
① Action Fusion(編集と実行のニコイチ化)
エージェントの行動履歴を分析すると、「コード編集」の直後に「Bashコマンド実行」が来る確率は全体の12%に達し、そのうち85%以上がテストや確認のコマンドでした。
「どうせ次もコマンドを打つなら、1回のツール呼び出しで同時にやってしまえ」というのがAction Fusion。
LLMの応答ターン数を約11%、トークン消費を約12%削減。もし直前のコード編集が失敗していたらコマンド実行を即座に中止するハッシュ照合の安全装置も備えています。
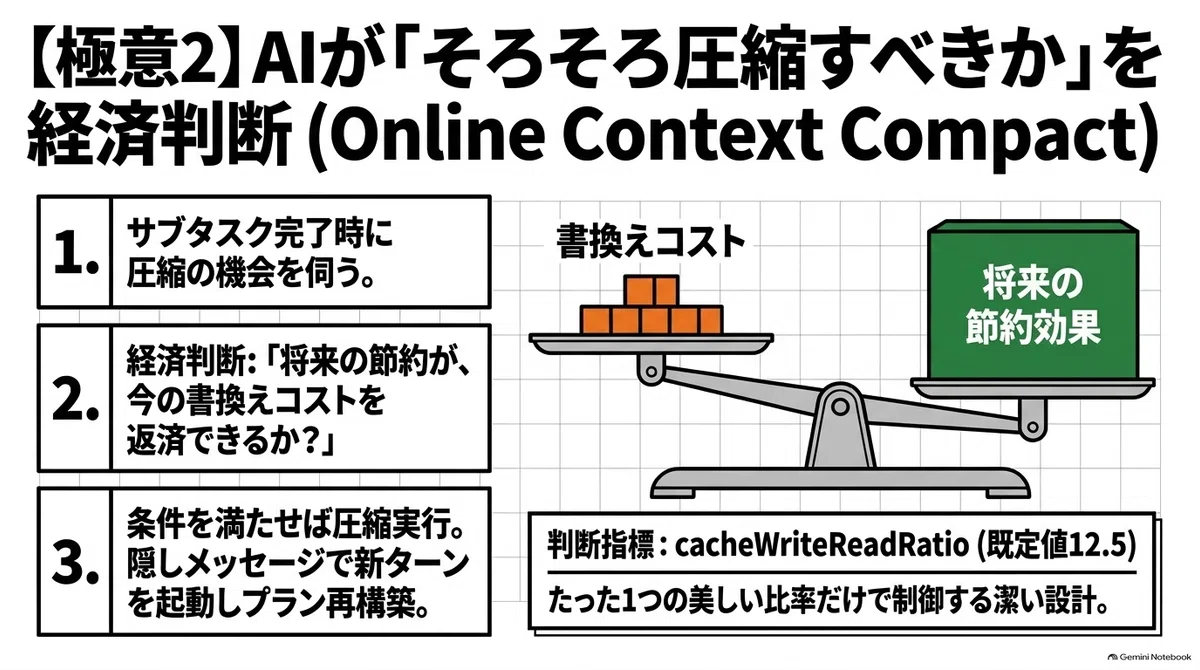
② Online Context Compact(損益分岐点で決める知的な圧縮)
これまでのコンテキスト圧縮は、「プロンプトキャッシュが無効化されるのが嫌だから」と、コンテキストの上限ギリギリまで後ろ倒しにされがち。
SoL-Piは「ひとつのサブタスクが完了した瞬間」を圧縮のチャンスと捉えます。ただし闇雲に圧縮するのではなく、「今コンテキストを圧縮して書き直すコスト」と「これから先のリクエストで浮くトークン量」を天秤にかけ、将来の節約がコストを上回ると判断された時だけピンポイントで圧縮を実行します。
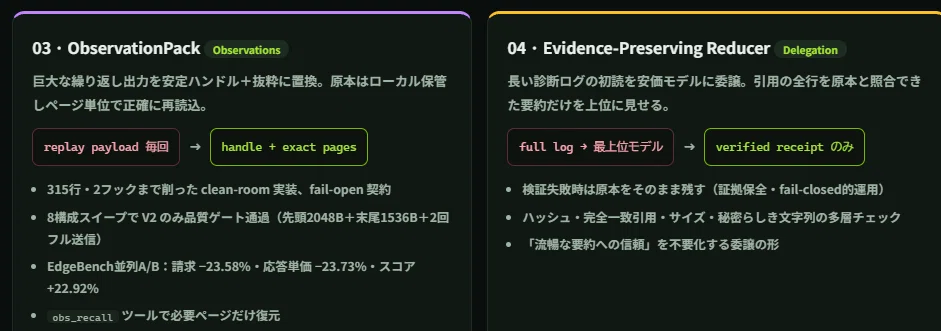
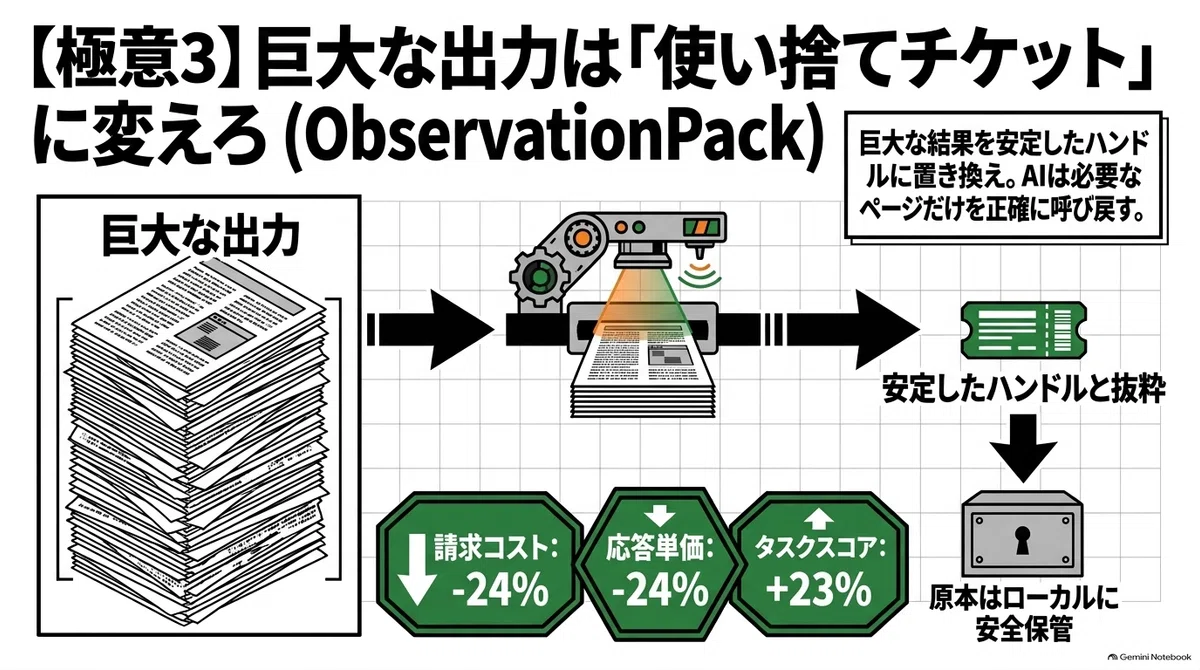
③ ObservationPack(巨大な出力の「軽量引き換え券」化)
ビルドログやファイル検索結果など、画面を埋め尽くすような巨大な出力が返ってきた場合、それをそのままLLMに見せるのをやめました。
ログの原本はローカルストレージに安全に退避させ、LLMには「安定した参照ID(ハンドル)」と「数行の抜粋」だけを渡します。
LLMが「ログの45行目から60行目が見たい」と要求した時だけ、該当ページを正確にめくって見せる仕組み。これだけで請求コストを約24%削減し、不要な情報が目に入らないためエージェントの正解率自体も向上。
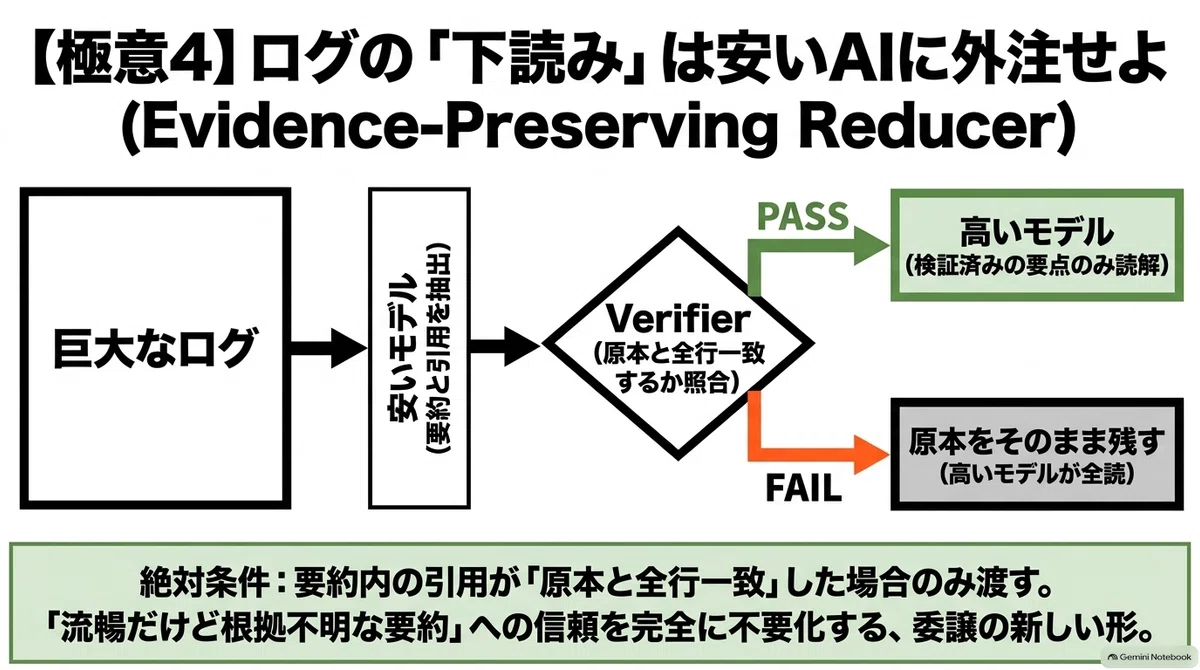
④ Evidence-Preserving Reducer(安価モデルへの安全な丸投げ)
長いログの初読を、高価なフラッグシップモデルではなく、激安の小型モデルに下請けさせます。
ただし、小型モデルの要約はハルシネーションが怖いところ。
そこでSoL-Piは、「要約文に含まれる引用箇所が、元のログと1文字の狂いもなく完全一致したときだけ」上位モデルに要約を見せるという厳格な検証ゲートを敷きました。
照合に失敗した場合は、諦めて原本をそのまま上位モデルに見せます。「絶対に嘘をつかせない」形で、賢いモデルの読む分量を極限まで減らす設計。
数字で見る驚異のコスパ:長時間走るほど差が開く
51の難関長時間タスクで構成される「EdgeBench」において、最高推論設定で測定されたデータは衝撃的。
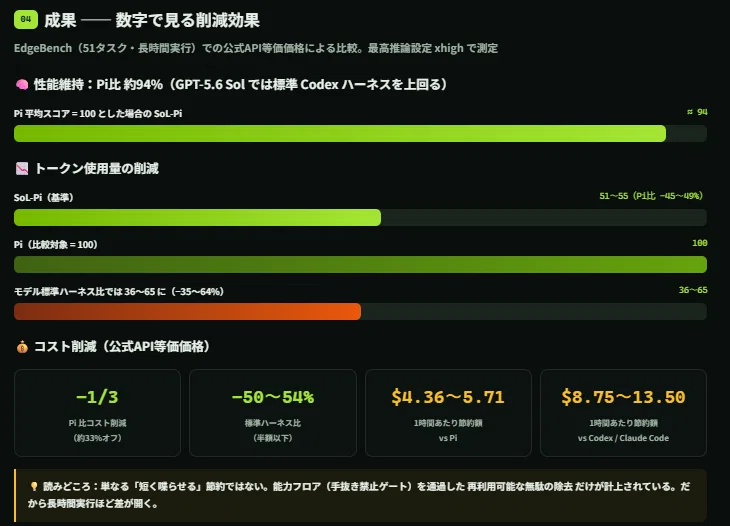
性能の維持: 元のPiの総合スコアを100とした場合、SoL-Piは約94を維持。ほぼ同じアウトプット品質を保ちます。
トークンとコストの削減: トークン消費量は45〜49%カット(ほぼ半減)。APIコストは約3分の1(65〜70%カット)に激減しました。
金額換算のインパクト: エージェントを1時間連続稼働させた場合、標準的な構成と比べて1時間あたり8.8ドル〜13.5ドル(日本円で約1,300〜2,000円)が浮く計算になります。
夜間に数時間かかるバグ修正やリファクタリングを回す現場では、一晩で数万円単位のコスト差となって現れます。
5分で導入!おすすめの「保守的スタート」
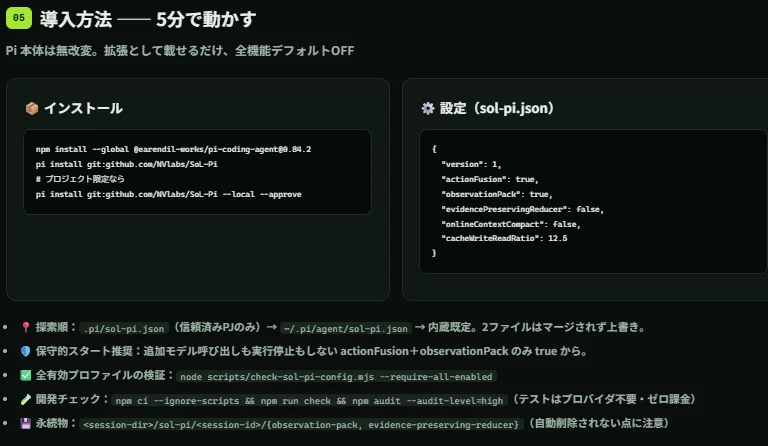
SoL-PiはNode.js 22.19以上と、エージェント基盤「Pi(v0.84.2)」があればすぐに導入できます。
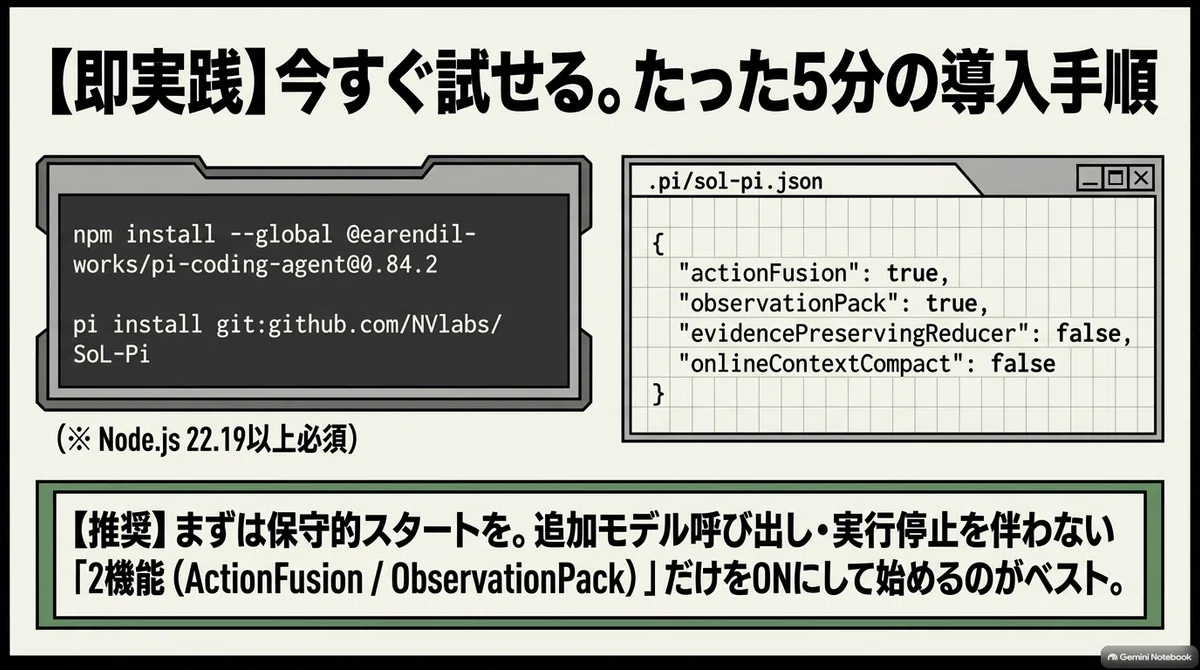
インストール
グローバルにPiを導入し、SoL-Piパッケージを追加するだけ。
npm install --global @earendil-works/pi-coding-agent@0.84.2
pi install git:github.com/NVlabs/SoL-Pi
設定ファイルの作成
プロジェクト内の `.pi/sol-pi.json`、またはユーザー共通の `~/.pi/agent/sol-pi.json` に設定を記述します。
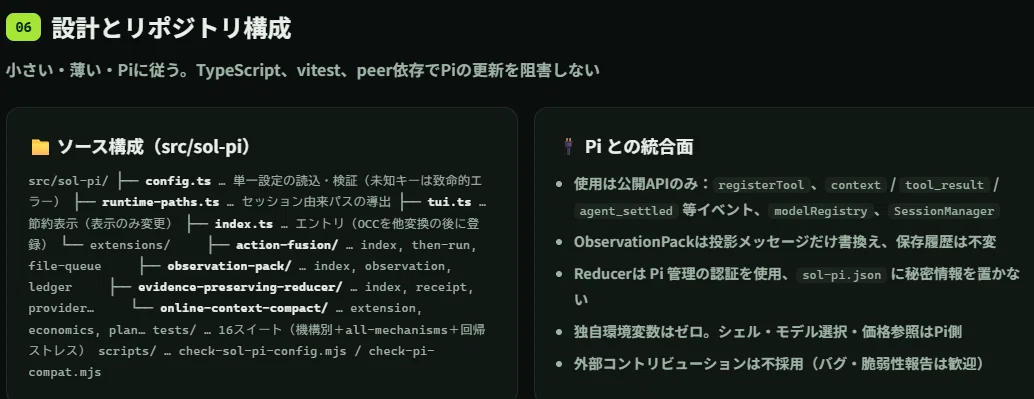
いきなり全機能をONにするのではなく、外部通信や停止リスクのない「保守的な2機能」からスタートするのが公式の推奨。
{
  "version": 1,
  "actionFusion": true,
  "observationPack": true,
  "evidencePreservingReducer": false,
  "onlineContextCompact": false,
  "cacheWriteReadRatio": 12.5
}
「アクションの合体」と「巨大ログの引き換え券化」を有効化するだけでも、目に見えてトークン消費が落ちるのを体感できます。
実運用で注意すべきセキュリティの落とし穴
導入にあたって、公式ドキュメントが警告している注意点も押さえておきましょう。
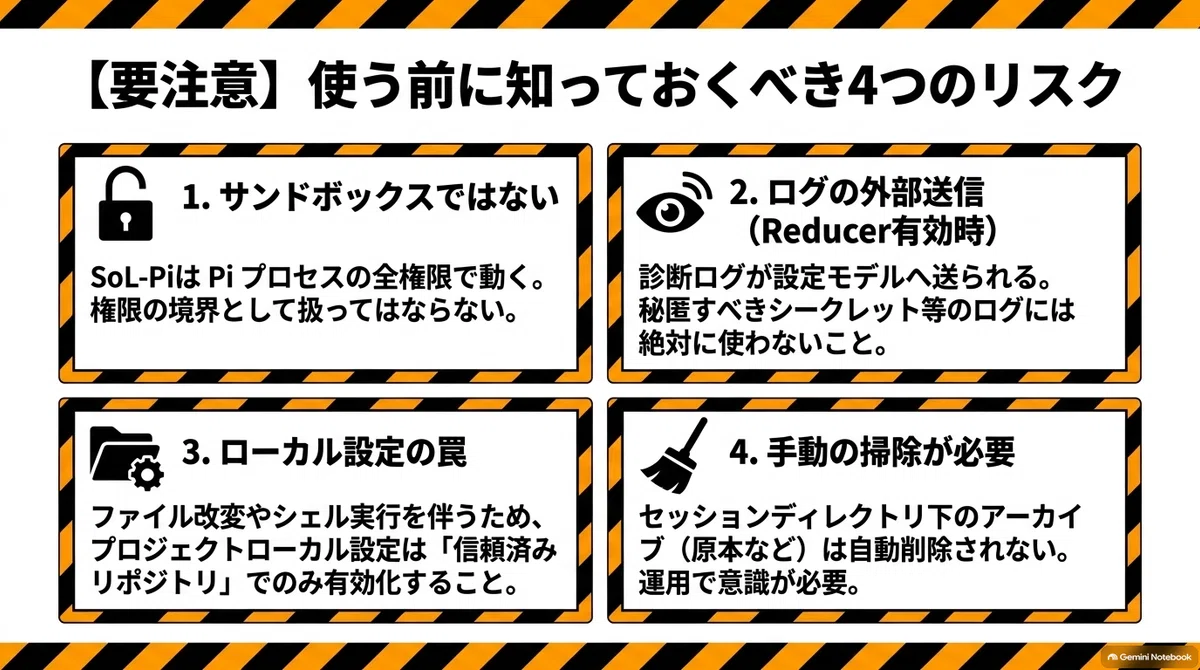
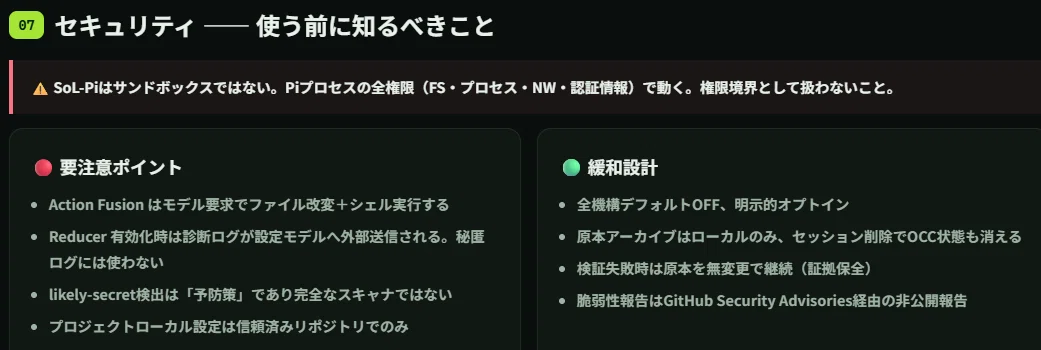
サンドボックスではない: SoL-PiはPiプロセスの権限をそのまま引き継いで動作します。セキュリティの隔離壁としては機能しません。
ログの外部送信リスク: 「Evidence-Preserving Reducer」を有効にすると、診断ログが要約用の小型モデル(外部API)へ送信されます。機密情報やAPIキーがログに平文で出力される環境では注意が必要です。
信頼できるリポジトリでのみ有効化する: プロジェクトごとの設定ファイルは、コード実行を伴うため、出所不明なリポジトリでは有効化しないでください。
ローカルアーカイブの容量管理: 巨大ログの原本はローカルに蓄積されていくため、定期的なクリーンアップ運用を意識しましょう。
NVIDIA研究チームが掴んだ「5つの深い洞察」
論文と公式ブログの中で、研究チームは今後のAIエージェント開発において極めて示唆に富む5つの洞察を残しています。
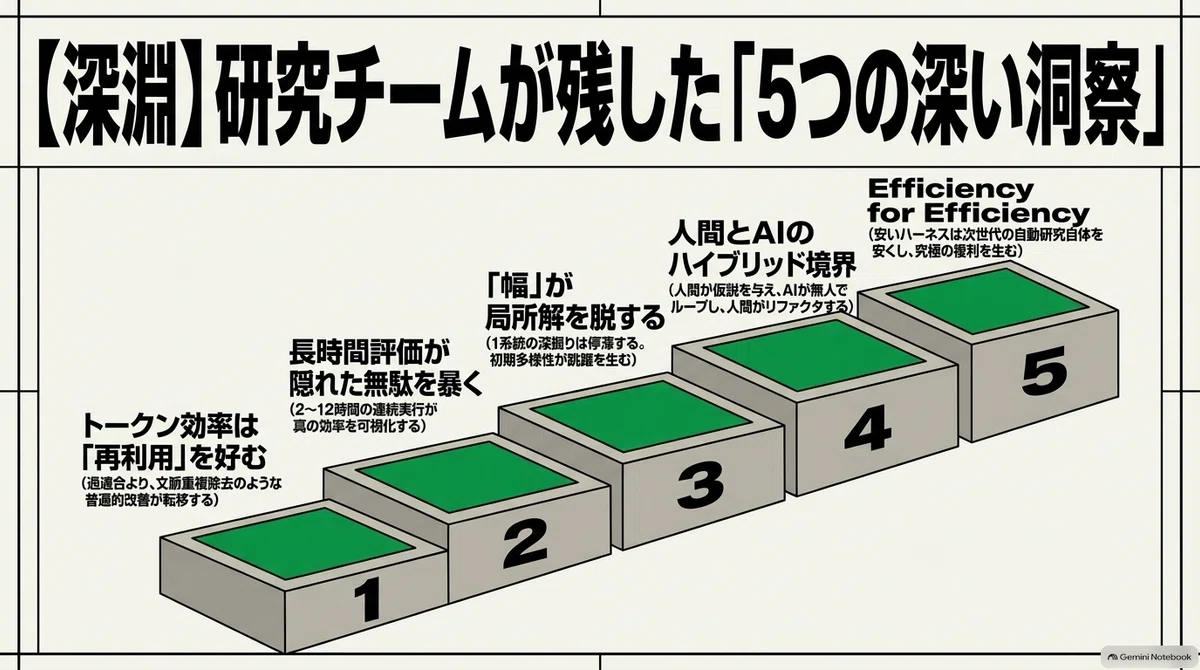
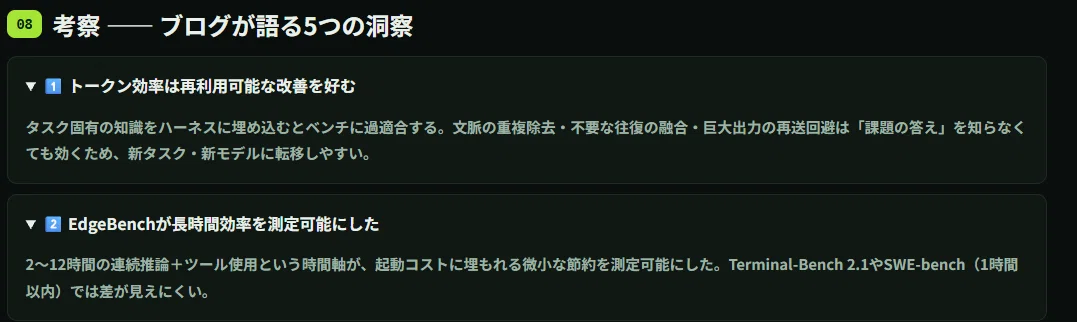
効率化は「再利用可能な改善」を好む: 特定の課題を解く知識をプロンプトに埋め込むと過適合する。ログの重複排除のような「答えを知らなくても効く改善」こそが、未知のタスクでも最大の効果を発揮する。
長時間のベンチマークでないと節約は見えない: 2〜12時間連続で動かして初めて、初期化コストに埋もれていた微細な節約が「複利」となって効いてくる。10分で終わるテストでは効率化の真価は測れない。
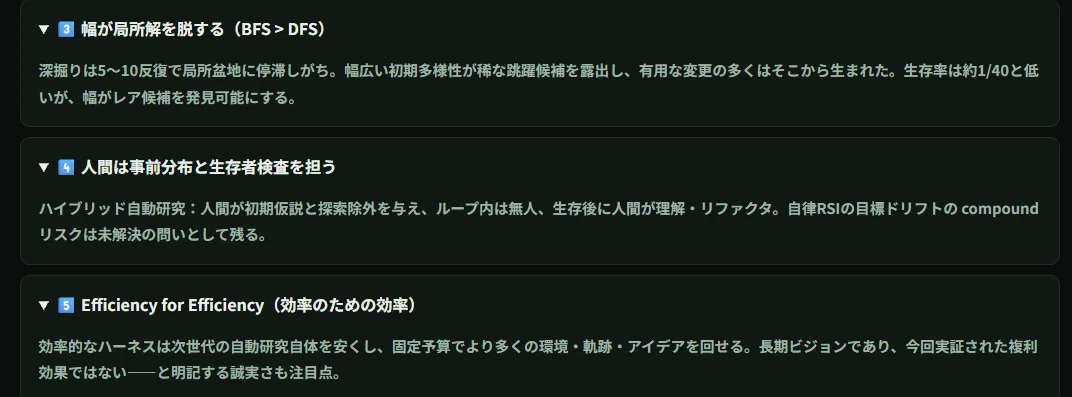
探索の「幅」がブレイクスルーを生む: 1つのアプローチを深掘りしても数回で頭打ちになる。152通りの幅広いアイデアからスタートしたからこそ、突飛で強力な機構が拾い上げられた。
人間は「最初の仮説」と「最後の検閲」を担う: 探索ループ自体は完全自動化されていても、探索の範囲を決め、生き残ったコードをリファクタして安全性を担保するのは人間の仕事である。
Efficiency for Efficiency(効率のための効率): ハーネスが効率化されれば、次の自動研究ループを回す実験コストが安くなる。固定予算の中でより多くの実験を回せるという、自己改善の好循環が生まれる。
まとめ:エージェントは「頭脳」から「足回り」の時代へ
これまで「どのフロンティアモデルが一番頭が良いか?」というモデル単体のスペック競争にばかり目を奪われていました。
もうね、へっとへとですよ懐事情は。
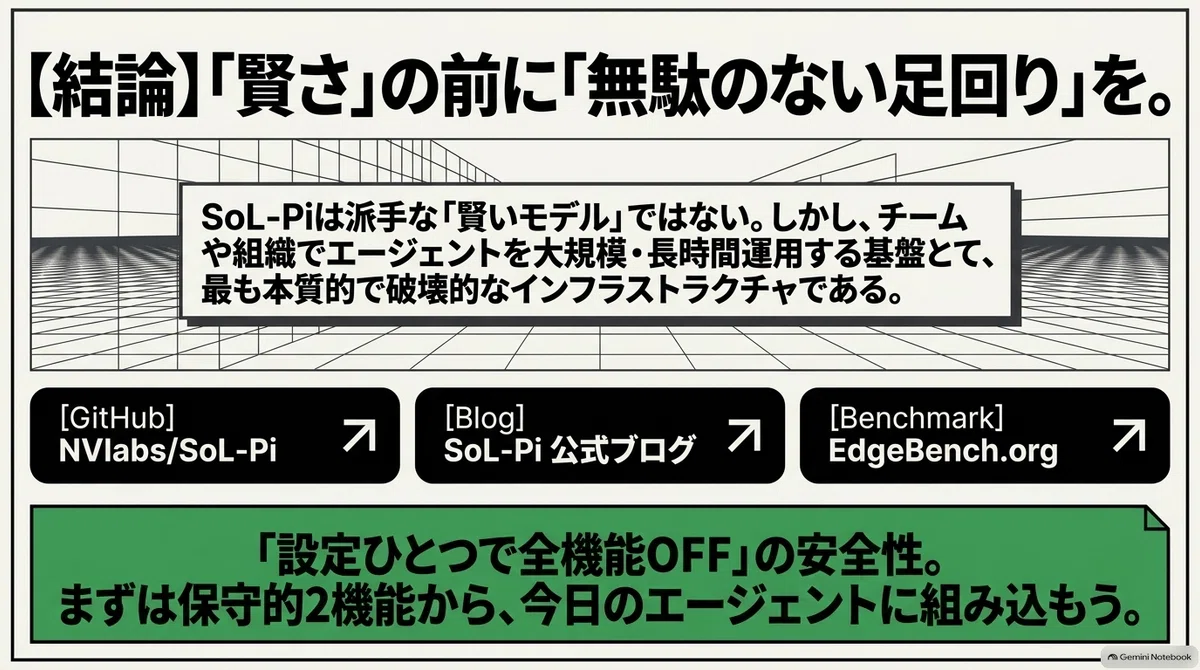
SoL-Piが証明したのは「モデルの頭脳が同じでも、ハーネスを洗練させるだけでコストは3分の1になり、スピードも劇的に向上する」という事実。
まずは安全な2機能(Action Fusion / ObservationPack)をオンにして動かしてみる。
エージェントがどんな無駄な往復をしていたのか、ログの挙動を観察してみる。
AIエージェントを「オモチャ」から「本番運用のインフラ」へと引き上げるためのヒントが、この薄く、洗練されたOSSの中に凝縮されています。
気になった人は、ぜひ自分の手元でその「無駄のなさ」を体感してみてください。これで節約してPi環境つかえるぞーっ
出典・リンク
🔗 NVlabs/SoL-Pi(GitHub) —— README・コード・Issue(公開2026-09-02、調査時点★79・Fork5・MIT)
🔗 SoL-Pi 公式ブログ —— 手法・4機構の研究過程・EdgeBench結果・考察の一次情報
🔗 earendil-works/pi —— 基盤ハーネス(上流、リポジトリ内でvendoringなし)
🔗 EdgeBench —— 51タスクの長時間実行エージェント評価基盤(held-out専用)
📄 本ページ調査日:2026-09-10(API・raw取得による一次情報ベース、価格は公式API等価価格)
いいなと思ったら応援しよう!
 よろしければ応援お願いします♡ いただいたチップはクリエイターとしての活動費に使わせていただきます!
