【ベイズ最適化】いつもの店か、新しい店か【獲得関数】

こんにちは、かなめです。
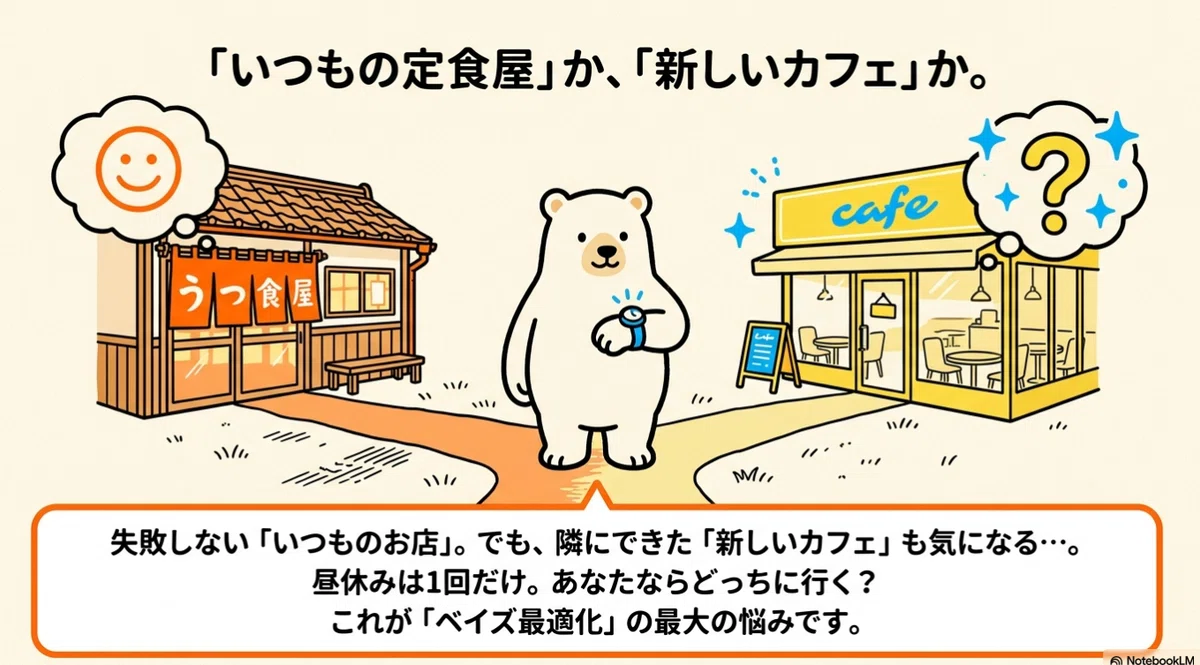
会社の近くに、よく行く定食屋があります。味は知り尽くしていて、外れることはまずありません。その並びに先月、新しいカフェができました。気にはなっているんです。でも昼休みは一回きりで、もしカフェが外れだったら、私は今日の昼を失う。
結果、もう3週間くらい定食屋に通い続けています。
笑い話みたいですが、この「いつもの店か、新しい店か」問題、実は名前のついた立派な数学の問題です。しかも90年ほど前に、笑えない現場で生まれています。今日はその話と、前回のホットケーキの帯がついに「次の一手」を口にするまでを書きます。
こんな人におすすめ
ベイズ最適化の解説で「獲得関数」という言葉に跳ね返された経験のある方
探索と活用、という言葉は聞いたことがあるけれど、ピンときていない方
理屈より先に、まず触って遊びたい方(今日、おもちゃを公開します)
前回のおさらい
第2回では、ガウス過程の話をしました。実験した3点(170℃で68点、180℃で80点、200℃で61点)のあいだを、予測の線と「自信のなさの帯」で埋めてくれるAI。データの近くでは帯が細く、遠くでは正直に太くなるのでした。
手堅い80点と、帯の中に眠る85点
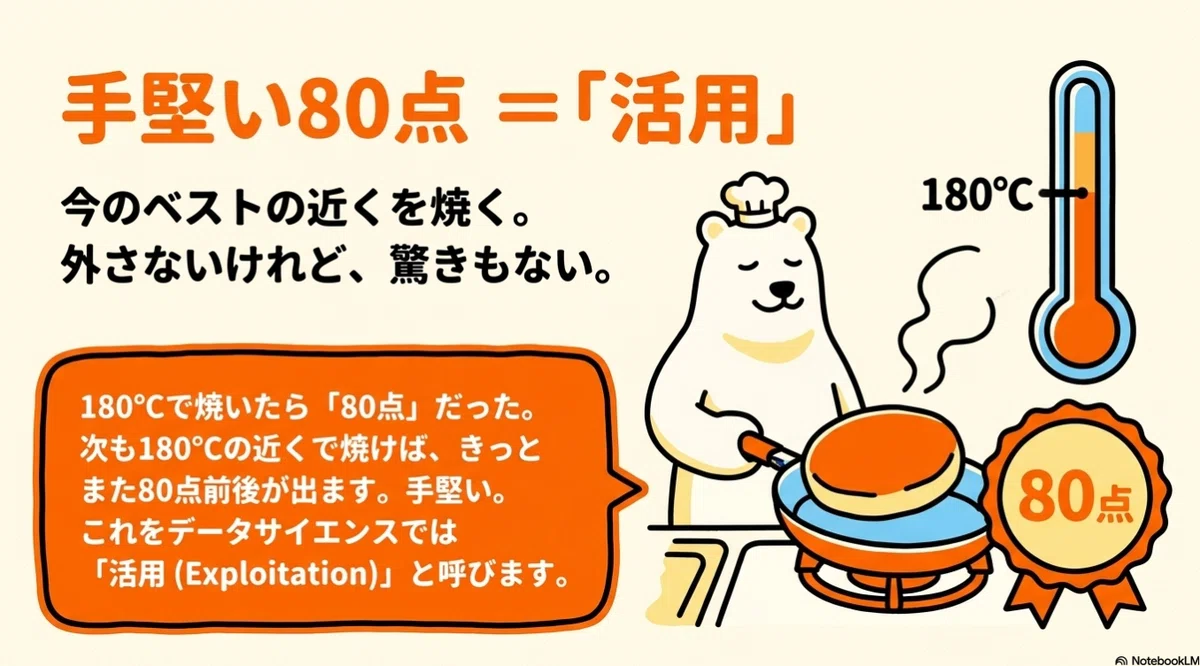
いまの手持ちで最高の1枚は、180℃の80点です。この近くをもう一度焼けば、たぶんまた80点前後が出ます。手堅い。
一方で、まだ焼いていない160℃のあたりは帯が太くて、「55点かもしれないし、85点かもしれない」状態です。ここを焼くのは怖い。でも、もし85点側だったら、自己ベスト更新です。
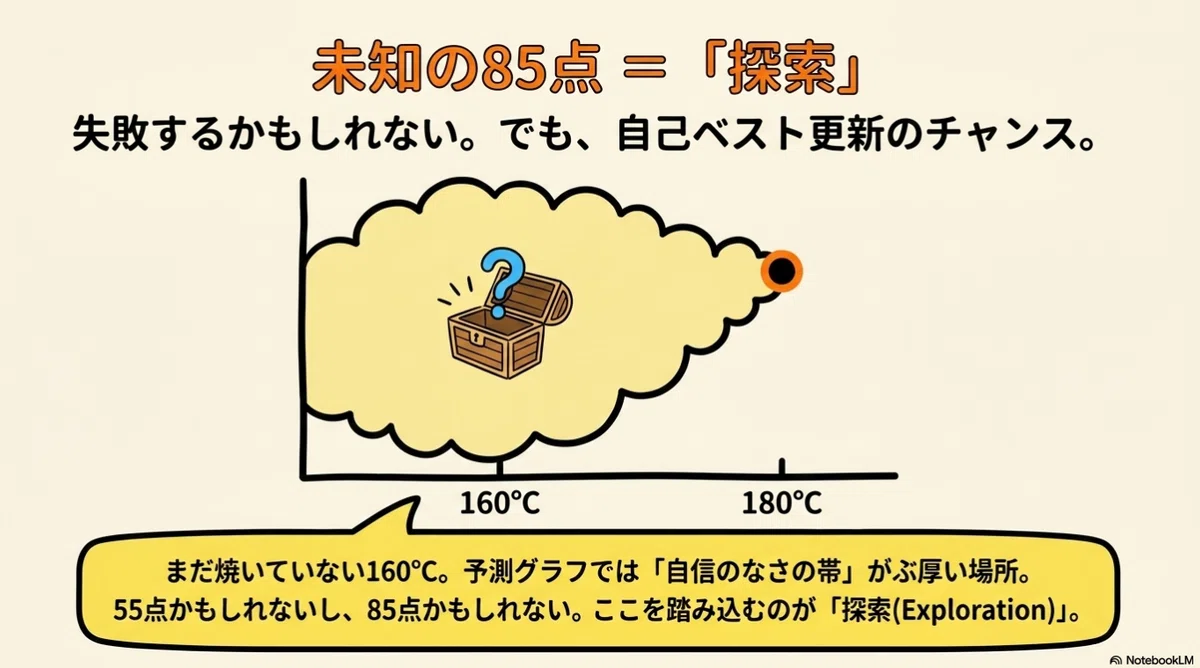
手堅い80点を取りにいくのが「活用」、帯の太い場所に踏み込むのが「探索」。そして困ったことに、この2つは同時にできません。次に焼けるのは1枚だけだからです。昼休みが1回しかないのと同じですね。
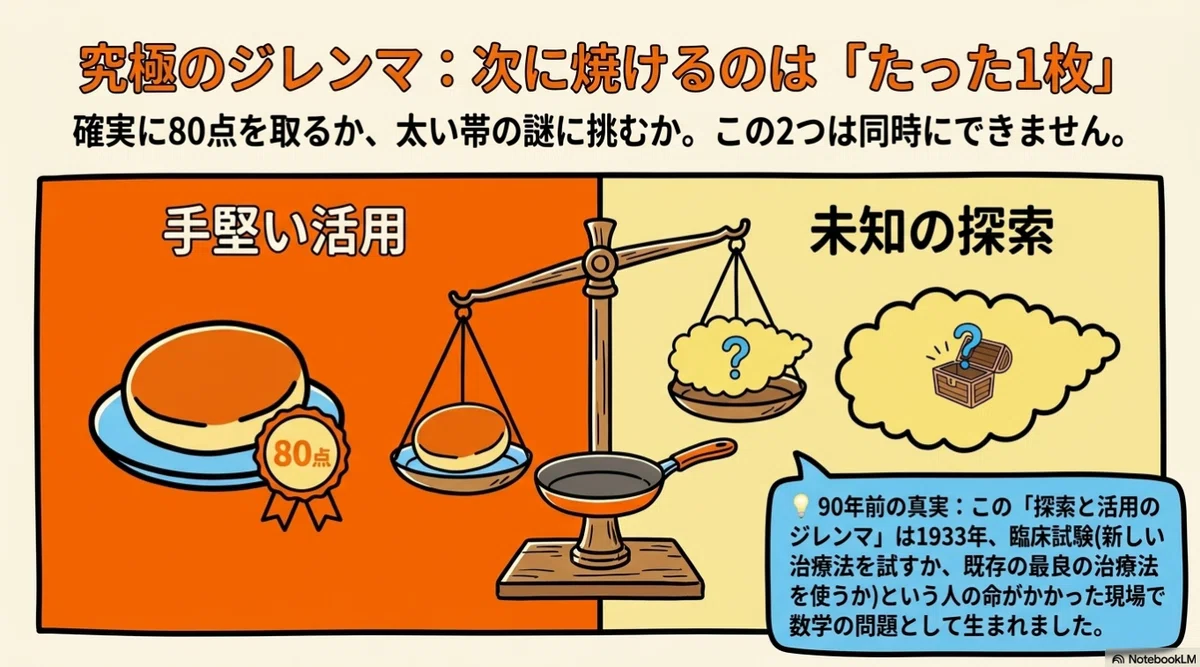
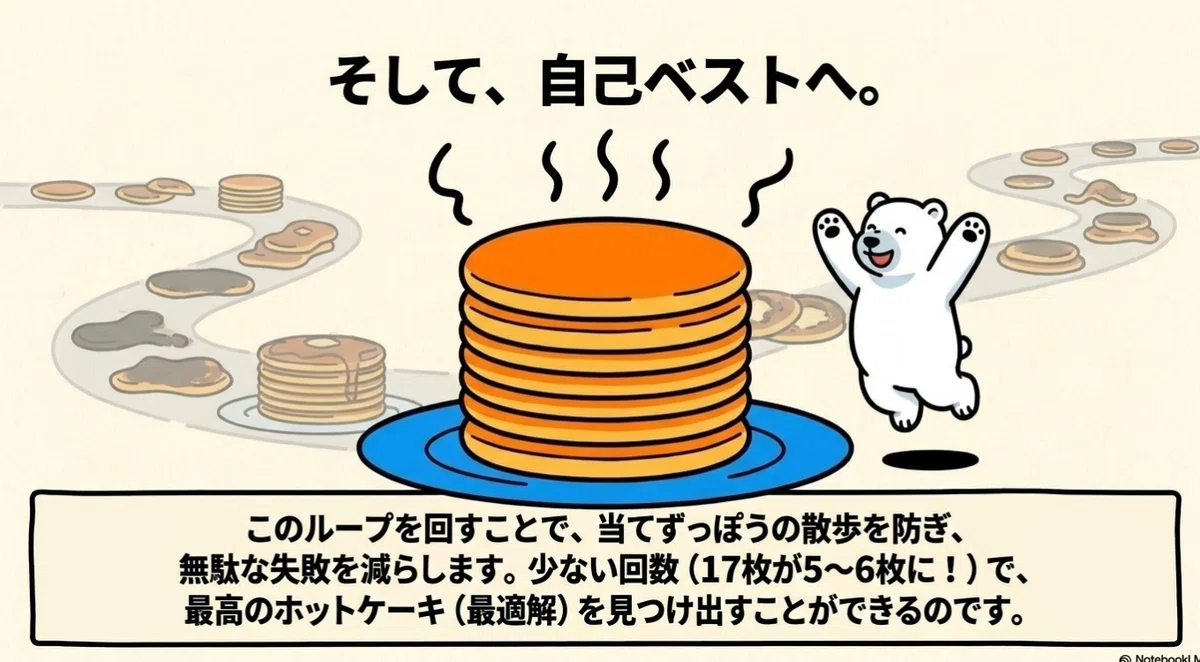
材料開発の言葉に置き換えると、実績のある組成の周りを微調整するのが活用、誰も評価したことのない配合領域に踏み込むのが探索です。どちらかだけでは、うまくいきません。活用だけだと今の山の上をうろうろするだけですし、探索だけだと当てずっぽうの散歩になります。
この綱引き、90年前の病院で生まれました
探索と活用のジレンマが数学の問題として最初に真剣に扱われたのは、1933年、トンプソンという研究者の論文だと言われています。舞台は臨床試験でした。
2つの治療法があって、どちらがよく効くかまだわからない。次の患者さんに、どちらを割り当てるべきか——。目の前の患者さんには、現時点で良さそうに見えるほうを使いたい(活用)。でも、それだけを続けると、もう一方が実は優れていた場合に永遠に気づけず、その後の大勢の患者さんが損をする(探索の必要性)。トンプソンは、この割り当てを確率的に賢く行う方法を提案しました。
ランチ選びと同じ構造の問題が、人の命がかかった現場で90年前に定式化されていた。私はこれを知ったとき、「探索と活用」という言葉の重みが少し変わりました。ちなみにこの数学はいま、Webサービスの A/Bテストや広告配信、動画のレコメンドの裏側で、それこそ毎秒動いています。あなたが今夜おすすめされる動画も、どこかのアルゴリズムの「新しい店」なのかもしれません。
獲得関数は「帯の上端」を見る
では、ベイズ最適化はこの綱引きにどう決着をつけるのか。答えは拍子抜けするほど簡単です。
帯の、上端がいちばん高いところを次に焼く。
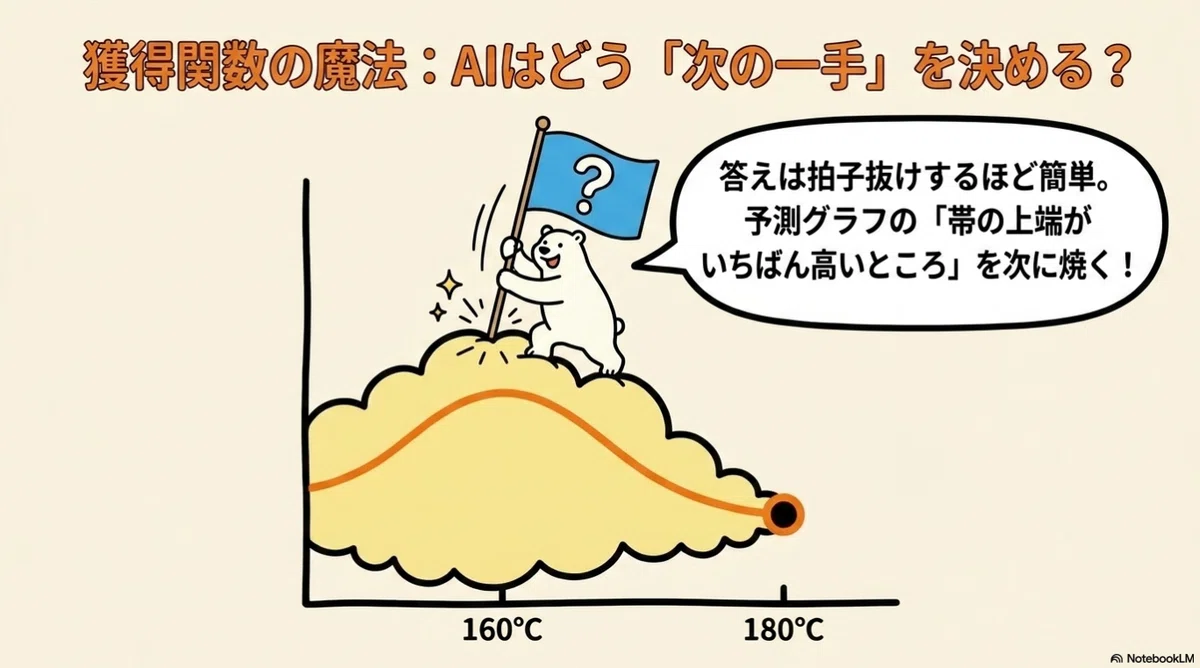
前回の帯を思い出してください。帯の上端が高くなる場所は2種類あります。予測そのものが高い場所(=活用したい場所)と、予測はそこそこでも帯が太い場所(=探索したい場所)。つまり帯の上端という一本の線が、活用の魅力と探索の魅力を勝手に足し合わせてくれているんです。
「よくわからないなら、いいほうに賭けてみようじゃないか」。この楽観主義をルールにしたのがUCBと呼ばれる獲得関数で、考え方はいま書いた2行がすべてです。数式で書いても「予測値+κ×帯の幅」というだけで、このκ(カッパ)という係数が、帯の幅をどれくらい重く見るかを決めます。
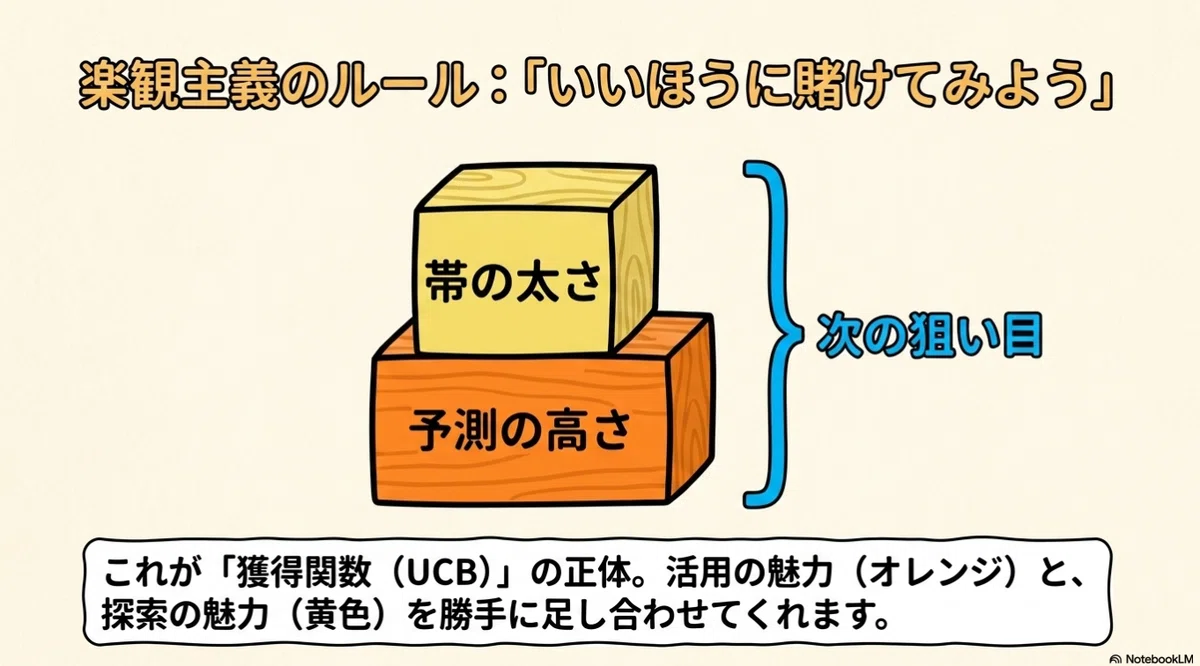
κが小さい:帯なんてほぼ無視。予測の高いところに行く堅実派
κが大きい:帯が太いところに吸い寄せられる冒険派
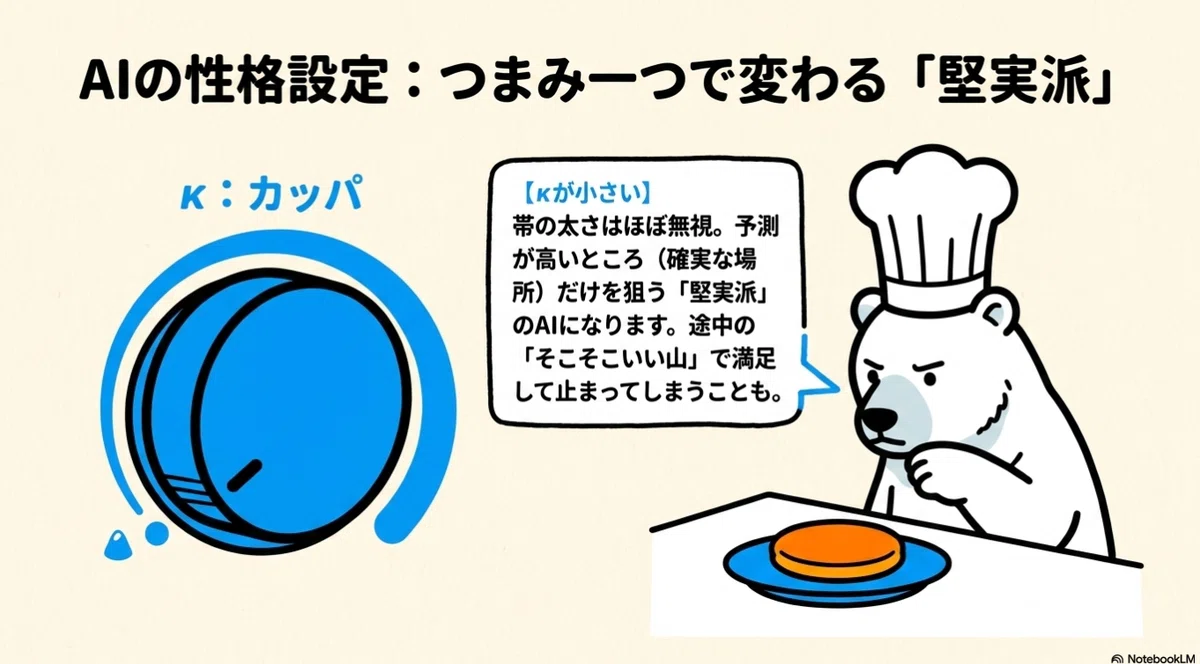
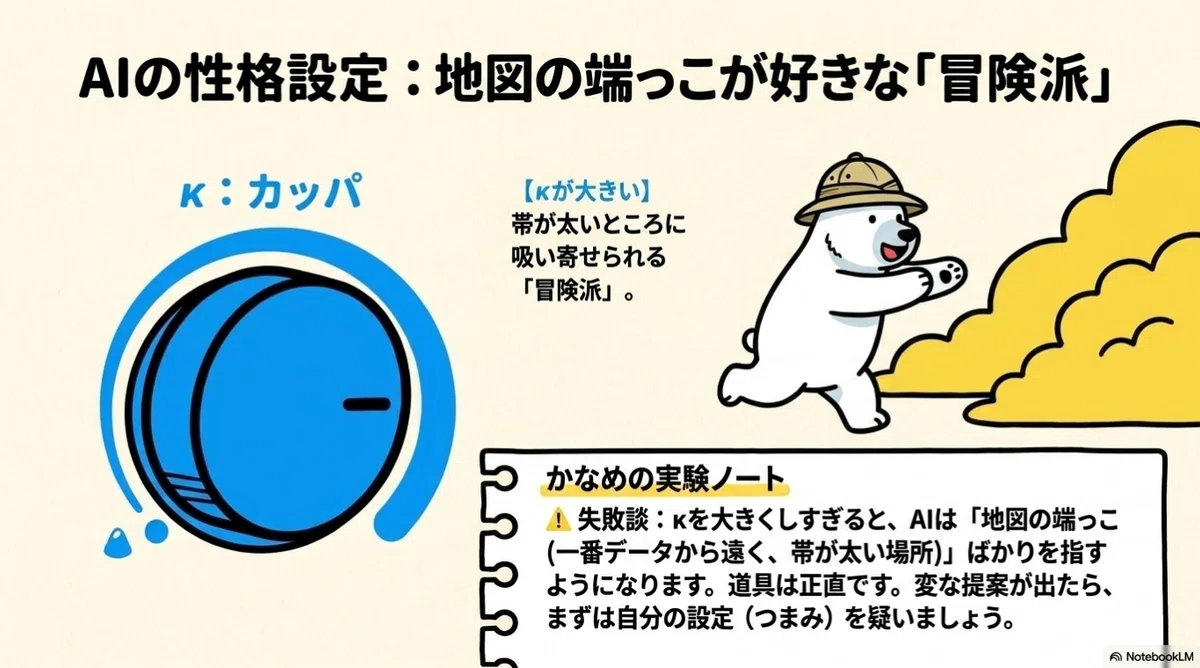
つまり、AIの性格はつまみ一つで変えられるんです。ちなみに獲得関数にはEI(期待改善量)という別の人気者もいて、性格づけの流儀が少し違うのですが、「予測の高さと帯の太さを天秤にかける」という魂は同じです。
これで、ループが閉じました
第1回からの部品が、今日で全部つながります。
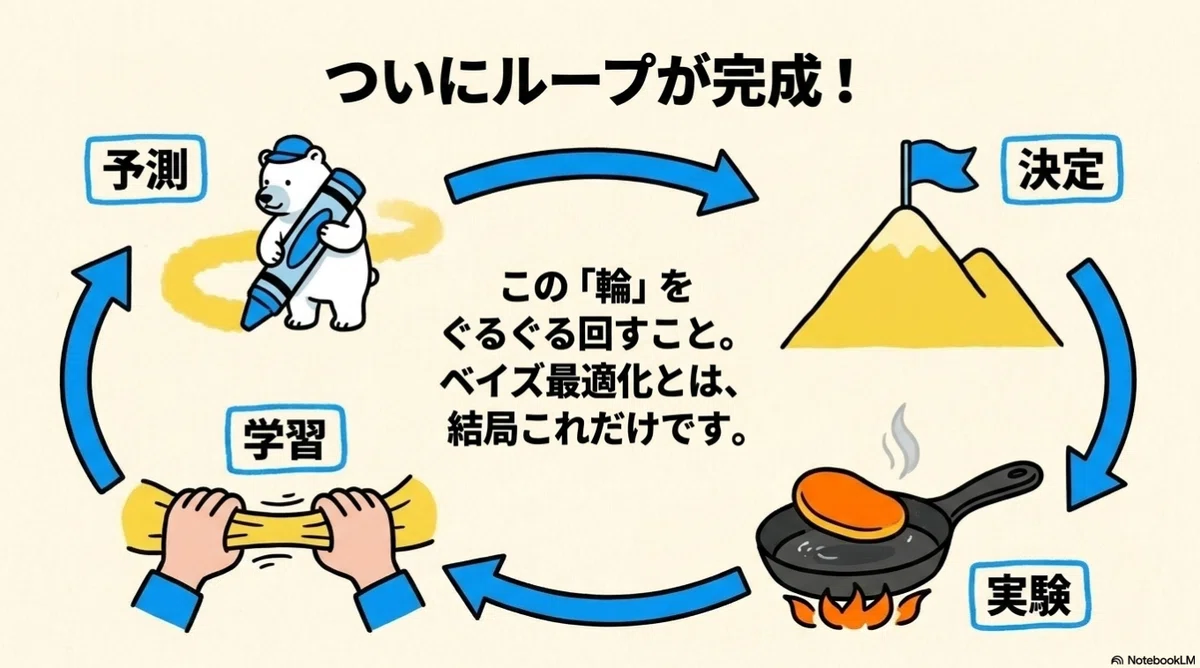
ガウス過程が予測と帯を描く → 獲得関数が次の一手を指す → 実験する → 結果を学んで帯が締まる → また次の一手……
この輪をぐるぐる回すこと。ベイズ最適化とは、結局これだけです。理論編は今日でおしまい。第1回で「17枚が5〜6枚になる」と書いた種明かしは、この輪の回転効率にありました。
今日から、指で回せます
お待たせしました。この輪を自分の指で回せるおもちゃ(アプリ)を作りました。
👇をクリックしてみてください。あやしくないです笑
遊び方は3ステップです。
グラフをタップすると、その温度でホットケーキが1枚焼けます(点数には毎回すこし「ゆらぎ」が入ります。実験ですから)
まず2〜3枚、適当に焼いてみてください。バター色の帯が現れて、焼くたびに形を変えます
あとは「AIの提案どおりに焼く」を押し続けるだけ。何枚で自己ベストにたどり着けるでしょうか
「AIの性格」スライダーで、堅実派と冒険派も切り替えられます。ひとつだけ予告しておくと、堅実派に振り切ると、途中の「そこそこいい山」で満足して止まってしまうことがあります。バグではなく、ベイズ最適化の現場で本当に起きる現象をそのまま仕込んであります。なぜ起きるのか、帯を眺めながら考えてみてください。
かなめの実験ノート(失敗談コーナー)
冒険派にも落とし穴はあります。実務でκを威勢よく大きくしすぎたときの話です。
AIの提案が、探索範囲の端、また端、また反対の端……と、端ばかりを指してくるようになりました。考えてみれば当然で、探索範囲の両端はデータから最も遠く、帯が構造的にいちばん太い場所です。帯の太さしか見ていない冒険家は、地図の端っこが大好きなんですね。
このときの学びは2つです。κのような調整つまみは、振り切る前にまず初期値近辺で様子を見ること。それから、AIの提案が変な偏り方をしたら、モデルではなくまず自分の設定を疑うこと。道具は正直に、設定どおりに動いただけでした。
今日の一冊と、学びの入口
『増補改訂版 ベイズ最適化 ―適応的実験計画の基礎と実践―』(今村秀明・松井孝太 著、近代科学社)
獲得関数を「種類別にきちんと」学びたくなったら、この本です。UCBもEIも、それぞれの得意不得意まで整理されていて、Optunaでの実装例もついています。今日の記事で輪郭をつかんでから読むと、だいぶ景色が違うはずです。
Udemy『【世界で91万人が受講】機械学習26のアルゴリズム(Machine Learning A-Z 日本語版)』
回帰そのものの引き出しを増やしたい方はこちら。ガウス過程以外の予測モデルを一通り眺めておくと、「なぜベイズ最適化はガウス過程を選んだのか」が逆側から見えてきます。
おわりに
書きながら思い出したのですが、例の新しいカフェ、結局まだ行っていません。私のκは、どうも小さめに設定されているようです。
よかったらコメントで教えてください。あなたは探索派ですか、活用派ですか。ランチでも、実験でも、人事異動の希望でも、題材は何でも構いません。
次回は、ついにPythonでこの輪を回します。使うのはNIMS(物質・材料研究機構)発の国産ライブラリPHYSBO。コードは全文コピペで動く形で載せますし、私が実際にはまった穴も3つ、恥を忍んで埋めずに残しておきます。17枚のはずだったホットケーキが何枚で片づくのか、答え合わせの回です。S
かなめ
このシリーズはマガジン【とことんやさしいベイズ最適化】にまとめています。
