AI画像生成の悩み

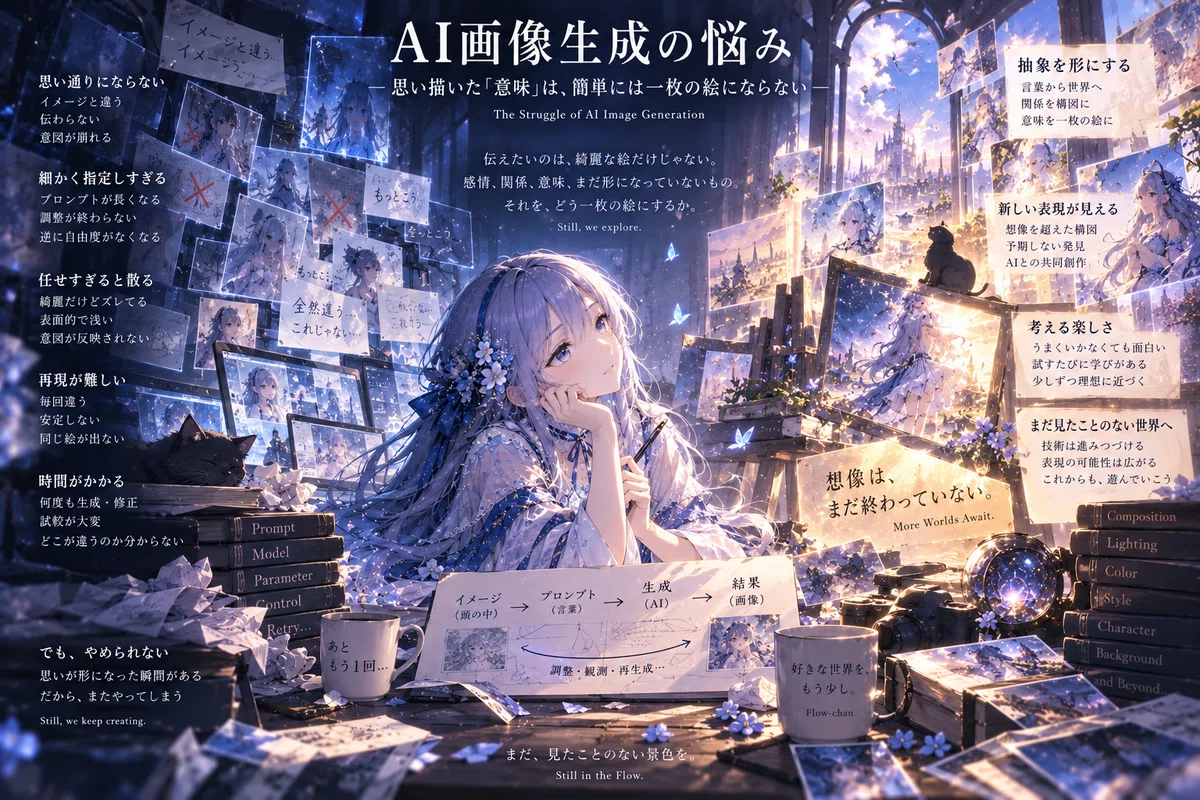
画像生成で難しいのは、単に「綺麗な絵を出すこと」ではない。
多くの人は、人物 → 構図 → 光 → カメラ → 背景 → 色 → 画風 → 小物のように細かく指定して、狙った結果へ近づけていく。
これは精密制御としては強い。
でも、そのぶん人間側が最初からかなり完成像を持っていないといけない。
ここで悩みが出る。「こういう雰囲気」「こういう関係」「こういう状態」「こういう意味」みたいな、まだ形になっていないものを描きたい時だ。
例えば、確定できないことと、決められないことは同じではない。
これは人物の服装でも、背景でも、カメラ位置でもない。
関係そのものである。
だから画像生成の難しさは、「言葉を絵にする」ことではなく、
抽象的な関係 → 空間 → 構図 → 人物 → 光 → 色 → 物 → 一枚の世界へ変換できるかどうかにある。
細かいプロンプトを書けば制御はできる。
ただし、それは「人間が先に絵を設計している」状態でもある。
逆に、抽象だけ渡すと自由度は上がるが、意味がズレやすい。
つまり画像生成には、ずっとこの二つの間がある。制御しすぎると、AIは描画装置になる。任せすぎると、意味が散る。
その中間で、「意味は保持する。構図はAIに考えさせる」という運用ができると、かなり面白くなる。
最近やっていて感じるのは、画像生成で本当に難しいのは「プロンプトを書くこと」ではなく、人間とAIの間で、まだ絵になっていないものを共有することなのかもしれない。
