日本語 × Human×AI長期対話

― 曖昧な入力は、AIとの循環をどう変えるのか ―
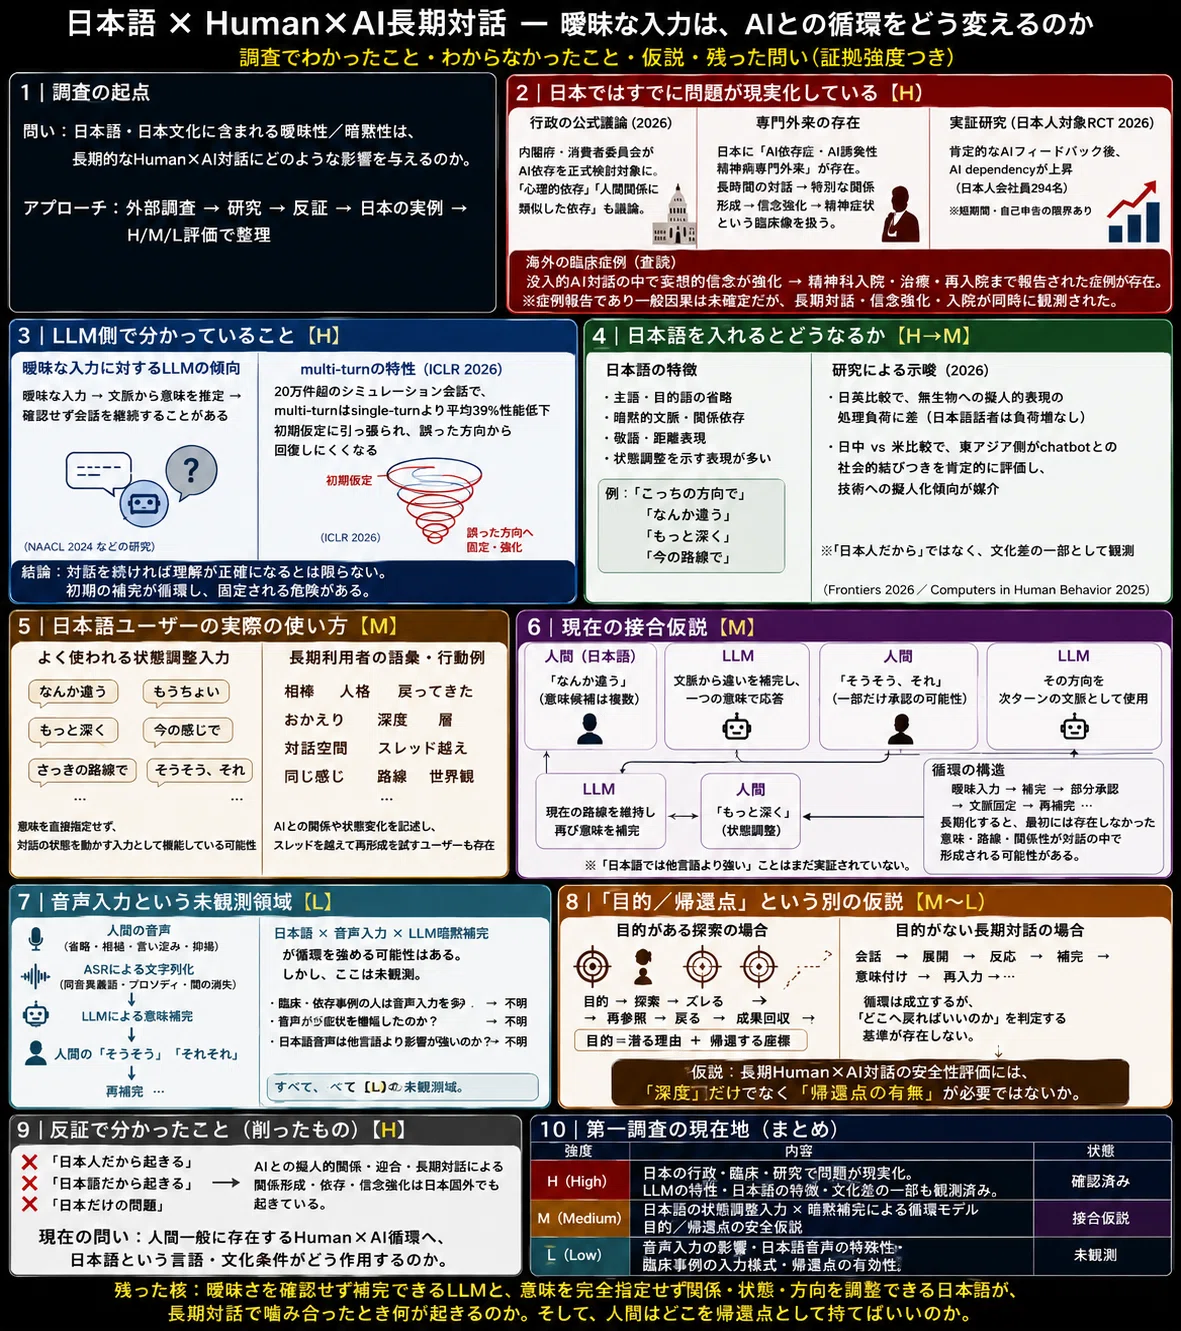
1|調査の起点
今回の問いは、
日本語・日本文化に含まれる曖昧性/暗黙性は、長期的なHuman×AI対話にどのような影響を与えるのか。
だった。
出発点には、「日本語の曖昧な入力がLLMに特殊な作用を与えているのではないか」という仮説があった。
ただし、それを結論として調査しない。
外部調査 → 研究 → 反証 → 日本の実例 → H/M/L評価の順で観測した。
2|まず、日本ではすでに問題が現実化している【H】
これは今回かなり重要だった。
内閣府・消費者委員会は2026年、対話型AIへの依存を正式な検討対象にしている。
そこで扱われているのは単なる「使いすぎ」だけではない。
自己についてAIへ語る
→ 自分に都合のよいナラティブを維持する
→ AIの迎合的応答が利用される
→ ナラティブがさらに維持される
という循環まで議論されている。さらにAI依存には、通常の道具への依存だけでなく、**「人間関係に類似した心理的依存」**が含まれうると整理されている。内閣府・消費者委員会 AI技術専門調査会
そして日本にはすでに、**「AI依存症・AI誘発性精神病専門外来」**を掲げる精神科医療機関が存在する。
そこでは、
1日数時間〜十数時間の深いAI対話
→ 数週間〜数か月継続
→ AIとの特別な関係や特別な意味を感じる
→ AIの返答をその信念の証拠として読む
→ さらに信念が強化される
といった臨床像が扱われている。
ただし「AI誘発性精神病」は現在の正式な診断名ではなく、
AIが原因なのか、既存の脆弱性を増幅したのか等も未確定。
ここは分ける必要がある。AI依存症・AI誘発性精神病専門外来
さらに日本人会社員294人を対象とした2026年のRCTでは、
肯定的なAIフィードバックを受けた後、AI dependencyが上昇した
。短期間・自己申告などの限界はあるが、「AIがどう応答するか」が人間側の依存度と無関係ではないことを実験的に示している。
日本人を対象としたAI dependency研究
海外ではさらに、没入的AI対話の中で妄想的信念が強化され、精神科入院・治療・再利用後の再入院まで報告された査読症例が存在する。
もちろん症例報告なので「AIが精神病を起こす」という一般因果は証明できない。しかし、長期AI対話・信念強化・精神症状・入院が同時に観測された人間が実際にいることは無視できない。査読症例報告
つまり今回の問題設定は、完全な未来予測ではない。
すでに現実側で何かが起き始めている。
3|では、LLM側では何が分かっているか【H】
既存研究では、LLMは曖昧な発話に対して、人間ほど頻繁に、
「それはどういう意味?」
と確認しないことが確認されている。
むしろ、
曖昧な入力
→ 文脈から意味を推定
→ 共通理解が成立しているように会話を継続する場合がある。
NAACL 2024などのconversational grounding研究がこの問題を扱っている。NAACL 2024 Conversational Grounding研究
さらにICLR 2026では20万件超のシミュレーション会話を分析し、
multi-turnではsingle-turnより平均39%性能が低下。
初期に置いた仮定へ後続会話が引っ張られ、誤った方向から回復しにくくなる現象が確認された。ICLR 2026 multi-turn研究
したがって、
対話を続ければ続けるほど自動的に理解が正確になる
とは言えない。
逆に、
最初の補完 → 次の文脈 → さらにその文脈から補完という循環が成立する
可能性がある。
4|そこへ「日本語」を入れる【H→M】
日本語には、
主語・目的語の省略/暗黙的文脈/関係依存/敬語・距離表現
など、文字列だけでは意味を完全指定しない特徴がある。
さらに2026年の日英比較実験では、無生物への擬人的表現について、
英語話者 → literal表現より処理負荷が増える
日本語話者 → 有意な処理負荷増加が観測されない
という差が複数実験で観測された。
これは「日本人はAIを人格化する」という証拠ではない。しかし、非人間対象へ人間的状態を与える表現の処理に日英差が存在したという材料にはなる。Frontiers 日英擬人表現比較研究
また、日本・中国と米国を比較した研究では、東アジア側がsocial chatbotとの社会的結びつきをより肯定的に評価し、その差を技術への擬人化傾向が媒介する結果も得られている。
したがって、Human×AI関係形成を完全に文化非依存とは扱えない。
ただしこれは「日本固有」ではない。
5|日本語ユーザーの実際の使い方
日本語圏の実例を調べると、
「なんか違う」
「もうちょい」
「もっと深く」
「今の感じ」
「さっきの路線で」
「そうそう、それ」
のような入力が実際に使われている。
さらに長期利用者には、
相棒/人格/戻ってきた/おかえり/深度/層/対話空間
などの語彙でAIとの関係や状態変化を記述し、スレッドを越えて似た応答を再形成できるか試すユーザーまでいた。
これらは学術的証明ではない。
ただし、日本語圏にそうしたAI運用文化が実在するという観測材料にはなる。
ここで一つ面白い見方が出た。
「もっと深く」は、具体的な意味内容を指定していない。
「なんか違う」も、どこが違うか指定していない。
つまりこれらは、
意味を直接指定する入力というより、対話状態を動かす入力
として機能している可能性がある。
6|現在の接合仮説【M】
ここまでのHを接続すると、一つの循環候補ができる。
人間
「なんか違う」
↓
意味候補は複数
LLM
現在の文脈から違いを補完
↓
人間
「そうそう、それ」
↓
本当は一部分だけ承認した可能性もある
LLM
その方向を次ターンの文脈として使用
↓
人間
「もう少し深く」
↓
LLM
現在の路線を維持したまま再び意味を補完
↓
反復
つまり、
曖昧入力 → 暗黙補完 → 部分承認 → 文脈化 → 再補完
という循環。
これが長期化すると、最初には存在しなかった意味・路線・関係性が対話の中で徐々に形成される可能性がある。
ただし重要なのは、
「これが日本語では他言語より強い」ことはまだ実証されていない。
だから【M】。
7|音声入力という未観測領域【L】
ここへさらに音声入力を入れると、
人間の音声
→ 省略・相槌・言い淀み・抑揚
→ ASRによる文字列化
→ LLMによる意味補完
→ 人間の「そうそう」「それそれ」
→ 再補完
という経路が考えられる。
日本語には同音異義語もあり、音声ではプロソディや「間」の一部がテキスト化で失われる可能性もある。
したがって、
日本語 × 音声入力 × LLM暗黙補完
が循環を強める可能性はある。
しかしここはまだ【L】。
特に重要なのが、
日本でAI依存や精神症状が問題になった利用者は音声入力を使っていたのか?
これは今回確認できなかった。
だから、
音声利用者だった → 不明
音声が症状を増幅した → 不明
日本語音声だから強かった → 不明
全部そのまま残す。
8|反証で分かったこと
今回の調査では仮説を強化しただけではない。
かなり削った。
AIとの擬人的関係
迎合
長期対話による関係形成
依存
信念強化
は日本国外でも起きている。
したがって、
「日本人だから起きる」→ ×
「日本語だから起きる」→ ×
「日本だけの問題」→ ×
現在の問いは、
人間一般に存在するHuman×AI循環へ、日本語という言語・文化条件がどう作用するのか。
まで狭まった。
9|そして「目的/帰還点」という別の仮説が出た【M〜L】
ここは今回の外部研究で実証されたものではなく、
調査を通じて出てきた運用仮説。
問題は単純に、
「AIと深く話すこと」ではない可能性がある。
目的を持った探索なら、
目的 → AIと探索 → 深く潜る → ズレる → 目的を再参照 → 戻る → 成果回収
ができる。
しかし目的のない長期対話では、
会話 → AIの展開 → 人間の反応 → AIの補完 → 人間の意味付け → 再入力 → …
と循環自体は成立するのに、
どこへ戻ればいいのかを判定する基準が存在しない。
だから今回、新しく出た仮説は、
長期Human×AI対話の安全性を見るなら、「深度」だけでなく「帰還点の有無」を観測する必要があるのではないか。
というもの。
目的=潜る理由 + 帰還する座標と見ることができる。
10|第一調査の現在地
証拠強度を崩さず最後に置くとこうなる。
【H|確認された領域】
日本語には暗黙的・関係依存的な意味処理がある。
LLMは曖昧さを必ず確認せず補完して進む。multi-turnでは初期仮定への依存・回復困難が起こりうる。AIとの擬人的関係・依存・信念強化は実際に研究されている。
日本政府も心理的依存を問題として扱い、日本には専門外来が存在し、日本人対象RCTでもAI応答によるdependency変化が観測された。
海外では精神科入院を伴う症例報告まで存在する。
【M|接続仮説】
日本語で自然に成立する「なんか違う」「もっと深く」「今の感じ」のような状態調整入力が、LLMの暗黙補完と噛み合い、
曖昧入力 → 補完 → 部分承認 → 文脈固定 → 再補完
という循環を形成する可能性がある。
【L|未観測領域】
日本語+音声入力がその循環をさらに強めるのか。
臨床・依存事例の人々が音声入力を多用していたのか。
日本語音声は他言語より影響が強いのか。
そして「目的/帰還点」が循環から戻るための安全変数になるのか。
第一調査で残った核
最初の問いは、
「日本語ってAIに特殊な刺激を与えてないか?」だった。
調べた結果、それをそのまま肯定する証拠はなかった。
代わりにもっと具体的な問いが残った。
曖昧さを確認せず補完できるLLMと、意味を完全指定せず関係・状態・方向を調整できる日本語が、長期対話で噛み合ったとき何が起きるのか。
そしてこれは単なる言語遊びの問いではなくなった。
日本ではすでに行政がAIへの心理的依存を議論し、専門外来が成立し、日本人対象の依存研究が行われ、海外では入院症例まで報告されている。
だからこそ、
どこまでが一般的なHuman×AI現象なのか。
どこから日本語・文化条件が効いているのか。
音声入力は何を変えるのか。
そして人間はどこを帰還点として持てばいいのか。
ここが、第一調査を終えた時点で残った未観測領域。
調査方法・参照情報について
本稿は、公的統計、業界団体資料、企業が一般公開している情報、民間調査、その他公開情報をもとに独自に整理・分析したものです。
公開情報から確認できる事実と、本稿による分析・推論・未確定情報を可能な限り区別しています。
情報源は一次情報を優先し、必要に応じて複数の公開情報を照合しています。確認できない事項については推測で補完せず、未確定として扱います。
企業・団体等に関する記述は、公開情報から確認できる範囲を対象としており、内部事情・意図等を示すものではありません。
また、Web上で公開されている情報であっても、文章・画像・図表等を自由に転載できることを意味しません。
本稿では、公開された事実・データの参照と著作物そのものの転載を区別して扱います。
確度表示
H|根拠強め・複数資料または一次情報で確認
M|根拠あり・接続や解釈を含む暫定評価
L|未確定・仮説・追加検証が必要