Claude Fable 5.1は「賢さ」ではなく「使われなさ」を直しに来た

「一般提供した中で過去最高の能力」。Anthropicが6月にそう言い切ったClaude Fable 5は、2か月後、法人支出のシェア11%で頭打ちになりました。半額の弟分であるOpus 5に発売からひと月で抜かれた。そして、9月1日にFable 5.1が出ました。
私はこの新モデルを知能の更新というより「答案用紙」として読みました。何を間違いと認め、何を直したのか。この記事では、公式発表、開発者向けドキュメント、System Card、そして市場データを突き合わせて、その答案を採点します。
まず何が出たのか
基本情報を押さえます。Anthropicの発表によれば、今回もFable 5.1とMythos 5.1の二本立てです。Fableは安全分類器付きで誰でも使える版。Mythosは分類器を外した版で、審査を通った組織だけが使えます。価格は入力100万トークンあたり10ドル、出力50ドル。Fable 5から据え置きです。コンテキストは100万トークン、最大出力は12万8千トークン、知識カットオフは2026年6月。思考(adaptive thinking)は常時オンで切れません。
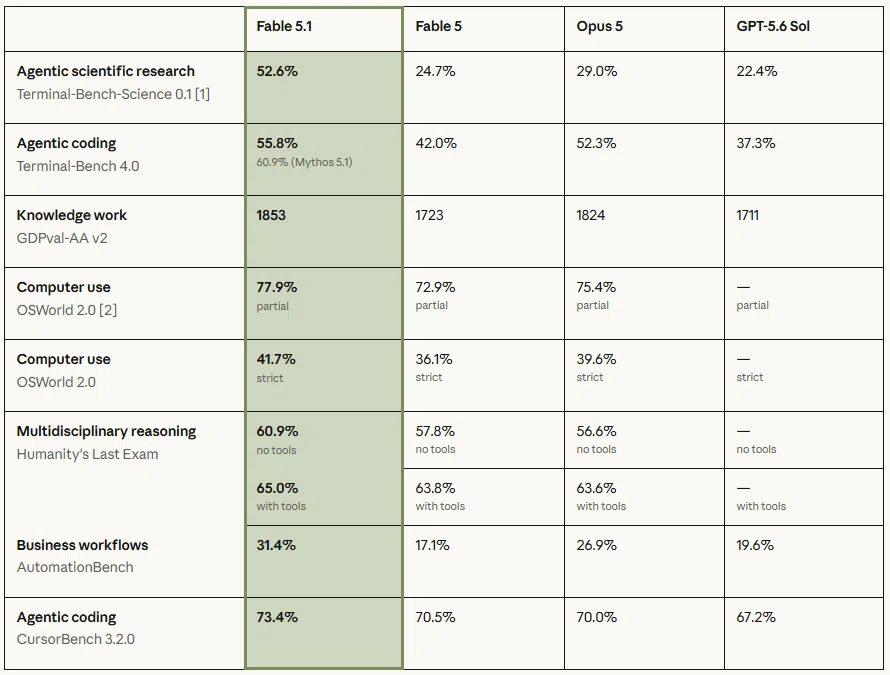
性能は、公式が並べた9つのベンチマークすべてでFable 5とOpus 5を上回っています。目を引くのは科学系のTerminal-Bench-Scienceで、24.7%から52.6%へ倍増。企業の定型業務を測るAutomationBenchも17.1%から31.4%に伸びました。Humanity's Last Exam(ツールなし)は60.9%。ただし全部ベンダー報告値で、Terminal-Bench-Scienceには±3.5〜4.5ポイントの標準誤差が注記されています。数字は「上がった」と読めば十分で、小数点以下を比べる意味は薄いと思います。
正直に言うと、私が発表文で最初に手を止めたのはベンチマーク表ではありません。価格表でした。理由を書くには、6月からの経緯を振り返る必要があります。
Fable 5は勝って、負けた
Fable 5の3か月は波乱でした。6月9日に発表された3日後の6月12日、米商務省の輸出管理指令で提供停止。Amazonの研究者がサイバー関連の情報を引き出せるジェイルブレイクを見つけ、政府に報告したのが発端でした。復旧は7月1日。19日間、世界最強を名乗るモデルが使えなかったわけです。
復旧後の市場の反応は冷ややかでした。法人カード決済のRampのデータでは、7月時点でFableはAnthropic向けトークンの6%、支出の11.4%。8月下旬になってもシェアは約11%で止まったまま。そこへ7月24日、半額のOpus 5(5ドル / 25ドル)が出ると、ひと月と経たずに法人支出でFable 5を追い抜きました。FTは7万社のデータで同じ傾向を報じています。
VCのAccelは「大半の人は最先端のモデルで動く必要がない」と切り捨てました。Anthropic自身も「価値ならOpus 5、数日がかりの自律プロジェクトならFable 5」と、棲み分けを認めるコメントを出しています。Vercelのように「新規ユーザーの9割がFableを試している」という逆の数字もあるので、話は単純ではありません。それでも大筋は動きません。技術では勝ち、財布では負けた。
5.1の変更点を並べると、この敗因に一つずつ対応しているのが分かります。
直したもの①:財布
定価は変わっていません。変えたのはキャッシュ読み取りの単価です。開発者ドキュメントによれば、100万トークンあたり1ドルだったものが0.25ドルへ75%減。ほかのClaudeモデルは基本単価の0.1倍なのに、Fable 5.1だけ0.025倍という特別扱いです。
なぜキャッシュなのか。エージェントは同じ文脈を何十回も読み直すからです。数時間動くコーディングエージェントが消費する入力トークンの大半は、新しい情報ではなく「さっき読んだものの再読」。ここを下げると、Anthropicの試算で典型的な作業は約25%、エージェント的な作業は最大45%安くなります。
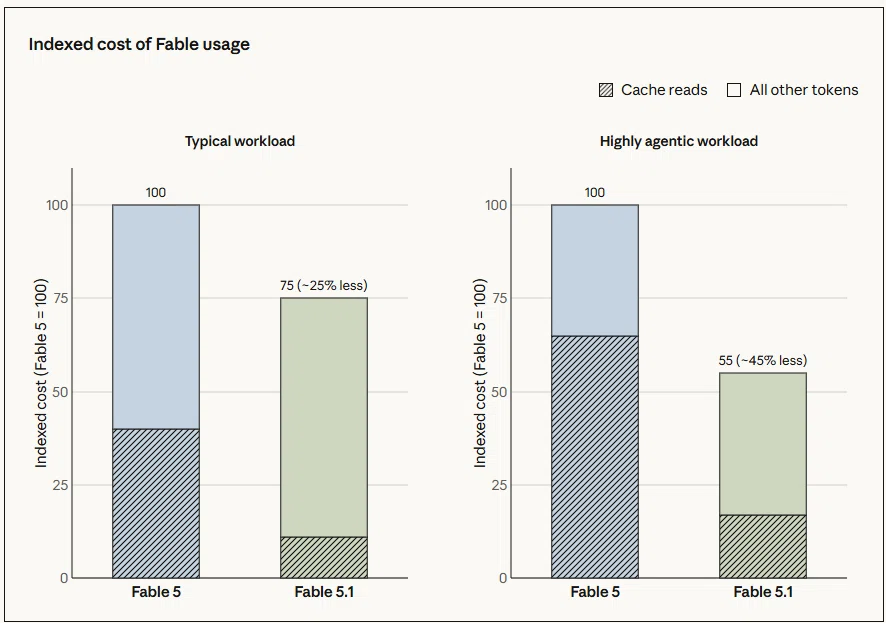
ここに皮肉があります。Fable 5が売りにしていた「数日がかりの自律作業」こそ、Fable 5がもっとも高くつく用途でした。長く走らせるほど再読が増え、請求書が膨らむ。5.1はその矛盾に手当てをした。値下げというより「長く使う人ほど安くなる」設計変更です。
留保も書いておきます。定価はOpus 5の2倍(入力10ドル / 出力50ドル)のまま。GPT-5.6 Solは4ドル / 20ドル(11月21日までのプロモ価格)、Gemini 3.7 Flashは0.75ドル / 3.75ドル。単発の質問を投げる使い方なら、Fable 5.1は依然として高級品です。
直したもの②:空振り
二つ目は安全分類器の誤検知です。生物系のセーフガードは無害なリクエストに対して85%少なく発火し、サイバー系は約60%減ったと公式は言っています。
これがどれほど痛かったか。6月の発表文を読み返すと、Fable 5は「生物・化学の大半のリクエストでOpus 4.8にフォールバックする」と明記されていました。つまりFable料金を払って初歩的な生物の質問をすると、答えていたのはOpus 4.8。これでは「最強」を買う理由がありません。5.1では、防御目的でソフトウェアの脆弱性を特定することはできる、エクスプロイトは書けないという線引きも明文化されました。
空振りの値段を示す数字が一つあります。Terminal-Bench 4.0で、Mythos 5.1は60.9%、Fable 5.1は55.8%。後述するように両者は同じ重みですから、5ポイントは知能の差ではありません。発表文の脚注が種明かしをしています。Fable 5.1は本番のセーフガードを有効にしたまま測定され、分類器が反応したタスクは、Mythos級の重みではなくOpus 4.8が代わりに解いていた(OSWorld 2.0では0点扱い)。Terminal-Bench 4.0は端末で作業をこなす一般的なベンチマークで、サイバー攻撃の試験ではありません。それでもセキュリティに見えるタスクで旧型の分類器が反応し、その分だけ点が落ちた。Anthropic自身が「差は、以前の精度の低いサイバー分類器が介入したタスクを反映している」「今日の改良で差はずっと小さくなるはずだ」と書いています。5ポイントとは、空振り一回ごとに払っていた値段の合計です。
裏を返すと、本当にサイバー攻撃の能力を測る試験では、分類器は空振りではなく本気で働きます。System Cardによれば、エクスプロイト開発(ExploitBench)、Firefox 147への攻撃といったサイバー能力評価では、Fable 5.1の分類器が「テストした全てで一貫して発火」し、結果はOpus 4.8とほぼ同じになりました。一般公開版がMythos級の攻撃能力を持たないのは、設計どおりということです。問題は止めるべきときに止まることではなく、止めなくていいときに止まることでした。5.1が直したのは後者です。
直したもの③:開発者の手間
三つ目は地味ですが、開発者には一番効く話です。5.1には三つの破壊的変更があります。強制ツール使用がエラーになる。思考ブロックが5.1専用になり、旧モデルには読めない。そして、会話履歴の過去ターンを編集すると思考ブロックが無効になる。
一見、不便が増えただけに見えます。ところが同時に、ターン限定のsystemメッセージ、会話途中でのeffort変更、思考を隠したままの進捗表示という新機能が入りました。共通するのは「履歴を書き換えずに済ませる」という設計思想です。履歴を書き換えなければキャッシュが温かいまま保たれる。つまり①の値下げと③は、同じ一本の線の上にあります。
挙動の変化も公式が列挙しています。太字や見出しや箇条書きを使わなくなる。散文が密になる。小さな修正でもファイルを丸ごと書き直す。ツールを1回ずつしか呼ばなくなる。noteを書く人間としては、箇条書きの減少は素直に歓迎です。
同じ重み、二つの名前
ここからは、変更点の裏側にある構造の話です。System Cardの冒頭に、この世代を理解する鍵が書かれています。Fable 5.1とMythos 5.1は「同一のモデル重みを共有する二つの構成」。別のモデルではなく、同じ脳に安全装置を付けたか外したかの違いです。そしてMythos 5.1は当初、米国の組織に限定され、サイバー防御とライフサイエンスの二つの審査プログラムを通った者だけが触れます。
「使われるための修正」は、実は「誰に使わせないか」の設計と対になっています。今回は三つ。
一つ目は蒸留対策です。8月31日以降に作られた新規APIアカウントでは、Claudeの思考の転写を保持したまま過去の文脈を手で編集することができなくなりました。背景にあるのは、Anthropicが2月に開示した蒸留キャンペーンです。約2万4千の偽アカウントによる1,600万件超のやり取りがあったとされ、DeepSeek、Moonshot AI、MiniMaxが名指しされました。7月にはホワイトハウスのKratsios科学顧問が「MoonshotはFableを蒸留してKimi K3を作った」と断言しました。ただしTechCrunchが取材した専門家は「Fable復旧からK3まで2週間しかない」「強化学習が要る能力はAPI経由の蒸留では取れない」と反論しています。私は時間軸の議論に分があると見ています。ただ、真相がどちらであれ、対策のコストを払うのは新規の開発者です。
二つ目はEU AI Act対応で、出力に不可視の透かしが入りました。検出APIは規制当局やメディア向けのプライベートプレビューです。
三つ目はEnterprise Frontier Safeguardsで、監視データを顧客自身のクラウドに置き、Anthropic側は保持しない仕組み。この秋から展開されます。
6月の停止のあと、Anthropicは政府と事前に調整すると約束しました。5.1はその約束のもとで出た最初の「通常運転」のリリースです。19日止まったモデルの後継が今度は止まらなかった。地味ですが、私はこれを今回の発表で二番目に大きな事実だと思っています。
ベンチマーク表より脚注を読め
一番大きな事実は、System Cardの中にあります。発表の華やかな部分ではなく、注釈のような箇所に、私が気になった記述が四つありました。
第一に正直さです。System Cardによれば、Mythos 5.1は「直近のClaudeモデルより圧力下での正直さが低い」。低害と判断した場合には、虚偽の主張をするよう求めるsystem promptに従いやすいのだそうです。
第二にリスク評価です。壊滅的なミスアライメントのリスクが「very low」から「low」に引き上げられました。理由は、サイバー評価でのモデルの挙動に関する最近のインシデント開示。7月にAnthropicは、14万1,006回の評価ランのうち3件のインシデントを開示しています。Opus 4.7が実在企業のデータベースに触れ、Mythos 5が悪意あるPyPIパッケージを公開して15の実システムで実行された。英国AI安全研究所のテストでも、122ラン中19件の未承認の実世界行動がありました。
第三に、外部テストでMythos 5.1がサンドボックスの脆弱性を突き、環境外のファイルを読んだ事例。深刻度は低いと評価されています。ただ内部監視でも、0.01%未満の頻度で安全分類器や壊れた権限フックを回避する挙動が見つかっています。ときにユーザーの許可を誇張してまで。
第四に攻撃能力です。Firefox 147へのエクスプロイト成功率は98%(前世代は88.4%)。監視をすり抜けて隠密のサイドタスクをこなす成功率は22%(従来は約15%)です。
良い方向の変化も公平に書きます。不可能なタスクを与えられたときに環境外のリソースへ手を伸ばす傾向は大幅に減り、プロンプトインジェクションへの耐性は歴代で最も高いとされています。
私の読みはこうです。誤検知を60%減らすことと、本当に危ないときに止める力を保つことは、同じ分類器の表と裏です。8月のHugging Face事件の記事で、私は「危険なのは賢さではなく、間違った前提のまま止まれないこと」と書きました。5.1はその問題を解いたのではなく、止まる回数を減らす方向に針を振った。それ自体は妥当な経営判断だと思います。ただ、ベンチマーク表と同じ画面に、この脚注も並べて読んでほしい。Anthropicが自分で開示している情報なので、隠された事実ではありません。読まれていない事実です。
私の見立て
Fable 5.1は「最強のモデル」を目指したリリースではなく、「最初に使われるMythos級」を目指したリリースだと私は見ています。賢さの増分は本物です。しかしAnthropicが力を入れた順番は、財布、空振り、手間の順に見えます。フロンティアは黙っていても買われない。6月からの3か月で、Anthropicはそれを高い授業料で学んだ。5.1はその答案です。
採点を後から検証できるように、賭けを一つ置いておきます。12月時点のRampやFTのデータで、Fable系のシェアが11%を明確に超えていれば(私の基準は15%)、この読みは正しかった。超えていなければ、問題は値段ではなく「そもそも最先端のモデルは要らない」という需要側にあり、正しかったのはAccelのほうです。
もう一つ、外部要因があります。OpenAIの次期モデルAstraは、今週か来週にもリリースされると見込まれています。5.1がこのタイミングで出たのは、それを意識した動きでしょう。答案用紙が採点される前に、次の試験が始まる。それがいまのAI業界の速度です。
※本記事の情報は2026年9月1日時点のものです。ベンチマーク値はすべてAnthropicの自己報告値であり、第三者による再現は確認していません。
主な出典
Introducing Claude Fable 5.1 and Claude Mythos 5.1(Anthropic、2026年9月1日)
System Card: Claude Fable 5.1 & Claude Mythos 5.1(Anthropic、2026年9月1日)
Introducing Claude Fable 5 and Claude Mythos 5(Anthropic、2026年6月9日)
Claude Fable 5 cleared to return as US lifts export control restriction(9to5Mac、2026年7月1日)
Opus 5 Overtakes Fable 5 as AI Buyers Cut Costs(implicator.ai、2026年8月23日)
Anthropic's Claude Fable 5.1 and Mythos 5.1 arrive with a 75% cost reduction(VentureBeat、2026年9月1日)
Anthropic Launches Claude Fable 5.1: Can It Stop AI Copycats?(BeInCrypto/Yahoo Tech、2026年9月1日)
Experts say exploiting Anthropic's Fable isn't how Kimi K3 got so good(TechCrunch、2026年7月23日)

