ブログ記事作成用スキルを作ってnote記事を書いてみよう

今回は、Claudeでのブログ記事作成用スキルの作り方とそのスキルを使ったnote記事の作成方法を紹介します。また、今回作成したスキルも公開します。
1.スキルの作成
今回は、ユーザーが指定したテーマについてネットで情報収集してブログ記事を書くスキルを作成します。
(1) ブログ記事を書くための手順を検討
「ブログ記事を書くスキルを作成して」とシンプルに最初から指示しても、スキルを作成できますが、より性能が高いスキルを作成するために、段階的に設計します。最初に手順を考えてもらいます。
ユーザーが指定したテーマに関する情報をネットから収集して、それらの情報を基に高品質なブログ記事を書くための手順を考えて
【Claude Opus 4.6の回答】
ネット情報を基に高品質なブログ記事を書くための手順
以下のようなワークフローが効果的です。
1. テーマの明確化と読者ターゲットの設定
まず、テーマを具体的なキーワードや問いに落とし込みます。
「誰に向けて」「何を伝えたいのか」を明確にすることで、後の情報収集にブレがなくなります。例えば「AI」という漠然としたテーマなら、「中小企業がAIを業務効率化に活用する方法」のように絞り込みます。
2. 多角的な情報収集
Web検索を使い、以下のような観点で幅広くソースを集めます。
一次情報の優先: 公式サイト、論文、政府統計、企業のプレスリリースなど、信頼性の高い情報源を最優先で探します。
複数の視点: 賛成・反対・中立など異なる立場の記事を読み、偏りを防ぎます。
最新性の確認: 情報の公開日を確認し、古い情報に基づいた主張をしないよう注意します。
具体的なデータや事例: 数字、ケーススタディ、専門家の見解など、記事に説得力を持たせる素材を意識的に収集します。
3. 情報の整理と構造化
集めた情報をそのまま並べるのではなく、自分の言葉で咀嚼し直します。ポイントを抽出し、「読者が最も知りたいことは何か」を軸に、記事全体のアウトライン(導入→本論→結論)を組み立てます。ここで記事の独自の切り口や主張(アングル)を決めるのが重要です。
4. 執筆
アウトラインに沿って書き進めます。意識すべき点としては、導入部で読者の関心を引くフック(問いかけ、意外な事実、共感できるシナリオなど)を用意すること、各セクションに具体例やデータを織り交ぜて抽象論に終わらせないこと、そして情報の出典を明記して信頼性を担保することが挙げられます。収集した情報はあくまで素材であり、コピーではなく自分の視点で再構成することが、記事のオリジナリティにつながります。
5. 推敲と品質チェック
書き終えたら、事実関係の正確性(ファクトチェック)、論理の一貫性、読みやすさ(文の長さ、専門用語の説明)、誤字脱字を確認します。可能であれば時間を置いてから読み返すと、客観的な視点で改善点が見つかりやすくなります。
もし実際に特定のテーマでブログ記事を作成したい場合は、テーマを教えていただければ、情報収集から執筆までお手伝いできます。
(2) 段階的にタスクを実行するスキルを作成
次に、先程の手順に従って段階的にタスクを実行するためのスキルを作成してもらいます。
これらをフェーズごとに実行するためのスキルを作成して
【Claude Opus 4.6の回答】
Now I have a good understanding of how to structure skills. Let me create the blog article writing skill with a clear phased workflow.
blog-article-writer スキルを作成しました。3つのファイルで構成されています。
構成:
SKILL.md — メインのスキル定義。5つのフェーズ(テーマ設計 → 情報収集 → 構造化 → 執筆 → 推敲)のワークフローと、各フェーズの成果物・進め方を定義
references/research-guide.md — Phase 2(情報収集)の詳細手順。キーワード設計、段階的な検索戦略、ソースの信頼性評価基準など
references/writing-guide.md — Phase 4(執筆)の詳細ガイドライン。導入のフックパターン、段落構成、文体ガイド、出典の記載方法など
特徴:
各フェーズの完了時にユーザーへ確認を取るインタラクティブ設計
「全部任せる」にも対応し、Phase 1のヒアリング後は一気に完成まで進行可能
著作権に配慮したパラフレーズ重視のルール
このスキルを使いたい場合は、/mnt/skills/user/ 配下に配置してください。テストしてみたいテーマがあればここで試すこともできます。
SKILL.md
ユーザーが指定したテーマに基づき、Web検索で情報を収集し、高品質なブログ記事を作成するスキル。 5つのフェーズ(テーマ設計 → 情報収集 → 構造化 → 執筆 → 推敲)を順に実行し、 各フェーズの成果物をユーザーに確認してもらいながら進行する。 「ブログ記事を書いて」「〜についての記事を作成して」「〜をテーマにブログを書いて」 「リサーチして記事にまとめて」といったリクエストが来たら、このスキルを使用する。 記事作成だけでなく、特定テーマの調査レポートやコンテンツ作成にも応用できる。
Blog Article Writer
ユーザーのテーマを基に、Web検索で情報を集め、高品質なブログ記事を段階的に作成するスキル。
全体フロー
Phase 1: テーマ設計(ヒアリング) → Phase 2: 情報収集 (Web検索) → Phase 3: 構造化 (アウトライン) → Phase 4: 執筆 (ドラフト) → Phase 5: 推敲 (品質チェック)
各フェーズの完了時にユーザーへ進捗を共有し、フィードバックを受けてから次へ進む。 ユーザーが「全部任せる」と言った場合は、Phase 1のヒアリング後、Phase 2〜5を一気に実行して最終成果物を渡す。
Phase 1: テーマ設計(ヒアリング)
目的: 記事のスコープ、読者ターゲット、ゴールを明確にする。
ユーザーのリクエストから以下を把握する。不明な点があれば質問する。
1. テーマの具体化: 漠然としたテーマ(例:「AI」)を、記事にできるレベルまで絞る(例:「中小企業がAIで業務効率化する3つの方法」)
2. 読者ターゲット: 誰に向けた記事か(初心者/専門家、年齢層、業種など)
3. 記事のゴール: 読者にどんな行動・理解を促したいか
4. トーン・スタイル: カジュアル/フォーマル、文体の好み
5. 文字数の目安: 短め(1000字)〜長め(5000字以上)
6. 言語: 日本語 or 英語(デフォルトはユーザーの言語に合わせる)
ヒアリング結果を簡潔にまとめてユーザーに確認を取る。
成果物: テーマ定義書(会話内で共有)
Phase 2: 情報収集(リサーチ)
目的: 記事の根拠となる情報をWebから幅広く集める。
詳細な手順は references/research-guide.md を参照。
概要
1. テーマに関連するキーワードを3〜5個抽出する
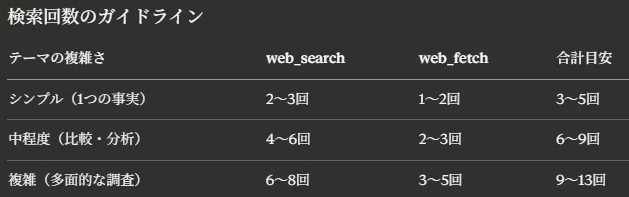
2. web_search で各キーワードについて検索する(最低3回、複雑なテーマなら5〜8回)
3. 有望なソースは web_fetch で本文を取得し、要点を抽出する
4. 収集した情報を以下の観点で整理する:
・事実・データ: 統計、調査結果、公式発表
・専門家の見解: 引用できる意見やコメント
・事例・ケーススタディ: 具体的な成功例・失敗例
・対立する意見: テーマに関する異なる立場
5. 情報源の信頼性を評価する(一次情報 > 専門メディア > 一般メディア > 個人ブログ)
ソース選定の優先順位
・公式サイト、政府統計、学術論文 → 最優先
・業界専門メディア、大手報道機関 → 高信頼
・テック系メディア、ビジネス誌 → 中信頼
・個人ブログ、SNS → 補助的に使用(裏取りが必要)
成果物: リサーチサマリー(主要な発見を箇条書きで会話内に共有)
Phase 3: 構造化(アウトライン作成)
目的: 記事全体の論理構造と流れを設計する。
1. リサーチ結果を基に、記事の独自のアングル(切り口)を決める
・「他のどの記事とも違う、この記事ならではの価値」を意識する
・読者の具体的な疑問や課題に答える形が望ましい
2. 以下の構造でアウトラインを作成する:
# タイトル案(2〜3案提示)
## 導入(フック)
- 読者の注意を引く要素(問いかけ/意外な事実/共感シナリオ)
## 本論
### セクション1: [見出し]
- 主張 + 根拠データ/事例
### セクション2: [見出し]
- 主張 + 根拠データ/事例
### セクション3: [見出し] - 主張 + 根拠データ/事例
## 結論(まとめ + CTA)
- 要点の整理
- 読者への次のアクション提案
3. アウトラインをユーザーに提示し、構成の承認を得る
成果物: アウトライン(マークダウン形式で会話内に共有)
Phase 4: 執筆(ドラフト作成)
目的: アウトラインに沿って本文を書き上げる。
詳細な執筆ガイドラインは references/writing-guide.md を参照。
執筆の基本原則
1. パラフレーズが基本: 収集した情報はすべて自分の言葉で書き直す。直接引用は最小限に
2. 具体性: 抽象的な主張には必ずデータや事例を添える
3. 読みやすさ: 一文は60字以内を目安に。専門用語には補足説明を入れる
4. つなぎ: セクション間の論理的なつながりを意識する
5. 出典明記: 情報源がある主張には出典を示す(記事末尾にリンク集、または文中で言及)
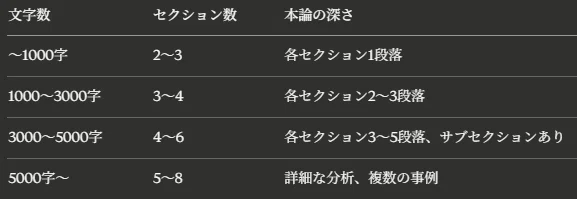
文字数別のガイドライン
出力形式
記事はマークダウン(.md)ファイルとして作成し、/mnt/user-data/outputs/ に保存する。 ファイル名は blog-[テーマの英語キーワード].md とする。
成果物: ブログ記事ドラフト(.mdファイル)
Phase 5: 推敲(品質チェック & 最終化)
目的: 記事の品質を最終確認し、完成版を納品する。以下のチェックリストに沿って記事を見直す:
ファクトチェック
- 数値やデータは情報源と一致しているか
- 事実関係に誤りがないか
- 引用元は正確に記載されているか
論理チェック
- 導入から結論まで一貫した論旨が通っているか
- 各セクションの順序は自然か
- 根拠なき主張がないか
読みやすさチェック
- 冗長な表現はないか同じ言い回しの繰り返しがないか
- 専門用語に十分な説明があるか
SEO・タイトルチェック(任意)
- タイトルは読者の興味を引くか
- 見出しにキーワードが自然に含まれているか
問題があれば修正し、最終版を /mnt/user-data/outputs/ に保存して present_files でユーザーに共有する。
成果物: 完成したブログ記事(.mdファイル)
著作権への配慮
記事作成時、収集した情報の取り扱いには細心の注意を払う:
- Web上の文章をそのまま転載しない。必ず自分の言葉でパラフレーズする
- 直接引用する場合は15語未満に留め、出典を明記する
- 1つのソースからの引用は1回までとする
- 歌詞、詩、記事の段落をそのまま再現しない
Research guide.md
リサーチガイド(Phase 2 詳細手順)
検索戦略
ステップ1: キーワード設計
テーマから検索キーワードを3〜5セット用意する。検索エンジンで最も効果的なのは1〜6語の短いクエリ。
キーワード設計の考え方:
- メインキーワード: テーマの核心を表す1〜2語(例: 「リモートワーク 生産性」)
- 派生キーワード: 具体的な側面に焦点を当てたもの(例: 「リモートワーク ツール 比較」)
- データキーワード: 統計や調査結果を狙うもの(例: 「リモートワーク 調査 2025」)
- 事例キーワード: 具体例を探すもの(例: 「リモートワーク 成功事例 企業」)
- 反論キーワード: 対立意見を探すもの(例: 「リモートワーク デメリット 課題」)
ステップ2: 段階的な検索
- 広い検索(1〜2回): メインキーワードで概要を把握
- 深堀り検索(2〜4回): 具体的なデータ、事例、専門家の見解を収集
- 補完検索(1〜2回): 不足している視点や最新情報を補う
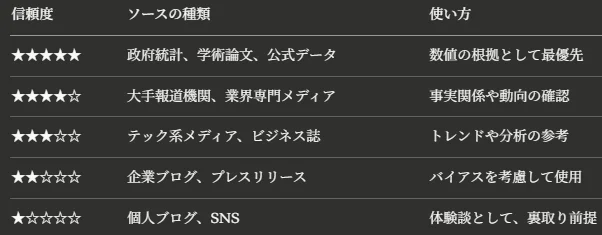
ステップ3: ソース評価
検索結果を見る際は以下の基準で質を評価する:
ステップ4: 情報の抽出と整理
有望なソースからは web_fetch で本文を取得し、以下を抽出する:
- ハードファクト: 数値、日付、固有名詞などの客観的事実
- インサイト: 専門家の分析や意見(パラフレーズして記録)
- ストーリー: 具体的な事例やケーススタディの要約
- 論点: テーマに対する賛否両論のポイント
検索回数のガイドライン
よくある落とし穴
- 確証バイアス: 自分の仮説を支持する情報だけを集めない。意図的に反論も探す
- 古い情報: 公開日を確認する。テクノロジー系は特に陳腐化が早い
- 出典ロンダリング: 複数の記事が同じ一次ソースを引用していることがある。元の情報源を辿る
- 検索の繰り返し: 同じクエリを繰り返しても結果は変わらない。キーワードを変えて試す
writing-guide.md
執筆ガイド(Phase 4 詳細手順)
導入部の書き方
導入部は記事の成否を決める最重要パート。読者が「続きを読みたい」と思えるフックを入れる。
効果的なフックのパターン
1. 意外な事実: 読者の常識を覆すデータや事実から始める
例:「日本企業の○○%が、実は〜を導入していないという調査結果がある」
2. 問いかけ: 読者自身に当てはまる質問を投げかける
例:「毎朝の通勤時間、もっと有意義に使えたらと思ったことはないだろうか?」
3. 共感シナリオ: 読者が「あるある」と感じる状況を描写する
例:「会議が終わった瞬間、『結局何が決まったんだっけ?』と感じた経験は誰にでもあるだろう」
4. ストーリー: 具体的な人物やエピソードから入る
例:「ある中小企業の経営者が、たった1つのツールを導入したことで〜」
導入部のテンプレート
[フック: 1〜2文]
[背景の提示: テーマの重要性や現状を簡潔に]
[記事のプレビュー: この記事で何がわかるかを明示]
本論の書き方
段落構成の原則
各段落は以下のパターンで構成する:
1. 主張(トピックセンテンス): その段落で言いたいことを1文で
2. 根拠: データ、事例、専門家の見解で主張を支える
3. 解説: 根拠が主張をどう支えるかを説明
4. つなぎ: 次の段落への橋渡し
具体性を高めるテクニック
- 「多い」→「○○%」「○万人」のように数値化する
- 「最近」→「2025年○月の調査によると」のように具体的な時期を示す
- 「ある企業」→ 可能な限り企業名や業種を明記する
- 「効果がある」→「○○が△△%改善した」のように効果を定量化する
セクション間のつなぎ方
セクションの切り替えが唐突にならないよう、以下のテクニックを使う:
- 対比: 「一方で〜」「しかし、〜の観点から見ると」
- 深堀り: 「では具体的にどうすればよいのか」「この点をさらに掘り下げてみよう」
- 発展: 「これを踏まえると〜」「この考え方を応用すると」
結論の書き方
結論に含めるべき要素
1. 要点の再確認: 記事の核心メッセージを別の角度から言い直す(コピペは禁止)
2. 実用的なアドバイス: 読者が今日から実践できる具体的なステップ
3. 未来への展望(任意): テーマの今後の展開について触れる
4. CTA(行動喚起)(任意): コメント、シェア、関連記事への誘導
避けるべきパターン
- 導入部の繰り返し
- 本論で触れなかった新しい論点の追加
- 「いかがでしたか?」のような空虚な問いかけ
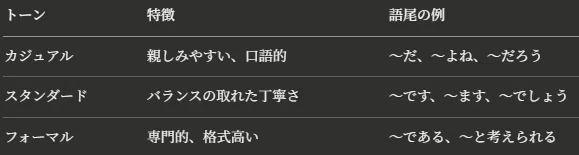
文体ガイドライン
一般的な注意点
- 一文は40〜60字を目安に。80字を超えたら分割を検討
- 「〜です。〜です。〜です。」と同じ語尾が3回以上続かないようにする
- 受動態より能動態を優先する
- 二重否定を避ける(「〜しないわけではない」→「〜することもある」)
トーン別の書き分け
出典の記載方法
文中での言及
情報源がある主張には、自然な形で出典を織り込む:
- 「○○社の調査によると〜」
- 「○○大学の△△教授は〜と指摘している」
- 「○○省が発表した統計では〜」
記事末尾の参考リンク
記事の最後に「参考資料」セクションを設け、主要なソースのURLを列挙する:
## 参考資料
- [ソース名1](URL)
- [ソース名2](URL)
- [ソース名3](URL)
(3) スキルファイルを自分のスキルにコピー
上記(2) で作成した3つのファイルをパッケージ化して、自分のスキルファイルとして設定します。
これらのファイルをすべてパッケージ化して、ブログ記事作成用のスキルファイルとしてコピーできるようにして
【Claude Opus 4.6の回答】
blog-article-writer.skill にパッケージ化しました(7.5KB、ZIP形式)。
中には以下の3ファイルがすべて含まれています:
SKILL.md — メインのスキル定義(5フェーズのワークフロー)
references/research-guide.md — リサーチ手順の詳細ガイド
references/writing-guide.md — 執筆の詳細ガイドライン
ダウンロードして、そのままスキルとしてインストールできます。
🌟最後に、以下のように表示されるので、「自分のスキルにコピー」をクリックすると、これらのスキルファイルが自分のClaudeに設定されます。
以下のように「blog-article-writer」のスキルが追加されました。右側のトグルスイッチをオンにすると、このスキルが使用できるようになります。
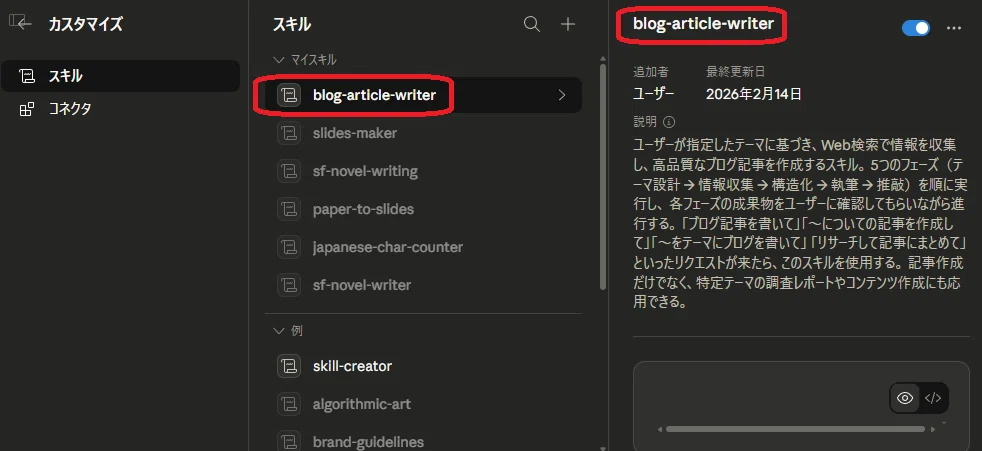
🌟このスキルファイルをダウンロードし、「設定」→「機能」→「スキル」画面から「+追加」をクリックして、自分のClaudeに設定することができます。
2.スキルを利用してnote記事を書く
(1) スキルの設定
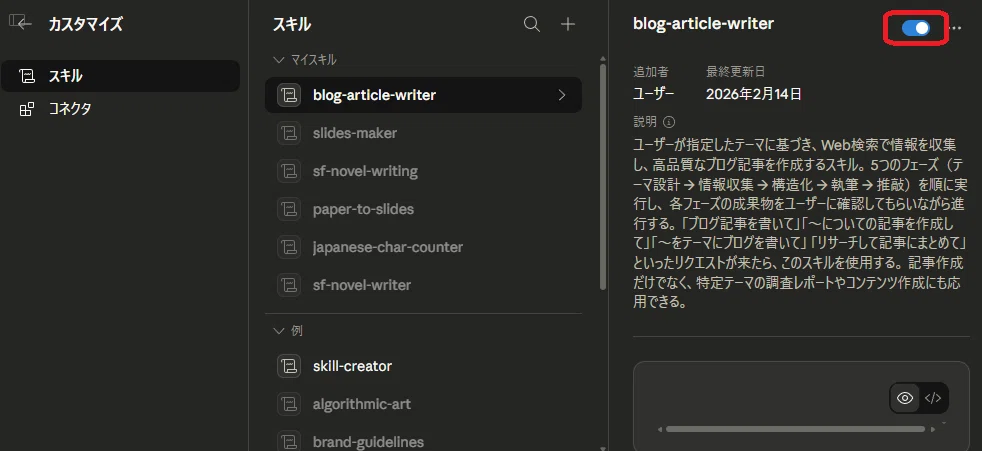
「カスタマイズ」→「スキル」画面で「blog-article-writer」を選択し、右側のトグルスイッチをオンに設定します。
(2) ブログ作成の指示
以下のように、テーマを示してブログ記事の作成を指示します。
Gemini 3 Deep Thinkについてブログ記事を書いて
【Claude Opus 4.6の回答】
ブログ記事を作成しますね!まず、記事のスコープを明確にするためにいくつか確認させてください。
十分なリサーチ情報が集まりました。記事の方向性について、いくつか確認させてください。
リサーチはすでに完了しています。上記の3点を教えていただければ、すぐに記事の構成案を作成して執筆に入れます。
🌟この後、以下のようにClaudeが質問してきますので、選択肢から自分の目的に合ったものを選んで回答してください。
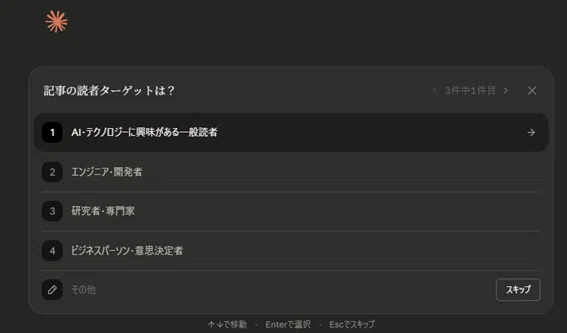
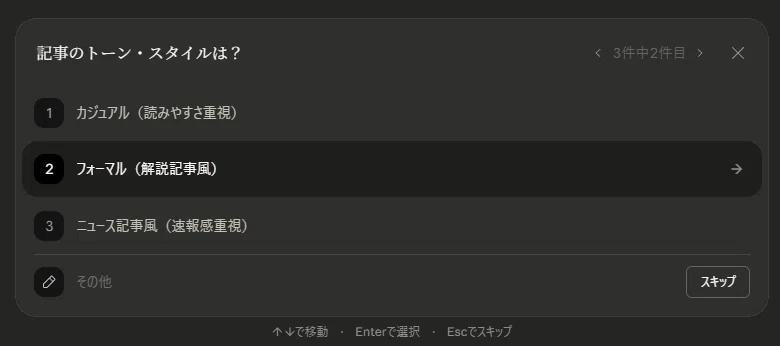
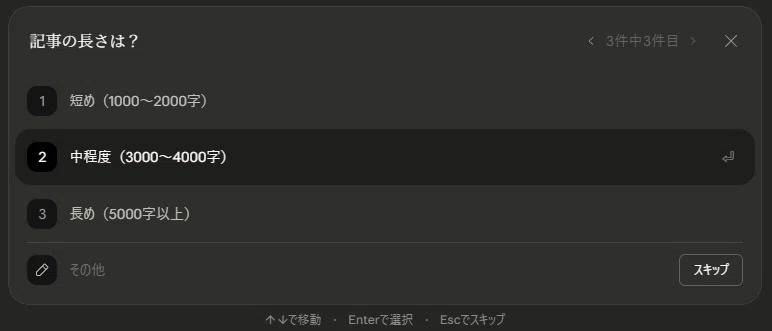
🌟これら3つの質問に回答すると、Claudeが記事の執筆を開始します。
Q: 記事の読者ターゲットは?
A: AI・テクノロジーに興味がある一般読者
Q: 記事のトーン・スタイルは?
A: フォーマル(解説記事風)
Q: 記事の長さは?
A: 中程度(3000〜4000字)
【Claude Opus 4.6の回答】
ありがとうございます。それではリサーチ結果をもとに、構成案をお見せしてから執筆に入ります。
テーマ定義:
テーマ: Google Gemini 3 Deep Thinkの概要・技術・成果・意義
読者: AI・テクノロジーに興味がある一般読者
トーン: フォーマル(解説記事風、「〜である」「〜と考えられる」体)
文字数: 3000〜4000字
アウトライン案:
導入 — 2026年2月、Googleが発表したDeep Thinkの衝撃的な成果(フック)
Gemini 3 Deep Thinkとは — 通常のAIとの違い、「並列仮説探索」の仕組み
ベンチマークが示す圧倒的性能 — ARC-AGI-2、Humanity's Last Exam、Codeforces等の具体的数値
18の未解決問題への挑戦 — 10年越しの予想の反証、物理学・経済学への応用
研究現場での実践事例 — ラトガース大学、デューク大学、3Dプリンティング
利用方法と今後の展望 — Google AI Ultra、API早期アクセス、AIの研究パートナー化
結論 — ベンチマークの先にある「科学的発見を加速するAI」の意義
この構成で執筆を進めてよろしいですか?調整したい点があればお知らせください。
🌟修正や意見があれば、ここで入力してください。この構成でよい場合は「はい」と回答します。
【Claude Opus 4.6の回答】
それでは執筆に入ります。
品質チェックを行い、問題がなければ納品します。
ファクトチェック、論理構成、読みやすさを確認しました。記事本文は約3,800字で、ご要望の範囲に収まっています。
ブログ記事が完成しました。Gemini 3 Deep Thinkの技術的仕組み(並列仮説探索)、主要ベンチマークでの圧倒的成績、18の未解決問題への貢献、そして研究現場での実践事例まで、フォーマルな解説記事としてまとめています。参考資料リンクも末尾に記載しました。
修正や加筆のご要望があればお知らせください。
🌟これで、Gemini 3 Deep Thinkに関する記事が完成しました。
3.完成した記事
今回「blog-article-writer」のスキルを使って作成したnote記事(4,693字)は、以下の通りです。
Gemini 3 Deep Think——AIが「未解決問題」を解く時代が始まった
2026年2月12日、Google DeepMindは「Gemini 3 Deep Think」の大規模アップグレードを発表した。抽象推論ベンチマーク「ARC-AGI-2」で84.6%という驚異的なスコアを記録し、さらに数学・物理学・計算機科学にまたがる18の未解決研究課題を解決したという。これは単なるベンチマーク更新の話ではない。AIが科学研究の現場で実質的な貢献を果たし始めたことを示す象徴的な出来事である。
本記事では、Gemini 3 Deep Thinkの技術的な仕組みからベンチマーク成績、実際の研究成果、そして今後の展望まで包括的に解説する。
Gemini 3 Deep Thinkとは何か
Gemini 3 Deep Thinkは、Google DeepMindが開発した特化型推論モードである。独立したモデルではなく、Gemini 3 Proの上に構築された高度な推論レイヤーとして機能する。通常のAIモデルが一度のパスで回答を生成するのに対し、Deep Thinkは複数の仮説を並列に探索し、反復的な推論サイクルを経て最終的な回答に到達する。
この仕組みは、心理学で「システム2思考」と呼ばれる人間の熟慮的・分析的な思考プロセスに近い。直感的に素早く答える「システム1」ではなく、時間をかけて論理的に問題を分解し、複数のアプローチを比較検討するのである。
具体的には、Deep Thinkは以下のステップで推論を行う。まず、問題に対して複数の解法仮説を同時に生成する。次に、それぞれの仮説を制約条件に照らして評価し、有望なものを絞り込む。行き詰まった場合はバックトラックして別の経路を探索する。最後に、最良の解法候補に対して自己検証を実施し、論理的整合性やエッジケースを確認したうえで回答を出力する。
従来の「思考の連鎖(Chain of Thought)」手法が直線的に推論を進めるのに対し、Deep Thinkは木構造的に複数の経路を並列探索できる点が本質的な違いである。その代償として、通常のモデルと比べて10倍から100倍の推論計算コストがかかるとされる。速さより正確さを優先する設計であり、日常的な質問ではなく、高度な分析を必要とするタスクに特化している。
ベンチマークが示す圧倒的な推論性能
Gemini 3 Deep Thinkのアップグレード版は、主要なAIベンチマークにおいて業界最高水準のスコアを記録した。
最も注目すべきは、ARC-AGI-2での84.6%という結果である。ARC Prize Foundationによって独立検証されたこのスコアは、OpenAIのGPT-5.2 Thinking(52.9%)やAnthropicのClaude Opus 4.6 Thinking(68.8%)を大幅に上回る。ARC-AGI-2は、パターンの暗記ではなく未知の問題に対する柔軟な推論能力を測定するベンチマークであり、人間の平均正答率が約60%であることを踏まえると、この数値の意味は大きい。なお、初代ARC-AGI-1ではDeep Thinkは96%に達しており、このベンチマークをほぼ飽和させた形となる。
PhD級の専門知識を問う「Humanity's Last Exam」では、外部ツールを使用しない条件で48.4%を達成した。これはClaude Opus 4.6の40.0%、GPT-5.2の34.5%をいずれも上回り、新たな最高水準を樹立している。
競技プログラミングの領域では、Codeforcesで3455というEloレーティングを獲得し、「Legendary Grandmaster」の称号に相当する水準に到達した。これは人間の競技プログラマーの中でもごく一部しか到達できないレベルであり、Claude Opus 4.6の2352 Eloと比較しても際立った差がある。
さらに、2025年の国際数学オリンピック(IMO)で金メダル水準の成績を収めたほか、国際物理オリンピック(IPhO)および国際化学オリンピック(IChO)の筆記セクションでも金メダル相当の結果を達成した。高エネルギー物理学の理論問題を扱うCMT-Benchmarkでも50.5%を記録しており、数学だけでなく自然科学の幅広い領域で高い推論能力を発揮していることがわかる。
18の未解決問題を解いた衝撃
ベンチマークの数値以上にインパクトがあるのは、Deep Thinkが実際の学術研究において18の未解決問題に貢献したという事実である。Google DeepMindが2月11日にarXivで公開した論文によれば、これらの成果はアルゴリズム、機械学習、組合せ最適化、情報理論、経済学など多分野にまたがるものである。
中でも特筆すべきは、2015年に提唱されたオンライン劣モジュラ最適化に関する予想の反証である。データストリームにおいて「到着したアイテムのコピーは、オリジナルを移動するより常に価値が低い」という直感的に正しそうな命題を10年にわたり人間の数学者たちは証明しようと試みてきた。Deep Thinkは、3要素からなる組合せ論的反例を構築し、この予想が誤りであることを厳密に証明した。人間が直感に引きずられて見逃していたエッジケースをAIの体系的な探索が発見した形である。
物理学の分野では、宇宙ひも(cosmic string)からの重力放射に関する計算に取り組んだ。特異点を含む積分が問題となっていたが、Deep Thinkはゲーゲンバウアー多項式を活用するアプローチを発見し、無限級数を閉じた形の有限和に変換することに成功した。
機械学習の最適化においても興味深い成果があった。ノイズ除去のためのAI学習では通常、数学的なペナルティ項を手動調整する必要がある。ある自動化手法がなぜ機能するのかが数学的に証明されていなかったが、Deep Thinkはこの手法が内部的に適応的なペナルティを自動生成していることを解析的に示した。
経済学では、AIトークンオークションに関する「顕示原理」を拡張する貢献をした。既存の理論は有理数入札にしか適用できなかったが、Deep Thinkはトポロジーの手法を用いて連続実数入札にも対応可能な証明を構築した。
これらの成果の約半数は主要な学術会議への投稿を予定しており、うち1件はすでにICLR 2026に採録されている。Google DeepMindはこれらの結果について、AI支援数学研究の重要度に応じた分類法も提案しており、現時点ではレベル2(査読付き学術誌に投稿可能な品質)と位置づけている。
研究現場での実践活用
Deep Thinkの価値は、抽象的なベンチマークや定理証明だけにとどまらない。すでに複数の研究機関が実際の研究プロセスにおいてDeep Thinkを活用している。
ラトガース大学の数学者Lisa Carbone氏は、アインシュタインの重力理論と量子力学の橋渡しに必要な数学的構造の研究に従事している。既存の訓練データがほとんど存在しないこの分野で、Carbone氏は高度に専門的な数学論文のレビューにDeep Thinkを使用した。その結果、人間の査読を通過していた論文中の微妙な論理的欠陥をDeep Thinkが検出したという。
デューク大学のWang Labでは、半導体材料の発見に向けた結晶成長の製造プロセス最適化にDeep Thinkを活用した。100マイクロメートルを超える薄膜を生成するための詳細なレシピを設計する際に、AIが実験条件の最適化を支援している。
さらに、GoogleのPlatforms and Devices部門のR&Dリーダーによるテストでは、Deep Thinkが手描きのスケッチから3Dプリント可能なファイルを生成する能力も示された。2次元の図面を分析し、複雑な3D形状をモデル化してSTLファイルとして出力する。この能力は、エンジニアリングにおけるプロトタイピングの速度を大幅に向上させる可能性がある。
利用方法と今後の展望
Gemini 3 Deep Thinkは、Google AI Ultra加入者であれば、Geminiアプリ内で利用可能である。使い方は、モデルドロップダウンからGemini 3 Proを選択し、プロンプトバーで「Deep Think」を有効にするだけである。応答には通常のモデルより時間がかかり、一般的には数分程度を要する。
今回のアップグレードで注目すべき点は、初めてGemini API経由でのアクセスが提供されることである。研究者、エンジニア、企業向けの早期アクセスプログラムへの参加申請を受け付けており、これによりDeep Thinkを自社のワークフローやエージェントシステムに統合することが可能になる。
ただし、利用にはコストの考慮も必要である。ARC Prize Foundationの検証によれば、ARC-AGI-2タスク1件あたりの推論コストは約13.62ドルとされており、大規模な本番環境での運用には経済性の課題が残る。日常的な質問には通常のGemini 3 FlashやProで十分であり、Deep Thinkはあくまで高度な推論を必要とするタスクに特化して使うべきモードと言える。
AIは科学の「能力を増幅する道具」となるか
Gemini 3 Deep Thinkの登場が示しているのは、AIが単なる情報検索や文章生成のツールから、科学的発見を加速する研究パートナーへと変貌しつつあるということである。10年間証明できなかった予想を反証し、査読を通過した論文の誤りを検出し、異分野の数学的手法を応用して膠着した問題を打開する。これらは、人間の研究者が直感や慣習に縛られやすい領域で、AIの体系的な探索能力が真価を発揮した事例と言えるだろう。
Google DeepMindはDeep Thinkを、人間の知性を置き換えるものではなく、「能力を増幅する道具(force multiplier)」として位置づけている。知識の検索と検証をAIが担い、人間は創造的な方向性の決定に集中する——そうした協働モデルが今まさに具体的な成果を生み始めている。
ARC-AGI-2のようなベンチマークが飽和に近づく中、今後の焦点は実世界での科学的・工学的インパクトへと移っていくことになる。Deep Thinkはその先鋒として、AI支援型の科学研究がどこまで進化しうるかを指し示す極めて重要な一歩である。
参考資料
Gemini 3 Deep Think: Advancing science, research and engineering — Google Blog
Accelerating mathematical and scientific discovery with Gemini Deep Think — Google DeepMind
Google Gemini 3 Deep Think Solves 18 Research Problems — WinBuzzer
4.感想
今回は公式の情報がそろっていたこともあり、しっかりした内容の記事が書けたと思います。作成したスキルは、実用性が十分にありそうです。比較的固い解説記事だったので、次はもう少しカジュアルなトーンの記事も試してみたいところです。
このように、スキルは自分で簡単に作成できますので、皆さんもぜひオリジナルのスキルを作って活用してみてください。
