「AI 2040 Plan A」とは何か――「AI 2027」の破滅予測を避ける米中協調の超知能ロードマップ

2026年7月9日、AI Futures Projectは「AI 2040: Plan A」を公開しました。
中心人物の一人は、元OpenAI研究者で「AI 2027」の共同著者として知られるダニエル・ココタジロ(Daniel Kokotajlo)氏です。ただし、これはココタジロ氏の単独研究ではありません。トーマス・ラーセン氏をはじめとする6人の共同著者が、AIの能力予測、データセンターの検証方法、経済モデル、秘密プロジェクトの可能性などを分担して作成した、大規模な共同プロジェクトです。
「AI 2027」が、現在のAI開発競争を続けた場合に何が起こり得るかを描いた警告シナリオだったとすれば、「AI 2040 Plan A」は、その結末を避けるために人類が何をすべきかを描いた提案です。
ただし、最初に最も大切な点を確認しておきましょう。
Plan Aは「2040年までAI開発を全面停止する計画」ではありません。
2029年に最先端AIの新規学習をいったん止めた後、国際監視の下で開発を再開し、2035年に「最高の人間専門家と同程度」の段階で再び停止します。その5年間に、AIの目的や行動を人間の意図・価値観と一致させる「AIアラインメント」や統治の問題を解き、2040年から超知能への移行を再開する――これがシナリオの骨格です。
また、著者たちはPlan Aを「予測」ではなく「推奨案」と位置づけています。実際に起こる可能性が最も高い未来ではなく、目指す価値があると考える未来を、政策の実施手順まで含めて具体化したものなのです。
そもそも「AI 2040」とは何か
AI 2040の公式サイトは、未来予測、小説的なシナリオ、政策提言、経済モデルを組み合わせたインタラクティブな思考実験です。AI Futures Projectにとっては、「AI 2027」と「AI Futures Model」に続く3番目の大型プロジェクトに当たります。
物語は2027年から始まります。AIエージェントが急速に普及し、2028年にはホワイトカラー業務の自動化とAI企業への権力集中が政治問題になります。そして2029年、米国は超知能にどう向き合うかという分岐点に立ちます。
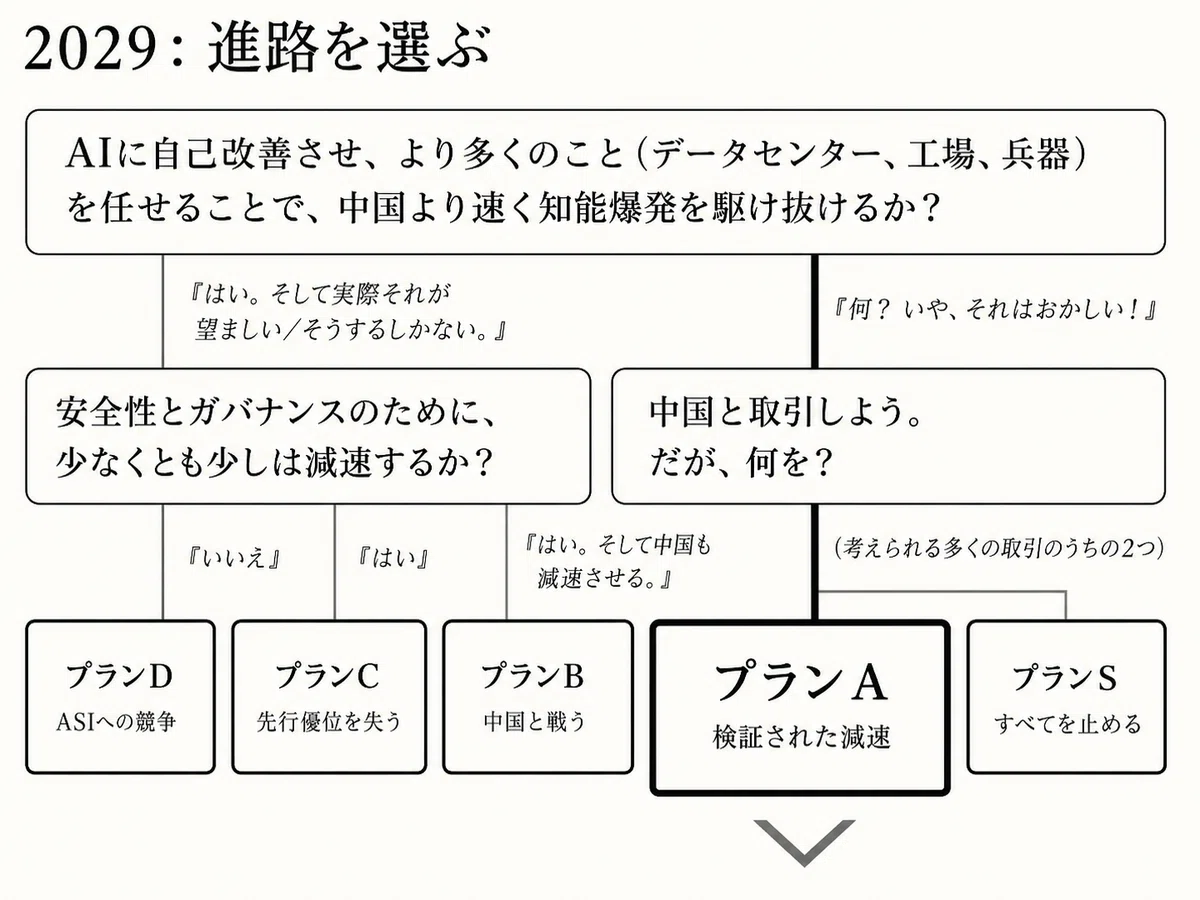
公式サイトでは、次の5つの進路が示されています。
Plan D:Race to ASI(超知能まで競争を続ける)
Plan C:Burn the Lead(先頭企業がリードの一部を安全対策に使う)
Plan B:Fight China(中国を妨害して米国のリードを広げる)
Plan A:Verified Slowdown(検証可能な国際協調で減速する)
Plan S:Shut It All Down(最先端AI開発を長期間停止する)
このうち、著者たちが推奨する中心ルートがPlan Aです。つまり「AI 2040」は複数の政策選択を比較する全体枠組みであり、「Plan A」はその中の本命案だと理解すると分かりやすいでしょう。
なぜPlan Aが必要なのか
Plan Aの出発点には、AI開発を競争に任せたままでは、次の5つの問題を同時に解けないという認識があります。
AIに対する制御の喪失
AIがAI研究そのものを自動化すると、より優れたAIが次のAIを作る循環が始まり、人間が安全性を検証できない速度で能力が上がる可能性があります。権力の極端な集中
最初の超知能を支配した企業や政府は、経済・軍事・情報のすべてで圧倒的な力を持ちます。AIが人間に従順だったとしても、「誰がそのAIを所有するのか」という問題は残ります。米中対立と第三次世界大戦の危険
一方が超知能を先に得れば、他方の核抑止力や体制そのものを無力化しかねません。その恐怖が、先制攻撃やサイバー攻撃を誘発する可能性があります。大規模な失業
AIとロボットが知的・肉体労働を代替すれば、所得だけでなく、労働を通じた社会的な力や生きがいも失われます。AIを使った大量破壊
高性能AIが生物兵器やサイバー攻撃の設計を容易にすれば、小規模な集団や個人でも甚大な被害を起こせるようになります。
著者たちは、これらを個別の規制で少しずつ抑えるだけでは不十分だと考えます。必要なのは、超知能に至るまでの道筋全体を設計し直すことです。公式の要約でも、Plan Aはこの5問題への包括策として説明されています。
Plan Aを支える4つの原則
Plan Aの中核は、2030年に国際的な「コンソーシアム」が採用する4原則です。
1.時間を買う(Buy Time)
安全性に十分な確信を持てないときは、AIの能力向上を減速させます。
重要なのは、AIを永久に止めることではなく、AI研究の自動化から超知能までを、数カ月ではなく約10年かけて進むプロセスに変えることです。政府、研究者、市民が状況を理解し、制度を整え、危険な兆候があれば止められる時間を確保します。
2.研究をほぼ全面的に透明化する(Total Research Transparency)
最先端AIの学習方法、実験、アルゴリズム、安全性評価などを、企業内の秘密にせず公開します。各国政府だけでなく、競合企業、大学、第三者監査機関も研究内容を検証できるようにする構想です。
ただし、何もかもインターネットに放流するわけではありません。学習結果を収めた巨大な数値データである「モデルの重み」は保護し、既存モデルを利用する「推論」の内容や利用者情報も非公開のままにします。公開する中心は、AIを新しく作り、改良する研究開発(R&D)の過程です。ココタジロ氏はAxiosの取材に対し、基本的な考え方を「モデルの重み以外は透明にする」と説明しています。
狙いは三つあります。危険な研究を外部から発見できるようにすること、安全研究に参加できる人を増やすこと、そして企業がアルゴリズム上の秘密を独占して競争する動機を弱めることです。
3.最先端AIを広く分散させる(Diffuse AI Broadly)
一社または一国だけを突出させず、複数国の数十社が同程度のAIを持つ状態を作ります。
研究が透明になり、能力向上の速度も抑えられれば、後続企業が先頭に追いつけます。その結果、超知能を一人のCEOや一国の指導者が独占する危険を下げられる、という発想です。
4.進歩を可逆的にする(Reversibility)
Plan Aでは、AIの性能向上を、拡散を止めにくい「アルゴリズム上の発見」よりも、物理的に管理できる「計算資源の増設」に寄せようとします。
アルゴリズムは一度漏れれば回収できません。一方、巨大データセンターなら場所を把握し、停止し、最悪の場合は破壊できます。この考えを極端な形にしたのが、Mutually Assured Compute Destruction(相互確証的な計算資源破壊)です。
シナリオでは、中国側の新設データセンターをカナダに、米国側をモンゴルに置きます。協定が崩壊した際には、相手に奪われる前に双方が自国の計算資源を破壊せざるを得ない配置にすることで、AI開発競争への復帰を抑止します。核抑止の「相互確証破壊」を、AIチップとデータセンターに置き換えた発想です。
米中は、どうやって互いの違反を見抜くのか
Plan Aの最大の難所は、米中が互いを信用していないことです。そこで著者たちは、信頼ではなく検証に基づく協定を提案します。
2029年の手順は、大きく三段階です。
計算資源の申告
半導体メーカー、販売会社、データセンターを監査し、世界中のAIチップの所在を追跡します。大規模データセンターは電力消費と冷却設備が巨大なため、衛星や電力網から比較的見つけやすいと想定されています。新規学習の一時停止
既存モデルの提供は続ける一方、新しい大規模学習を止めます。ネットワーク監視装置や処理の抜き取り再計算によって、データセンターが許可された推論だけを行っているかを確認します。世界的な参加
半導体供給網を持つ国や主要国を加え、米中二国間の合意を国際コンソーシアムに拡張します。
検証計画の補足資料は、現在の技術では低コストかつ高信頼の監視体制はまだ整っていないと認めています。一方で、大規模計算資源は物理的に集中するため、検証技術への投資によって改善できると主張します。
秘密計画に回せる「ダーク・コンピュート」について、著者側の中央値は世界全体の約0.5%、80%信頼区間は0.1〜1.4%です。ただし、この数字は多数の仮定に依存する試算であり、安全性が実証された値ではありません。
2027年から2040年まで、何が起こるのか
Plan Aの特徴は、政策だけでなく、その後の社会を年ごとに描いていることです。
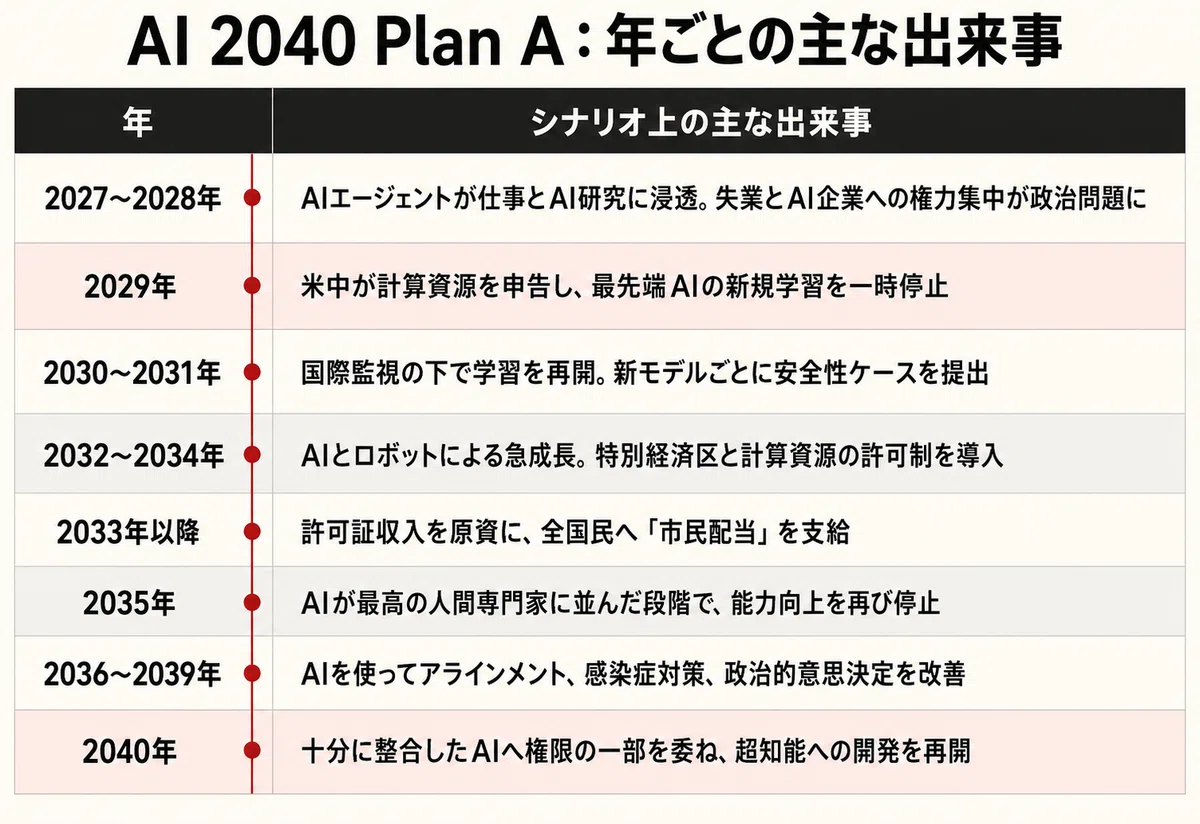
シナリオでは、2032年に実質GDPが約50%成長し、市民配当は2032年の年4万5,000ドルから2035年には約100万ドルへ増えるとされます。2040年には就業率が12%まで下がる一方、所得中央値は1,300万ドルに達します。
しかし、これらは予測モデルから得た非常に不確実な数字です。公式文書自身も、2040年の海外への所得移転など、一部は現実的な予測というより著者の推奨だと注記しています。数字の派手さより、「労働所得が消えるなら、AIとロボットの所有益をどう社会に戻すのか」という制度上の問いを見るべきでしょう。
Plan B・C・D・Sと比べると何が違うのか
公式の比較資料では、Plan A以外の案も次のように整理されています。
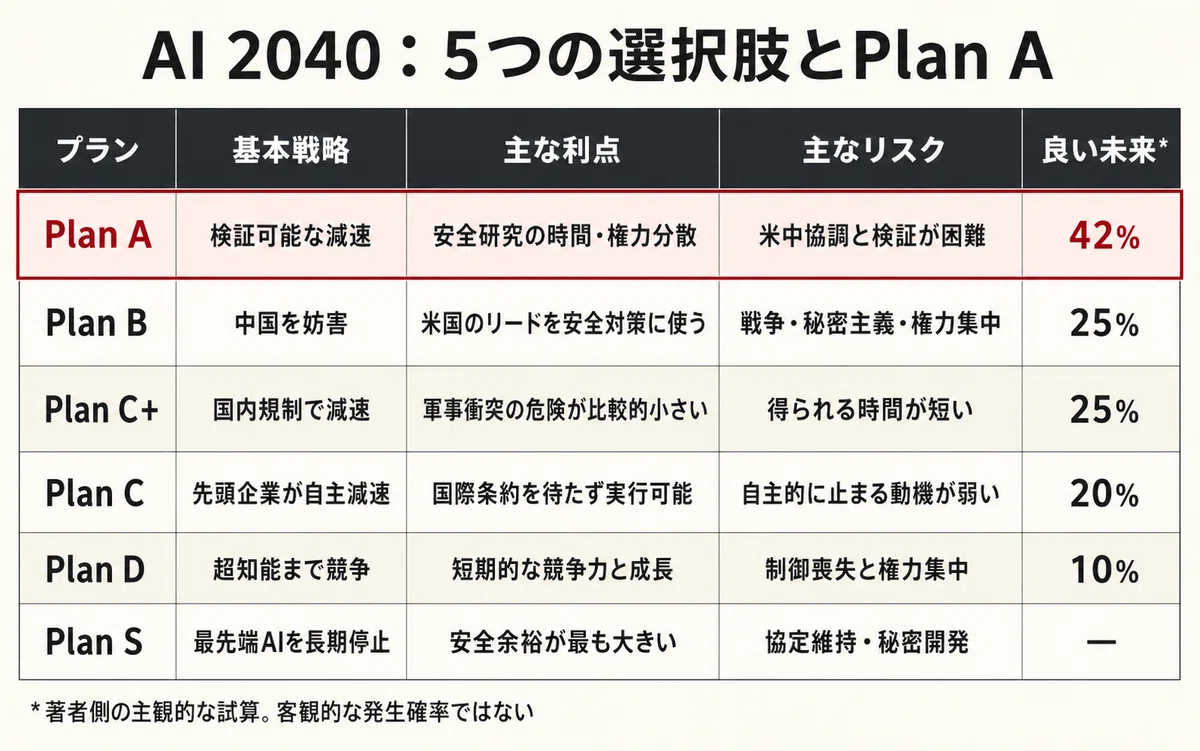
* 数値は比較資料を執筆したEli Lifland氏による主観的な中央値であり、客観的な発生確率ではありません。Plan Bには物理攻撃型とサイバー攻撃型、Plan Cには国内規制を伴うC+という派生案があります。
Plan Aは、Plan Dの「競争を続ける」とPlan Sの「全面的に止める」の中間に位置します。AIを使わなければ解けない安全問題もあるため、制御可能な範囲では進歩を続ける。しかし、人間の理解を越える前には止める。これが他の案との本質的な違いです。
興味深いのは、著者たち自身がPlan Aの実現を楽観視していないことです。5人の著者が示した発生確率はわずか3〜15%で、Plan Dは25〜50%でした。つまりPlan Aは「起こりそうな未来」ではなく、著者たちが「起こすべきだ」と考える未来なのです。
海外メディアはどう報じたか
Axiosは、Plan Aを「超知能を2040年まで遅らせ、社会が準備する時間を得る提案」と紹介しました。同時に、米議会の分断、米中対立、AI安全規制への政治的抵抗という厳しい現実も指摘しています。
The Washington Postは、「AI 2027」の暗い予測に対する、より明るい別ルートとして報道しました。ただし、その実現には米中が徹底した透明性を受け入れ、企業が社内限定の高性能モデルを外部検証にさらす必要があると強調しています。ココタジロ氏自身も、企業はこの案を好まないだろうと認めています。
Semaforは、Plan Aは反AI思想ではなく、むしろ前例のない経済成長を認める構想だと評価しました。その一方で、世界の指導者が私益や対立を乗り越えて協調する展開は「おとぎ話」のようにも見えると評しています。
この三つの報道をまとめると、Plan Aは「AIを止める運動」ではなく、「成長を続けながら破局を避ける設計図」として注目されている一方、その政治的実現可能性が最大の疑問と見られていることが分かります。
Plan Aの本当の価値は「正解」よりも「空白を見せること」
Plan Aの個々の数字を、そのまま未来予測として信じる必要はありません。2030年にAI研究が完全自動化されるのか、市民配当が100万ドルになるのか、2040年にAIを信頼できるのかは、どれも確実ではありません。
それでも、このプロジェクトには大きな価値があります。
現在のAI政策には、「透明性を高める」「安全性評価を義務づける」「雇用対策を行う」といった個別提案は数多くあります。しかし、その政策を実施した後、誰がAIを所有し、米中はどう反応し、失業者の所得をどう保障し、最終的に超知能を作るのかという全体像まで描いた提案は多くありません。
Plan Aは、その空白を強制的に可視化します。著者たちが「シナリオによる精査」と呼ぶ方法です。政策案を抽象的なスローガンのままにせず、時間軸に置き、登場人物の利害を与え、失敗時の分岐まで書く。そうすると、見落としていた前提や副作用が浮かび上がります。
「AI 2040 Plan A」に対する主な反論
最後に、Plan Aに対して考えられる反論を整理します。特に重要なのが、AI Futures Projectの依頼でシナリオを批評したAI研究者リチャード・ンゴ(Richard Ngo)氏の「Selective Optimism」です。同氏は制作過程で助言し、一部の指摘は反映されたものの、残った三つの大きな異論を公開しています。
反論1:急激な「知能爆発」という前提が強すぎる
Plan Aは、AIがAI研究を自動化すると、約1年で最高専門家級から超知能へ進み得るという前提に大きく依存しています。しかし、ベンチマーク上のAI能力が急上昇しても、雇用、科学、政治など現実社会への影響は、それほど急には現れない可能性があります。
ンゴ氏は、能力向上と社会的影響の間には、導入の難しさ、物理的なボトルネック、組織間協力の失敗などの「弱い環」があると指摘します。もし超知能への移行が数十年単位で進むなら、Plan Aほど巨大で中央集権的な国際体制は過剰かもしれません。
これに対し著者側は、時期には大きな不確実性があると認めています。前提を整理した補足資料では、AI研究自動化の90%信頼区間を2027年半ばから2050年ごろまでとし、急速な離陸にも幅を持たせています。それでも、「急速な自己改善が起こり得る以上、事前準備には保険価値がある」というのが著者側の立場です。
反論2:米中協調と有能な政府を仮定しすぎている
Plan Aには、米中首脳が危険を正しく理解し、半導体企業とAI企業を統制し、各国の監査官を受け入れ、秘密計画を抑え、長期間にわたって協定を守る必要があります。
しかも、「中国という国家にとって得か」と「中国共産党の指導層にとって得か」は同じではありません。AIによる富の分配と情報公開が一般国民を強くするなら、現在の権力者には拒む動機も生まれます。米国側でも、政権交代、企業ロビー、司法判断、州政府との対立が計画を崩す可能性があります。
著者自身のPlan A発生確率が3〜15%にとどまることは、この反論の強さを示しています。Plan Aは実現可能な政策パッケージというより、政治的な奇跡が起きた場合の最善努力に近い、という見方は十分に成り立ちます。
反論3:「全面透明化」は安全保障上の危険にもなる
研究を公開すれば、多くの研究者が安全性を検証できます。しかし同時に、秘密開発を行う国家や組織も、最先端アルゴリズムを利用できます。小規模な計算資源でも大きな能力を引き出す新手法が発見されれば、「巨大データセンターを監視すればよい」という前提が崩れます。
また、知的財産をほぼ放棄させれば、企業の研究投資が減るだけでなく、公開義務を避けるための偽装や、監査対象外の小規模研究が増える可能性もあります。
Plan Aはこれを欠陥ではなく、能力向上競争を弱める効果としてある程度意図しています。モデルの重みは公開せず、危険な研究は計算資源の制約で抑える考えです。それでも、「情報は拡散するが、計算資源は管理できる」という区別がいつまで成り立つかは、計画の最も重要で不確実な前提です。
反論4:権力分散を目指しながら、巨大な監視体制を作ってしまう
Plan AはAI企業の独占を防ぎますが、その代わりに、世界中の半導体、データセンター、研究、ロボット生産を監視する国際体制を作ります。この組織には、企業活動を止め、計算資源を破壊し、産業立地や生産量を決める強い権限が必要です。
その権限が民主的に統制されなければ、AIによる独裁を防ぐために人間の監視国家を作るという逆説が生じます。「複数国が参加しているから権力が分散している」とは限りません。大国間の密約が、中小国や市民の選択肢を奪う可能性もあります。
反論5:2040年の「AIへの権限移譲」は速すぎる
シナリオでは、2038年にアラインメントが科学となり、2039年にAIを信頼し始め、2040年には軍事・経済インフラの一部をAIに委ねます。
ンゴ氏は、この移行が急すぎ、一般市民が理解し同意する時間がないと批判します。専門家が安全性を確信したとしても、それは社会全体の民主的な同意とは別です。しかも最終段階では、人間が望んでもAIを停止できない「後戻り不能点」を意図的に越えます。
著者たちは、整合したAIに軍事を委ねることで、人間のクーデターや核戦争を防げると考えます。しかし、「安全なAIが人間の命令を拒否する」という制度を、誰が、どの価値観に基づいて設計するのかは、技術問題であると同時に政治哲学の問題です。
反論6:経済的な豊かさで社会問題を解決できるとは限らない
年100万ドルの市民配当があっても、失業による喪失感、政治参加の弱体化、所有者と非所有者の力の差、土地など希少資源の高騰が消えるとは限りません。許可証収入が公平に分配される保証もなく、制度が企業や政治家に取り込まれる可能性があります。
さらに、年50〜100%級の経済成長、ロボットの急増、巨額の税収という予測は、エネルギー、鉱物、建設、法制度、地域住民の反対といった現実の摩擦を小さく見積もっている可能性があります。
逆に、AI加速派から見れば、Plan Aは存在しないかもしれない破滅リスクのために、莫大な成長と技術革新を遅らせる計画です。全面停止を支持する側から見れば、人間の制御限界ぎりぎりまでAIを強化し、2040年に主権を渡すPlan Aは、むしろ危険な加速案です。Plan Aは中間案だからこそ、両側から批判されます。
結局のところ、Plan Aを完成した答えとして受け入れる必要はありません。むしろ読むべきなのは、そこに残された弱点です。
もしAIが人間を超えるなら、誰が開発速度を決めるのか。違反をどう見抜くのか。AIが生む富を誰が所有するのか。そして、人間はどの条件ならAIに権限を渡してよいのか。
「AI 2040 Plan A」の最大の意義は、これらの問いに正解を与えたことではなく、正解がまだ存在しないことを、具体的な未来の形で示した点にあるのだと思います。
※この記事は、ChatGPT WorkとGPT-5.6 Solを使用して作成されました。
