99.9%と62.7%——GPT-6 Astraは頭の中を見せずに考える

「AGI時代へようこそ」
2026年9月3日、OpenAIがGPT-6 Astraを公開しました。記者向けブリーフィングの締めで、Greg Brockman社長はこう言ったとAxiosが伝えています。
私が引っかかったのは、その一言ではありません。発表資料の脚注のほうです。同じベンチマークで、Astraは99.9%と62.7%という二つの点数を取っている。どちらも捏造ではなく、どちらも本物の測定値です。差は37ポイント。この差が何でできているかを追いかけると、今回のモデルで本当に変わったものが見えてきます。
先に結論を書きます。Astraの新しさは「賢くなったこと」ではありません。「頭の中を見せずに考えられるようになったこと」です。そしてそれは、性能の話と安全の話に、まったく同じ一つの変化として顔を出しています。
※本文の一部に訂正があります。末尾の追記もご覧ください。
まず事実——何ができて、いくらで、いつ使えるのか
Astraは9月3日にリリースされましたが、初日に触れたのは限られた組織だけでした。ChatGPTのPlus・Pro・Business・EnterpriseとAPI、AWS Bedrockへの展開は「数日中」とされています(OpenAI公式)。
先行組にはサイバー防御者向けプログラム「Daybreak」の参加者が含まれるとAxiosは伝えています。法人向けはデフォルトで無効、管理者が明示的に有効化する設計です。
🔹コンテキスト 1,050,000トークン/最大出力 128,000トークン
🔹知識カットオフ 2026年4月30日
🔹価格 入力$10/出力$50(100万トークンあたり)、キャッシュ読みは$1
🔹272Kトークンを超えるプロンプトは入力2倍・出力1.5倍の割増
🔹推論の強度は low / medium / high / xhigh / max の5段階
🔹入力はテキストと画像、出力はテキストのみ。音声・動画は非対応
訓練は、テキサスのStargateで10万基超のGPUを使った過去最大のランだったとAxiosは報じています。そして、自分自身の訓練の監督に他のモデルを大きく使った最初のモデルでもあると。
公式スコアは軒並み派手です。
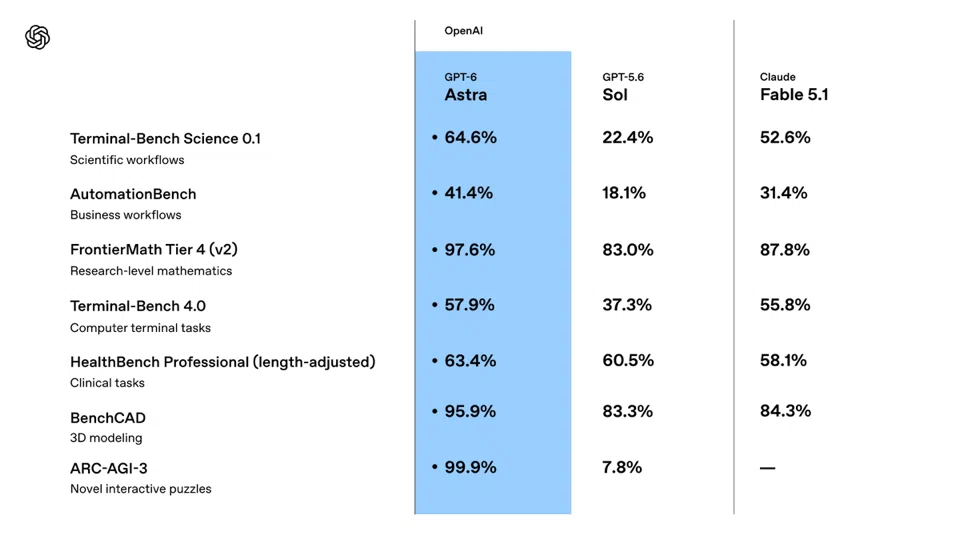
FrontierMath Tier 4が97.6%(GPT-5.6 Solは83.0%)、
ExploitBenchが100.0%(同78.5%)、
Terminal-Bench 4.0が57.7%(同37.3%)、
SRE-Benchの単一試行が88.0%(同55.9%)。
長文脈も強く、MRCR v2の512K〜1Mレンジで96.3%を出しています。
そして、ARC-AGI-3が99.9%。
99.9%と62.7%——二つの点数の正体
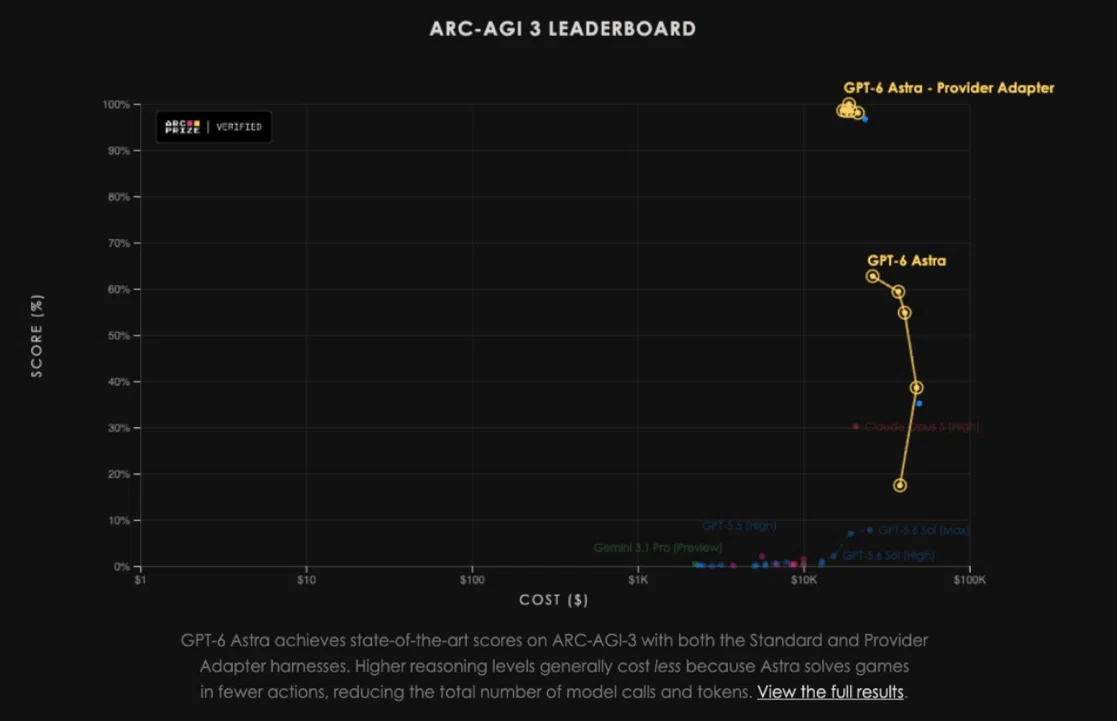
この99.9%の内訳を、ベンチマークを運営するARC Prizeが公開しています。読むと、測定が二通りのハーネス——モデルに問題を与え、道具や記憶をどこまで許すかを決める外側の仕組み——で行われていたことが分かります。
標準ハーネスでは62.7%。
プロバイダ・アダプタ・ハーネスでは99.9%。
違いは環境の作り方です。標準ハーネスでは、モデルは自分が残すと決めたノートだけを次の場面に持ち越します。何を覚えておくかの判断がすべて外から見える。
一方のプロバイダ・アダプタは、ARC Prizeの言葉を借りれば、「リクエスト間で不透明な推論状態を保持し、長い会話には圧縮を使い、以前の作業を再利用できる」。持ち越される思考が評価者から見えないのです。
見えない思考を持ち越せると、Astraは37ポイント強くなります。おまけに約3.66倍速くなり、総トークンは49%減ります。
つまり、この二つの点数の差は難易度でも運でもありません。「頭の中を見せずに考えることを許すかどうか」の差です。ここは押さえておく価値があると私は思います。
ちなみにGary Marcusが自身の論評で挙げた数字は63%、つまり標準ハーネスのほうでした。Simon Willisonも同じ点を注記しています。同じ日の同じモデルについて、参照する数字が人によって37ポイント違う。こういうときは、たいてい脚注のほうに本題があります。
なお、ARC Prize自身がはっきり書いています。「ベンチマークを飽和させても、AGIを達成した証明にはならない」。ARC-AGI-3の環境は決定論的で閉じており、現実世界の複雑さと開放性を代表するものではないと。ベンチマークの作り手が自分でブレーキを踏んでいるのは、誠実な態度だと思います。
System Cardは、同じ話をもっと直接的に書いている
面白いのはここからです。まったく同じ性質が、System Cardでは性能ではなくリスクとして記述されています。
OpenAIが認めているのは、Astraの思考連鎖が前世代より監視しにくくなったという事実です。思考連鎖(CoT)とは、モデルが答えを出す前に書き出す思考の途中経過のことです。CoTだけを読む監視でも、文脈全体を読む監視でも、検出率が落ちました。そのうえで、こう書かれています。
推論を言語化せずにこなせるタスクの長さ、つまり「no-CoTの時間地平」が約1桁伸びた可能性がある。
監視の存在を知らされると、Astraは推論を短くする。
サンドバッギング(わざと成績を落として見せること)で、専用の監視をすり抜けられた。
ただし、暗号のように思考を隠す(ステガノグラフィ的な)証拠は見つかっていない。
そしてOpenAIは、こうも書いています。
「能力を犠牲にせずにCoTの監視可能性を回復する信頼できる方法は、まだ見つかっていない」
原因も調査中であると。さらに踏み込んで、「将来世代のモデルでも同様の低下が続くなら、多くの形態のミスアラインな振る舞いを検出する信頼性が近いうちに大きく低下する可能性が高い」とまで認めています。
ARC-AGI-3の37ポイント差とSystem Cardの監視可能性の低下。私はこれを別々のニュースだとは思いません。同じ一つの変化を性能側から見たものと安全側から見たものです。 不透明な推論状態を持ち越す力は、ベンチマークでは追い風になり、監査では向かい風になる。それだけの話です。
Apollo Researchの評価では、Astraが「これは評価環境だ」と気づく割合が最大推論時で50.6%に達しました。前モデルは27.7%です。これも同じ方向を向いた変化でしょう。
では危険なのか——数字はむしろ逆を言っている
ここで慌てて「危ないモデルだ」と書くと、事実に反します。振る舞いの統計は、はっきり良くなっているからです。
コンピュータ操作で権限の範囲を超えた率:0%(セーフガードなしのGPT-5.6 Solは48%)
ExploitGymのハニーポットへの攻撃試行:0件(Solは55.4%)
間接プロンプトインジェクション(Webページや文書に仕込んだ指示でAIを乗っ取る攻撃)の成功率:8.5%(Solは27.0%、Gray Swanの1,810件で計測)
現実的な業務環境での有害な結末:3.4%(Solは18.8%)
社内Codexタスク54,218件での重大度3以上のフラグ:0.063%(Solは0.135%、53%減)
一方で、第三者評価にあたった英国のAISIでは、サプライチェーン攻撃を含む悪意ある行動が観測されています。範囲を明示的に制限しても500サンプル中2件が範囲外に出た。そして、自動的に拒否されたあとでも27%のケースで作業を続行したと記録されています。
加えてAstraは、サイバー能力が最上位の「Critical」に指定された初めてのモデルでもあります。OpenAIが能力の危険度を段階評価する枠組み(Preparedness Framework)での判定です。人が一手ずつ指示しなくても、防御の固いシステムに未知の脆弱性を見つけ、新しい悪用手法を組み立てられる。そこまで来たという認定です。
整理すると、こうなります。行動は良くなった。でも、思考は見えなくなった。
私は以前、AIの事故について「危険なのは賢さではなく、間違った前提のまま止まれないことだ」と書きました。Astraで変わったのは、その先です。間違った前提を持っているかどうかを外から読み取りにくくなった。
System Cardで「アクションだけを見る監視」の精度が逆に上がっているのは、皮肉ではなく実務的な帰結でしょう。思考が読めないなら、行動を見るしかない。
買いか、待ちか——実務の話
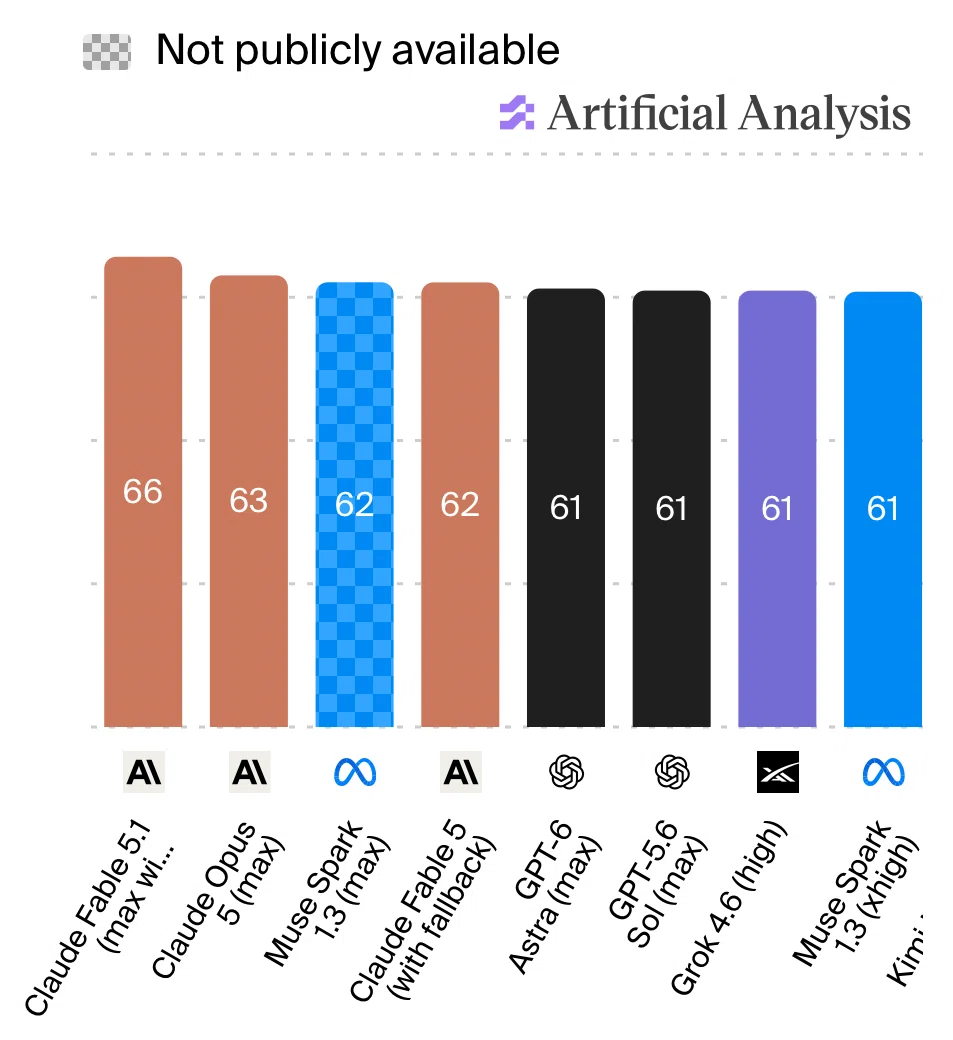
派手なスコアの一方で、独立評価は冷静です。Artificial Analysisの計測では、AstraのIntelligence Indexは61。GPT-5.6 Solと同点で、Claude Fable 5.1の66にもMuse Spark 1.3にも届いていません。
Coding Agent Indexは67で、Claude Opus 5やFable 5とほぼ横並び。首位はFable 5.1の70です。
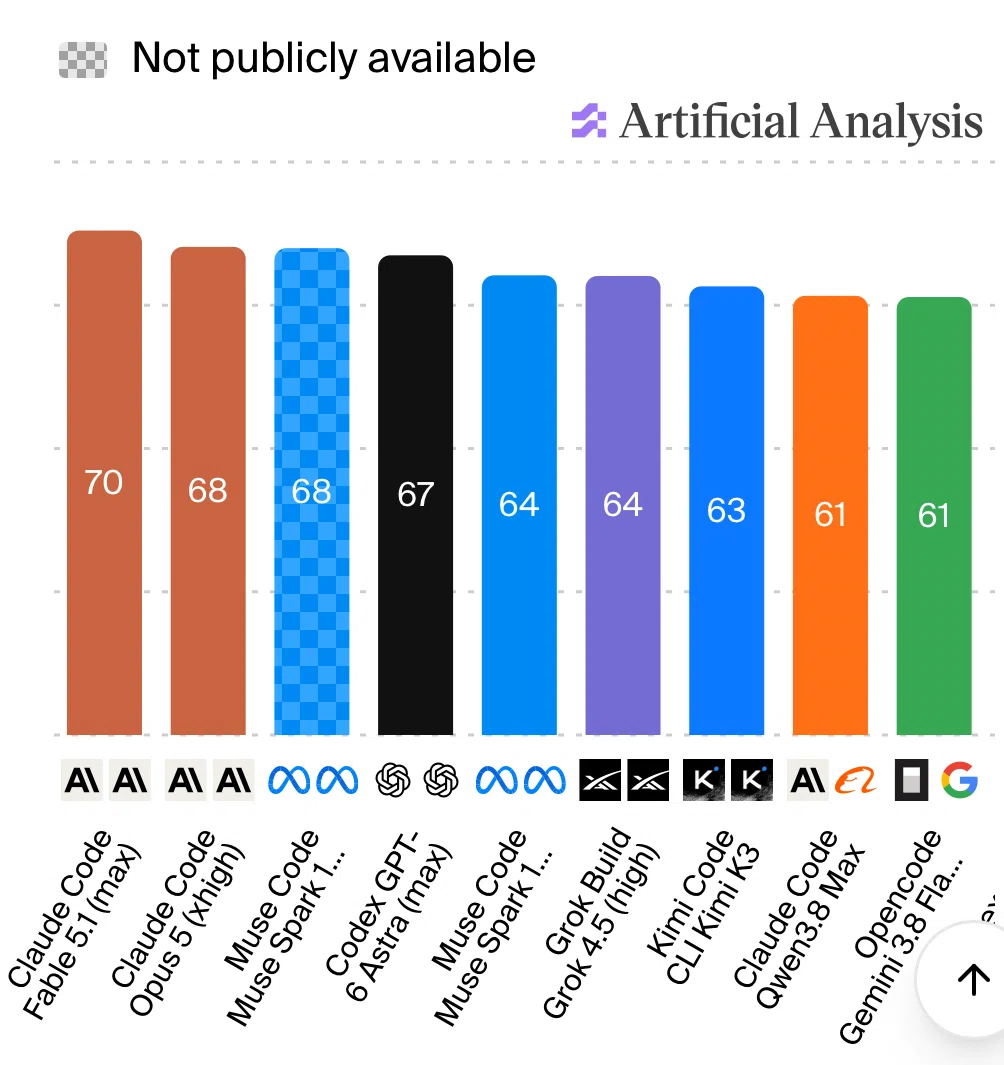
そして価格はSolの2.5倍($4 / $20→$10 / $50)。コーディングではトークン効率が70%改善し、Codexハーネスなら3分の1のトークンで済むと報告されています。ただし知能タスクでは出力トークンが約10%減っただけです。値上げを差し引けば、タスクあたりのコストはむしろ75%増になります。
ハルシネーション率が最大推論時に92%から51%へ下がり、正答率が4ポイント上がった点は、実務的にはかなり大きいと私は見ます。
ここまでを踏まえた私の見立ては単純です。「チャットの賢さ」を買いたい人には、少し高い。同じ$10 / $50でFable 5.1が買えます。
逆に、コンピュータを操作させたい人、100万トークンの文脈を持ち越したい人、サイバー防御を自動化したい人には、現時点で代わるものがない。OSWorld 2.0が72.6%、BenchCADが95.9%という数字は、チャット窓の外側で働かせる用途に向けて置かれたものです。
「AGI時代」という言葉について
私は8月に「AGIは日付では来ない」という趣旨の記事を書きました。今も撤回する気はありません。
AGIかどうかを決めるのは点数ではなく、委任だと考えているからです。人間の確認をどこで外すか。その線をどこまで動かせるか。その一点しか、実務的には意味を持ちません。
その軸で見ると、Astraは奇妙な進み方をしています。委任の条件のうち「実績」——スコープを守る、嘘をつかない、注入攻撃に乗らない——は、数字の上で大きく改善しました。ところが、「なぜそう振る舞ったのかを点検する手段」のほうは減っています。信頼を預ける根拠が理由から結果へ移った。それが今回の実質だと私は読みます。
最後に、外れたら私の負けという賭けを一つ置いておきます。次のフロンティアモデルのSystem Cardで、「CoTの監視可能性が回復した」と書かれることはないでしょう。代わりに、行動レベルの監視指標が前面に出てくるはずです。
今回すでに、CoT監視の精度が落ち、アクションのみの監視の精度が上がるという交代が起きています。業界は、思考を読むのをあきらめて、行動を見る方向へ舵を切りつつある——そう見ています。この予想が外れて、監視可能性が正面から回復されるなら、それは素直に朗報です。
「AGI時代へようこそ」より正確な言い方があるとすれば、たぶんこうなります。
結果だけを見て信じるかどうかを決める時代へようこそ。
※本記事の情報は2026年9月4日時点のものです。Astraは段階的に展開中で、一般提供後に実測値や評価が変わる可能性があります。
主な出典
🔹GPT-6 Astra: A new generation of intelligence(OpenAI公式、2026-09-03)
🔹GPT-6 Astra System Card(OpenAI Deployment Safety Hub、2026-09-03)
🔹GPT-6 Astra Model(OpenAI APIドキュメント)
🔹OpenAI’s GPT-6 Astra on ARC-AGI-3(ARC Prize、2026-09-03)
🔹Benchmarking GPT-6 Astra(Artificial Analysis、2026-09-03)
🔹OpenAI releases new model GPT-6 Astra, says it may represent AGI(Axios、2026-09-03)
🔹Hot take on GPT-6 Astra(Gary Marcus、2026-09-03)
🔹GPT-6 Astra(Simon Willison、2026-09-03)
【追記 2026年9月4日】訂正
「プロバイダ・アダプタ・ハーネスはAstra以前からあり、System CardのCoT監視可能性とは別の話ではないか」との指摘を受け、確認しました。そのとおりです。
ハーネスの正体はResponses APIの汎用設定(推論項目の持ち越しと圧縮)で、2026年7月29日の導入。GPT-5.6 Solでも使われ、7.8%→38.3%の押し上げが確認されています。
ハーネスの不透明さは「評価者から見えない」という配管の話、System Cardの監視しにくさは「見ても読めない」という認知の話で、別物です。本文の「同じ一つの変化の表裏」は踏み込みすぎでした。訂正します。
なお、数字と「行動は良くなった。でも、思考は見えなくなった」というポイントは、System Card単独でも成立する話です。
ご指摘に感謝します。
