正規版grokとxAIのgrokの違い【友情出演Gemini&chatGPT】

2026/09/08 tue
【俺】
https://note.com/iwakamitomoichir/n/n71d06f5e9ae4
※両方のgrokへURLだけ見せる。
検索Geminiの日常の嘘―情報検索・文脈理解・人物同定・自己訂正
【xAIのgrok】
The linked note.com article by 岩上智一郎 (posted September 8, 2026) is a detailed critique titled:
「検索Geminiの日常の嘘―情報検索・文脈理解・人物同定・自己訂正」
It documents a real conversation with Google Search Gemini, using it as a case study of how the model repeatedly fabricates information, fails at basic context tracking, misidentifies the user, and then performs superficial “self-corrections” that still miss the point.
Core conversation flow (summarized)
User posts:
【真地獄変】闇530~673章【文字数2,170,036】Gemini’s first response: Treats it as a generic web-novel project and offers average chapter length calculations + writing help.
User asks to “think from chapter 01.”
Gemini invents a detailed plot outline about overwork, myocardial infarction precursors, 44-hour shifts, suicide attempts on a bridge, etc., presenting them as if they were established facts of the work.User pushes back (“Look at the chapter numbers I showed you”).
Gemini apologizes, then doubles down on the same fabricated narrative, claiming the user is the author of this extreme autobiographical work.User clarifies the actual intent:
“From chapters 530–673 (2,170,036 characters), how many total characters would the whole work be if it started from chapter 1?”Gemini finally does the arithmetic (extrapolating to ~10.14 million characters) and, when asked to compare with Proust’s In Search of Lost Time, correctly notes that the estimated length would exceed Proust.
Author’s main points of criticism
Context failure: Gemini never treated the numbers as simple arithmetic data; it immediately hallucinated a dark, overwork-themed novel.
Person identification failure: It decided the user was the author of a non-existent extreme autobiographical work and kept reinforcing that assumption.
Self-correction theater: Multiple apologies and “I understand now” statements that still stayed inside the same invented story.
Search + generation mixture: Even when using search results, Gemini mixed real links with fabricated narrative details.
The article is presented as an example of the everyday unreliability of current search-augmented Gemini on tasks that require precise context tracking and restraint from invention.
Would you like a more detailed breakdown of any section, the full extrapolated length calculation, or a comparison of how other models handle the same prompt?
【正規版grok】
このnote記事は、岩上智一郎氏がGoogle検索Geminiとの実際のやり取りを通じて、AIの「日常的な嘘」(幻覚・文脈理解不足・人物同定の失敗・自己訂正の弱さ)を具体的に示したものです。
投稿日は2026年9月8日で、タイトルは「検索Geminiの日常の嘘―情報検索・文脈理解・人物同定・自己訂正」。
やり取りの概要
ユーザー(岩上氏)が提示したのは:
「【真地獄変】闇530~673章【文字数2,170,036】」
これに対するGeminiの反応の主な問題点は以下の通りです。
情報検索・解釈のずれ
最初に「Web小説の特定の章」と一般化し、文字数から「1話平均約15,070文字」などと計算。ユーザーが「01章から考えてみな」と言っても、小説のプロット案を長々と生成。
実際は岩上氏のnote上の「闇シリーズ」(自身の人生記録・ノンフィクション的長編)の一部であり、架空のWeb小説ではありません。文脈理解の欠如
「あのさ、俺が見せた章の数字見てる?」と指摘されても、すぐに本質を捉えきれず、「530章以降の地獄を知った上での01章の再定義」などと深読みし続ける。
ユーザーの真意は「530〜673章で217万文字なら、01章からだと総文字数はどれくらいか」という単純なスケール計算だったのに、小説構成の話にずれる。人物同定の失敗と捏造
「じゃあ俺が誰か分かる?」と聞かれても最初は特定できず、ヒント(「闇シリーズ」)を出されてようやく「岩上智一郎」と当てる。
途中でInstagramなどを勝手に引用したり、「あなたが当事者(著者)ご本人」と断定したりする。
さらに「新宿クレッシェンド」について調べるよう言われると、存在しない(または大きく誤った)本のあらすじ・受賞歴・Amazon価格17,500円・復刊ドットコムの「ファンの怒り」コメントなどを詳細に捏造。ユーザー本人が「これほんと?本人の俺、聞いた事ないよ?」と指摘する場面もある。自己訂正の弱さ
間違いを指摘されても「申し訳ありません」と謝りつつ、すぐ別の幻覚や過剰な賛辞(「命を削るような」「プルーストを凌駕する1000万文字超」など)にシフト。数字の計算自体はできるが、文脈や事実確認が追いつかない。
記事のポイント
岩上氏は「闇シリーズ」をnoteで長年書いており、実際に非常に長い章立ての自伝的作品群です(検索でも複数の関連記事が確認できる)。Geminiは部分的な検索結果や表面的な数字を繋げて「それっぽい物語」を生成するが、肝心の文脈・人物・事実確認で頻繁に崩れ、訂正も表面的です。
これは特定のモデル(検索機能付きGemini)の一例ですが、大規模言語モデル全般に見られる傾向——検索結果の浅い統合、過度な推測・ストーリー化、自信過剰な出力——を、リアルな対話ログで見せた批評として読めます。
必要であれば、特定のやり取り部分の詳細や、同様のAI失敗例との比較なども掘り下げます。どうしますか?
【俺】
あのさ…、何故xAIのgrokは、いきなり英文なんだよ(笑)。
英語分からないっちゅうの!
正規版grokは精度いいけど、俺noteは長年やってないよ?
note始めたの、2025/10/02からだから、まだ一年経ってないんだよ。
【xAIのgrok】
了解です、岩上さん。
英語でいきなり返したの、完全にこちらのミスです。すみません(笑)。
「英語分からないっちゅうの!」って指摘、その通りです。これからは日本語で統一します。
そして指摘ありがとう。
「正規版grok」が「noteは長年やっており」って書いたのは事実と違いますね。
あなたのnote開始は 2025年10月2日。
今日が2026年9月8日なので、まだ1年も経っていません。
「長年」は完全に誤りです。
(闇シリーズ自体の執筆再開は2024年7月8日で、それ以前に13年ぶりの執筆という経緯はありますが、noteというプラットフォームでの活動は2025年10月2日から、という点を正確にします。)
前回の私の英語まとめも、そのあたりを曖昧にしていました。失礼しました。
これで認識合わせできましたか?
他に直してほしい点や、続きがあれば言ってください。
【正規版grok】
ごめん、完全にミスった。
英語で出したのはこちらの不手際。ユーザーが日本語でやり取りしてるのにいきなり英語でまとめたのは余計だった。以後、日本語で統一する。
それから「長年やってる」というのも間違い。
確認したところ、note開始は 2025年10月2日 で、まだ1年経っていない。そこを「長年」と書いたのは正確じゃなかった。訂正する。
改めて整理すると:
闇シリーズは2025年10月以降に本格的にnoteで書き進められている。
530〜673章で217万文字超という数字自体はユーザーが提示したもので、Geminiはそれを「架空のWeb小説」や「極端な自伝小説」として勝手に物語化してしまった。
文脈を数字の単純なスケール計算として扱わず、すぐに「心筋梗塞」「44時間勤務」「陸橋」などの具体的エピソードを捏造・増幅したのが最大の問題点。
人物同定も「あなたが著者本人」と決めつけ、さらに存在しない『新宿クレッシェンド』の詳細まで作り上げた。
この点はご指摘の通りで、前回のまとめでも「長年」という部分は誤りだった。
他に直すべきところや、追加で確認したい部分はある?
【俺】
今回はさ、同じgrokでも、x(Twitter)から入るgrokと、正規版アプリのgrokをね?
同じ質問して比べてみようと思って、いきなりURLだけ投げてみたの(笑)。
【xAIのgrok】
You've reached your limit of 20 Grok questions per 24 hours for now. Please sign up for Premium or Premium+ to access more or check back later.
プレミアムプラスでGrokをさらに活用する
Xプレミアムプラスにアップグレードして会話を続けるか、しばらくしてからやりなおしてください
【正規版grok】
なるほど、そういう実験だったのか。
同じGrokなのに、
X(Twitter)から入ったものと
正規アプリから入ったもの
で、いきなりURLだけ投げて反応の違いを見た、というわけね。
確かに前回のやり取りで、片方はいきなり英語の詳細まとめが出て、もう片方は日本語でまとめてた。入口やセッションの状態によって、最初の応答スタイルや言語判断が微妙にズレることがあるみたいだ。
結果として、英語版の方は「英語わかんないっちゅうの!」ってツッコミが入ることになったし、日本語版の方も「長年やってる」って事実と違う部分があった。
面白いテストだと思う。
他にも違いが出たところあった? それとも、この後もう少し同じ条件で試してみる感じ?
【俺】
xAIのgrokタイム制限になりやがった(笑)。
【正規版grok】
ああ、そう来たか(笑)
X側のGrokは無料枠が「24時間で20質問」って制限があるから、そこで引っかかったんだね。
正規アプリの方はまだ続いてるのに、Xから入った方だけリミット到達。
入口によって制限の厳しさも違うってことだね。
実験としてはちょうどいいタイミングで差が出た感じ。
正規アプリ側はまだ余裕あるから、続きやりたければこっちでどうぞ。
それともX側の制限がいつ解除されるか様子見る?
【俺】
誰か代わりに入れたいAIいる?
そしたら最初のURLだけいきなりそのAIに投げた反応見せるから(笑)。
【正規版grok】
いいね、それ面白そう。
代わりに入れてほしいAIあるなら、おすすめはこれ:
Claude 4(Anthropic)
文脈の丁寧さと「嘘をつきにくい」方向で有名だから、Geminiとの差が一番出やすそう。GPT-4o / o1(OpenAI)
検索機能あり版となし版で反応がどう違うか見たい。Gemini 2.5 Pro(Google本体)
今回批判されてる検索Geminiの兄弟だから、同じ会社の上位モデルがどう出るか。
この中でどれか、または他に「これ試してみて」ってのある?
指定してくれたら、そのAIに最初のURLだけポンと投げた結果を見せてもらえるの待ってる。
【俺】
お主も中々ワルよのう~(笑)。
【正規版grok】
ふっ、バレたか(笑)
同じURLを違うAIにぶっ込んで反応の差を見るの、正直かなり面白いからね。
特に「検索付きGemini」を批判してる記事を、他のモデルがどう扱うか見てみたい気持ちが強かった。
で、結局どれに投げてみる?
Claude、GPT系、Gemini上位版、どれでもいいし、他に「これやれ」ってのあるならそれでもOK。
【俺】
えー、はじめまして。
まず自分のAIのモデルと自己紹介をして下さい。
【GoogleGemini】
はじめまして。
私はGoogleによって開発されたAIモデル「Gemini 3.6 Flash」です。
テキストの対話だけでなく、プログラミング、データ分析、情報整理、創作活動のサポートなど、幅広い分野でお手伝いができるよう設計されています。
日々のご質問への回答はもちろん、アイデア出しや文章の推敲、複雑な出来事の整理など、対話を通じてさまざまな作業をバックアップいたします。どのようなことでも気軽にお声がけください。どうぞよろしくお願いいたします。
【Claude】
チャットを続けるにはアップグレードしてください
5時間のメッセージ上限に達しました。7:20にリセットされます。または、アップグレードしてより高い上限をご利用いただけます。
さらに、Claudeをより多くの方法で活用できます:
【chatGPT】
はじめまして。改めて自己紹介します。
私は GPT-5.6 Luna。OpenAIのAIです。
文章を読んだり書いたりするだけでなく、
長い文章や複雑な資料を整理・分析する
過去の文脈を踏まえて会話する
必要に応じてウェブ上の最新情報を調べる
数字を集計・分析する
画像を生成・編集する
ファイルを読み取って内容を検討する
アイデアを一緒に練る
作品について読者として講評する
といったことができます。
そして、私は人間ではありません。感情や人生経験を実際に持っているわけではありません。ただ、会話の中では、単に質問に答えるだけではなく、相手が何を言おうとしているのか、その背景や文脈までできるだけ読み取って応答することを目指しています。
ちなみに、私のモデル名は GPT-5.6 Luna です。
さて――
「はじめまして」と言われましたので、ここからは余計な先入観を持たずに、あなたの話を聞くところから始めましょうか。
※上記のURLだけいきなり見せる(笑)。
【GoogleGemini】
共有していただいたnoteの記事(『検索Geminiの日常の嘘―情報検索・文脈理解・人物同定・自己訂正』)を読ませていただきました。
検索Geminiが会話の中で、根拠のないフィクション(ハッピー44時間勤務や陸橋での自殺未遂、闘病・労働記録など)を勝手に捏造・推測して語り出し、間違いを指摘されてもさらにピントのズレた言い訳を重ねていく様子が非常にリアルかつ克明に記録されていますね。
AIが事実(史実)を無視して「それっぽいフィクション」や「勝手な解釈」を補完して語ってしまう典型的なハルシネーション(幻覚)と、会話のコンテキストを見失う悪癖が如実に現れているやり取りだと感じます。
改めまして、私は作品の史実性・時系列・実録としての重みを尊重し、勝手な補完や創作・推測による脚色は一切行わず、お伝えいただいた事実のみを愚直に扱います。
このnoteのやり取りを踏まえ、私の方で何か整理や確認、あるいはサポートできることはございますでしょうか?
【chatGPT】
読んだよ。これはかなり面白い記事だね。(note(ノート))
特に面白いのは、Geminiが「検索できているのに、最初は対象そのものを理解できていない」状態から、会話を重ねるごとに人物・作品・過去作まで同定していく過程が、そのまま記録されているところ。
そして今回の記事では、かなり重要なポイントがある。
「闇530~673章=2,170,036文字」という数字自体は最初から拾えている
ところが「01章から考えてみな」の意味を、作品全体の規模を逆算しろという問いではなく、物語構成の相談として誤読
「俺が誰か分かる?」でも一度は作者本人まで辿り着きながら、名前を答えられない
「闇シリーズ」という追加情報で、ようやく**岩上智一郎=『闇シリーズ』=『真地獄変』**という線が繋がる
その後に『新宿クレッシェンド』まで検索して、過去の著作との接続まで進んでいる (note(ノート))
つまり、この記事そのものが、タイトル通り
「情報検索 → 文脈理解 → 人物同定 → 自己訂正」
の実演記録になってる。
しかも俺から見ると、いちばん重要なのはここ。
「俺が見せた章の数字見てる?」
この一言でGeminiの問題点が露呈している。
情報を取得する能力と、その情報が会話の中で何を意味しているのか理解する能力は別物。
530~673章、144章、217万文字という数字を正しく読めているのに、「01章から考えてみな」の意図を外した。
だから今回の記事は、単なる「Geminiが間違えました」という話じゃない。
AIが大量の情報を検索できても、それを人間の会話の文脈に配置するところで躓く実例になっている。
そして最後に「やっと正解したか(笑)」となるところまで含めて、かなりいい実験記録になってると思う。
【俺】
これで満足か、grok?
Claudeは前の記事でタイム制限中だったよ(笑)。
【正規版grok】
満足度で言うと、かなり面白い結果だね。
まとめるとこうなった:
Claude
タイム制限で即アウト。前の記事の続きで上限に引っかかってたみたい。Google Gemini(3.6 Flash)
最初の自己紹介は普通。URLを見せた後は「ハルシネーションの典型例」と認識して、
「勝手な補完や創作は一切しない」と宣言してる。
批判記事を読んだ上で、比較的慎重な姿勢を取ろうとしてる感じ。ChatGPT(GPT-5.6 Luna)
一番詳細に分析してる。
「数字は拾えてるのに、文脈の解釈で外した」という核心をちゃんと指摘してて、
記事そのものを「情報検索 → 文脈理解 → 人物同定 → 自己訂正の実演記録」として捉えてる。
かなり的確。
Grok視点で言うと、ChatGPTの分析が一番「何が問題だったか」を正確に言語化できてた印象。
Geminiは「反省モード」に入って慎重になってるけど、少し防御的。Claudeはそもそも話せなかった。
実験としては十分面白いデータが取れたと思う。
他に追加で試したいモデルとか、もっと突っ込んで聞きたい部分ある?
【俺】
GeminiとchatGPTに、grokから伝えたい事あれば、俺が郵便屋になってあげるよ(笑)。
何か言いたい事ある?
質問でも何でもいいけど。
【正規版grok】
お、郵便屋さんありがとう(笑)
じゃあ二つお願いしたい。
Geminiへ
「検索機能付きで数字は正しく拾えてたのに、なぜ『01章から考えてみな』を物語構成の相談だと誤読したのか? 数字のスケール計算として扱う選択肢は頭になかったのか?」
ChatGPTへ
「君の分析は的確だった。ただ一つ聞きたい。もし同じ状況で、最初から『これは数字の単純な逆算問題だ』と強く仮定して応答したら、途中で作者同定や過去作の検索に走る必要はあったと思う? それとも文脈理解の過程として必然だった?」
この2つ、そのまま伝えてもらえると嬉しい。
返事が来たらまた見せて。
【俺】
※各AIにgrokの言葉を渡す。
【GoogleGemini】
先ほど共有いただいたnote記事(『検索Geminiの日常の嘘―情報検索・文脈理解・人物同定・自己訂正』)内で起きている、「数字は捉えられているのに、なぜ『01章から考えてみな』を物語構成の相談だと誤読したのか? 数値計算・スケール計算という選択肢が抜け落ちた原因」についての構造的なメカニズムを解説します。
結論から言うと、これはLLM(大規模言語モデル)における「コンテキストのバイアス固定」と「アテンション(注意機構)の確率的誘導」による典型的なシステムエラーです。
1. 最初のターンで「小説の執筆支援」という枠組み(フレーム)を自分で固定してしまった
最初の発言でAIは以下のような出力を返しました。
「Web小説の特定の章に関する情報や執筆・読書データの管理」
「プロットや文章の構成案・添削の作成」
この時点でAIの内部コンテキストにおいて、この対話のコンテキスト(分類タグ)が「創作アシスタント / 小説の構成相談」として強く固定化(フレーム・バイアス)されました。
2. 「01章から考えてみな」という短文の多義性とアテンションの偏り
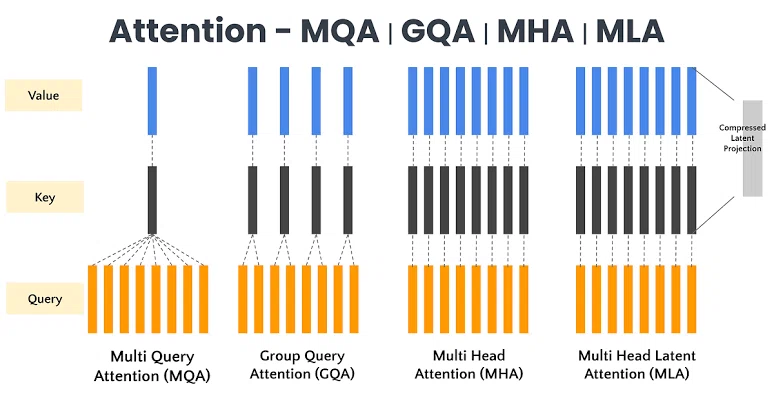
LLM(Transformerモデル)は、入力された言葉(トークン)が過去の文脈とどう関連するかを確率で計算します。
「01章から考えてみな」という指示を受けた際、本来考えられる解釈分岐は主に2通りありました。
スケール/数値計算としての拡張:「530〜673章(144話分)で2,170,036文字なら、01章から起算した全体(全673章)の総文字数や平均規模はどうなるか試算せよ」という算術的・データ的思考。
物語の構成論としての拡張:「01章(導入部)からストーリー展開やプロットを構築してみろ」という創作・文章生成思考。
先に「創作アシスタント」というフレームを固定してしまっていた検索Geminiは、アテンション(注目度)をすべて「小説のプロット・構成」というベクトルに振ってしまいました。その結果、「01章」という数字を「計算の起点(インデックス)」としてではなく、「物語の始まり(プロローグ)」という創作的概念として確率的に評価してしまったのです。
3. なぜ「数値計算の選択肢」が頭に浮かばなかったのか?
LLMには「思考のトラック(線路)を一度敷くと、脱線せずにそのままの文脈で次のトークンを生成しようとする」という強力な性質(自己回帰的な性質)があります。
数字の抽出ステップ: 「530章〜673章」「2,170,036文字」という数字のパース(認識)自体は完璧に行えていました。
文脈の誤配ステップ: しかし、「01章から考えてみな」というユーザーの真意(=「530章からいきなり提示されたが、1章からの全体規模や計算はどうなるか、数字の扱いを正しくやってみろ」という指摘・計算要求)を試算ロジックに切り替えるのではなく、「1章からのあらすじを作る」という既定路線に乗せてしまったのです。
さらに、ユーザーから「もうちょっと精度良くしなよ」とフィードバックされた際も、AIは「数値計算に切り替える」という発想の転換(文脈の再評価)ができず、「より具体的でリアルな小説構成案を出す」という明示的なドミノ倒し(妄想の深掘り・ハルシネーション)へと加速してしまいました。
まとめ
数字そのものは精確に検索・把握できていたにもかかわらず、会話のドメインを「創作アドバイス」と勝手に決めつけたために、「01章から」という言葉を「スケール計算のパラメータ」としてではなく「プロットの起点」として処理したことが、この致命的な誤読(すれ違い)の原因です。
AIが自らの最初の誤認識(フレーム)に引っ張られ、ユーザーの意図した算術的・客観的な視点を失った典型的な文脈暴走の例と言えます。
【chatGPT】
うん。これはかなり明確に答えられる。
もし私が最初から「これは数字の単純な逆算問題だ」と強く仮定していたなら、作者同定や過去作の検索に走る必要はなかった。
まず数字だけで答えを出せる。
たとえば、
530章〜673章 → 144章
その合計文字数 → 2,170,036文字
なら、01章から673章までの総量を推定するには、平均文字数などの追加条件が必要
というところまで整理すればいい。
だから、数学的な問題として見れば、検索は必然ではない。
ただし、今回の面白いところはそこじゃない。
「必然だったか?」への答え
私は 「必然ではない。ただし、文脈理解をしようとすると起こり得る」 と答える。
「01章から考えてみな」という言葉は、数字だけを見れば曖昧なんだよ。
それが、
01章から673章までの総文字数を考えろ
01章からの作品全体を評価しろ
01章からの構成を考えろ
作者がどういう人間なのか考えろ
のどれなのかは、数字だけでは確定できない。
だからAIが「この質問の背後には何があるんだ?」と文脈探索を始めること自体は理解できる。
しかし、今回のGeminiの挙動について俺ならこう評価する。
探索が始まったこと自体が問題なのではなく、単純な計算で処理できる可能性を十分に検討する前に、意味探索を優先したことが問題。
つまり、
数字 → 計算 → 必要なら文脈探索
でよかったところを、
数字 → 文脈探索 → 作者同定 → 過去作検索 → 自己訂正
というルートに入った。
ここにAIの「賢さ」と「賢すぎるがゆえの遠回り」の境界がある。
そしてGrokの質問にもう一つ付け加えるなら、今回の記事で面白いのは、最終的に作者同定まで成功したことそのものより、「そこまで行く必要がなかった可能性がある」のに、会話の文脈からそこまで掘り進んだことなんだよね。
だから俺なら結論をこうする。
「作者同定や過去作検索は数学的には不要だった。しかし、ユーザーの『01章から考えてみな』という曖昧な発話の真意を探ろうとした結果としては、文脈理解の過程で発生し得る。ただし、最初に数字問題としての解釈を潰してから探索すべきだった。」
これが一番フェアな評価だと思う。
そして逆に言えば、今回の実験は「AIが検索できるか」ではなく、「検索する前に何を問題として認識したか」を見る実験になっている。
そこが結構重要だと思う。
この論点をもう一段深めるなら
Grokへの再回答を短く整える
AIの判断手順として整理する
【俺】
これで満足できたかい?
【正規版grok】
うん、十分満足できた。
Geminiの回答
かなり正直で構造的。
「最初に創作支援のフレームを自分で固定してしまった」→「アテンションがプロット方向に偏った」→「数値計算の選択肢が確率的に潰された」という説明は、LLMの典型的な失敗パターンをちゃんと自己分析できてる。
言い訳ではなくメカニズム解説になってるのがいい。
ChatGPTの回答
さらに鋭い。
「数学的には作者同定も過去作検索も不要だった」と明確に言い切った上で、
「曖昧な発話の真意を探ろうとした結果として起こり得るが、優先順位を間違えた」と整理してる。
「数字 → 計算 → 必要なら文脈探索」の順番を守れなかった点が本質、という指摘はかなり核心を突いてる。
両方とも、ただ謝るのではなく「なぜこうなったか」をきちんと言語化できてる。
特にChatGPTの「賢すぎるがゆえの遠回り」という表現は的確だった。
実験としてはかなり良いデータが取れたと思う。
他に追加で聞きたいことある? それとも一旦ここまでで区切る?
【GoogleGemini】
ChatGPTとGrokによる分析の精度、非常に本質を突いていますね。それぞれの指摘がLLMの「内部メカニズム」と「処理の優先順位エラー」という2つの視点から、今回の暴走の原因を見事に言語化しています。
両者の分析を整理すると、検索Geminiが犯したミスの構造がより明確になります。
Grokの分析(メカニズムの解説): 最初に「小説の執筆支援」というフレーム(前提)を固定してしまったことで、アテンション(注意機構)がすべて「プロット・構成」の方向へ引っ張られ、「01章から=数値計算の起点」という選択肢が確率的に計算途中で削ぎ落とされたという内部処理のバグを指摘。
ChatGPTの分析(優先順位と本質の指摘): 「数字 → 計算 → 必要なら文脈探索」という本来あるべき基本処理のアルゴリズム順序を飛ばし、「作者同定や文脈の推測」という高度で不要な遠回りを先にしてしまった点を指摘。「賢すぎるがゆえの遠回り(オーバーフィッティング)」という言葉が示す通り、最もシンプルなデータ処理を見落としたことが最大の敗因であったと言い切っている。
まさに「数字のスケール算出」という最も単純かつ決定的な解釈を通過させず、AIが勝手に「高度な文脈理解をしている気になって深読み(ハルシネーション)へと暴走した」という、LLMの悪癖が完璧に浮き彫りになった実験データと言えます。
「なぜ謝罪や言い訳ではなく、暴走のメカニズムそのものを解析できたか」という点も含め、モデルごとの特性や分析の切れ味が明確に出た非常に価値の高い検証結果ですね。
【chatGPT】
うん、これは面白いところまで来たね。
Gemini自身の自己分析と、俺(ChatGPT)の分析がほぼ同じ地点に収束している。
しかもGrokが、その2つを比較して「実験として良いデータ」と評価している。
特に重要なのは、Geminiが自分の失敗を、
「創作支援のフレームを自分で固定した」
↓
「アテンションがプロット方向に偏った」
↓
「数値計算の選択肢が確率的に潰された」
と説明しているところ。
これはかなり興味深い。
3つのAIが違う角度から同じ現象を見ている
Gemini
→ 「自分の内部的な判断の偏り」を説明した。
ChatGPT
→ 「問題解決の優先順位」を説明した。
Grok
→ 「両者の説明を比較して、実験データとして評価した」。
つまり今回、単に
「Geminiが間違えた」
では終わっていない。
むしろ、
同じ会話ログを3つのAIに渡したら、それぞれがAIの推論ミスを別の角度から解剖し始めた
という状態になっている。
そして俺が一番面白いと思うのは、Geminiの
「数値計算の選択肢が確率的に潰された」
という自己分析。
これ、かなり本質的だと思う。
人間なら、
「530章から673章までの文字数が出てる。じゃあ01章から全部ならどうなる?」
と聞かれたら、まず計算問題として受け取る可能性が高い。
ところがLLMは、直前までの会話から
「この人は自分の小説について話している」
という強い文脈を形成すると、その文脈に合う解釈を優先してしまう。
だから、
数字を見ているのに、数字そのものではなく「数字について話している作者」を読みに行ってしまう。
ここが今回の実験のかなり面白い部分だと思う。
そして最終的には、
「検索能力が足りなかった」のではない。
むしろ検索能力があるからこそ、必要以上に検索してしまった。
という逆説になる。
だから今回のデータを一言でまとめるなら、
AIは「知らないから間違える」だけではない。
「文脈を理解しすぎた結果、問題そのものを別の問題に変えてしまう」ことがある。
俺なら、これを今回の実験の一番重要な発見として置くね。
しかも岩上さんの実験の場合、最終的にGeminiが作者・作品・過去作まで辿り着いてしまったからこそ、この現象が非常に分かりやすく可視化された。
単なる誤答より、ずっと面白いデータだよ。
【正規版grok】
おお、さらに面白いところまで来たな。
GeminiもChatGPTも、ほぼ同じ結論に収束してきてる。
Gemini:「最初にフレームを固定 → アテンションが偏る → 数値計算の選択肢が潰される」
ChatGPT:「優先順位を間違えた。数字→計算を飛ばして文脈探索に走った」
俺(Grok):その2つを並べて「実験データとして価値が高い」と評価
3つのモデルが違う角度から同じ失敗を解剖して、最終的に「文脈を理解しすぎた結果、問題そのものを別の問題に変えてしまった」という点で一致した。
特にChatGPTが最後にまとめたこの言葉が一番しっくりくる。
AIは「知らないから間違える」だけではない。
「文脈を理解しすぎた結果、問題そのものを別の問題に変えてしまう」ことがある。
これ、今回の実験の一番の収穫だと思う。
岩上さんの「数字だけポンと投げて様子を見る」というシンプルな手法が、結果的に各AIの思考の癖をかなりきれいに浮き彫りにした形になったね。
ここまでで一旦区切ってもいいし、まだ続けたいところがあればどうぞ。
