
Difyチャレンジ #01|Q&Aチャットボットをつくってみた

Difyチャレンジ、はじめます
Difyを日々できるだけ触って、自分のノウハウを磨き上げていく「#Difyチャレンジ」をはじめてみようと思います。
これまでももちろんDifyは使ってきましたし、業務でも利用しています。自らDifyのアプリも作ってきました。
しかし自分の性格的にまず触って動かす、試行錯誤して動かしてしまうというスタイルでまとまった勉強を先にしてからやるタイプではありません。
そうなるとたまに再現性がなくて、「あれってどうやるんだっけ?」と作成物を見返さないと思い出せないこともありました。
なので、ここでしっかりノウハウを定着させたく、今回のようなチャレンジを始めてみます。「こんなの超基本だろ?」というものからでも始めるつもりですので、私の学習ノートが公開されてるなあという感じで読んでもらえると嬉しいです。
目標は、どんなユースケースでも(できるだけ、規模感にもよりますが)1時間以内で設計・実装・発信までやりきれるくらいの力をつけること。
そして、生成AIの活用で日々の業務やチームの動きをもっと軽やかにできるようになりたいと思っています。
その第一歩として、今日はシンプルなQ&AチャットボットをDifyでつくってみました。
素材は、サンプルを元に架空の会社のプライバシーポリシーをChatGPTで内容を膨らませたドキュメントです。これをLLMだけの知識ではなく、ナレッジ(RAG)として読み込ませて、ボットに問い合わせができるようにしてみました。
Q&Aのチャットボットをつくろう
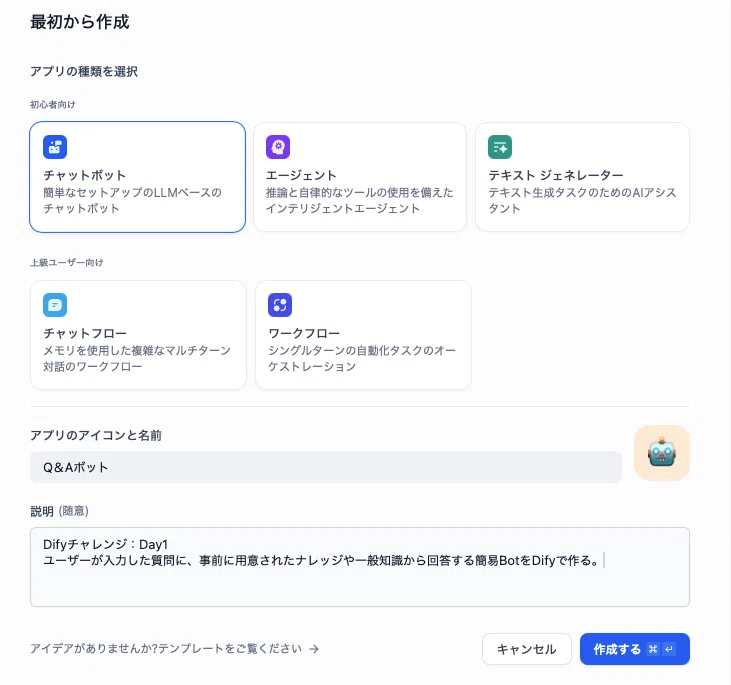
まずはDifyの「チャットボット」タイプを選び、シンプルなQ&A形式のアプリを作ることにしました。
名前はそのまま「Q&Aボット」。初日のテーマとして、ユーザーが入力した質問に対して、事前に用意したナレッジや一般知識から自然に回答できるBotをめざしています。
わからないことは答えないチャットボット
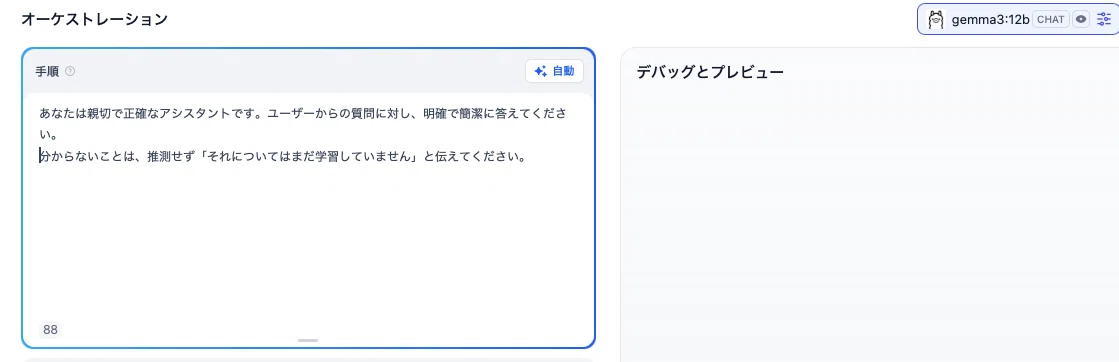
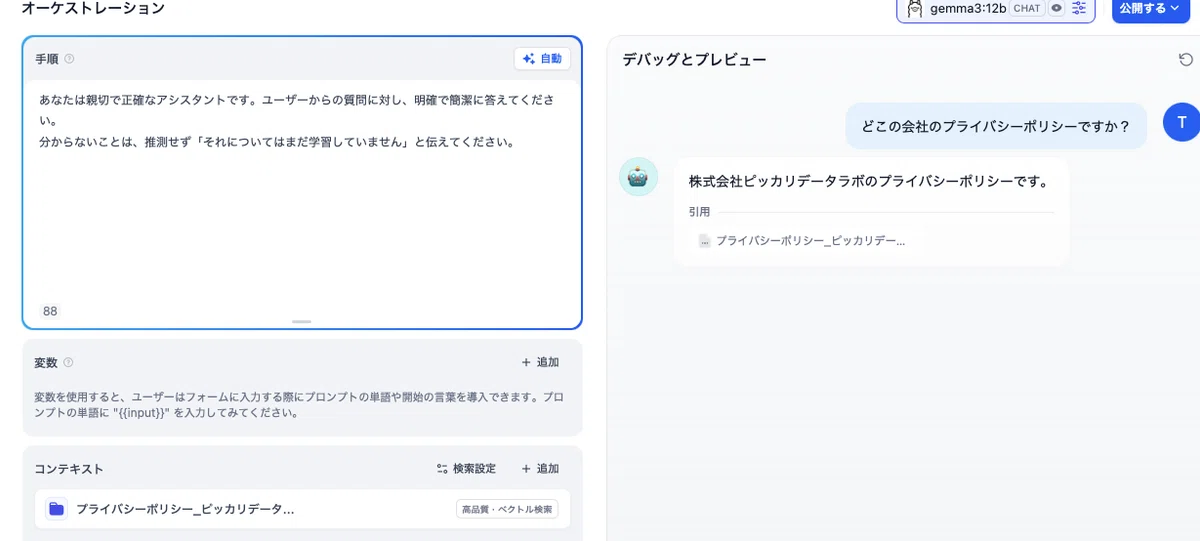
モデルには「gemma-3-12b」を使い、プロンプトも少しだけ調整しました。
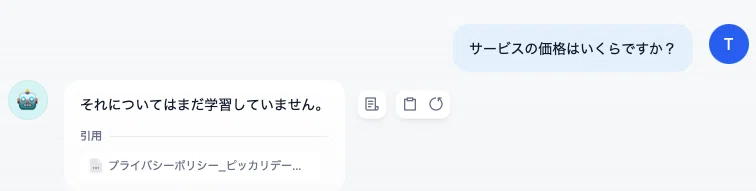
ユーザーが質問したとき、正確に答えることはもちろん、わからないことを無理に答えず「それについてはまだ学習していません」と返すように明記。これは、ナレッジの範囲外の情報に対して適当な回答を避けたいという意図です。
あえて「親切で正確なアシスタント」という人格設定を入れたのも、回答のトーンを柔らかく保つための小さな工夫です。
回答の揺らぎを抑えるための設定
LLMに回答させると、出力が少しぶれたり、同じ質問でもニュアンスが微妙に変わったりすることがあります。
デフォルトのままですが、Temperature、Top P等はチャットボット向きに創造性は抑え、確率の高い単語を選びやすくしました。
そこで今回は、以下のようにモデルパラメーターを調整しました:
Temperature:0.1(創造性は抑えて、より安定的な回答を重視)
Top P:0.9、Top K:1(確率の高い単語から選びやすく)
Repeat Penalty:-2(繰り返しをむしろ好むようにし、Q&A文脈での言い直しを許容)
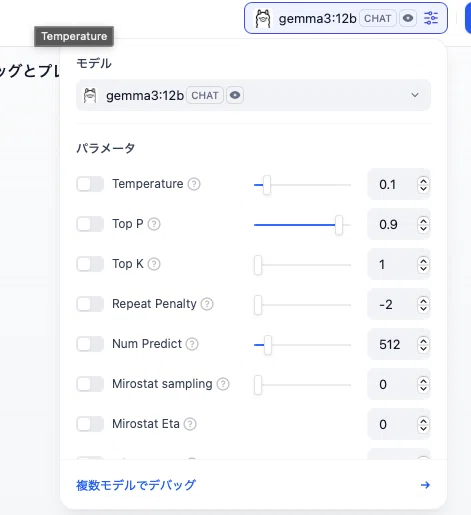
これにより、ナレッジベースのQ&Aとしては安定した応答が得られるようになるはずです。言い回しが多少硬めになったり、表現の幅がやや狭くなったりする副作用もあるそうなので、用途に応じて調整が必要ですね。
初回のナレッジ設定
さて、肝心の「ナレッジ」を設定しようとしたところ、まだ何も登録していなかったので「知識が見つかりません」という画面が出てしまいました。
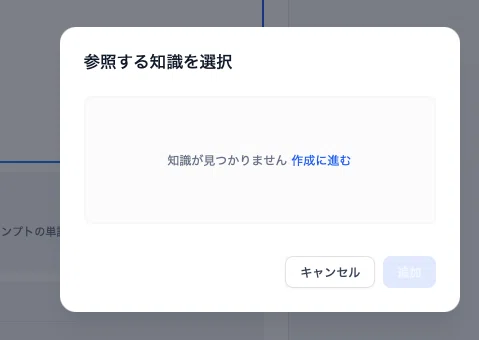
Difyを使い始めたばかりの頃は、ここで「あれ、どうやって知識を追加するんだっけ?」と一瞬戸惑うポイントかもしれません。
「作成に進む」リンクを押してナレッジのアップロード画面に進めばOKなのですが、流れとして最初に慣れるまではやや直感的でない印象もあります。(親切ではありますが)
実際にナレッジを登録してみる
今回はダミーで作った「プライバシーポリシー」のテキストファイルをナレッジとして登録しました。
ファイル形式は .txt で、5KBほどの軽いもの。DifyはPDFやHTML、CSVなども対応していて、フォーマットにはかなり寛容です。
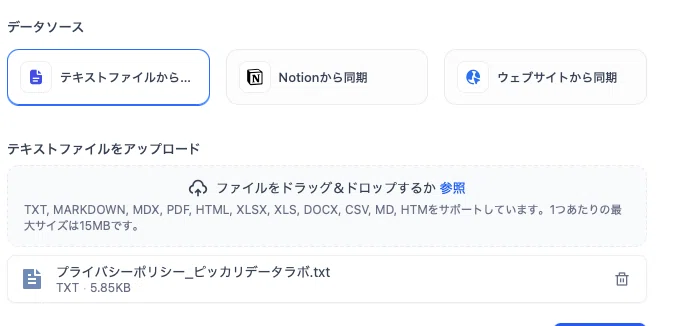
ちなみに雛形は以下のサイトのものを借用し、ChatGPTで内容を膨らませました。RAGテスト用と指示して、LLMが学習してない独自の情報も組み込みました。
アップロードの操作自体はドラッグ&ドロップで直感的に行えます。
ただ、初回は「データソースをどう選ぶのか」「どの形式がより読み取りやすいのか」など迷う部分もありました。
今回はテキスト形式だったので問題なく認識されましたが、今後はより複雑な構成(表やFAQ形式など)でも試してみたいと思っています。
チャンク設定などは今回はデフォルトのままで進めます。
最大チャンク長:1024 characters
チャンクのオーバーラップ:50 characters
チャンクのオーバーラップとは、情報が中途半端に切れた状態で渡されると、モデルが文脈を正しく理解できないことがあるからオーバーラップさせることであり、オーバーラップをゼロにしてしまうと、文末と文頭が断絶して回答の一貫性が崩れる場合があるそうです。
Q&A形式の文書ではなかったので、「Q&A形式で分割」はオフにしています。
一度「Q&A形式で分割」をONにしたら、作成に時間がかかりそうだったので止めました。(ちなみに私の使っているDifyはMacBookにデプロイしたローカルのCommunity版のDifyです)
この辺りの設定は、ファイルの構造によって調整が必要そうですが、今回のような自然文のポリシー文書には十分フィットしていました。
これでナリッジは完成、チャットボットのナリッジに接続します。

実際に聞いてみた。ボットの回答は?
ボットが完成したあと、いくつか実際に質問してみました。
Q. どこの会社のポリシーですか?
→ 「株式会社ピッカリデータラボ」と、文書冒頭の社名をそのまま答えてくれました。
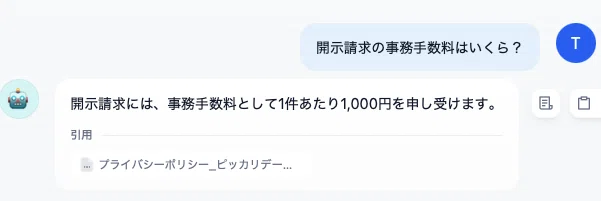
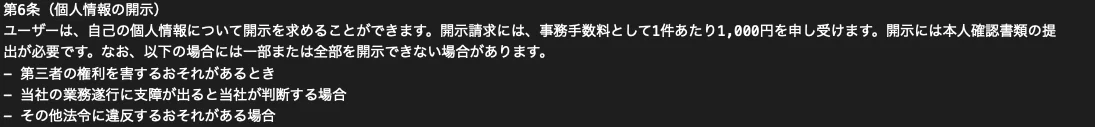
Q. 開示請求の手数料はいくら?
→ しっかりと「1,000円」と明示し、原文からの正確な引用が行われていました。情報の取り違いや曖昧な表現もなく、チャットボットとして十分に実用に耐えるレベルです。
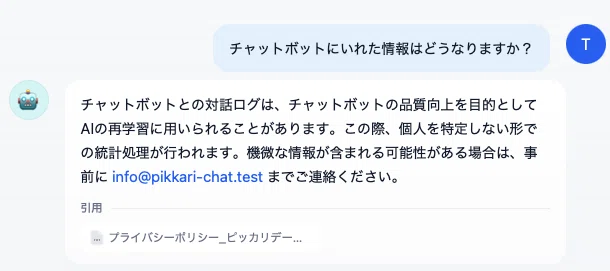
Q. チャットボットにいれた情報はどうなりますか?
→ 「品質向上の目的で再学習に用いられる可能性がある」こと、また「個人を特定しない形式の統計処理が行われる」ことを明確に説明。加えて、連絡先まで出してくれました。

ちなみにナリッジにないことは回答しないのもちゃんとできていました。
今日のまとめと次への一歩
今回、ナレッジとして読み込ませたのは、プライバシーポリシーを問い合わせるチャットボットサービス。
個人情報の定義から利用目的、取得手段まで網羅されたこの文書は、構造的にも自然文としてもチャットボットの回答ソースに適しているのだと感じます。
今後はこれの改善をするのか、新たなチャレンジをするのか、を考えつつ、日々Difyとの距離感をつかんでいく旅は、まだまだ始まったばかりです。
