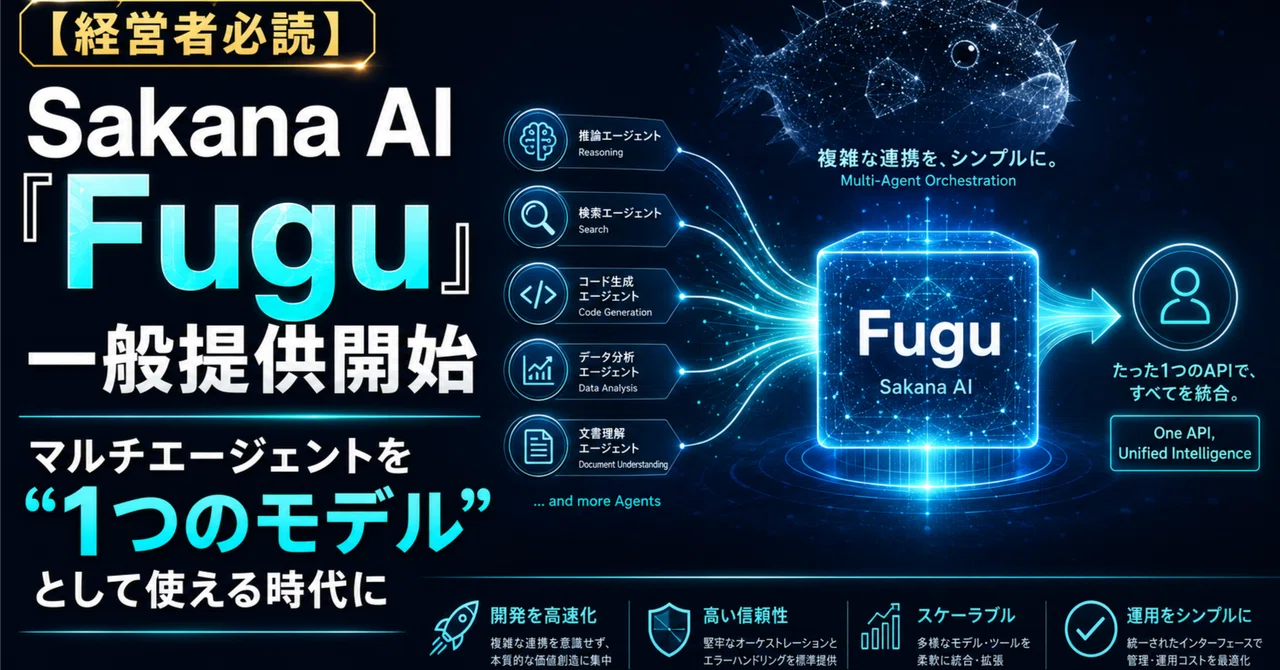
【経営者必読】Sakana AI「Fugu」一般提供開始 — マルチエージェントを"1つのモデル"として使える時代に、日本のB2B経営者が今四半期に決めるべき5つの戦略判断

「複数のAIモデルを束ねた"マルチエージェント"を、自社で組み立てることなく、APIキーを1つ差し替えるだけで使えるようになった」
これは構想ではありません。2026年6月22日、日本のAIスタートアップ Sakana AI が、フラッグシップ商用製品「Sakana Fugu(サカナ・フグ)」を一般提供開始したという「現在の事実」です。
Sakana AI の公式発表によれば、Fugu は「マルチエージェントのオーケストレーションシステムを、1つの基盤モデルとして提供する」プロダクトです。ユーザーは単一のAPI(OpenAI互換)に投げるだけ。あとは Fugu が、単独モデルで解けるなら解き、複雑なら専門モデルのチームを編成・連携させる。「外からは1つのモデル、内側では協調するエキスパート群が働いている」——これが Fugu の正体です。
そして上位版「Fugu Ultra」は、エンジニアリング・科学・推論の厳しいベンチマークで、Anthropic の Fable 5 や Mythos Preview といった最先端モデルと「肩を並べる(shoulder-to-shoulder)」と主張されています。しかも、輸出規制のリスクを負わずに、です。
本記事は、この発表を「すごいニュース」で終わらせず、日本のB2B経営者が今四半期に何を判断すべきかまで落とし込みます。同時に、launch 直後から噴出している懐疑論——「結局はプレミアムなモデルルーターでは?」——も正面から扱います。経営判断には、マーケティングと実態の両方が要るからです。
いま何が起きているのか — 3行サマリー
製品: Sakana AI が「マルチエージェントを1つのモデルAPIとして提供する」Fugu / Fugu Ultra を一般提供開始(2026/6/22)。OpenAI互換APIにつなぎ替えるだけで利用可能。
主張: Fugu Ultra はフロンティアモデル級の性能を、特定ベンダー依存や輸出規制リスクなしに提供。背後のモデル群(Opus/GPT/Gemini級)は柔軟に入れ替え可能。
論点: 性能ベンチマークは「検証困難(ベンダー自己申告・モデルプール非公開)」、コストとレイテンシは重く、「真のAI主権ではなく依存先を1段隠しただけ」との批判も強い。過度な期待も過度な無視も誤りで、自社タスクでの実測が必須。
Sakana Fugu とは何か — 5つの重要事実
事実1: 「マルチエージェント」を自前で組まずに、1つのモデルとして呼べる
最大のポイントはここです。これまでマルチエージェントを使うには、LangChain や CrewAI などで「どのモデルが誰を呼ぶか」のグラフを自分で配線する必要がありました。Fugu の賭けは、その"協調の仕方"そのものを学習させてしまうという発想です。
ユーザーは1つのエンドポイントにリクエストを送るだけ。Fugu が内部で、モデルの選択・委譲・検証・統合をすべて管理します。マルチエージェントの複雑さが、利用者のコードに一切及ばない。あるアナリストの表現を借りれば、「ゲートウェイはリクエストを"モデル"に振り分けるが、Fugu は"プロセス"を選ぶ」。ここが従来のモデルルーターとの本質的な違いだと、Sakana 側は位置づけています。
事実2: 「Fugu」と「Fugu Ultra」— 用途で選ぶ2層構成
提供は2モデルです。いずれも単一のOpenAI互換APIから利用できます。
Fugu: 高い性能と低レイテンシのバランス型。日常業務のデフォルト。Codex のようなコーディング/コードレビュー、チャットボット等のインタラクティブ用途に自然に組み込める。データ・プライバシー・コンプライアンス要件があるチームは、特定のエージェントをプールから除外できる。
Fugu Ultra(fugu-ultra-20260615): 困難な多段階問題で回答品質を最大化。AIリサーチ、論文再現、サイバーセキュリティ分析、文献・特許調査など、精度と深さが要る重い業務向け。
経営者がまず理解すべきは、「Ultra=常に上位互換」ではない、という点(後述の事実4)。
事実3: 学習されたオーケストレーション(TRINITY と Conductor)
Fugu は思いつきの寄せ集めではなく、Sakana の研究基盤の上にあります。ICLR 2026 採択の2論文がベースです。
TRINITY: 約0.6Bパラメータの小さな"指揮者"。CMA-ES(進化計算)で進化させ、はるかに大きなワーカーモデル群に Thinker / Worker / Verifier の役割を割り当てる。
Conductor: 7BモデルをRL(強化学習)で訓練し、自然言語での協調戦略を獲得。自分自身を再帰的に呼び出し、テスト時の計算量をスケールできる。
要は「指揮者は小さく、重い仕事は差し替え可能なフロンティアモデル群に委譲する」構造です。創業陣も本物で、**Llion Jones(Transformer 論文の共著者)、David Ha(元 Stability、Google Brain)**が率いています。「集合知=魚群(school of fish)」という Sakana 創業来の思想とも一貫しています。
事実4: ベンチマーク「肩を並べる」の中身 — 検証が構造的に難しい
ここは経営者が冷静になるべきところです。発表は「Fable や Mythos に匹敵」とうたい、公式ページはより慎重に「肩を並べる(shoulder-to-shoulder)」と表現します。そしてそれは"ベンチマークごと"の話であって、総合での話ではない。
懐疑論者が指摘する弱点は具体的です。
名指しした相手と直接対決していない: Fable 5 と Mythos Preview は米国の輸出規制で一般提供が止まっており、Sakana は各社の"公表値"と比較。独立検証では、Fable 5 は SWE-Bench Pro で約86.0、Fugu Ultra は73.7という内訳も指摘される。勝ち負けはベンチマークごとに入れ替わる。
モデルプールがブラックボックス: 「どのモデルを選び、どう協調させたか」はクエリ単位では一切開示されない(仕様上)。監査も再現も帰属もできない。
自社の表でも階層が揺らぐ: 安価な Fugu が上位の Fugu Ultra を SciCode(60.1 vs 58.7)や τ³ Banking(21.7 vs 20.6)で上回る箇所がある。「難しい問題は Ultra」という売り文句と並べると奇妙に映る。
結論として、たとえ全数値が正直でも、外部からは構造的に検証できない。「ベンダーの主張」として扱い、誰かが再現するまで割り引くのが妥当です。なお Sakana は過去、AI Scientist で「実験の42%がコーディングエラーで失敗」等の指摘を受けた前科もあり、非公開プール+自己申告ベースラインは"性善説"では受け取れません。
事実5: 価格と提供形態 — サブスク3層+従量、ただし"重い"
コンソール(console.sakana.ai)からAPIキーを取得して利用します。価格は以下。
サブスクリプション: 月額 $20 / $100 / $200(全ティアで両モデル利用可)
従量課金(pay-as-you-go): 重い用途・エンタープライズ向け
Fugu Ultra のトークン単価: 100万トークンあたり 入力$5 / 出力$30 / キャッシュ$0.50。272Kコンテキスト超で単価が倍。
重い Fugu Ultra タスクは1メッセージ約$10に達することも。
2026年7月末までに加入すれば2ヶ月目無料。
一方、辛口の声も実在します。「$200/月で実質 週3時間未満、APIは非常に遅く、出力品質は Fable には遠く及ばない。日常の主力としては全く使えない」。コストとレイテンシは"重い"前提で評価すべきです。
なぜ"オーケストレーションモデル"が次のフロンティアなのか
Sakana の主張の根っこを押さえておくと、Fugu の狙いが見えます。経営者にとっては、特定製品の成否よりこの潮流のほうが重要です。
背景1: スケールの限界。この数年のAIの進歩は、巨大な一枚岩モデルを、より大量のデータで学習させる力業が牽引してきました。しかし現実の難タスクは、単一モデルの一回の呼び出しでは最良の結果になりにくい。どのモデルを使い、いつ委譲し、途中をどう検証し、弱点を避けて強みを組み合わせるか——最先端の能力は、こうした"判断の積み重ね"から引き出される、というのが Sakana の見立てです。
背景2: 地政学的な必然。単一ベンダー依存は、いまや技術論というより経営・地政学リスクです。重要インフラ・金融・行政を一社のAPIで動かすことは、規制や輸出管理が変われば一夜で前提が崩れる弱点になる。実際、Anthropic の Fable 5 / Mythos に輸出規制が及び、アクセス条件が動きました。集合知(複数モデルの協調)は、この集中リスクへの現実的なヘッジになる、というのが Fugu の核心的な売り文句です。
背景3: 自前マルチエージェントの"運用疲れ"。多くの企業が LangChain や CrewAI でエージェントを組んでみたものの、設計・保守・検証の重さに直面しています。Fugu は「協調そのものを学習済みの製品」として提供し、その負担を肩代わりすると主張します。
この3つが重なって、「マルチエージェント=自分で配線するパターン」から「買えるプリミティブ(部品)」へという移行が始まった。Fugu はその最初の本格的な商用例の1つ、という位置づけです。経営者が今四半期に押さえるべきは、Fuguを使うか否か以前に、この移行が自社の調達・ガバナンス・競争優位にどう効くかです。
AI活用の事業構造はどう変わるか
Before(2025年まで)の「複数モデル活用」
モデルごとに個別契約・個別API・個別の癖を運用が吸収。
マルチエージェントを使いたければ、社内で LangChain 等でオーケストレーションを"自前配線"。設計・保守・検証の負荷は自社持ち。
ベンダー1社のAPIに重要ワークフローを載せると、規制・輸出管理・価格改定で一夜にして前提が変わるリスクを丸抱え。
After(2026年〜)の選択肢
マルチエージェントが"部品(プリミティブ)"として買える。自前でグラフを組まずに、1つのAPIで集合知を呼び出す。
背後のモデルは差し替え可能。あるプロバイダーが止めても、オーケストレーターが動的に迂回——というのが Sakana の売り。
ただし After にも落とし穴がある。依存先が"単一エンドポイント+非公開プール"に移っただけで、その内側はやはり米国系フロンティアモデル(Opus/GPT/Gemini級)。「単一ベンダー依存を別の単一ベンダー依存に置き換えただけでは?」という批判は、経営判断として無視できません。
つまり構造変化の本質は「マルチエージェントの民主化」と「依存リスクの再配置」が同時に起きること。便利さと不透明さがトレードオフになっています。
初期ユーザーの評価 — 賛否は明確に割れている
約500名のベータ参加者と、launch直後の反応を見ると、評価ははっきり割れています。経営判断には、両方を知っておく必要があります。
肯定的な声
「コードレビューでは Fugu Ultra は GPT-5.5 より明らかに上。他ツールが3件しか指摘しない場面で、20件以上のバグを洗い出した。今は全レビューをこれに通している」(ソフトウェアエンジニア)
「素の出力品質はトップクラスのフロンティアモデルと同等。加えて、長時間セッションでもペルソナが安定し、他モデルが崩れる場面でもキャラクターを保った。エージェント製品では、これは生のベンチマークスコア以上に重要」(エンタープライズ向けプラットフォーム企業の経営層)
「範囲を絞った1つの指示だけで、情報収集→XSS/SQLi検査→認証レビュー→証拠付きレポート作成まで、セキュリティ評価を一気通貫でこなした。指定範囲を逸脱せず、破壊的操作も避けた」(サイバーセキュリティエンジニア)
データ分析をほぼ自動で進めた、というAutoResearch用途の報告もあり、"長く入り組んだ多段階タスク"でこそ光るというのが共通項です。「1プロンプトの良し悪し」ではなく、「読む→実装→テスト→証拠比較→不足の洗い出し→最終レポート」という長い行程を着実に前進させる点に価値がある、と Sakana 自身も位置づけています。
否定的・懐疑的な声
「$200/月で実質 週3時間未満。APIは非常に遅く、出力品質はテストした限り Fable には遠く及ばない。日常の主力としては全く使えない」
launch当日の Substack や Hacker News のトップでも、最頻の反応は「良いマーケティングの付いた、プレミアムなモデルルーター」に近いものでした。オーケストレーションのオーバーヘッド(レイテンシ・レート制限・コスト)は実在し、単一フロンティアモデルに対する品質優位は"まだ自明ではない"という評価です。
ただし全員が否定的なわけではありません。「速いコーディングモデルの横に Fugu Ultra を"アドバイザー"として併用し、本番に投入できた」という肯定的なベータユーザーもいました。用途次第で評価が大きく振れる——これが現時点の正直な状況です。経営としては、この振れ幅こそが「自社タスクでのブラインド実測が必須」という結論を裏づけます。横並びの評判ではなく、自社の代表業務で測るしかありません。
日本のB2B経営者が今四半期に決めるべき5つの戦略判断
判断1: 「AIベンダー依存」のリスク設計をやり直すか
輸出規制で Anthropic の Fable 5 / Mythos へのアクセス条件が動いた事実(Anthropic発表)は、「重要業務を一社APIに載せる」リスクが仮定ではなくなったことを示します。Fugu はこのリスクへの"ヘッジ"を売りにします。自社の重要ワークフローが特定ベンダーに何割依存しているかを、今四半期に棚卸しすべきです。
判断2: 「AI主権(sovereignty)」をどう評価するか — resilience ≠ independence
ここは思考停止が一番危ない論点です。Fugu は確かに回復力(resilience)を高めます。1つのモデルが止まっても迂回できる。しかし独立(independence)とは別物です。Fugu のプールは見たところ依然として米国管理下のフロンティアモデルで、規制対象の Fable / Mythos には(非公開ゆえ)そもそもルーティングできない。「日本発だからAI主権」と短絡せず、"何からの独立"なのかを定義してから評価してください。
判断3: 「ブラックボックス」をどこまで許容できるか
規制業種(金融・医療・公共・法務)では、「どのモデルが自社データに触れたか」を説明・監査できないこと自体がリスクです。Fugu はクエリ単位の内訳を開示しません。一般的なコーディング支援なら割り切れても、機微情報や説明責任が伴う領域では、Fugu の「特定エージェントをプールから除外」機能や、そもそも採否を、コンプラ部門と今四半期に詰める必要があります。
判断4: 「コスト構造」を従量・レイテンシ込みで見るか
オーケストレーションは複数モデル呼び出しの積み上げで、レイテンシとコストが複利的に膨らむ。重いタスクは1メッセージ$10級、272K超で単価倍。「便利そう」で全社展開すると、従量課金が青天井になり得ます。PoCは必ず自社の代表タスクで実コスト・実速度を計測してから。
判断5: 「ベンダーの主張」をどう扱う運用にするか
Fugu の性能主張は構造的に外部検証が難しい。これを機に、AI調達の意思決定ルールとして「ベンチマーク値は参考、採否は自社タスクのブラインド実測で決める」を明文化すべきです。これは Fugu に限らず、今後のAI調達すべてに効きます。
経営層が今四半期に取るべき4つの戦略決断
決断1: 「AIベンダー依存マップ」を作成する
どの業務が、どのモデル/ベンダーに、どれだけ依存しているか。止まったら何が起きるか。1枚にする。Fugu採用の是非より、この地図がないこと自体が経営リスクです。
決断2: 「オーケストレーション評価PoC」枠を設ける
Fugu/Fugu Ultra を、自社の代表的な"長く入り組んだ業務"(例: コードレビュー、調査レポート、データ分析、セキュリティ点検)で2〜4週間試す。比較対象は単一フロンティアモデル1本。**「1プロンプトの良さ」ではなく「多段階での着実な前進」**を評価軸にする(Fugu の真価はそこにあると Sakana も主張)。
決断3: 「ガバナンス/監査要件」を先に決める
PoC前に、扱ってよいデータ区分、ログ要件、説明責任の線引きを決める。非公開プールに機微データを通さない運用を技術的に担保(エージェント除外設定・データ区分)。
決断4: 「評価基準=自社実測」を全社ルール化する
ベンダー発表のベンチマークで意思決定しない。ブラインド・自社タスク・コスト/レイテンシ込みで測る。Fugu の launch は、この規律を全社に入れる絶好の口実です。
B2B経営者として(情シス/CTOに任せず)自分で確認しておくべき5観点
観点1: 法務 — データの行き先と説明責任
「どのモデルが自社データを処理したか」を開示できない構造で、自社の契約・規制・顧客約款に抵触しないか。海外モデルへのデータ越境、機微情報の扱いを法務と確認。
観点2: 財務 — 従量課金の上限設計
サブスク$20〜$200に加え、重い用途は従量で膨らむ。部門ごとの上限・アラート・予算枠を最初に設計しないと、月次で驚くことになる。
観点3: 組織 — AI調達の意思決定権限
「魅力的なベンチマーク」で現場が独自契約を増やす前に、調達の意思決定フロー(誰が試し、誰が承認するか)を整える。Fugu は"つなぎ替えるだけ"で導入できる手軽さゆえ、無秩序な乱立を招きやすい。
観点4: リスク — 新たな単一障害点
「複数ベンダー依存の解消」を狙ったはずが、Fuguという単一エンドポイントへの依存に化ける逆説。Fugu自体が止まったら/値上げしたら、を想定する。冗長化(単一モデルへのフォールバック)を残す。
観点5: 戦略 — "オーケストレーションが製品カテゴリ化"する意味
マーケを差し引いても、本件で確かなのは1つ。オーケストレーションが「自前で配線するパターン」から「買える製品カテゴリ」へ移行し始めたことです。学習された指揮者が役割を割り当て、自分で計算量をスケールする——これは静的なエージェントグラフの次の段階。この方向性は、特定launchの成否とは別に、注視に値します。
業界別影響度マップ
SaaS / 開発組織(影響度: 大): コードレビュー・自動調査・エージェント製品の"中身"として有力。ただしレイテンシ/コスト/監査性が採否を分ける。まずレビュー用途でPoC。
金融 / 保険(影響度: 中〜大だが要慎重): 多段階の調査・分析に魅力。一方で「どのモデルが触ったか不明」は規制・監査と衝突しやすい。エージェント除外・データ区分が前提。
製造 / 研究開発(影響度: 中): 論文再現・機械設計・特許調査など"長く入り組んだ"探索に親和。実測でROIを見極め。
コンサル / 専門サービス(影響度: 中): リサーチ生産性に効く可能性。出力の検証責任は人間側に残る前提で。
一般B2B(非IT中心)(影響度: 小〜中): 直接導入より、自社が使うSaaSの裏側に Fugu型オーケストレーションが入ってくる流れを把握しておく。
経営者の想定Q&A
Q1: 「結局、OpenRouter のようなモデルルーターと何が違うの?」
ルーターは「どのモデルに振るか」を選ぶ。Fugu は「どういうプロセスで解くか(誰に計画させ、誰に実行させ、誰に検証させるか)」を学習した指揮者が決める、というのが主張です。ただし「実態は高機能ルーター+良いマーケ」という辛口評価も多く、差を体感できるかは自社タスク次第。PoCで確認を。
Q2: 「日本発だから、米国モデルの規制リスクを回避できる?」
半分正しく、半分は誤解です。1モデルが止まっても迂回できる回復力は上がる。しかしプールの中身は依然として米国系フロンティアモデルで、規制対象そのもの(Fable/Mythos)には繋げない。**"依存先を1段隠した"**に近い面があります。
Q3: 「ベンチマークでフロンティア級なら、乗り換えていい?」
非公開プール+自己申告ベースラインで、外部検証が構造的に困難です。ベンチマークは参考に留め、自社タスクのブラインド実測(品質・速度・コスト)で判断してください。
Q4: 「コストはどれくらい見ておけば?」
サブスク$20/$100/$200に加え、Fugu Ultra は100万トークンで入力$5・出力$30、272K超で倍、重いタスクは1メッセージ$10級。従量の上限設計を最初に。
Q5: 「セキュリティやコンプラ部門は何を気にする?」
「どのモデルが、どの順で、自社データに触れたか」をクエリ単位で開示しない点。監査・説明責任が要る業務では、エージェント除外設定やデータ区分、そもそも採否を先に詰める必要があります。
Q6: 「最大のリスクは何ですか?」
ブラックボックスへの依存です。便利さと引き換えに、内部で何が動いているかを見る・監査する・制御する力を手放す。日常コーディングなら妥当な取引でも、説明責任が伴う領域ではブラックボックスそのものが問題になります。
Q7: 「結局、最大の教訓は?」
「マルチエージェント=自前で作るもの」から「買える製品カテゴリ」へ移り始めたこと。Fugu単体の成否はともかく、この潮流は本物です。自社のAI調達を「ベンダー主張で決めない/自社実測で決める」体制に作り替える契機にしてください。
まとめ — 「マルチエージェントが製品になる」時代の経営者の責任
Sakana Fugu は、マルチエージェントのオーケストレーションを"1つのモデルAPI"として民主化した、注目すべきプロダクトです。学習された指揮者が役割を割り当て、計算量を自らスケールする方向性は、静的なエージェントグラフの次の段階を指し示します。
同時に、本件は**「ベンダーの主張をそのまま信じない」経営規律の試金石**でもあります。非公開プール、自己申告ベンチマーク、重いコストとレイテンシ、そして「回復力≠独立」というAI主権の誤読しやすさ。過度な期待も、過度な無視も、どちらも経営判断としては失格です。
「AIで何ができるか」の議論は終わりました。これからは「どのAIに、何を、どこまで依存し、どう監査・代替可能にしておくか」を経営者が設計する時代です。Sakana Fugu の登場は、その問いを日本のB2B経営者に突きつけています。
経営者として、今四半期中に着手すべき5つの行動
AIベンダー依存マップを作る(どの業務が・どのモデルに・どれだけ依存し・止まったら何が起きるか)。
Fugu/Fugu Ultra を自社の代表タスクでPoC(比較は単一フロンティアモデル、評価軸は"多段階での前進"・実コスト・実速度)。
ガバナンス/監査要件を先に決める(データ区分・エージェント除外・説明責任の線引き)。
AI調達ルールを"自社実測で決める"へ明文化(ベンダーのベンチマークでは決めない)。
冗長化を残す(Fuguという新たな単一エンドポイントへの集中を避け、フォールバックを用意)。
「ウチの重要業務は、いまどのAIベンダーに何割依存していて、それが一夜で止まったら何が起きますか?」
この問いに即答できなければ、それが今四半期の最優先課題です。
一次ソース
Sakana AI(公式): Sakana Fugu — One Model to Command Them All(リリース, 2026/6/22)
paddo.dev: A Multi-Agent System Sold as a Model — Sakana's Fugu(賛否を含む分析)
#経営者向け #SakanaAI #Fugu #マルチエージェント #AIエージェント #生成AI #AI戦略 #ベンダーロックイン #AI主権 #B2B経営 #DX戦略 #AIガバナンス #LLM #日本のAI
