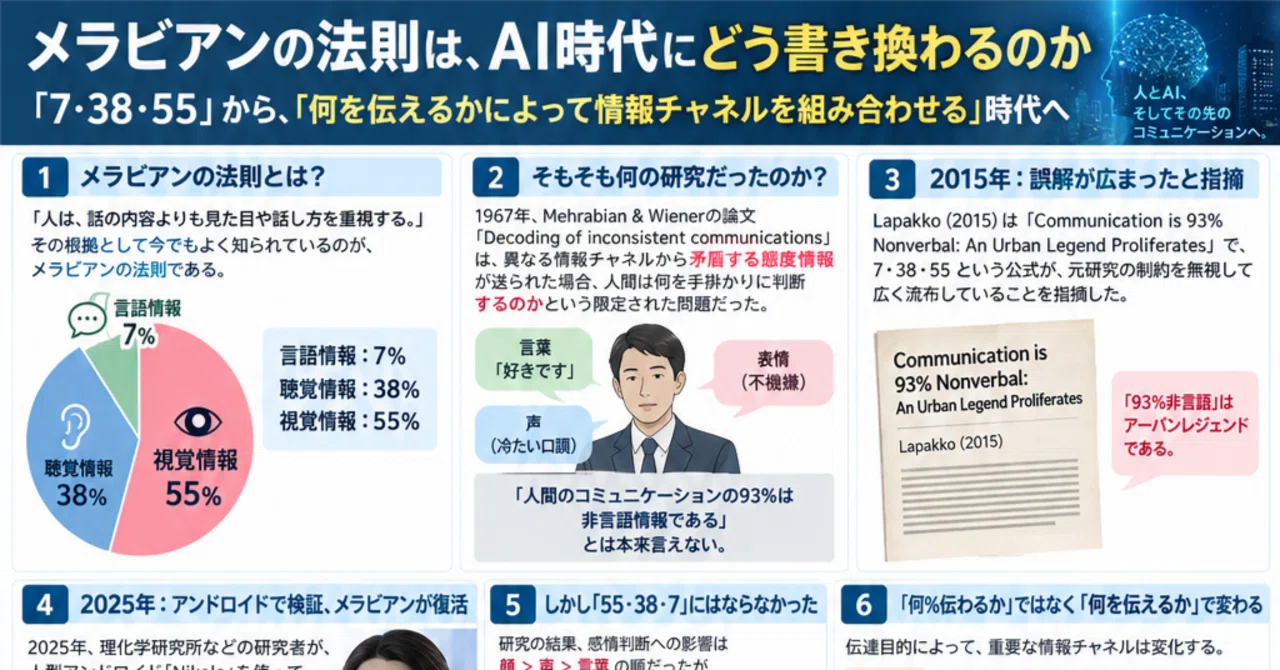
メラビアンの法則は、AI時代にどう書き換わるのか「7・38・55」から、「何を伝えるかによって情報チャネルを組み合わせる」時代へ

メラビアンの法則は、AI時代にどう書き換わるのか
「7・38・55」から、「何を伝えるかによって情報チャネルを組み合わせる」時代へ
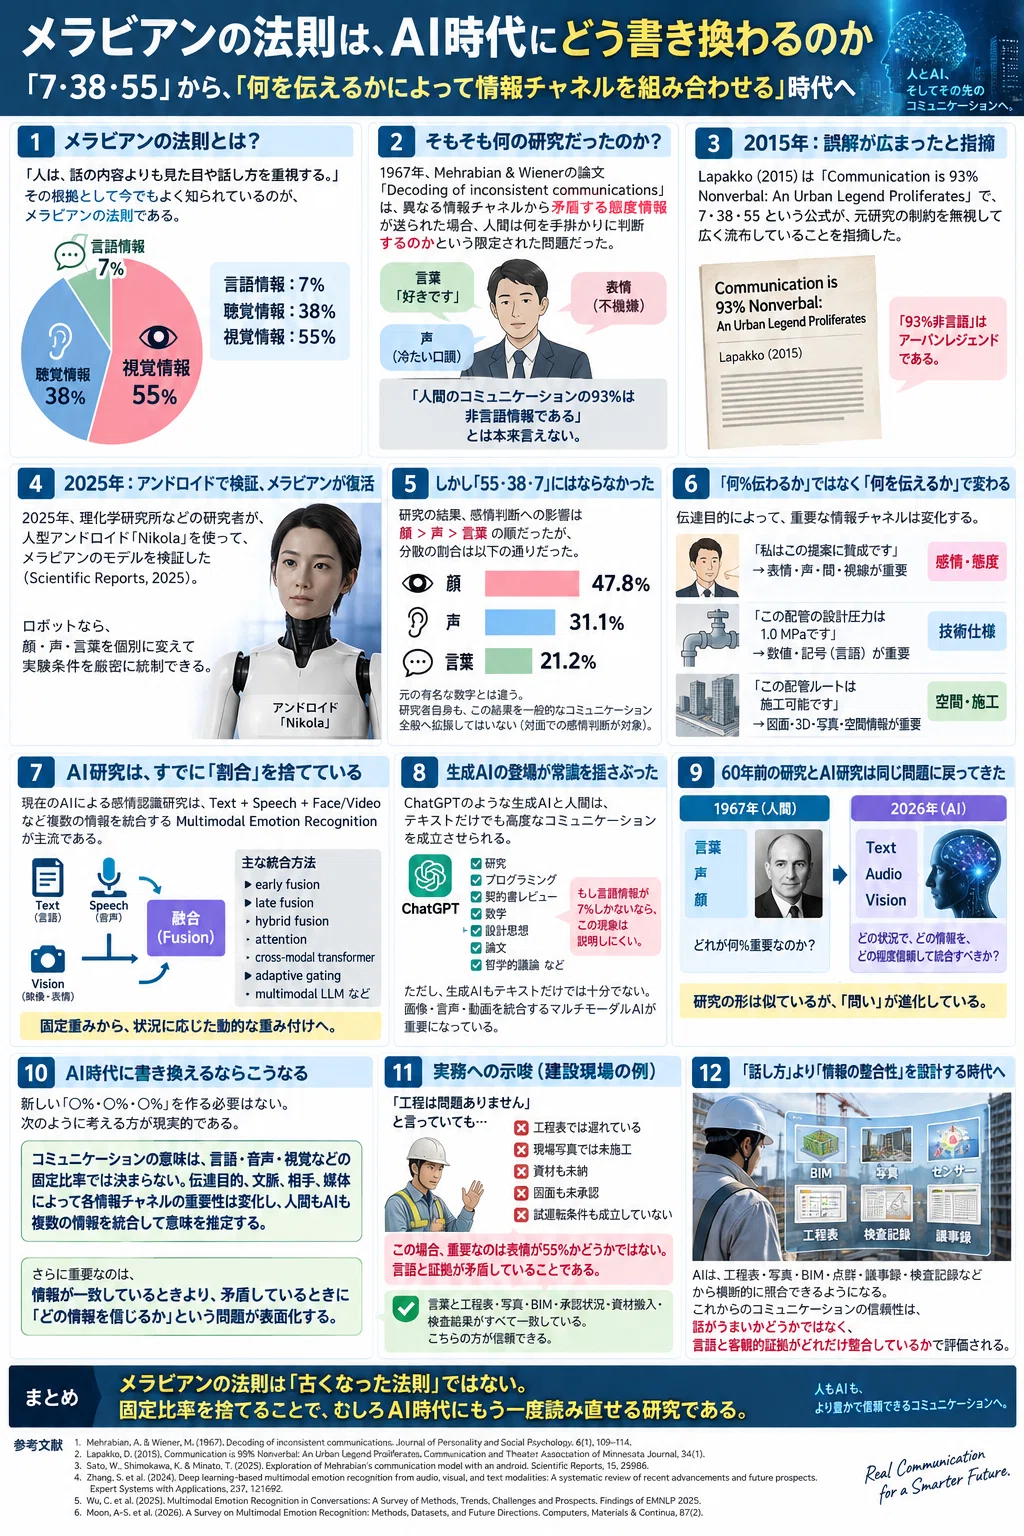
「人は、話の内容よりも見た目や話し方を重視する。」
その根拠として、今でも頻繁に登場するのが「メラビアンの法則」である。
有名なのは、
言語情報:7%
聴覚情報:38%
視覚情報:55%
という数字だ。
しかし2026年現在、この数字を「人間のコミュニケーション全般を説明する法則」と考えるのは適切ではない。
一方で興味深いことに、メラビアンが約60年前に提起した問題そのものは、AI研究の最前線でむしろ重要になっている。
現在の研究用語で言えば、それはmultimodal communication / multimodal emotion recognition / multimodal fusionという問題である。近年のレビューでも、テキスト・音声・映像など複数モダリティを統合して感情や意味を推定する研究が大きな領域になっている。
つまり、メラビアンは完全に間違っていたというより、
「何%か」という問い方が古くなった
と考えると分かりやすい。
1.そもそもメラビアンは「人間のコミュニケーション全部」を測っていない
原点に戻る。
Mehrabian & Wienerが1967年に発表した論文は、Decoding of inconsistent communications である。
重要なのはタイトルにある inconsistent だ。
研究対象は、
「言葉では好意的なのに、声は否定的」
といったように、異なる情報チャネルから矛盾する態度情報が送られた場合、人間は何を手掛かりとして判断するのかという限定された問題だった。
したがって、
「人間のコミュニケーションの93%は非言語情報である」
とは本来言えない。
この誤解は後年かなり批判され、Lapakkoは2015年にそのものずばり、
“Communication is 93% Nonverbal: An Urban Legend Proliferates”
という論文を発表している。7・38・55という公式が、元研究の制約を無視して広く流布していることを指摘した研究である。
2.ところが2025年、メラビアンが復活した
ここからが面白い。
2025年、Scientific Reports に理化学研究所などの研究者による、
“Exploration of Mehrabian’s communication model with an android”
という研究が掲載された。
約60年前の問題を、今度は人型アンドロイドを使って検証したのである。
なぜロボットなのか。
人間の場合、
顔だけ変える
声だけ変える
言葉だけ変える
という実験条件を完全に統制することが難しい。
ロボットなら、それができる。
研究ではアンドロイド「Nikola」に、
顔 × 声 × 言葉
それぞれについてpositive / neutral / negativeな表現をさせ、人間がどう感情価を判断するか調べた。
その結果、感情判断への影響は、
顔 > 声 > 言葉
の順になった。
ここだけ見ると、
「やっぱりメラビアンは正しかったじゃないか」
となる。
しかし、重要なのは次だ。
3.2025年の研究でも「55・38・7」にはならなかった
研究で説明された分散の割合は、
顔:47.8%
声:31.1%
言葉:21.2%
だった。
元の有名な数字とは違う。
しかも研究者自身が、この結果を一般的なコミュニケーション全般へ拡張してはいない。
研究対象はあくまで、
face-to-face emotional communication
つまり対面での感情情報の判断である。
さらに論文では、客観的なメッセージの意味を推論する課題では、言語情報の重要性が高くなる先行研究にも触れている。
ここが極めて重要だ。
4.「何%伝わるか」ではなく、「何を伝えるか」で変わる
例えば、
「私はこの提案に賛成です」
と言う。
本当に賛成しているのかを判断するなら、
表情、声、間、視線などが重要になる。
ところが、
「この配管の設計圧力は1.0 MPaです」
ならどうだろう。
表情47.8%、声31.1%、言葉21.2%ではない。
ほぼ意味がない。
1.0 MPaという記号・数値情報そのものが重要だからだ。
さらに、
「この配管ルートは施工可能です」
になると、また変わる。
文章だけでは足りない。
平面図、断面図、BIM、点群、施工空間、写真、干渉チェックなどの視覚・空間情報が重要になる。
つまり、
情報チャネルの重要性は、伝達目的によって変化する。
これがメラビアンを現代的に理解するうえで非常に重要なポイントだ。
5.そしてAI研究は、すでに「割合」を捨てている
現在のAIによる感情認識研究を見ると、この変化がよく分かる。
2023~2026年のレビュー研究では、人間の感情を、
Text
+ Speech
+ Face / Video
など複数の情報源から推定するMultimodal Emotion Recognitionが研究されている。
ここでは、
「顔は55%だから0.55を掛ける」
という単純な処理はしない。
むしろ研究課題になっているのは、
どう融合するか(fusion)
である。
2026年のレビューでは、early fusion、late fusion、hybrid fusionに加えて、attention、cross-modal transformer、adaptive gating、multimodal large language modelsなど、多様な統合方法が整理されている。
つまりAI研究は、
固定重み
から、
状況に応じた動的な重み付け
へ進んでいる。
6.人間のコミュニケーションも同じではないか
ここからは、これらの研究を踏まえた私なりの整理である。
1960年代的なモデルを単純化すると、
意味 = 0.07 × 言葉 + 0.38 × 声 + 0.55 × 顔
となる。
しかし現代的には、むしろ、
Meaning = f(言語、音声、表情、身体、文脈、過去の会話、相手、目的、媒体)
と考えた方が自然だ。
しかも、この関数 f は固定されていない。
たとえば、
感情を読む
→ 顔・声の比重が上がる。
技術仕様を伝える
→ 言語・数値の比重が上がる。
空間を説明する
→ 図・3D・映像の比重が上がる。
危険を伝える
→ 写真・動画・数値・言語を組み合わせる。
契約条件を伝える
→ 言語の正確性が極めて重要になる。
この方が現実のコミュニケーションを説明しやすい。
7.そして生成AIの登場が、メラビアンの常識をさらに揺さぶった
ここは1967年には存在しなかった世界だ。
ChatGPTのような生成AIと人間は、基本的には大量の言語情報だけでも高度なコミュニケーションを成立させられる。
研究。
プログラミング。
契約書レビュー。
数学。
設計思想。
論文。
哲学的議論。
これらはテキストだけでも相当に深いところまで到達できる。
もし本当に、
「言語情報はコミュニケーションの7%しかない」
のであれば、この現象はかなり説明しにくい。
ただし、生成AIもテキストだけでは十分でない方向へ進んでいる。
画像、音声、動画などを統合するマルチモーダルAIが重要になっている。
最新のMultimodal Emotion Recognition研究でも、単一モダリティだけでは現実の対話における微妙な感情理解が難しく、text・speech・visual signalsを統合する方向が研究されている。
ここが面白い。
8.60年前の人間研究と、現在のAI研究が同じ問題に戻ってきた
1967年のメラビアンは、
言葉
声
顔
のどれを人間が重視するのかを研究した。
2026年のAI研究は、
Text
Audio
Vision
をどう統合すれば人間の感情や意図を理解できるのかを研究している。
形が非常によく似ている。
違うのは問いだ。
昔は、
「どれが何%重要なのか?」
だった。
現在は、
「どの状況で、どの情報を、どの程度信頼して統合すべきなのか?」
になっている。
これはかなり大きな転換だと思う。
9.だから「AI時代のメラビアン」を作るなら、固定比率にしてはいけない
新しい「○%・○%・○%」を作る必要はない。
むしろ、
伝達したい意味に応じて、最適な情報チャネルは変わる。
と考える。
そしてもう一つ重要なのが、
複数の情報チャネルが一致しているか。
という問題だ。
例えば施工会議で、
「工程は問題ありません」
と言っている。
しかし、
工程表では遅れている。
現場写真では未施工。
資材も未納。
図面も未承認。
試運転条件も成立していない。
この場合、重要なのは説明者の表情が55%かどうかではない。
言語と証拠が矛盾していることである。
逆に、
「工程は問題ありません」
という言葉と、
工程表、写真、BIM、承認状況、資材搬入、検査結果が全部一致している。
こちらの方が信頼できる。
10.これはメラビアンの本来の問題に、むしろ戻っている
考えてみると面白い。
メラビアンの原研究も、
異なる情報チャネルが矛盾したら、人間はどう判断するのか
という研究だった。
60年後のAIも、
テキストではPositive
声ではNegative
表情ではNeutral
という情報が入ってきたとき、
「では、この人は実際にはどう感じているのか」
を推論しなければならない。
だからメラビアンの研究テーマそのものは、古くなったどころか、マルチモーダルAIによって再び重要になっているとも言える。
11.AI時代に書き換えるならこうなる
「7:38:55」ではない。
私は研究知見を実務的に整理するなら、次のように表現した方がよいと思う。
コミュニケーションの意味は、言語・音声・視覚などの固定比率では決まらない。伝達目的、文脈、相手、媒体によって各情報チャネルの重要性は変化し、人間もAIも複数の情報を統合して意味を推定する。
そして、さらに重要なのが、
情報が一致しているときより、矛盾しているときに「どの情報を信じるか」という問題が表面化する。
という点だ。
これなら1967年の研究から2026年のマルチモーダルAI研究まで、かなりきれいにつながる。
「話し方」より「情報の整合性」を設計する時代へ
メラビアンの法則から学ぶべきことは、
「見た目を良くしよう」
ではなかったのかもしれない。
本当に重要なのは、
言っていることと、見えていることと、実際に起きていることを一致させること。
AI時代になると、この意味はさらに大きくなる。
人間だけなら、「大丈夫だと思います」という説明で済んでいたものを、AIは工程表、写真、BIM、点群、議事録、検査記録などから横断的に照合できるようになる。
するとコミュニケーションの信頼性は、
話がうまいかどうか
だけではなく、
言語と客観的証拠がどれだけ整合しているか
でも評価できる。
これは建設現場にもかなり重要な変化だと思う。
「大丈夫です」ではなく、
なぜ大丈夫なのか。
そして、
言葉以外のデータも同じ結論を示しているのか。
約60年前に「言葉・声・顔の不一致」から始まった問題は、AI時代には、
言葉・音声・映像・図面・センサー・履歴・実世界の不一致をどう検出し、意味を統合するか
という問題へ拡張されつつある。
そう考えると、メラビアンの法則は「古くなった法則」というより、
固定比率を捨てることで、むしろAI時代にもう一度読み直せる研究
なのだと思う。
参考文献
Mehrabian, A. & Wiener, M. (1967). Decoding of inconsistent communications. Journal of Personality and Social Psychology, 6(1), 109–114.
Lapakko, D. (2015). Communication is 93% Nonverbal: An Urban Legend Proliferates. Communication and Theater Association of Minnesota Journal, 34(1).
Sato, W., Shimokawa, K. & Minato, T. (2025). Exploration of Mehrabian’s communication model with an android. Scientific Reports, 15, 25986.
Zhang, S. et al. (2024). Deep learning-based multimodal emotion recognition from audio, visual, and text modalities: A systematic review of recent advancements and future prospects. Expert Systems with Applications, 237, 121692.
Wu, C. et al. (2025). Multimodal Emotion Recognition in Conversations: A Survey of Methods, Trends, Challenges and Prospects. Findings of EMNLP 2025.
Moon, A-S. et al. (2026). A Survey on Multimodal Emotion Recognition: Methods, Datasets, and Future Directions. Computers, Materials & Continua, 87(2). 画像化
