平均値の多重比較(TukeyのHSD法)

私は平均値の群間比較にTukeyのHSD法(Tukey法)を長年使ってきた。大学生のとき上回生からそう教わったからだ。しかし、研究キャリアの後半となり、長年使ってきた手法が正しいのか試してみたくなった。Bonferroniと比べて第一種の過誤をよりよく調整できているのか試してみた。
Tukey法
最小有意差HSDを求める。
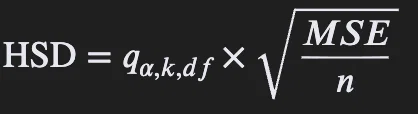
q スチューデント化範囲
α 有意水準(通常は α = 0.05)
k 群の数
df 誤差の自由度(分散分析表から得られる)
MSE 誤差の平方和( 〃 )
n 群あたりの標本数(ばらつきがある場合はそれらの調和平均)
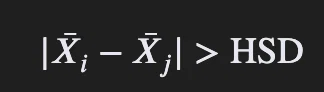
あとは以下の基準の組み合わせのものは有意とする。バーのついたX_i, jは比較する群の平均値を示す。つまり、上で求めたHSDより平均値の差が大きい組み合わせを有意と判定する。
第一種の過誤のシミュレーション
Rでは組み込み関数
TukeyHSD()
があるので、これを使えばよい。
前回のBonferroni補正と同様にして、TukeyHSDの第一種の過誤を調べる。標準正規分布に従う3群の標本(n = 10)を作成し、いずれかの組み合わせで有意となる危険を判定する。すなわち、Pの最小値の分布を評価する。
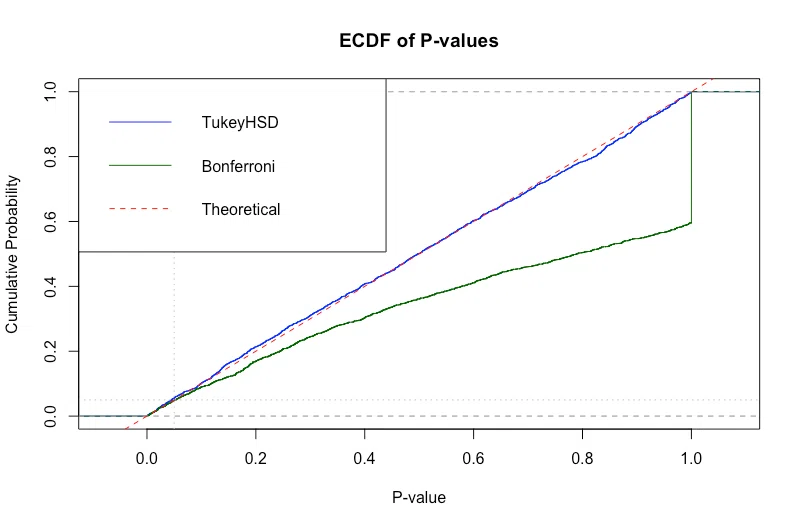
一般に帰無仮説のもとではP値は一様分布をし、経験累積分布関数(ECDF)は45度の右上がりとなるので、この点で判定する。Rのコードは末尾に示した(no. 1)。
以下の図は横軸が(調整済み)P値、縦軸が累積確率である。検定が好ましい(第一種の過誤を正しく調整できている場合)は赤で示した直線にのる。
Tukey法ではほぼ対角線にのり、調整がうまくいっている。
一方、Bonferroniでは期待される直線より大きく右にずれている。これは、理想よりP値が大きく見積もられることを示している。
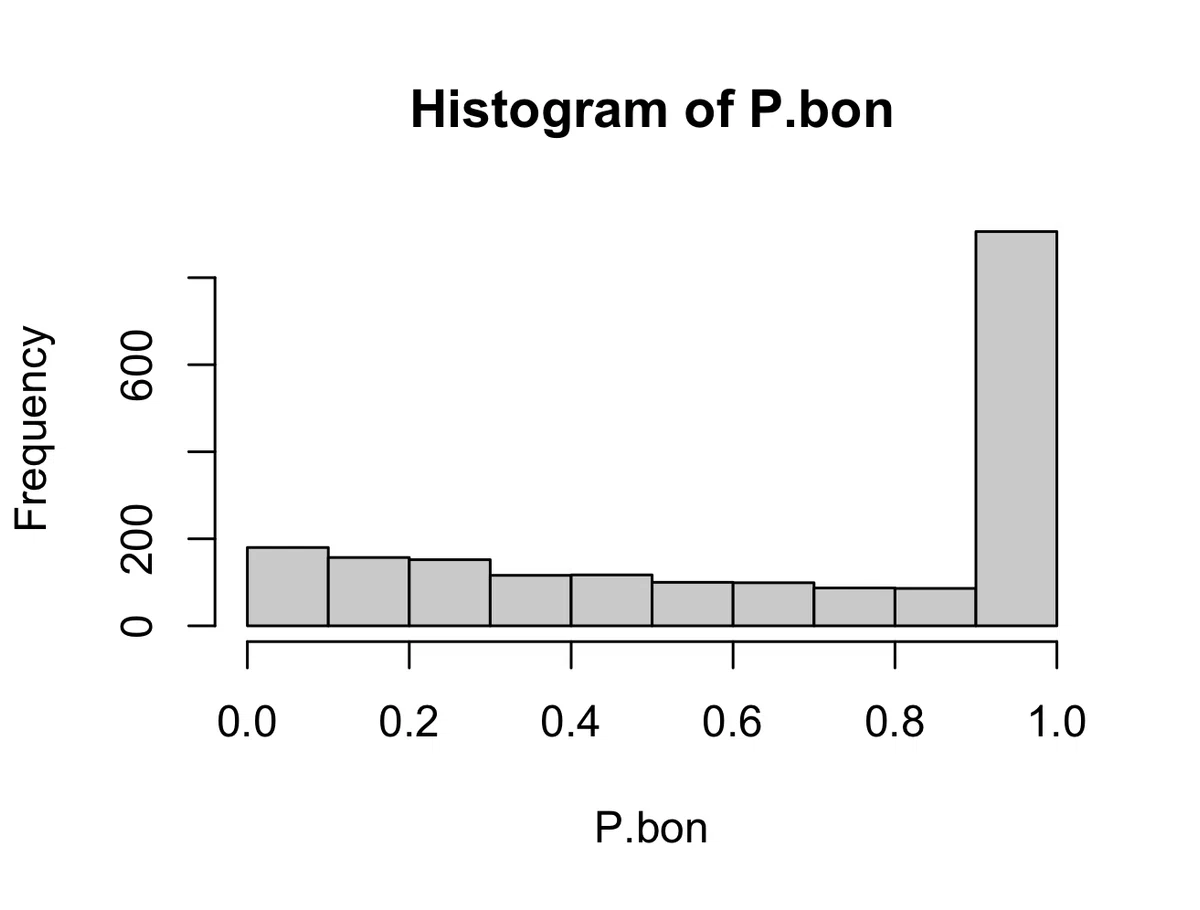
Tukey法のP値の分布
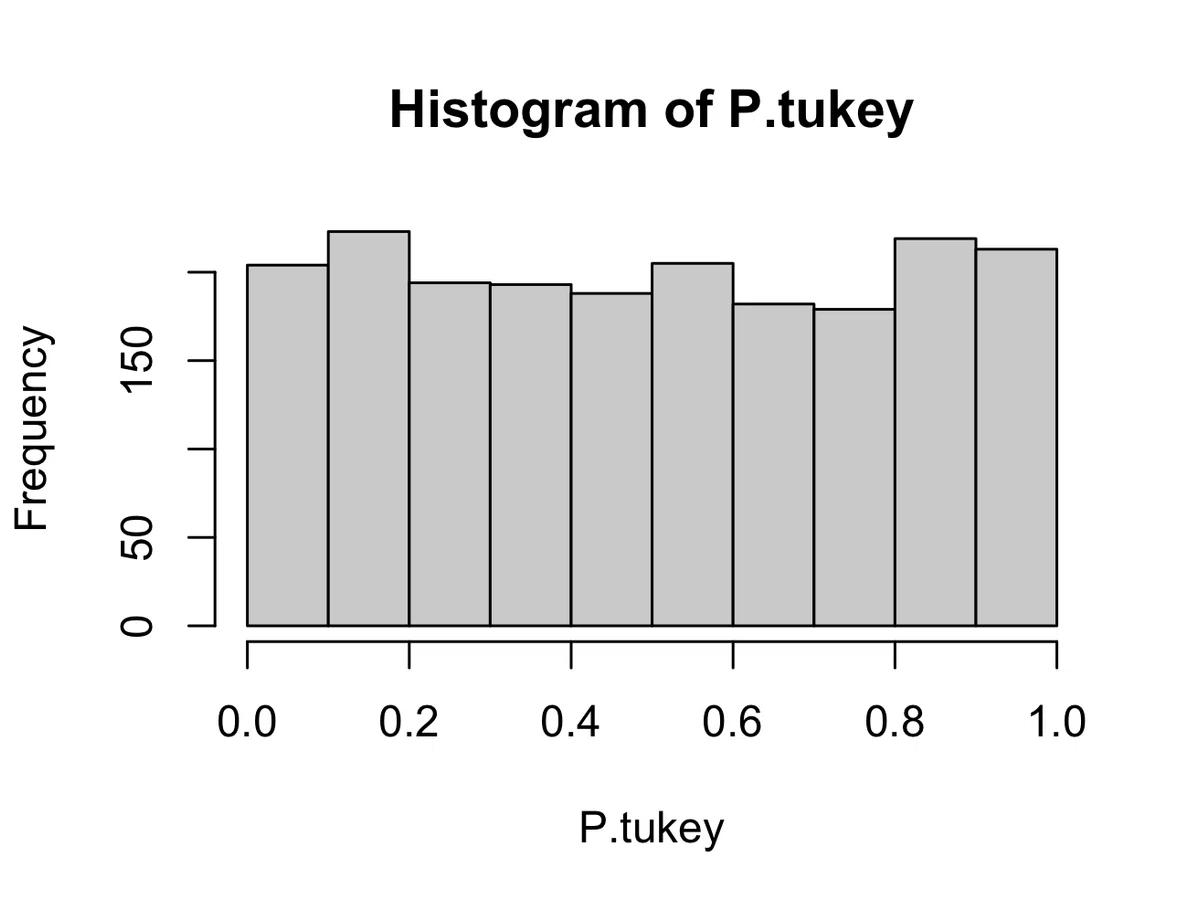
ボンフェローニ法の場合はヒストグラムの形は右下がりとなる。1が飛び出ているのは1を超えた部分を1に丸めたためである。
3群の場合はそれほど違いがないが、もっと群が増えるとどうなるか。
4群(6通りの組み合わせ)ではどうなるか。コードは末尾に掲載した(no. 1)。
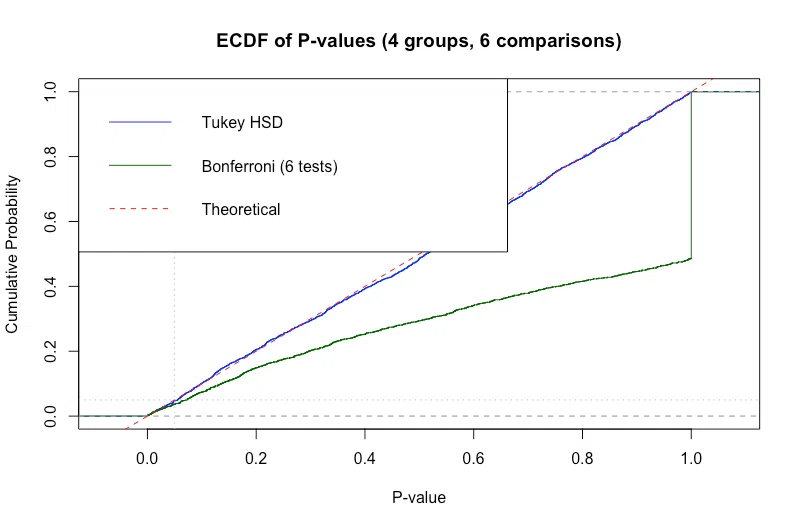
P = 0.05の付近を拡大(グレーの縦線)
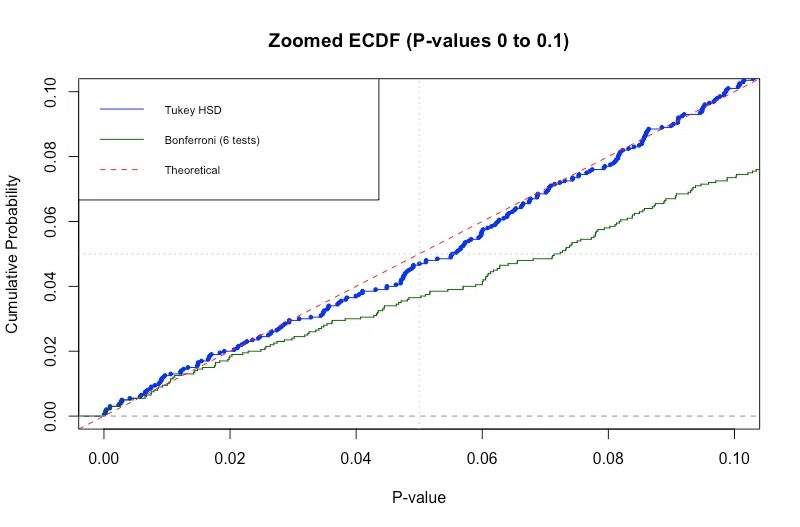
Bonferroni法はいくぶん保守的(実際には差があるのに有意差が出にくい)ことがわかる。
t検定との比較
最後に、t検定のP値がそれぞれの補正法でどう変換されるか見てみよう。
Bonferroni法では有意水準αが1/3になるので、t検定のP値を3倍したものを調整済みP値とし、1を超えた場合は1に丸めた。コードは末尾に示した (no. 3)。2,000反復のシミュレーションの結果:
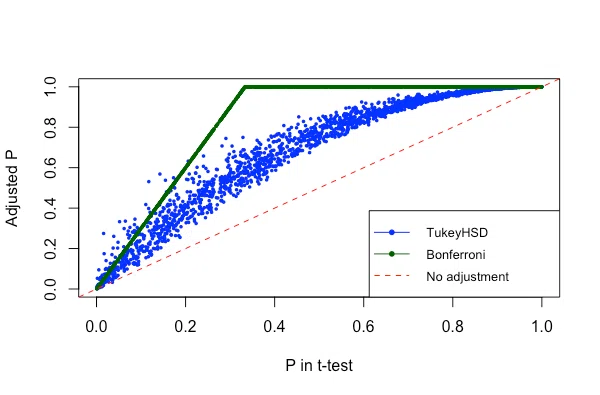
P = 0.05付近を拡大した図を示す。
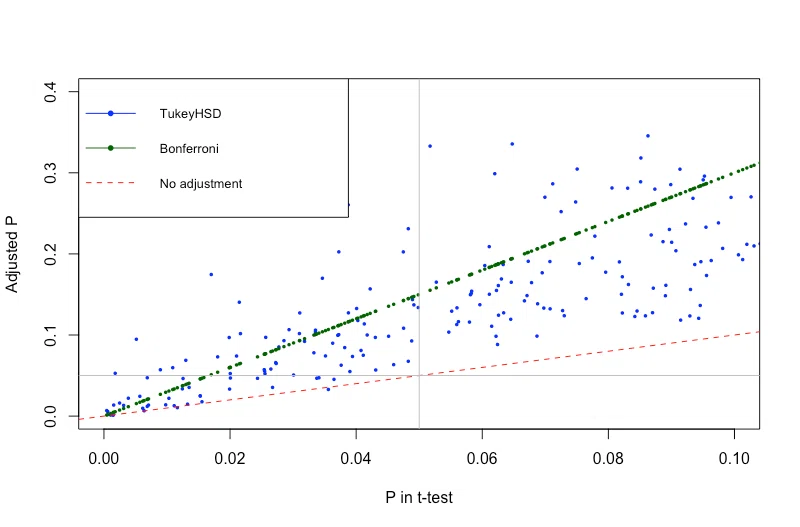
いずれの方法でも調整されたP値はt検定の場合より上にあり、有意性の基準が厳しくなっている。しかし、Tukey法による調整済みP値がボンフェローニ法の場合よりも下方にあり、有意になりやすいことが見て取れる。すなわち、ボンフェローニ法では元のt検定のPが0.167未満でないと有意差とならないが、Tukey法ではそれ以上でも有意差になることもある。
ただし、データセットによってはボンフェローニ法よりも厳しい(緑の点の上に青がある)場合もある。原点付近で、Tukey法では有意ではないが、Bonferroni法では有意なペアがいくつかある。これはTukey法では他の群の分散も統計量に大きく関与するためである。
今回は各群n = 10の実験だった。サンプルサイズや群数、母分散の偏りなどによって、これらの関係性は変わるだろう。
今日の発見
Tukey法は第一種の過誤をうまく調整できているようだ。
Tukey法はBonferroni法で有意にならない場合でも有意になる場合が多いが、すべてではない。
以下の記事も参照:
平均値の多重比較(FisherのLSD法)
https://note.com/k_i186/n/nf136c3bbf7a4
Rコード
補遺
コード1
# 多重性シミュレーション (Bonferroni vs Tukey's methods)
# 2026-02-23

nrep <- 2000          # シミュレーション回数
P <- numeric(nrep)    # ANOVAのP値
P.tukey <- numeric(nrep)   # Tukey法における最小P値
P.bon <- numeric(nrep)   # Bonferroni法における最小P値

for (i in 1:nrep){
	A <- rnorm(10); B <- rnorm(10); C <- rnorm(10)
	dat <- data.frame(x = gl(3, 10, labels = c("A","B","C")), y = c(A, B, C))

	a <- aov(y ~ x, data = dat)  # ANOVA

	# Minimum P value in TukeyHSD
	P.tukey[i] <- min(TukeyHSD(a)$x[,"p adj"])

	# Three t-tests and Bonferroni correction
	P1 <- t.test(A, B, var.equal = T)$p.value
	P2 <- t.test(B, C, var.equal = T)$p.value
	P3 <- t.test(C, A, var.equal = T)$p.value
	  # pairwise.t.test(dat$y, dat$x, p.adjust.method = "none", pool.sd = TRUE) も同じこと
 	P.bon[i] <- pmin(min(P1, P2, P3)*3, 1)  # 1を超えないようにpminで抑えた
}

# ECDF(累積分布関数)
plot(ecdf(P.tukey),
		 main = "ECDF of P-values",
		 xlab = "P-value", ylab = "Cumulative Probability",
		 col = "blue", cex = 0.1)
plot(ecdf(P.bon), add = TRUE, col = "darkgreen", verticals = TRUE, do.points = FALSE)

abline(0, 1, col = "red", lty = 2) # 対角線
abline(v = 0.05, h = 0.05, col = "gray", lty = 3)

legend("topleft", legend = c("TukeyHSD", "Bonferroni", "Theoretical"),
			 col = c("blue", "darkgreen", "red"), lty = c(1, 1, 2))
コード2
4群の比較(6通りの組み合わせ)のコード
P.tukey <- numeric(nrep)
P.bon <- numeric(nrep)

for (i in 1:nrep){
  # 1. 4群(A, B, C, D)のデータ生成
  # 10個×4群で合計40個の乱数を生成
  y <- rnorm(40)
  x <- gl(4, 10, labels = c("A","B","C","D"))
  dat <- data.frame(x, y)

  # 2. Tukey法
  a <- aov(y ~ x, data = dat)
  P.tukey[i] <- min(TukeyHSD(a)$x[, "p adj"])

  # 3. Bonferroni法(ここが最小限の変更ポイント)
  # 補正なしのP値をすべて出し、その最小値を「比較回数の6」倍する
  res_p <- pairwise.t.test(dat$y, dat$x, p.adjust.method = "none", pool.sd = TRUE)$p.value
  P.bon[i] <- pmin(min(res_p, na.rm = TRUE) * 6, 1)
}

# --- ECDFプロット(凡例の数字なども更新) ---
plot(ecdf(P.tukey), main = "ECDF of P-values (4 groups, 6 comparisons)",
     xlab = "P-value", ylab = "Cumulative Probability", col = "blue", cex = 0.1)
plot(ecdf(P.bon), add = TRUE, col = "darkgreen", verticals = TRUE, do.points = FALSE)
abline(0, 1, col = "red", lty = 2)
abline(v = 0.05, h = 0.05, col = "gray", lty = 3)

legend("topleft", legend = c("Tukey HSD", "Bonferroni (6 tests)", "Theoretical"),
       col = c("blue", "darkgreen", "red"), lty = c(1, 1, 2))
コード3
t検定のP値が2つの方法でどう調整されるか
# 多重性シミュレーション (Bonferroni vs Tukey's methods)
# P-values
# 2026-02-23

nrep <- 2000          # シミュレーション回数
P1 <- numeric(nrep)    # ANOVAのP値
P.tukey <- numeric(nrep)   # Tukey法における最小P値
P.bon <- numeric(nrep)   # Bonferroni法における最小P値

for (i in 1:nrep){
	A <- rnorm(10); B <- rnorm(10); C <- rnorm(10)
	dat <- data.frame(x = gl(3, 10, labels = c("A","B","C")), y = c(A, B, C))

	P1[i] <- t.test(A, B, var.equal = T)$p.value

	a <- aov(y ~ x, data = dat)
	P.tukey[i] <- TukeyHSD(a)$x[1,"p adj"]  # Tukey P values

	P.bon[i] <- pmin(P1[i] * 3, 1)   #  Bonferroni P values
}

# Plot
plot(P.tukey ~ P1,
		 xlab = "P in t-test", ylab = "Adjusted P",
		 xlim = c(0, 1), ylim = c(0, 1),
		 col = "blue", cex = 0.5, pch = 16)
points (P.bon ~ P1, col = "darkgreen", cex = 0.5, pch = 16)

# 対角線(補正なしの場合のライン)
abline(0, 1, col = "red", lty = 2)
abline(v = 0.05, col = "gray"); abline(h = 0.05, col = "gray")

legend("bottomright", legend = c("TukeyHSD", "Bonferroni", "No adjustment"),
			 col = c("blue", "darkgreen", "red"),
			 pch = c(16, 16, NA),
			 lty = c(1, 1, 2),
			 cex = 0.8,
			 bty = "L"
)
