
最新AI比較(プログラミング)

はじめに
最近、GoogleがGemini 2.5 Pro Preview 0506を出し、その後AnthropicがClaude Sonnet 4とOpus 4を発表し、更にその後Gemini 2.5 Pro Preview 0605が発表されるなど、LLMの公開が相次いでいる。
そこでこの記事では、公開されているLLMのプログラミング能力について、電卓アプリを作らせるタスクで比較しようと思う。
注意:特定のタスクで試行回数はそれぞれ1回なので、正確にモデルの能力を測れていない可能性があります。
また、使用するモデルが最上位モデルでないこともあり、正確な比較ではない部分があります。
タスクの詳細
モデル一覧
プログラミング能力の比較のため、自分が使える中で最新で最上位のモデルを各社1つづつ使用する(推論と非推論がある場合は推論系のモデルを採用する)。
カッコ内は使用したサイト名もしくはそのURL。
OpenAI
o4-mini(ChatGPT)
Gemini 2.5 Pro Preview 0605(Google AI Studio)
Anthropic
Claude Sonnet 4(Claude)
xAI
Grok 3(grok.com、Thinkはオン)
Meta
Llama 4 Maverick 03-26 experimental(lmarena.ai)
DeepSeek
DeepSeek R1(chat.deepseek.com)
プロンプト
以下の条件を満たす電卓アプリをHTML, CSS, JSで作って。

* 言語は上でも言った通りHTML, CSS, JS
* CSS, JSはHTML内のstyle, script要素に書き、全てのコードを1つのHTMLファイルに書くこと
* ライブラリは使用しないこと
* 数字は0~9まで(スタイル的に場所が余るなら"00"を追加しても良い)
* 小数点機能をつけること
* 演算は{+, -, *, /}の4つは含めること
* 削除系のボタンはAC(オールクリア)とC(クリア、1文字消去、⌫でも良い)の2パターン用意すること
* 0で割ったときには、エラーをユーザーに見える形で表示すること
* 浮動小数点数計算への対策を出来るならすること
* キーボードショートカットを導入すること(キーは自分で適切なものを考えること)
評価基準
コード指定への対応:4点満点(減点方式で、指示を無視している箇所1個につき1点減点、最低0点)
デザイン:5点満点で評価(指示したものが全てあって3点、そこから使いやすさなども踏まえて判断)
計算が出来るか:満点2点
0除算への対策:満点2点
浮動小数点計算への対応:満点2点
キーボードショートカット:満点5点(全て使えれば3点で、そこからキーボード選択などで判断)
プラスで、何か使いやすいだったりあれば、最大3点で加点(1つあたり1点)
合計で基本最大20点(20点を超えてもその特典で放置)。
結果概要
モデル名を一部省略している箇所がある
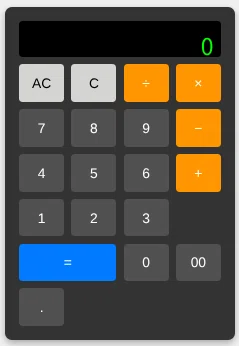
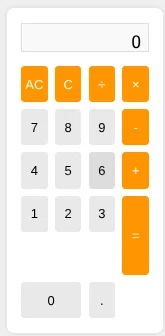
o4-mini
コード指定への対応:4点
デザイン:3点
計算ができるか:2点
0除算への対策:2点
浮動小数点計算への対応:1点(小数点以下10桁までに丸めているため、小さすぎると0になったりする)
キーボードショートカット:5点(問題なし)
プラス:0点
合計:17点
Gemini 2.5 Pro
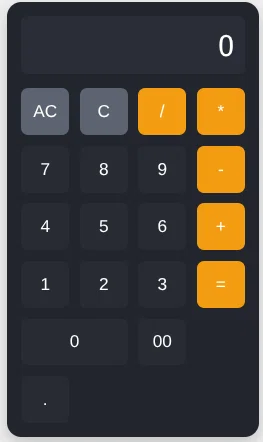
コード指定への対応:4点
デザイン:4点
計算ができるか:2点
0除算への対策:2点
浮動小数点計算への対応:2点
キーボードショートカット:4点(Enterキーを押すと、前に押したキーとなってしまう部分がある)
プラス:1点(浮動小数点計算への対策が整数に変換してから計算するようにしている)
合計:19点
Claude Sonnet 4
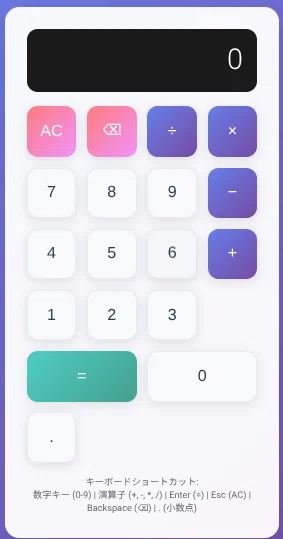
コード指定への対応:4点
デザイン:4点(若干直せそう)
計算ができるか:2点
0除算への対策:1点(出来ているものの、エラーが長すぎてスタイルが壊れる)
浮動小数点計算への対応:2点
キーボードショートカット:5点
プラス:1点(下にキーボードショートカットが書いてある)
合計:19点
Grok 3
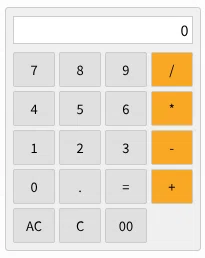
コード指定への対応:4点
デザイン:3点(全てあるが、削除系のボタンが下にあったり、そもそもデザインが古かったりと、最低限)
計算ができるか:2点
0除算への対策:2点
浮動小数点計算への対応:1点(o4-miniと同様に小さすぎると0になったりする)
キーボードショートカット:5点
プラス:0点
合計:17点
Llama 4 Maverick
コード指定への対応:4点
デザイン:2点(全て存在がするが、破綻が起きているので、減点)
計算ができるか:2点
0除算への対策:2点
浮動小数点計算への対応:1点(o4-miniやGrok3と同様)
キーボードショートカット:3点("*"キーを押すと何故か除算になる)
プラス:0点
合計:14点
DeepSeek R1
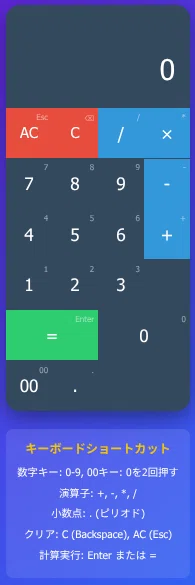
コード指定への対応:4点
デザイン:4点(全てあるが、若干見にくい)
計算ができるか:0点(そもそも計算が上手くいかない時がある上に、数字キーを1回押したはずなのに、2桁分入力されてしまうバグもある)
0除算への対策:1点(エラーは出るが、他の文字と被っている)
浮動小数点計算への対応:2点
キーボードショートカット:5点
プラス:1点(下にキーボードショートカットが書いてある、更にキーの右上にも書いてある)
合計:17点
まとめ
o4-mini: 17点
Gemini 2.5 Pro: 19点
Claude Sonnet 4: 19点
Grok 3: 17点
Llama 4 Maverick: 14点
DeepSeek R1: 17点
結果はこうなったが、17点となった3つのモデルは、o4-mini > Grok 3 > DeepSeek R1の順番が決まるくらいには、結構印象が違った。
不等号で並べると、
Gemini 2.5 Pro = Claude Sonnet 4 >> o4-mini > Grok 3 > DeepSeek R1 >> Llama 4 Maverick
といった感じ。
結果とは関係がないが、Artifactsや、Canvas のようにプレビュー機能が付いているのがほとんどだった(Google AI StudioとChatbot Arena以外全て)。
最後に
最後まで読んでくださり、ありがとうございます。
よろしければ、follow等お願いします。
