
【初心者向けML入門 (分類問題)第1回】🐧ペンギンデータで学ぶ!機械学習「データ前処理」入門

「ペンギン好きの方、データ分析初心者の方、ぜひ一緒に進めていきましょう!
役に立ったら『いいね』で応援してもらえると励みになります🐧」
なぜ「パーマーペンギンのデータ(Palmer Penguins)」を使うのか
ペンギンのデータを使用する理由は、ペンギンが可愛いからです。
🐧🐧🐧🐧可愛いは正義です。
📌 全体ロードマップ
第1回:ペンギンデータの正体を知る&欠損値を直す 👈 今回はココ!
第2回:文字のデータを数字に変換する(エンコーディング)
第3回:いよいよ機械学習モデルに学習させて予測してみよう!
1. そもそも「ペンギンデータ」ってどんなもの?
ペンギンデータは、南極の島々に暮らす3種類のペンギン(アデリー(Adelie)、ジェンツー(Gentoo)、ヒゲペンギン(Chinstrap)の身体測定データです。
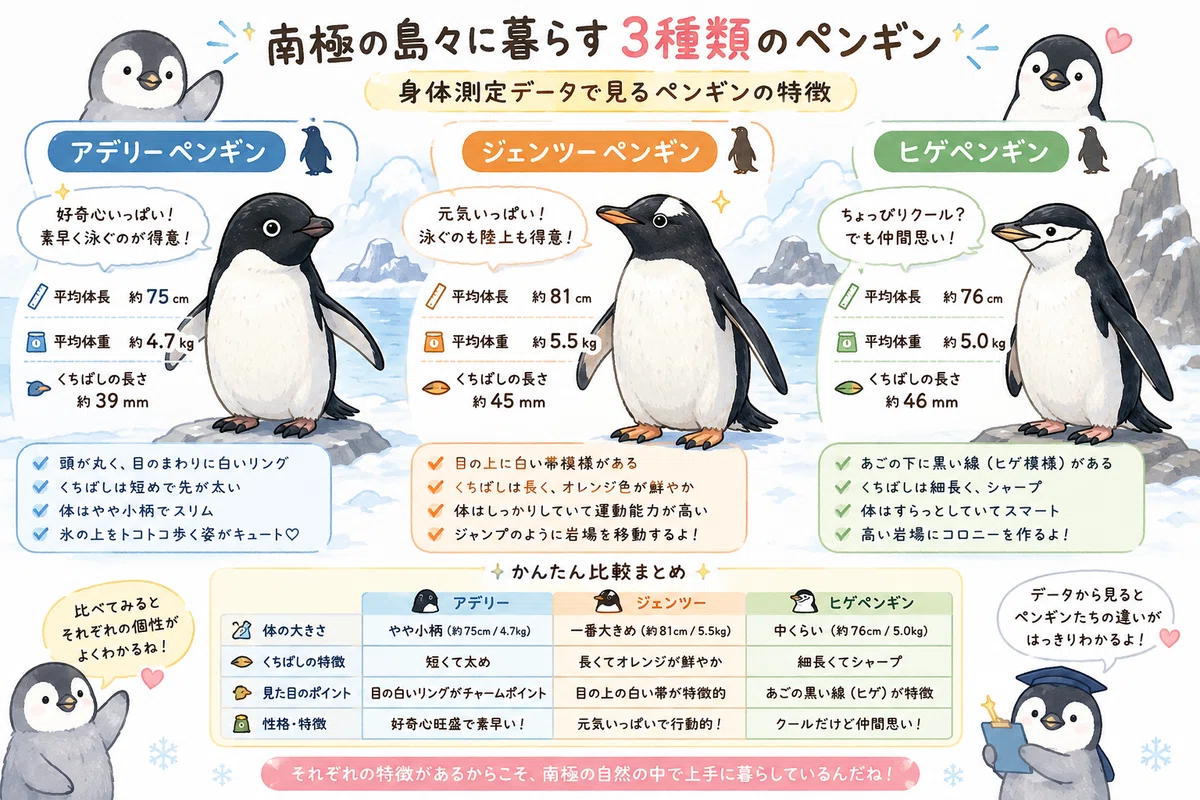
予測したいゴール: 「くちばしの長さ」や「体重」などの特徴から、「何という種類のペンギンか?」をAIに当ててもらう(分類問題)
まずは、Pythonを使ってこのデータを覗いてみましょう。
その前に・・・・補足という名の蛇足
機械学習と直接関係がないのですが、ペンギンのイメージをより具体的にするために3種類のペンギンの名前の由来を記載しますね。
アデリーペンギン(Adelie)
1840年に南極に上陸したフランス人探検家デュモン・デュルヴィルの妻・アデリー (Adélie) への献名で、彼が上陸した場所はアデリーランドと名付けられ、そこで発見された本種にもアデリーの名が付けられた。
ジェンツーペンギン(Gentoo)
英名の"Gentoo"は、ポルトガル語で「異教徒」を意味する"Gentio"に由来し、頭部の白い帯模様をターバンに見立てたものといわれる。
一方、別和名のオンジュンペンギンはこのペンギンの温順な性格にちなんでいる。
ヒゲペンギン(Chinstrap)
頭の下に細い黒い帯模様があり、黒いヘルメットを被っているように見える[2]。この黒い帯が和名の由来であり、英名では「chinstrap penguin」、「ringed penguin」、「bearded penguin (和名と同義)」などと呼ばれる。
それではこれから取り扱うペンギンに詳しくなったところで本題に戻りましょう。
使用するデータについて
使用するデータは、seabornというライブラリに入っているサンプルデータを使用します。
ライブラリのインストールは下記になります。
pip install seabornライブラリのインストールが終わりましたら、早速テータを読み込んでみましょう。
💻 サンプルコード:データを読み込んでみる
最初の5行だけを表示して、データが読み込まれているかの確認とデータの雰囲気を掴むためのコマンドです。
import pandas as pd
import seaborn as sns

# ペンギンデータの読み込み
df = sns.load_dataset('penguins')

# 最初の5行を表示してみる
print(df.head())
📊 実行結果(イメージ)
  species     island  bill_length_mm  bill_depth_mm  flipper_length_mm  body_mass_g     sex
0  Adelie  Torgersen            39.1           18.7              181.0       3750.0    Male
1  Adelie  Torgersen            39.5           17.4              186.0       3800.0  Female
2  Adelie  Torgersen            40.3           18.0              195.0       3250.0  Female
3  Adelie  Torgersen             NaN            NaN                NaN          NaN     NaN
4  Adelie  Torgersen            36.7           19.3              193.0       3450.0  Female
2. 読み込んだデータの概要を調べてみる
Pandasのdf.info() は、データフレームの「健康診断カルテ」のようなもので、データ分析や前処理をする上で最もよく使う超重要コマンドの一つです。
1. df.info() でどのような情報が取れるのか?
コードを実行すると、データ全体の「基本スペック」がテキストで一覧表示されます。具体的には、以下の5つの重要な情報が一度に手に入ります。
データの形式(型): 今扱っているのが、PandasのDataFrameという形式であること。
行数と列の数: データに「何行(サンプル数)」の「何列(特徴量)」があるか。
すべての列名: カラム(項目)の名前の一覧。
非欠損値の数(データの詰まり具合): 各列に「空白(欠損値)ではないデータが何個あるか」。これにより、どこに欠損値があるか一発で分かります。
データのデータ型(Dtype): それぞれの列が「数値(int, float)」なのか、「文字列(object)」なのか。
メモリ使用量: データがパソコンのメモリをどれくらい消費しているか。
2. 実際の使い方と出力結果の見方
先ほどの「ペンギンデータ」を例に、実際のコードと出力結果を見てみましょう。
💻 サンプルコード:df.info()
# df.info()を実行する
df.info()
📊 出力結果(イメージ)
<class 'pandas.DataFrame'>
RangeIndex: 344 entries, 0 to 343
Data columns (total 7 columns):
 #   Column             Non-Null Count  Dtype
---  ------             --------------  -----
 0   species            344 non-null    str
 1   island             344 non-null    str
 2   bill_length_mm     342 non-null    float64
 3   bill_depth_mm      342 non-null    float64
 4   flipper_length_mm  342 non-null    float64
 5   body_mass_g        342 non-null    float64
 6   sex                333 non-null    str
dtypes: float64(4), str(3)
memory usage: 24.9 KB
None
3. ここに注目!df.info()の見方
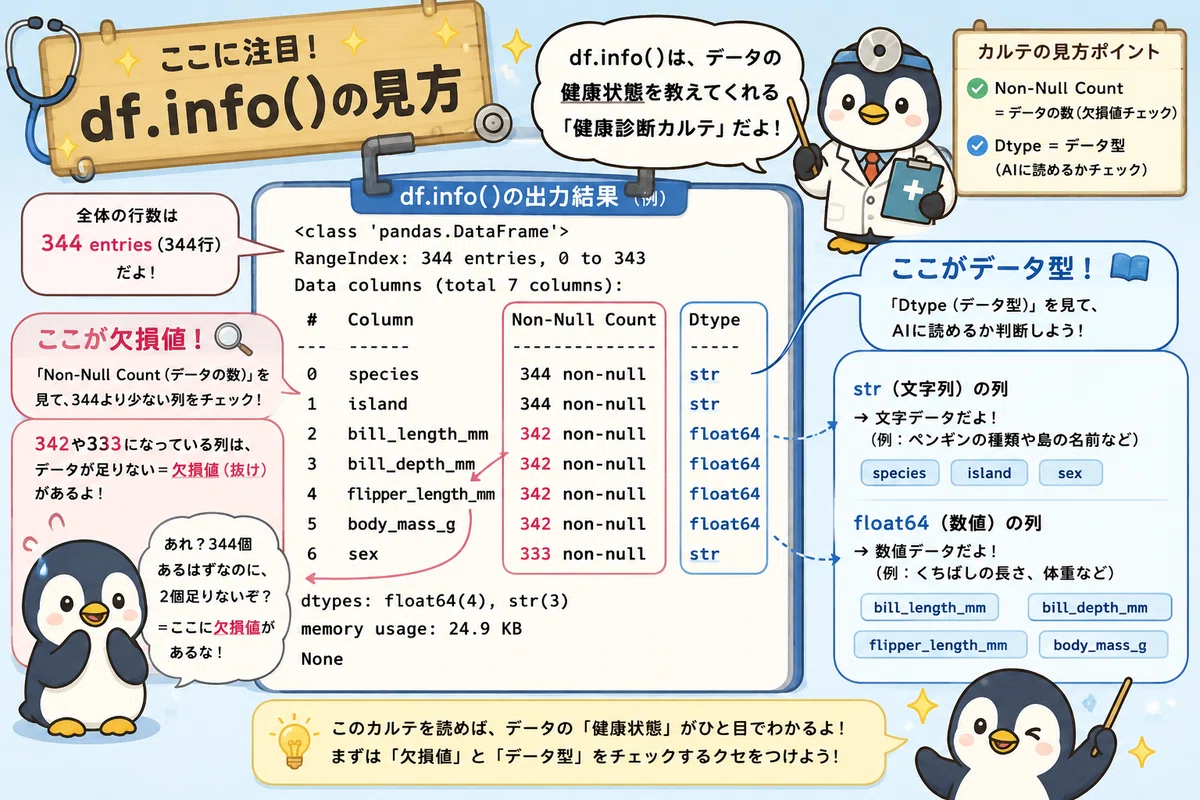
「Non-Null Count(データの数)」を見て欠損値を見つける
全体の行数は 344 entries(344行)なのに、bill_length_mm の行だけ 342 non-null になっています。
「あれ?344個あるはずなのに、2個足りないぞ?=ここに欠損値(抜け)があるな!」と直感的に気づくことができます。
「Dtype(データ型)」を見てAIに読めるか判断する
str(object)と書かれている列(species, island, sex)は、「文字列」を表しています。
機械学習のモデルは基本的に「数字」しか理解できないため、str(object) の列を見つけたら「あ、次回のブログでやる『数値への変換(エンコーディング)』が必要だな」と予測できます。
3. 敵の正体を知る:「欠損値(データの抜け)」とは?
現実の世界で集めたデータには、計測ミスや記入漏れによる「空白(抜け)」が必ずと言っていいほど含まれています。
機械学習のプログラムは非常に厳格なので、データに「空白(NaN)」が含まれていると、「エラーが発生して動かない!」という事態になってしまいます。
人間で言うなら、「レシピの塩の量が『(空白)』になっていて、料理が進められない状態」です。
だからこそ、人間がきれいにしてあげる(前処理)必要があるのです。
🕵️♀️ 欠損値の詳細を調べてみる
df.info() で全体のおおまかなアタリをつけたら、次に「どこに、何個の欠損値(抜け)があるのか」をピンポイントで暴くための専用コマンドを使うと、前処理が劇的にスムーズになります。
1. 欠損値が含まれているか?だけ知る:df.isnull().any()
df.isnull().any(axis=0) は、数ではなく 「欠損値が『ある(True)』か『ない(False)』か」 をチェックすることができます。
💻 サンプルコード
# 各列に欠損値が含まれているか(True / False)を判定する
print(df.isnull().any(axis=0))
※ axis=0 は「列方向」という意味ですが、省略して df.isnull().any() と書いても同じ結果になります。
📊 出力結果(イメージ)
species              False
island               False
bill_length_mm        True
bill_depth_mm         True
flipper_length_mm     True
body_mass_g           True
sex                   True
dtype: bool
どの列に欠損値があるか、False,Trueで表示されるため、すぐ分かりますね。
2. どの列に、欠損値が何個あるか?👑最強の定番:df.isnull().sum()
「どの列に、欠損値が何個あるか」を一発で数える、実務でも最もよく使われるコマンドです。
💻 コード
# 各列の欠損値の個数を合計して表示する
print(df.isnull().sum())
📊 出力結果(イメージ)
species               0
island                0
bill_length_mm        2
bill_depth_mm         2
flipper_length_mm     2
body_mass_g           2
sex                  11
dtype: int64
これを見れば、sex(性別)の列には11個の抜けがあり、bill_length_mm(くちばしの長さ)には2個の抜けがあることが一目瞭然ですね!
3. あといくつ欠損値が残っているか確認:df.isnull().sum().sum()
データ全体の中に、「合計でいくつ欠損値があるか」をひとつの数字で知りたいときに使います。前処理の前後で「ちゃんと全部消せたかな?」を確認するのに便利です。
💻 コード
# データフレーム全体の欠損値の総数を出す
print(df.isnull().sum().sum())
📊 出力結果(イメージ)
19ペンギンデータ全体で、合計19個の欠損値があることが分かります。
4. 具体的にどの行に欠損値があるのか?👑 王道テクニック:df[df.isnull().any(axis=1)]
「データの中にどんな欠損値があるか」が分かったら、次は「具体的にどの行が抜けているのか(実際のデータの中身)」を自分の目で確認したくなりますよね。
「どれかひとつの列にでも欠損値(True)が含まれている行」をすべて抽出する方法です。
💻 コード
print(df[df.isnull().any(axis=1)])axis=1 と書くことで、「縦方向(列ごと)」ではなく「横方向(行ごと)」にチェックを走らせています。「どこかの列がダメなら、その行全体をピックアップして!」という命令になります。
これを実行すると、さっき df.info() で見つけた「11件の性別不明データ」や「2件の寸法抜けデータ」が綺麗にリストアップされ、「なぜ抜けているのか(全部抜けているのか、一部分だけなのか)」が直感的に分かります。
📊 出力結果(イメージ)
    species     island  bill_length_mm  bill_depth_mm  flipper_length_mm  body_mass_g  sex
3    Adelie  Torgersen             NaN            NaN                NaN          NaN  NaN
8    Adelie  Torgersen            34.1           18.1              193.0       3475.0  NaN
9    Adelie  Torgersen            42.0           20.2              190.0       4250.0  NaN
10   Adelie  Torgersen            37.8           17.1              186.0       3300.0  NaN
11   Adelie  Torgersen            37.8           17.3              180.0       3700.0  NaN
47   Adelie      Dream            37.5           18.9              179.0       2975.0  NaN
246  Gentoo     Biscoe            44.5           14.3              216.0       4100.0  NaN
286  Gentoo     Biscoe            46.2           14.4              214.0       4650.0  NaN
324  Gentoo     Biscoe            47.3           13.8              216.0       4725.0  NaN
336  Gentoo     Biscoe            44.5           15.7              217.0       4875.0  NaN
339  Gentoo     Biscoe             NaN            NaN                NaN          NaN  NaN
------
5. 特定の列だけに絞って抽出する:df[df['列名'].isnull()]
「全体じゃなくて、『性別(sex)』が抜けている行だけをピンポイントで見たい!」というときは、こちらの書き方が便利です。
💻 コード
df[df['sex'].isnull()]全データのうち、特定の重要な項目だけが抜けているケースを調べたいときに使います。例えば『価格』や『ラベル(正解データ)』が抜けている行は予測に使えないので、こうしてピンポイントで確認して削除するかどうかを判断します。
📊 出力結果(イメージ)
    species     island  bill_length_mm  bill_depth_mm  flipper_length_mm  body_mass_g  sex
3    Adelie  Torgersen             NaN            NaN                NaN          NaN  NaN
8    Adelie  Torgersen            34.1           18.1              193.0       3475.0  NaN
9    Adelie  Torgersen            42.0           20.2              190.0       4250.0  NaN
10   Adelie  Torgersen            37.8           17.1              186.0       3300.0  NaN
11   Adelie  Torgersen            37.8           17.3              180.0       3700.0  NaN
47   Adelie      Dream            37.5           18.9              179.0       2975.0  NaN
246  Gentoo     Biscoe            44.5           14.3              216.0       4100.0  NaN
286  Gentoo     Biscoe            46.2           14.4              214.0       4650.0  NaN
324  Gentoo     Biscoe            47.3           13.8              216.0       4725.0  NaN
336  Gentoo     Biscoe            44.5           15.7              217.0       4875.0  NaN
339  Gentoo     Biscoe             NaN            NaN                NaN          NaN  NaN
4. 欠損値をやっつけろ!具体的な対処法とコード
欠損値を見つけたときの代表的な対処法は、次の2つです。
行ごと消去する(データ数が十分にある場合)
別の値(平均値など)で穴埋めする(データを減らしたくない場合)
今回は、初心者にも分かりやすい「行ごと削除する方法」をやってみましょう。
1. 欠損値のデータを行ごと削除する
💻 サンプルコード:欠損値を削除する
Pandasの dropna() という便利な関数を使います。
元のdfは書き換わらず、新しいdf_cleanに保存されるようにします。
# 欠損値(NaN)が含まれている行をすべて削除する
df_clean = df.dropna()

# 削除前と削除後のデータ件数を確認してみる
print(f"削除前のデータ数: {len(df)}")
print(f"削除後のデータ数: {len(df_clean)}")
📊 出力結果(イメージ)
削除前のデータ数: 344
削除後のデータ数: 333
2. 欠損値のデータが正しく削除されているか確認をする
削除後のデータに欠損値が無いことを調べてみましょう。
💻 サンプルコード:欠損値の有無を調べる
print(df_clean.isnull().any(axis=0))
print('------')
print(df_clean.isnull().sum().sum())
📊 出力結果(イメージ)
species              False
island               False
bill_length_mm       False
bill_depth_mm        False
flipper_length_mm    False
body_mass_g          False
sex                  False
dtype: bool
------
0
df_cleanのデータには欠損値が含まれていないことが分かりますね。
5. 今回のまとめ & 次回の予告
お疲れ様でした!本日のまとめです。
現実のデータには「欠損値(空白)」がつきものであること。
そのままではAIがエラーを起こすため、事前の掃除(前処理)が必須であること。
今回は dropna() を使って、空白の行をスッキリ削除する方法を覚えたこと。
次回予告
データから空白は消えましたが、実はまだ問題があります。
species(種類)や island(島)、sex(性別)は「文字」になっていますよね。
コンピューターは文字の計算が苦手です。「アデリー」や「Male」をどうやって数字に翻訳すればいいのでしょうか?
次回は、【第2回:文字のデータを数字に変換する(エンコーディング)】を分かりやすく解説します!お楽しみに!
🙇 今回の内容で『ここが分かりやすかった!』『ここが難しかった』などあれば、ぜひコメントやいいねで教えてください!
